
Com a part del seu compromís amb un ecosistema d'IA més segur i transparent, OpenAI utilitza senyals de procedència per ajudar les persones a saber si un contingut s'ha generat amb un model d'OpenAI.
Els senyals de procedència poden aportar informació útil sobre l'origen, però no garanteixen que el contingut sigui exacte, que no s'hagi modificat, que se'n tingui la propietat legal o que es presenti en el context correcte.
Senyals de procedència d'OpenAI
Quins senyals de procedència utilitza OpenAI?
OpenAI utilitza diferents senyals de procedència segons el tipus de contingut.
| Tipus de contingut | Senyals de procedència | Notes |
|---|---|---|
| Imatges | Credencials de contingut i marques d'aigua SynthID | Les imatges generades amb ChatGPT, Codex o l'API d'OpenAI inclouen tots dos senyals. |
| Àudio | Marques d'aigua SynthID | L'àudio generat amb ChatGPT o l'API d'OpenAI inclou una marca d'aigua inaudible incorporada al mateix àudio. |
| Text | Marques d'aigua textGrain (només a la UE) | A la UE, el text generat amb ChatGPT inclou un canvi invisible en l'aleatorietat que fa servir el model per triar les paraules, per complir el Reglament d'IA de la UE. Els clients de l'API de tot el món poden activar les marques d'aigua per als textos generats des de la configuració del projecte o de l'organització. |
| Vídeo | Credencials de contingut | Sora ja no està disponible. Més informació. |
La cobertura pot variar segons el producte, el model, el mètode d'exportació, el tipus de fitxer i el moment en què es va crear el contingut. La cobertura inclou els continguts generats amb l'API, excepte els dels models que es preveu retirar aviat, com ara gpt-image-1, gpt-image-1.5 i sora-2.
Per què alguns tipus de contingut utilitzen diversos senyals?
Quan és tècnicament viable, OpenAI combina metadades i marques d'aigua perquè cadascuna pugui compensar les limitacions de l'altra. Les metadades poden contenir informació detallada, però les plataformes, les eines d'edició i les conversions de fitxers les poden eliminar. Les marques d'aigua aporten menys context, però, com que estan inserides en el contingut generat mateix, poden resistir algunes transformacions que eliminen les metadades.
Fins a quin punt resisteixen els senyals de procedència les modificacions del contingut?
Les marques d'aigua de SynthID per a imatges i àudio i les de textGrain per a text estan dissenyades per resistir els canvis habituals. Segons el tipus de contingut, aquests canvis poden incloure petites modificacions, copiar i enganxar, retallar o fer captures de pantalla. Els canvis més importants —com ara retallar molt una imatge, comprimir fitxers, reformular substancialment un text o traduir-lo— poden fer que una marca d'aigua sigui indetectable. Després de canvis importants, també pot tenir menys sentit descriure el resultat com a "generat per OpenAI".
Les credencials de contingut, desenvolupades per la Coalició per a la Procedència i l'Autenticitat del Contingut, es poden perdre amb accions quotidianes, com ara fer una captura de pantalla o convertir un fitxer. Quan es conserven, poden aportar més detalls sobre l'origen i l'historial d'un fitxer que una marca d'aigua per si sola.
Quan és tècnicament possible, utilitzem tots dos mètodes per augmentar les probabilitats que la informació de procedència resisteixi els canvis en el contingut.
Què són les credencials de contingut i què permeten fer?
Les credencials de contingut adjunten informació sobre l'origen i l'historial d'un fitxer, com ara quina eina el va crear i quan. Utilitzen un estàndard obert desenvolupat per la Coalició per a la Procedència i l'Autenticitat del Contingut (C2PA), motiu pel qual de vegades s'anomenen "metadades C2PA".
Les credencials de contingut ajuden a verificar d'on prové el contingut. No s'utilitzen només per al contingut generat per IA: els fabricants de càmeres, els mitjans de comunicació i altres entitats també utilitzen l'estàndard per certificar l'origen i l'historial del seu contingut multimèdia. Més informació sobre C2PA.
Què és SynthID i què permet fer?
SynthID és una tecnologia de marques d'aigua invisibles desenvolupada per Google DeepMind que insereix un senyal directament al contingut multimèdia generat. A diferència de les metadades, el senyal forma part del contingut mateix i pot persistir després d'algunes modificacions o transformacions. SynthID proporciona un senyal de procedència addicional, juntament amb les metadades C2PA. Per exemple, si s'eliminen les metadades d'un fitxer, una marca d'aigua inserida encara pot indicar que el contingut s'ha generat amb eines d'OpenAI compatibles. Més informació sobre SynthID.
Per què afegiu marques d'aigua al text generat?
Estem implementant marques d'aigua de text per als usuaris de ChatGPT a la UE per complir el Reglament d'IA de la UE i d'acord amb els nostres compromisos en virtut del Codi de bones pràctiques de la UE sobre transparència del contingut generat per IA, que OpenAI ha signat juntament amb diversos altres grans proveïdors d'IA.
Què és textGrain i què permet fer?
textGrain és la tecnologia de marques d'aigua de text d'OpenAI. Ajusta subtilment la manera com el model tria aleatòriament entre les possibles paraules o parts de paraules mentre escriu. Al llarg d'un fragment, aquestes tries creen un patró que un detector pot cercar, fins i tot després d'algunes modificacions.
La marca d'aigua forma part de la redacció mateixa i no és visible per als lectors. No afegeix caràcters ocults, espais invisibles ni signes de puntuació inusuals. Les marques d'aigua de text ajuden a complir el requisit del Reglament d'IA de la UE de marcar el text generat.
Eines de verificació d'OpenAI
Com puc comprovar si un contingut s'ha generat amb eines d'OpenAI?
Pots visitar openai.com/verify per comprovar si un fitxer d'imatge o d'àudio compatible conté senyals de procedència associats a contingut generat o exportat amb eines d'OpenAI. Quan pugis un fitxer compatible, l'eina hi cercarà senyals de procedència d'OpenAI que admeti, com ara una marca d'aigua SynthID o un manifest C2PA de confiança associat a OpenAI. Si l'eina troba un senyal de procedència d'OpenAI que admet, això indica que probablement el contingut s'ha generat amb un model d'OpenAI.
Els desenvolupadors i les organitzacions també poden utilitzar l'API de procedència del contingut d'OpenAI per cercar senyals de procedència d'OpenAI en imatges i àudio i integrar la verificació a les seves aplicacions o fluxos de treball. Les organitzacions amb un cas d'ús que compleixi els requisits poden sol·licitar límits més alts.
Pel que fa al text, d'acord amb les nostres obligacions en virtut del Reglament d'IA de la UE, les organitzacions amb un cas d'ús que compleixi els requisits poden sol·licitar accés al detector de text. Això inclou, per exemple, les institucions acadèmiques i de recerca que estudien la procedència del text, la fiabilitat de la detecció o com les persones interpreten els resultats sobre la procedència. Revisarem individualment les sol·licituds de les organitzacions que compleixin els requisits i, segons correspongui, ens hi posarem en contacte per comunicar-los novetats o demanar-los informació addicional. El nostre enfocament pel que fa a l'accés pot evolucionar a mesura que n'aprenguem més i millorem la tecnologia.
Actualment col·laborem amb un grup reduït d'investigadors, entre els quals hi ha John Thickstun, professor adjunt d'informàtica a la Universitat de Cornell; Martin Vechev, professor d'informàtica a l'ETH de Zuric i director científic de l'INSAIT, i investigadors de l'Institut Kempelen de Tecnologies Intel·ligents (KInIT), per entendre millor les capacitats i les limitacions de la tecnologia i orientar les millores en les marques d'aigua de text.
Qui pot optar a límits de verificació més alts i es cobren les comprovacions?
Actualment, les comprovacions amb l'API de procedència del contingut són gratuïtes i estan subjectes a límits d'ús. El programa de límits més alts se centra en projectes de procedència d'interès públic i fluxos de treball d'integritat de la informació que compleixin els requisits, com ara la verificació en redaccions periodístiques, la comprovació de fets, la recerca sobre la procedència del contingut i la supervisió normativa.
Les aplicacions empresarials generals queden actualment fora de l'abast del programa, com ara la prevenció del frau, l'autenticació i la verificació amb finalitats comercials, o la revenda com a part de paquets de serveis de procedència i anàlisi de dades.
Les organitzacions amb un cas d'ús que compleixi els requisits poden sol·licitar un augment dels límits, però presentar una sol·licitud no en garanteix l'aprovació. L'API pública continua disponible amb els límits per defecte, també per a avaluacions a petita escala. Consulta la documentació de l'API de procedència del contingut per conèixer els límits d'ús actuals.
Qui pot accedir al detector de text i es cobren les comprovacions?
Actualment, les comprovacions amb el detector de text són gratuïtes. Els casos d'ús admesos inclouen organitzacions acadèmiques i de recerca que estudiïn la procedència del text, la fiabilitat de la detecció o com s'entenen els resultats sobre la procedència.
Les aplicacions empresarials generals queden actualment fora de l'abast del programa, com ara la prevenció del frau, l'autenticació i la verificació amb finalitats comercials, o la revenda com a part de paquets de serveis de procedència i anàlisi de dades.
Les aplicacions relacionades amb la integritat acadèmica, com ara comprovar si s'ha utilitzat IA en treballs d'estudiants (per exemple, en la redacció d'assaigs o tesis), també queden actualment fora de l'abast del programa.
Què volen dir els resultats de la verificació?
Si es detecta un senyal a través d'openai.com/verify o de l'API de procedència del contingut d'OpenAI, vol dir que el contingut pujat conté un senyal de procedència admès associat a OpenAI. L'eina no confirma que el contingut sigui exacte, que no s'hagi modificat, que se'n tingui la propietat legal o que es presenti en el context correcte. Tampoc no identifica qui ha creat el contingut ni per què l'ha creat.
Si no es detecta cap senyal, vol dir que l'eina no ha trobat senyals de procedència emesos per OpenAI al fitxer pujat. Tot i això, el contingut podria haver-se generat o exportat amb OpenAI si:
El contingut es va crear abans que els senyals de procedència estiguessin disponibles.
El contingut prové d'un producte, model, mètode d'exportació o tipus de fitxer no compatible.
Les metadades es van eliminar en pujar, baixar, editar, convertir o compartir el fitxer.
Una marca d'aigua s'ha degradat a causa de la compressió, la retallada, el soroll, l'edició, la conversió de format o altres transformacions.
Un fragment d'àudio és massa curt o s'ha modificat considerablement.
Com puc obtenir el resultat de verificació més fiable?
Puja un sol fitxer compatible cada vegada i, sempre que sigui possible, utilitza el fitxer exportat original. En el cas de les imatges, evita retallar-les o convertir el fitxer abans de comprovar-lo. En el cas de l'àudio, els fragments d'entre 10 i 60 segons solen donar els millors resultats. Encara que no es detecti cap senyal, tingues en compte l'origen i el context del fitxer abans de treure'n una conclusió.
Els resultats mostren la meva indicació o informació personal?
Els senyals de procedència no inclouen detalls sobre l'usuari, l'organització o la indicació.
Què passa amb el contingut que verifico amb openai.com/verify o amb l'API de procedència del contingut?
El contingut que es puja a openai.com/verify o s'envia a la nostra API de procedència del contingut per verificar-lo només es processa per comprovar si conté senyals de procedència admesos. El contingut no s'emmagatzema, tret que ho exigeixi la llei, ni s'utilitza per entrenar models d'OpenAI.
OpenAI pot detectar contingut generat amb altres eines d'IA?
Les nostres eines de procedència del contingut estan dissenyades per detectar senyals de procedència admesos associats a contingut generat per models d'OpenAI o exportat amb eines d'OpenAI. No estan dissenyades per detectar contingut generat per altres models d'IA i també poden no detectar contingut generat per OpenAI si el senyal corresponent no hi és, no s'admet o està degradat.
Com funcionen les marques d'aigua
Les marques d'aigua determinen l'autoria, la propietat o la responsabilitat legal?
No. Una marca d'aigua és un indici que un model d'OpenAI probablement ha generat o processat el contingut. Per si sola, no estableix qui és l'autor o el propietari del contingut, si calia informar de l'ús d'IA o qui n'és legalment responsable. Tampoc indica si el model estava editant contingut pujat per un usuari.
Les marques d'aigua indiquen fins a quin punt hi ha intervingut un model d'OpenAI?
No. El detector informa de si ha trobat una marca d'aigua. Trobar-ne una és un indici que un model d'OpenAI probablement ha generat o processat el contingut, però no mostra si el model n'ha generat una part o la totalitat, ni quina ha estat l'aportació d'una persona.
Com funcionen les marques d'aigua de text?
Les marques d'aigua de text creen un patró secret en les tries de paraules i parts de paraules, anomenades "segments", que fa el model mentre escriu.
A cada pas, el model assigna una probabilitat a cadascun dels possibles segments següents. El sistema de marques d'aigua crea diversos conjunts ajustats d'aquestes probabilitats, cadascun dels quals afavoreix opcions diferents segons una clau secreta. Els conjunts s'equilibren de manera que, en calcular-ne la mitjana, coincideixin amb les probabilitats originals del model. La clau selecciona quin conjunt s'utilitza i, a continuació, el model fa una nova tria aleatòria a partir d'aquest conjunt.
Més endavant, un detector amb la mateixa clau i una configuració coincident pot comprovar si el text segueix el patró secret més sovint del que s'esperaria per atzar.
Les marques d'aigua de text s'apliquen als textos factuals i als textos proporcionats pels usuaris?
Les marques d'aigua de text depenen del fet que el model disposi de diverses maneres de dir una cosa. Hi ha menys flexibilitat quan una resposta ha de ser molt factual o precisa, com ara la resposta a un problema matemàtic, o quan es demana al model que reprodueixi un text proporcionat sense modificar-lo. En aquests casos, el model té menys marge per canviar la redacció sense que es noti la diferència, de manera que és possible que la marca d'aigua no es detecti.
Les marques d'aigua de text s'apliquen a les respostes curtes i al codi?
Els fragments curts no solen contenir prou text per detectar-hi marques d'aigua de manera fiable. També és més difícil inserir marques d'aigua al codi perquè hi ha menys opcions plausibles per continuar-lo que en la prosa habitual.
Per tenir en compte aquestes limitacions, el Codi de bones pràctiques sobre transparència del contingut generat per IA del Reglament d'IA de la UE no exigeix marques d'aigua en continguts generats de menys de 200 segments —unes 150 paraules en anglès— ni en fragments de codi.
Com varia la detecció de marques d'aigua de text segons l'idioma?
Les taxes de detecció varien segons l'idioma i, actualment, és més fàcil detectar-les en alguns idiomes que en d'altres. Podem ajustar la intensitat de la marca d'aigua per millorar-ne la detecció en els idiomes en què el senyal és més feble.
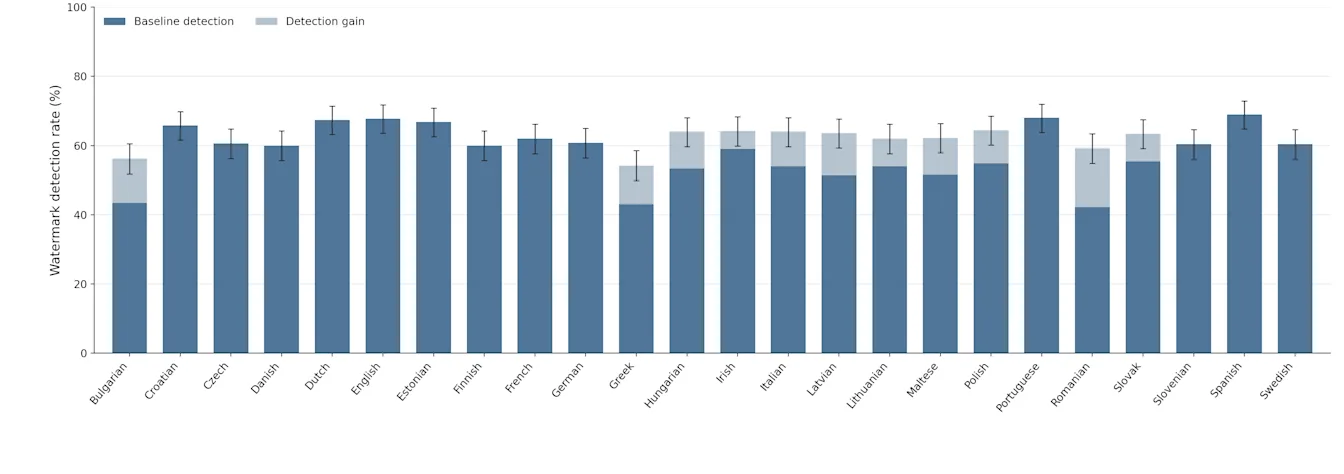
Aquest gràfic avalua la taxa de detecció en els 24 idiomes oficials de la UE. Primer vam generar 500 indicacions sintètiques en anglès sobre temes diversos i després les vam traduir als altres 23 idiomes. Amb una taxa de falsos positius de l'1 %, el castellà té la taxa de detecció més alta (69,0 %), mentre que el romanès té la més baixa (42,2 %). La nostra marca d'aigua té un paràmetre d'intensitat ajustable: un "regulador" que reforça o afebleix el senyal de la marca d'aigua segons l'àmbit. Amb aquest regulador, vam poder augmentar la intensitat en els idiomes amb taxes de detecció inferiors al 60 %; les parts de color blau clar de les barres mostren les millores obtingudes.
Les marques d'aigua de text redueixen la qualitat del model?
Segons les nostres proves, no. En les proves de referència que utilitzem per avaluar Astra, el nostre model d'avantguarda més recent, les diferències de rendiment amb marques d'aigua i sense es troben dins del marge de variació que solem observar entre avaluacions. Les proves prèvies a ChatGPT tampoc van mostrar cap canvi en les taxes de valoracions negatives ni en altres mètriques del producte arran de la introducció de marques d'aigua.
Les marques d'aigua de text redueixen la velocitat del model?
Les marques d'aigua de text tenen un impacte insignificant en la velocitat dels nostres models.
En què es diferencien les marques d'aigua de text d'OpenAI de les eines de detecció d'IA de tercers?
Les eines de detecció de tercers, com Pangram, solen utilitzar classificadors per identificar text generat amb IA a partir de patrons com la tria de paraules. Aquest enfocament analitza el text després de generar-lo, en lloc de detectar-hi un senyal incorporat. El Reglament d'IA de la UE exigeix específicament que s'incorpori un senyal al text generat.
Per què utilitzeu les vostres pròpies marques d'aigua de text en lloc de TextSeal o SynthID?
Hem desenvolupat el nostre propi mètode de marques d'aigua de text, anomenat textGrain, per tenir més control que amb SynthID o TextSeal sobre l'equilibri entre la facilitat de detecció de les marques d'aigua i la varietat de respostes generades a partir de la mateixa indicació. A les nostres proves, el nostre mètode va identificar correctament un percentatge de mostres de text amb marques d'aigua similar o superior al de SynthID per a text. Tenim previst publicar textGrain com a tecnologia de codi obert perquè altres persones hi puguin basar els seus desenvolupaments i ajudar a millorar les marques d'aigua de text.
Les marques d'aigua de text afegeixen caràcters ocults, segments addicionals o canvis visibles?
No. Les marques d'aigua de text modifiquen el patró estadístic de la tria de paraules; no insereixen caràcters ocults ni afegeixen segments dedicats exclusivament a la marca d'aigua. La marca d'aigua no és visible per als lectors, i copiar i enganxar el text no introdueix contingut ocult.
Orientacions per als clients
Soc client de l'API. Com puc activar les marques d'aigua de text?
Els clients de l'API d'OpenAI poden activar les marques d'aigua de text per a un projecte concret des de Configuració, o per a tota l'organització des de Configuració de l'organització. En cada cas, els clients poden seleccionar a quins models s'aplica la marca d'aigua de text. Un cop activada per a un model compatible, OpenAI afegeix la marca d'aigua durant la generació del text. Els clients no han d'afegir cap marca addicional a cada resposta.
Activa Permet les marques d'aigua de text, selecciona els models i, després, selecciona Desa.
Configuració predeterminada de l'organització: ves a Configuració de l'organització > Controls de dades.
Selecciona Procedència del text.
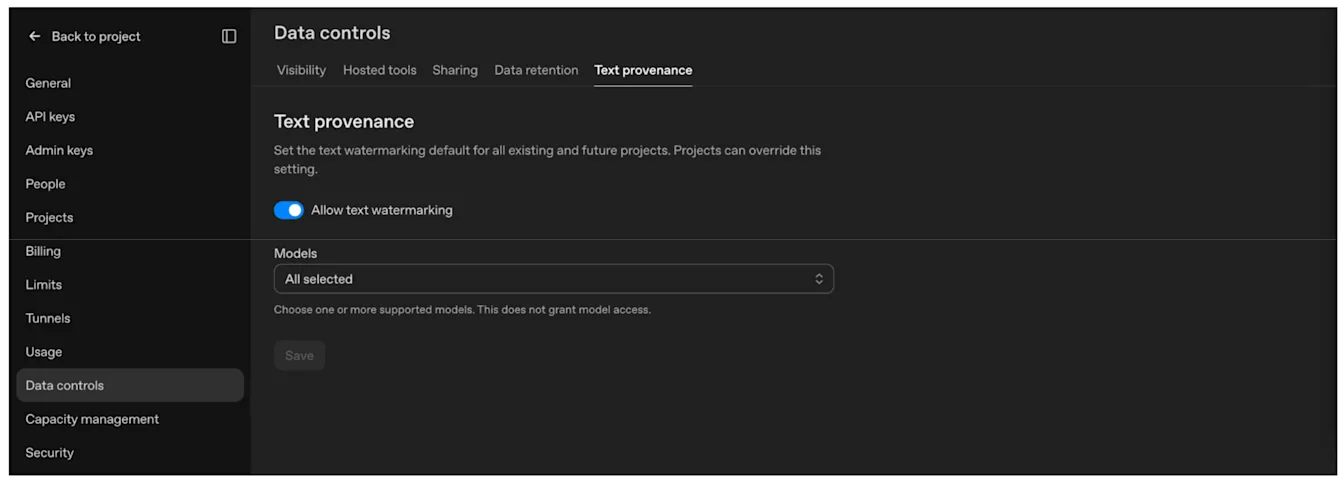
Configuració específica del projecte: ves a Configuració del projecte > Procedència del text.
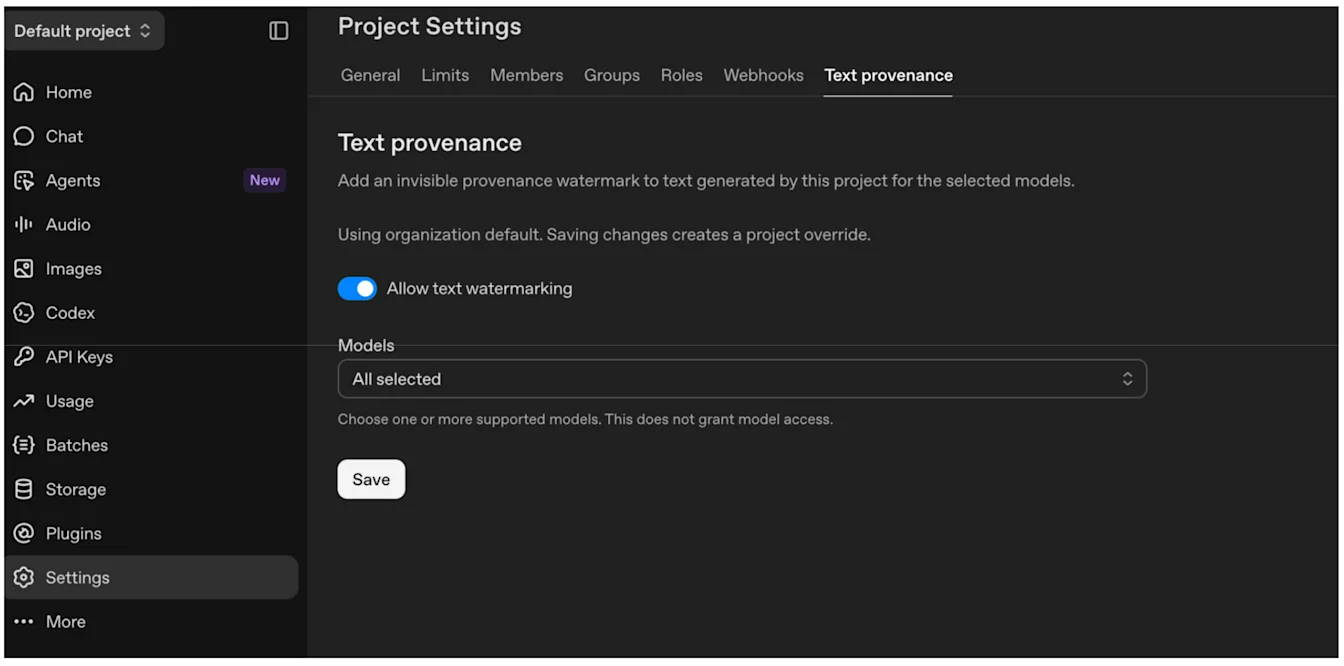
Per a quins models puc activar les marques d'aigua?
A Configuració i Configuració de l'organització, els clients poden consultar la llista de models que actualment admeten marques d'aigua. Durant les properes setmanes, ampliarem aquesta compatibilitat a tots els models antics.
Activar les marques d'aigua de text també em dona accés al detector de text?
No. Actualment, l'accés al detector de text es limita a organitzacions de recerca i acadèmiques autoritzades que treballen per millorar la fiabilitat de les marques d'aigua de text, la facilitat d'ús i la claredat amb què es poden explicar la tecnologia i els seus resultats. Això és coherent amb els nostres compromisos en virtut del Codi de bones pràctiques sobre transparència del contingut generat per IA del Reglament d'IA de la UE.
Els senyals es mantindran en el contingut després de transformar-lo?
És possible, però depèn del senyal i dels canvis que hi facis.
En el cas d'imatges i àudio compatibles, conserva'n una còpia original i utilitza l'API de procedència del contingut per fer proves amb fitxers representatius després d'editar-los, convertir-los i publicar-los. En el cas de les imatges, retallar-les, afegir-hi soroll, convertir-les a JPEG o fer-ne captures de pantalla pot dificultar la detecció dels senyals. Només pots fer aquestes proves amb text si la teva organització té accés autoritzat al detector de text.
Si el format del fitxer i el flux de treball ho permeten, conserva les metadades C2PA existents i inclou credencials de contingut als fitxers que creïs. També pots plantejar-te afegir-hi marques pròpies perquè la informació de procedència sigui més duradora o útil. Consulta la documentació tècnica de C2PA per obtenir detalls sobre la implementació.
En el cas del text, la marca d'aigua forma part de la tria de paraules del model. Si mantens la redacció original, s'espera que el senyal es conservi quan reutilitzis el text, sense cap feina d'integració addicional. Reescriure substancialment el text, parafrasejar-lo o traduir-lo pot reduir la fiabilitat de la detecció. Ni tan sols mantenir la redacció original garanteix que la marca d'aigua sigui detectable, especialment en fragments curts o en textos amb poc marge per triar paraules diferents.
Accedeixo als models d'OpenAI a través d'un servei al núvol. Els continguts que s'hi generen també contenen senyals de procedència?
Treballem amb tots els nostres proveïdors de serveis al núvol i de distribució per garantir que s'incorporin senyals de procedència, incloses marques d'aigua, a tots els continguts generats que ho admetin, ja siguin imatges, àudio o text. La disponibilitat pot variar segons el contingut generat i el proveïdor.
Els senyals de procedència substitueixen les etiquetes visibles d'IA o altres avisos?
No. Les marques d'aigua i les metadades C2PA proporcionen informació que el programari pot llegir. No substitueixen les etiquetes visibles, els bàners o altres avisos que puguin ser obligatoris.
La necessitat d'un avís addicional depèn de com i on utilitzis el contingut. OpenAI no et pot assessorar sobre les teves obligacions legals específiques; el teu equip jurídic ha d'avaluar els requisits aplicables al teu ús.
Tinc més preguntes sobre el Reglament d'IA de la UE
Envia una consulta sobre el Reglament d'IA de la UE i et respondrem.