
Som led i arbejdet for et sikrere og mere gennemsigtigt AI-økosystem bruger OpenAI oprindelsessignaler til at hjælpe folk med at forstå, om indhold er genereret med en OpenAI-model.
Oprindelsessignaler kan give nyttige oplysninger om indholdets oprindelse, men de garanterer ikke, at indholdet er korrekt, uredigeret, lovligt ejet eller præsenteret i den rette kontekst.
OpenAI's oprindelsessignaler
Hvilke oprindelsessignaler bruger OpenAI?
OpenAI bruger forskellige oprindelsessignaler til forskellige indholdstyper.
| Indholdstype | Oprindelsessignaler | Bemærkninger |
|---|---|---|
| Billeder | Content Credentials og SynthID-vandmærker | Billeder genereret med ChatGPT, Codex eller OpenAI API indeholder begge signaler. |
| Lyd | SynthID-vandmærker | Lyd genereret af ChatGPT eller OpenAI API indeholder et uhørligt vandmærke, som er indlejret i selve lyden. |
| Tekst | textGrain-vandmærker (kun EU) | I EU indeholder tekst genereret af ChatGPT en usynlig ændring af den tilfældighed, der indgår i modellens ordvalg, for at overholde EU’s AI-forordning. API-kunder i hele verden kan aktivere vandmærker i tekstoutput via deres projekt- eller organisationsindstillinger. |
| Video | Content Credentials | Sora er udfaset. Læs mere. |
Dækningen kan variere afhængigt af produkt, model, eksportmetode, filtype og tidspunktet for oprettelsen af indholdet. API-output er omfattet, bortset fra output fra modeller, der snart skal udfases, herunder gpt-image-1, gpt-image-1.5 og sora-2.
Hvorfor bruges der flere signaler til nogle indholdstyper?
Når det er teknisk muligt, kombinerer OpenAI metadata og vandmærker, så de kan kompensere for hinandens begrænsninger. Metadata kan indeholde detaljerede oplysninger, men platforme, redigeringsværktøjer og filkonverteringer kan fjerne dem. Vandmærker indeholder mindre kontekst, men fordi de er indlejret i selve det genererede indhold, kan de overleve visse ændringer, der fjerner metadata.
Hvor modstandsdygtige er oprindelsessignaler over for ændringer af indholdet?
SynthID-vandmærker til billeder og lyd samt textGrain-vandmærker til tekst er designet til at modstå almindelige ændringer. Afhængigt af indholdstypen kan det være mindre redigeringer, kopiering og indsættelse, beskæring eller skærmbilleder. Mere omfattende ændringer – såsom kraftig billedbeskæring, filkomprimering, omfattende parafrasering eller oversættelse – kan gøre det umuligt at registrere et vandmærke. Efter omfattende ændringer kan det også være mindre meningsfuldt at beskrive resultatet som »OpenAI-genereret«.
Content Credentials, udviklet af Coalition for Content Provenance and Authenticity, kan gå tabt ved almindelige handlinger, f.eks. når man tager et skærmbillede eller konverterer en fil. Når de stadig er tilgængelige, kan de give flere detaljer om en fils oprindelse og historik end et vandmærke alene.
Når det er teknisk muligt, bruger vi begge metoder for at øge sandsynligheden for, at oplysninger om oprindelse bevares, når indholdet ændres.
Hvad er Content Credentials, og hvad gør de muligt?
Content Credentials knytter oplysninger om en fils oprindelse og historik til filen, f.eks. hvilket værktøj der har oprettet den og hvornår. De bruger en åben standard udviklet af Coalition for Content Provenance and Authenticity (C2PA), og derfor kaldes de nogle gange »C2PA-metadata«.
Content Credentials hjælper folk med at verificere, hvor indhold kommer fra. De bruges til mere end AI-genereret indhold: Kameraproducenter, nyhedsorganisationer og andre bruger også standarden til at bekræfte deres mediers kilde og historik. Læs mere om C2PA.
Hvad er SynthID, og hvad gør teknologien muligt?
SynthID er en teknologi til usynlig vandmærkning, udviklet af Google DeepMind, som indlejrer et signal direkte i genererede medier. I modsætning til metadata er signalet en del af selve indholdet og kan blive bevaret gennem visse redigeringer eller ændringer. SynthID giver et ekstra oprindelsessignal sammen med C2PA-metadata. Hvis metadata f.eks. fjernes fra en fil, kan et indlejret vandmærke stadig give et signal om, at indholdet er genereret med understøttede OpenAI-værktøjer. Læs mere om SynthID.
Hvorfor vandmærker I tekstoutput?
Vi indfører vandmærkning af tekst for ChatGPT-brugere i EU for at overholde EU's AI-forordning og leve op til vores forpligtelser i henhold til EU's adfærdskodeks om gennemsigtighed i AI-genereret indhold, som OpenAI har underskrevet sammen med flere andre store AI-udbydere.
Hvad er textGrain, og hvad gør teknologien muligt?
textGrain er OpenAI's teknologi til vandmærkning af tekst. Den justerer diskret den måde, modellen tilfældigt vælger mellem mulige ord eller orddele på, mens den skriver. Disse valg skaber et mønster i en tekstpassage, som en detektor kan lede efter, selv efter visse redigeringer.
Vandmærket er en del af selve ordlyden og er ikke synligt for læserne. Det tilføjer ikke skjulte tegn, usynlige mellemrum eller usædvanlig tegnsætning. Vandmærkning af tekst understøtter overholdelsen af kravet i EU's AI-forordning om at mærke genereret tekst.
OpenAI's verifikationsværktøjer
Hvordan kan jeg tjekke, om indhold er genereret med OpenAI-værktøjer?
Du kan besøge openai.com/verify for at tjekke, om en understøttet billed- eller lydfil indeholder oprindelsessignaler, der er knyttet til indhold genereret eller eksporteret med OpenAI-værktøjer. Når du har uploadet en understøttet fil, søger værktøjet efter understøttede oprindelsessignaler fra OpenAI, såsom et SynthID-vandmærke eller et betroet C2PA-manifest knyttet til OpenAI. Hvis værktøjet finder et understøttet oprindelsessignal fra OpenAI, tyder det på, at indholdet er genereret af en OpenAI-model.
Udviklere og organisationer kan også bruge OpenAI’s Content Provenance API til at tjekke billeder og lyd for oprindelsessignaler fra OpenAI og integrere verificering i deres egne applikationer eller arbejdsgange. Organisationer med et anvendelsesformål, der opfylder kriterierne, kan ansøge om højere grænser.
I overensstemmelse med vores forpligtelser i henhold til EU’s AI-forordning kan organisationer med et anvendelsesformål, der opfylder kriterierne, ansøge om adgang til tekstdetektoren. Det gælder for eksempel akademiske institutioner og forskningsorganisationer, der undersøger teksters oprindelse, detektionens pålidelighed, eller hvordan folk forstår resultater om oprindelse. Vi vurderer ansøgninger fra kvalificerede organisationer enkeltvis og følger op efter behov med nyt om ansøgningen eller anmodninger om yderligere oplysninger. Vores tilgang til adgang kan ændre sig, efterhånden som vi får mere viden og forbedrer teknologien.
Vi samarbejder i øjeblikket med en mindre gruppe forskere, herunder John Thickstun, adjunkt i datalogi ved Cornell University, Martin Vechev, professor i datalogi ved ETH Zürich og videnskabelig direktør for INSAIT, samt forskere ved Kempelen Institute of Intelligent Technologies (KInIT). Formålet er at få en bedre forståelse af teknologiens muligheder og begrænsninger og bruge den viden til at forbedre vandmærkning af tekst.
Hvem kan få højere verifikationsgrænser, og koster det noget at foretage kontroller?
Kontroller via Content Provenance API er i øjeblikket gratis og underlagt forbrugsgrænser. Programmet for højere grænser fokuserer på projekter om indholds oprindelse i offentlighedens interesse og arbejdsgange, der sikrer informationsintegritet, og som opfylder kriterierne. Det omfatter f.eks. verifikation på nyhedsredaktioner, faktatjek, forskning i indholds oprindelse og myndighedstilsyn.
Almindelig erhvervsmæssig anvendelse er i øjeblikket ikke omfattet af programmet. Det gælder f.eks. kommerciel forebyggelse af svindel, autentificering og verifikation eller videresalg som en del af samlede tjenester til kontrol af oprindelse og dataanalyse.
Organisationer med et anvendelsesformål, der opfylder kriterierne, kan ansøge om højere grænser, men en indsendt ansøgning garanterer ikke godkendelse. Den offentlige API er fortsat tilgængelig med sine standardgrænser, også til mindre evalueringer. Se dokumentationen til Content Provenance API for de aktuelle forbrugsgrænser.
Hvem kan få adgang til tekstdetektoren, og koster det noget at foretage kontroller?
Kontroller med tekstdetektoren er i øjeblikket gratis. Anvendelsesformål, der opfylder kriterierne, omfatter akademiske institutioners og forskningsorganisationers undersøgelser af teksters oprindelse, detektionens pålidelighed eller folks forståelse af resultater om oprindelse.
Almindelig erhvervsmæssig anvendelse er i øjeblikket ikke omfattet af programmet. Det gælder f.eks. kommerciel forebyggelse af svindel, autentificering og verifikation eller videresalg som en del af samlede tjenester til kontrol af oprindelse og dataanalyse.
Anvendelse til kontrol af akademisk integritet, såsom at kontrollere studerendes arbejde for AI-brug (f.eks. ved skrivning af essays eller specialer), er også i øjeblikket ikke omfattet af programmet.
Hvad betyder verificeringsresultaterne?
Hvis der registreres et signal via openai.com/verify eller OpenAI’s Content Provenance API, betyder det, at det uploadede indhold indeholder et understøttet oprindelsessignal knyttet til OpenAI. Værktøjet bekræfter ikke, at indholdet er korrekt, uredigeret, lovligt ejet eller præsenteret i den rette kontekst. Det identificerer heller ikke, hvem der har oprettet indholdet, eller hvorfor det blev oprettet.
Hvis der ikke registreres et signal, betyder det, at værktøjet ikke fandt oprindelsessignaler udstedt af OpenAI i den uploadede fil. Indholdet kan stadig være genereret eller eksporteret af OpenAI, hvis:
Indholdet blev oprettet, før oprindelsessignaler var tilgængelige.
Indholdet kom fra et produkt, en model, en eksportmetode eller en filtype, der ikke understøttes.
Metadata blev fjernet under upload, download, redigering, konvertering eller deling.
Et vandmærke blev svækket af komprimering, beskæring, støj, redigering, formatkonvertering eller andre ændringer.
Et lydklip er for kort eller er blevet ændret væsentligt.
Hvordan får jeg det mest pålidelige verifikationsresultat?
Upload én understøttet fil ad gangen, og brug så vidt muligt den oprindelige eksporterede fil. For billeder bør du undgå at beskære eller konvertere filen, før du kontrollerer den. For lyd giver klip på mellem 10 og 60 sekunder generelt de bedste resultater. Selv hvis der ikke registreres noget signal, bør du tage filens kilde og kontekst i betragtning, før du drager en konklusion.
Viser resultaterne min prompt eller mine personoplysninger?
Oprindelsessignaler indeholder ikke oplysninger om brugeren, organisationen eller prompten.
Hvad sker der med indhold, som jeg verificerer via openai.com/verify eller Content Provenance API?
Indhold, der uploades til openai.com/verify eller indsendes til verificering via vores Content Provenance API, behandles udelukkende for at tjekke for understøttede oprindelsessignaler. Indholdet gemmes ikke, medmindre loven kræver det, og bruges ikke til at træne OpenAI-modeller.
Kan OpenAI registrere indhold, der er genereret med andre AI-værktøjer?
Vores værktøjer til kontrol af indholds oprindelse er designet til at registrere understøttede oprindelsessignaler knyttet til indhold, der er genereret af OpenAI-modeller eller eksporteret af OpenAI-værktøjer. De er ikke designet til at registrere indhold, der er genereret af andre AI-modeller, og de kan også overse OpenAI-genereret indhold, hvis det relevante signal mangler, ikke understøttes eller er svækket.
Sådan fungerer vandmærkning
Fastslår vandmærker ophav, ejerskab eller juridisk ansvar?
Nej. Et vandmærke er en indikation af, at en OpenAI-model sandsynligvis har genereret eller behandlet indholdet. I sig selv fastslår det ikke, hvem der har skabt eller ejer indholdet, om der var krav om oplysning om AI-brug, eller hvem der har det juridiske ansvar. Det fortæller heller ikke, om modellen redigerede indhold, som en bruger havde uploadet.
Viser vandmærker, i hvilket omfang en OpenAI-model har været involveret?
Nej. Detektoren oplyser, om den har fundet et vandmærke. Et fund er en indikation af, at en OpenAI-model sandsynligvis har genereret eller behandlet indholdet, men det viser ikke, om modellen har genereret noget af eller hele indholdet, eller hvor meget et menneske har bidraget.
Hvordan fungerer vandmærkning af tekst?
Vandmærkning af tekst skaber et hemmeligt mønster i modellens valg af ord og orddele, kaldet »token«, mens den skriver.
Ved hvert trin tildeler modellen hver mulig næste token en sandsynlighed. Vandmærkningssystemet opretter flere justerede sæt af disse sandsynligheder, som hver især favoriserer forskellige valg ud fra en hemmelig nøgle. Sættene er afbalanceret, så deres gennemsnit svarer til modellens oprindelige sandsynligheder. Nøglen vælger, hvilket sæt der skal bruges, og modellen foretager derefter et nyt tilfældigt valg ud fra dette sæt.
En detektor med den samme nøgle og tilsvarende indstillinger kan senere kontrollere, om teksten følger det hemmelige mønster oftere, end man ville forvente ved tilfældigheder.
Bruges tekstvandmærker i faktuel tekst og tekst leveret af brugeren?
Vandmærkning af tekst afhænger af, at modellen har forskellige måder at sige noget på. Der er mindre fleksibilitet, når et svar skal være meget faktuelt eller præcist, f.eks. svaret på en matematikopgave, eller når modellen bliver bedt om at gengive en angivet tekst uden ændringer. I disse tilfælde har modellen mindre mulighed for at ændre ordlyden, uden at det gør en mærkbar forskel, så vandmærket kan muligvis ikke registreres.
Bruges tekstvandmærker i korte svar og kode?
Korte passager indeholder som regel ikke nok tekst til, at vandmærker kan registreres pålideligt. Det er også sværere at vandmærke kode, fordi der er færre plausible muligheder for, hvad der kommer som det næste, end i almindelig prosa.
For at tage højde for disse begrænsninger kræver adfærdskodeksen om gennemsigtighed i AI-genereret indhold under EU's AI-forordning ikke vandmærker i output på under 200 token – cirka 150 ord på engelsk – eller i kodestykker.
Hvordan varierer detektionen af tekstvandmærker fra sprog til sprog?
Detektionsraterne varierer fra sprog til sprog, og i øjeblikket er det lettere at registrere vandmærker på nogle sprog end på andre. Vi kan justere vandmærkets styrke for at forbedre detektionen på sprog, hvor signalet er svagere.
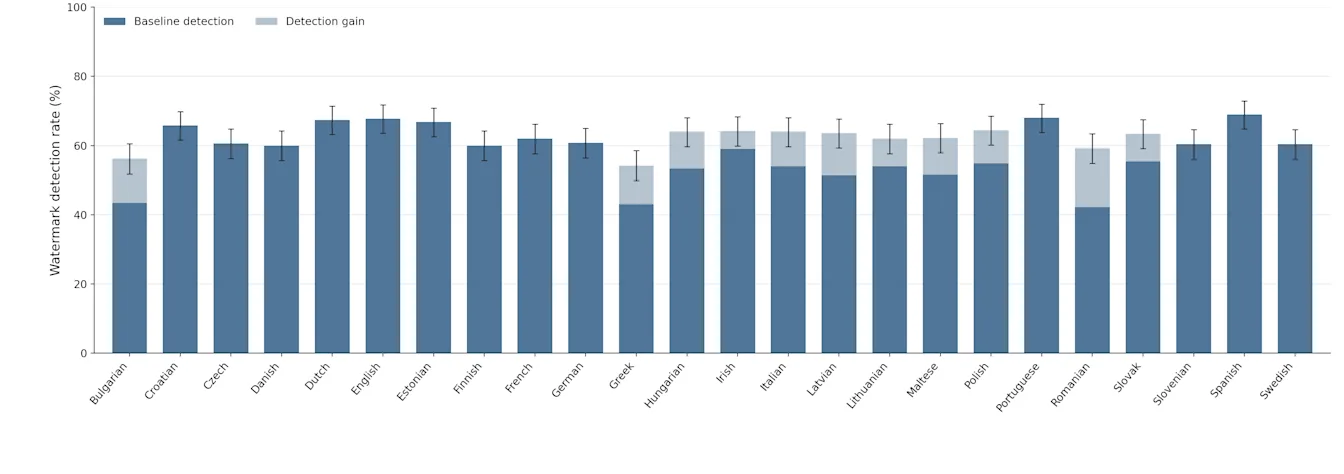
Dette diagram viser detektionsraten for alle 24 officielle EU-sprog. Vi genererede først 500 syntetiske engelske prompts om forskellige emner og oversatte dem derefter til de øvrige 23 sprog. Ved en falsk positiv-rate på 1 % har spansk den højeste detektionsrate (69,0 %), mens rumænsk har den laveste (42,2 %). Vores vandmærke har en justerbar styrkeparameter – en »drejeknap«, der styrker eller svækker vandmærkesignalet inden for forskellige områder. Med denne drejeknap kunne vi øge styrken for sprog med detektionsrater under 60 %. De lyseblå dele af søjlerne viser de opnåede forbedringer.
Forringer tekstvandmærker modellens kvalitet?
Ifølge vores test gør de ikke. På tværs af de benchmarks, vi bruger til at vurdere Astra, vores nyeste banebrydende model, ligger forskellene i ydeevne med og uden vandmærkning inden for de tilfældige udsving, vi typisk ser mellem evalueringer. Tidligere test i ChatGPT viste heller ingen ændring i andelen af negative bedømmelser eller andre produktmålinger ved indførelsen af vandmærkning.
Gør tekstvandmærker modellen langsommere?
Vandmærkning af tekst har en ubetydelig indvirkning på vores modellers hastighed.
Hvordan adskiller OpenAI’s tekstvandmærker sig fra tredjepartsværktøjer til AI-detektion?
Tredjepartsværktøjer til detektion, såsom Pangram, bruger typisk klassifikatorer til at identificere AI-genereret tekst ud fra mønstre i blandt andet ordvalg. Denne tilgang analyserer teksten, efter at den er genereret, i stedet for at registrere et indlejret signal. EU’s AI-forordning kræver specifikt, at der indlejres et signal i genereret tekst.
Hvorfor bruger I jeres egne tekstvandmærker i stedet for TextSeal eller SynthID?
Vi udviklede vores egen metode til vandmærkning af tekst, kaldet textGrain, for at få mere kontrol end med SynthID eller TextSeal over balancen mellem, hvor let vandmærket kan registreres, og hvor varierede svar der genereres ud fra samme prompt. I vores test identificerede vores metode korrekt en tilsvarende eller større andel af vandmærkede tekstprøver end SynthID til tekst. Vi planlægger at udgive textGrain som open source-teknologi, så andre kan bygge videre på den og hjælpe med at forbedre vandmærkning af tekst.
Tilføjer vandmærkning af tekst skjulte tegn, ekstra token eller synlige ændringer?
Nej. Vandmærkning af tekst ændrer det statistiske mønster i ordvalget. Det indsætter ikke skjulte tegn eller tilføjer token, der kun bruges til vandmærket. Vandmærket er ikke synligt for læserne, og kopiering og indsættelse af teksten tilføjer ikke skjult materiale.
Vejledning til kunder
Jeg er API-kunde. Hvordan aktiverer jeg tekstvandmærker?
Kunder, der bruger OpenAI API, kan aktivere vandmærkning af tekst for et bestemt projekt via Indstillinger eller for hele organisationen via Organisationsindstillinger. I begge tilfælde kan kunder vælge, hvilke modeller der skal bruge tekstvandmærker. Når funktionen er aktiveret for en understøttet model, tilføjer OpenAI vandmærket, mens teksten genereres. Kunder behøver ikke at tilføje en separat markering til hvert svar.
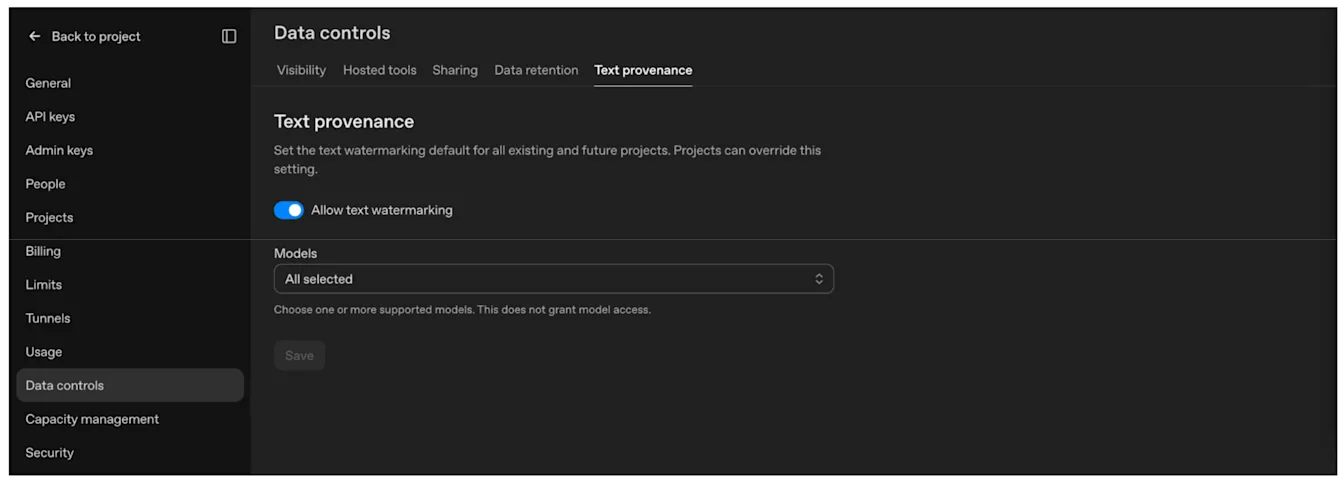
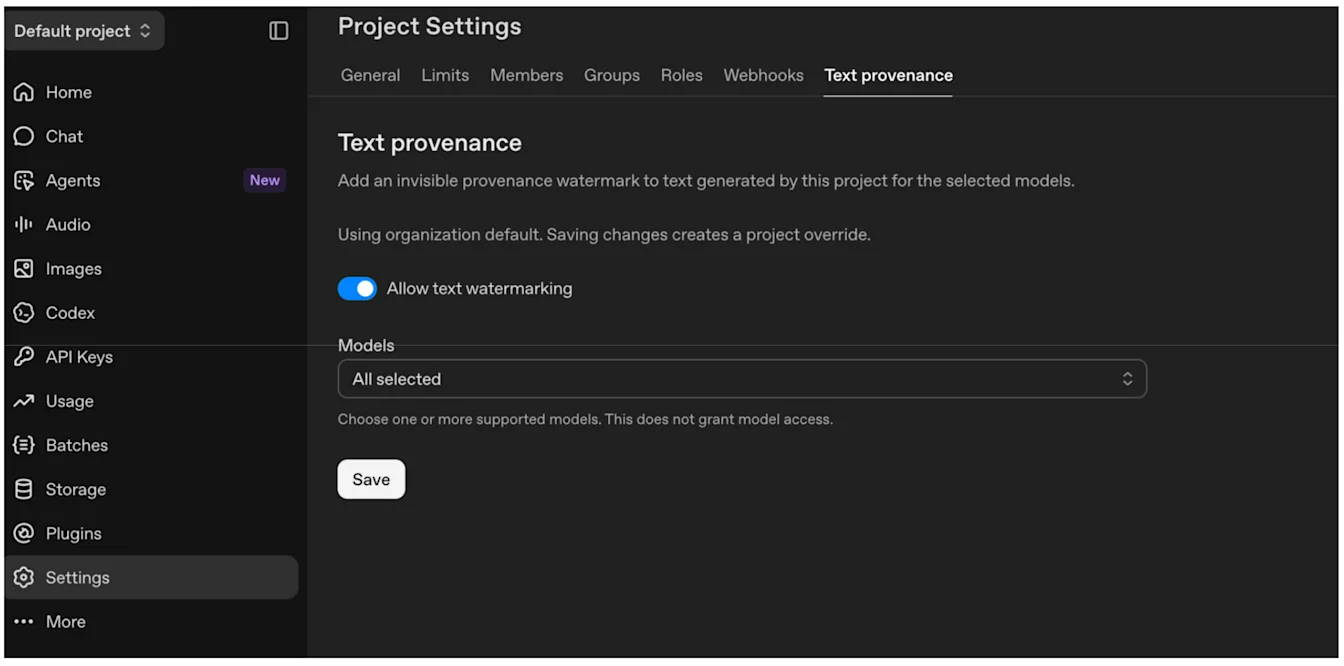
Aktivér Tillad vandmærkning af tekst, vælg dine modeller, og vælg derefter Gem.
Standard for organisationen: Gå til Organisationsindstillinger > Datakontrol.
Vælg Tekstens oprindelse.
Tilsidesættelse for projektet: Gå til Projektindstillinger > Tekstens oprindelse.
Hvilke modeller kan jeg aktivere vandmærker for?
Under Indstillinger og Organisationsindstillinger kan kunder se listen over modeller, der i øjeblikket understøtter vandmærkning. I løbet af de kommende uger udvider vi understøttelsen til alle ældre modeller.
Får jeg også adgang til tekstdetektoren, når jeg aktiverer tekstvandmærker?
Nej. Adgangen til tekstdetektoren er i øjeblikket begrænset til godkendte forskningsorganisationer og akademiske institutioner, der arbejder på at forbedre vandmærkningens pålidelighed og brugervenlighed samt gøre teknologien og dens resultater lettere at forklare. Dette er i overensstemmelse med vores forpligtelser i henhold til adfærdskodeksen om gennemsigtighed i AI-genereret indhold under EU's AI-forordning.
Bliver signalerne bevaret i indholdet, når jeg ændrer det?
Det kan de blive, men det afhænger af signalet og de ændringer, du foretager.
For understøttede billeder og lydfiler bør du gemme en original kopi og bruge Content Provenance API til at teste repræsentative filer efter redigering, konvertering og offentliggørelse. For billeder kan beskæring, tilføjelse af støj, konvertering til JPEG og skærmbilleder gøre signalerne sværere at registrere. Du kan kun teste tekst på denne måde, hvis din organisation har fået godkendt adgang til tekstdetektoren.
Hvis dit filformat og din arbejdsgang understøtter det, bør du bevare eksisterende C2PA-metadata og inkludere Content Credentials i de filer, du opretter. Du kan også overveje at tilføje dine egne markeringer for at gøre oplysninger om oprindelse mere holdbare eller nyttige. Se den tekniske dokumentation for C2PA for detaljer om implementeringen.
For tekst er vandmærket en del af modellens ordvalg. Hvis du bevarer ordlyden, forventes signalet at blive bevaret, når du genbruger teksten, uden yderligere integrationsarbejde. Omfattende omskrivning, omformulering eller oversættelse kan gøre detektionen mindre pålidelig. Selv uændret ordlyd garanterer ikke, at vandmærket kan registreres, især i korte passager eller tekst med begrænsede muligheder for at variere ordvalget.
Jeg bruger OpenAI’s modeller via en cloudtjeneste. Indeholder disse output også oprindelsessignaler?
Vi samarbejder med alle vores cloud- og distributionsudbydere om at sikre, at oprindelsessignaler, herunder vandmærker, indlejres i alle relevante output, herunder billeder, lyd og tekst. Tilgængeligheden kan variere afhængigt af output og partner.
Erstatter oprindelsessignaler synlige AI-mærkninger eller andre oplysninger om AI-brug?
Nej. Vandmærker og C2PA-metadata giver oplysninger, som software kan læse. De erstatter ikke synlige mærkninger, bannere eller andre meddelelser, der kan være påkrævet.
Om du skal give yderligere oplysninger, afhænger af, hvordan og hvor du bruger indholdet. OpenAI kan ikke rådgive dig om dine specifikke juridiske forpligtelser. Dit juridiske team bør vurdere kravene til din brug.
Jeg har flere spørgsmål om EU’s AI-forordning
Send en forespørgsel om EU’s AI-forordning, så vender vi tilbage til dig.