
OpenAI möchte Modelle entwickeln, die für Entwickler:innen in einer Vielzahl von Bereichen und Anwendungen nützlich sind. Wir verbessern unsere Modelle durch Forschungsfortschritte und indem wir sie auf reale Herausforderungen und Kontexte anwenden.
Standardmäßig verwenden wir keinerlei Eingaben oder Ausgaben aus unseren Produkten von Geschäftsnutzer:innen, einschließlich ChatGPT Business, ChatGPT Enterprise und der API, um unsere Modelle zu verbessern. Wir erkennen jedoch an, dass API-Nutzer:innen derzeit Einschränkungen dabei haben, diese Modelle so anzupassen, dass sie sich mit ihren spezifischen Anforderungen weiterentwickeln.
Eine Möglichkeit, zu dieser Verbesserung beizutragen, besteht darin, der Freigabe von Feedback, Evaluierungs- und Fine-Tuning-Daten oder API-Ein- und -Ausgaben an OpenAI zuzustimmen. Organisationen, die sich dafür entscheiden, können diese Optionen auf Projekt- oder Organisationsebene über ihre Einstellungen zur Datenkontrolle verwalten. Von Ihnen geteilte Daten werden verwendet, um Nutzungsmuster zu identifizieren, die Modellqualität zu messen und die künftige Evaluierung und das Training von Modellen zu unterstützen.
Bei der Nutzung der OpenAI API behalten Sie stets die Kontrolle über Ihre Daten und Ihre Privatsphäre. Sie können Ihre Einstellungen jederzeit ändern und sich wieder dagegen entscheiden. Zum Schutz der Privatsphäre von Menschen ergreifen wir Maßnahmen, um die Menge personenbezogener Daten in unseren Trainingsdatensätzen zu verringern, bevor sie für Modellverbesserungen und Training verwendet werden.
Bitte beachten Sie, dass Sie durch das Teilen von Daten aus Ihrer Organisation mit OpenAI bestätigen, dass Sie über die entsprechenden Berechtigungen verfügen, damit OpenAI diese Daten wie in diesem Artikel beschrieben verarbeiten und verwenden darf. Bitte nehmen Sie keine sensiblen, vertraulichen oder geschützten Informationen in die von Ihnen geteilten Daten auf.
Sie müssen Organisationsinhaber:in sein, um der Datenfreigabe an OpenAI zuzustimmen. Konten mit aktivierter keine Datenaufbewahrung können unsere Mechanismen zur Datenfreigabe nicht nutzen.
So teilst du Feedback über das API-Dashboard
Die Möglichkeit, Feedback über den Playground zu teilen, ist standardmäßig für alle Organisationen deaktiviert. Wenn ein Kontoinhaber der Freigabe von Feedback zu API-Modellen für seine Organisation zustimmen möchte, kann er auf der Seite mit den Organisationseinstellungen „Aktiviert“ oder „Für ausgewählte Projekte aktiviert“ auswählen.
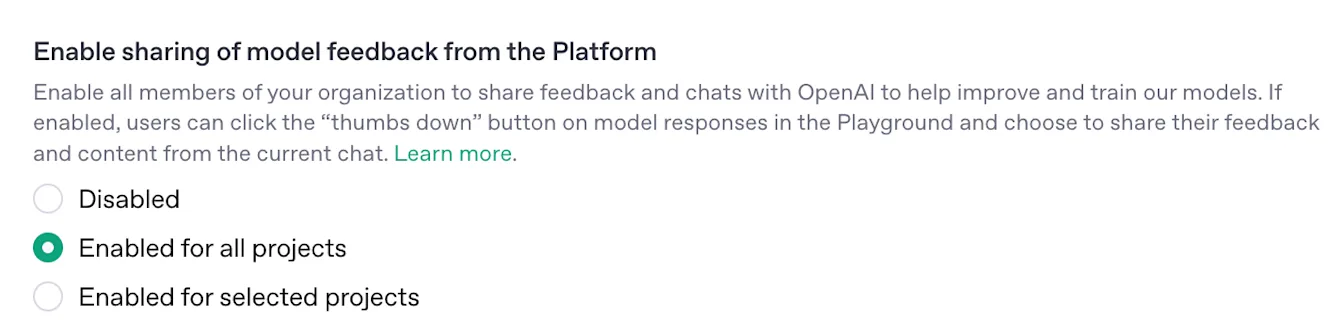
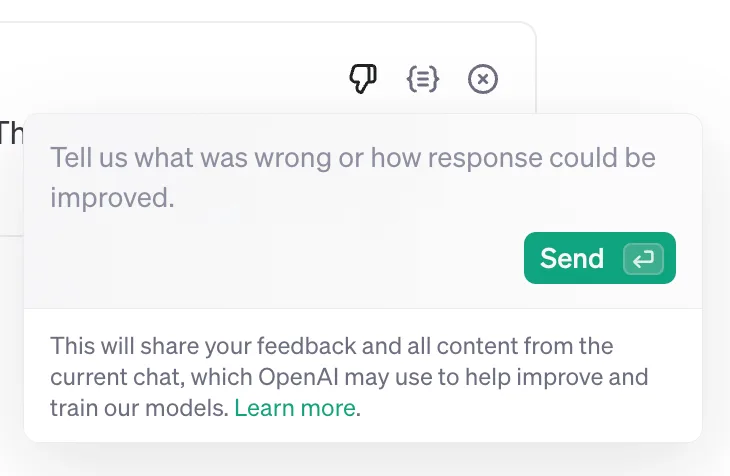
Wenn die Einstellung auf „Aktiviert“ gesetzt ist, sehen Mitglieder einer Organisation im Playground bei Modellantworten eine Schaltfläche mit einem nach unten zeigenden Daumen. Wenn sie darauf klicken, können sie Feedback und den bisherigen Gesprächsverlauf einschließlich Eingaben, Ausgaben und hochgeladener Dateien mit unseren Feedbacksystemen teilen.
So teilst du Evaluierungs- und Fine-Tuning-Daten mit OpenAI
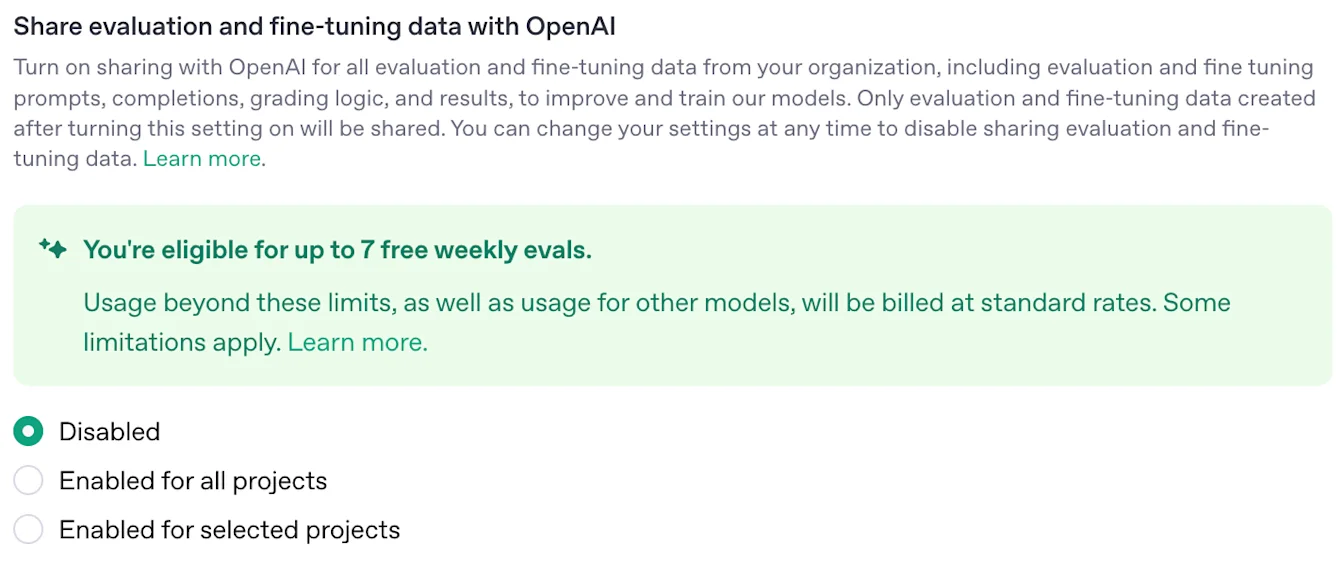
Die Freigabe von Evaluierungs- und Fine-Tuning-Daten ist standardmäßig für alle Organisationen deaktiviert. Kontoinhaber können diese Funktion über die Einstellungsseite ihrer Organisation für alle oder nur für ausgewählte Projekte aktivieren. Kontoinhaber können diese Einstellungen jederzeit ändern und die Teilnahme wieder beenden. Diese Einstellung ist für bestimmte Organisationen nicht verfügbar, darunter Unternehmen, für die „keine Datenaufbewahrung“ aktiviert ist.
Wenn die Einstellung auf „Aktiviert“ gesetzt ist, werden Evaluierungs- und Fine-Tuning-Daten, die in aktivierten Projekten an OpenAI gesendet werden, mit OpenAI geteilt. Evaluierungen, die du mit OpenAI teilst, werden derzeit für bis zu 7 Durchläufe pro Woche kostenlos verarbeitet. Wenn du Daten für Aufträge zum Reinforcement Fine-Tuning teilst, wird die Nutzung der daraus entstehenden Modelle zu vergünstigten Inferenzpreisen abgerechnet.
So teilst du Ein- und Ausgaben mit OpenAI
Die Datenfreigabe für Ein- und Ausgaben ist standardmäßig für alle Organisationen deaktiviert. Verantwortliche für das Konto können diese Funktion auf der Einstellungsseite ihrer Organisation für alle oder nur für ausgewählte Projekte aktivieren. Verantwortliche für das Konto können diese Einstellungen jederzeit ändern und die Funktion wieder deaktivieren. Diese Einstellung ist für bestimmte Organisationen nicht verfügbar, darunter Enterprise-Kunden und Unternehmen, für die keine Datenaufbewahrung aktiviert ist.

Bei der Einstellung „Aktiviert“ werden Ein- und Ausgaben, die in entsprechend aktivierten Projekten an OpenAI gesendet werden, mit OpenAI geteilt.
Kostenlose Tokens für Prompts und Vervollständigungen, die mit OpenAI geteilt werden
Einige Organisationen können für Datenverkehr, den sie mit OpenAI teilen, täglich kostenlose Tokens erhalten.
Wie erfahre ich, ob ich für die kostenlosen Tokens berechtigt oder dafür angemeldet bin?
Ob du für das Angebot berechtigt bist, kannst du auf der Einstellungsseite zur Datenfreigabe prüfen. Dort wird gegebenenfalls das Angebot „Du bist für die kostenlose tägliche Nutzung von Datenverkehr berechtigt, den du mit OpenAI teilst“ angezeigt. Wenn du die Datenfreigabe aktivierst und für kostenlose Tokens berechtigt bist, wird „Du bist für kostenlose tägliche Tokens angemeldet“ angezeigt.
OpenAI wird dieses Programm 30 Tage im Voraus ankündigen, bevor es beendet wird.
So sieht das Angebot für berechtigte Personen in Launch und Grow aus:

So sieht das entsprechende Angebot für berechtigte Personen in Build aus:

Wenn dieser Text auf deiner Seite zur Datenfreigabe nicht angezeigt wird, bist du derzeit nicht für die kostenlosen Token berechtigt.
Wie kann ich prüfen, ob ich die täglichen kostenlosen Token erhalte? Werden sie automatisch angerechnet oder muss ich sie aktivieren?
Wenn du der Freigabe deines Datenverkehrs für OpenAI zustimmst und für das Angebot berechtigt bist, werden die kostenlosen Token automatisch auf den Datenverkehr angerechnet, den du bei den unten aufgeführten Modellen mit OpenAI teilst.
Feinabgestimmte Modelle, das Training zur Feinabstimmung, Evaluierungen und die Werkzeugnutzung sind nicht enthalten.
Beachte, dass du die kostenlosen Token nur für Datenverkehr erhältst, den du mit OpenAI teilst. Wenn du also die Freigabe nur für bestimmte Projekte aktivierst, qualifiziert sich nur die Nutzung in diesen Projekten für die kostenlosen Token. Du benötigst ein positives Kontoguthaben, um OpenAI-Modelle und die kostenlosen Token zu nutzen.
Du kannst die Nutzung deiner kostenlosen Token prüfen, indem du in deinem Nutzungsdashboard die Nutzungsaktivität (bei der die kostenlosen Token in der Gesamtsumme enthalten sind) mit den Kosten (bei denen die kostenlosen Token nicht als Kosten erscheinen) vergleichst. Wähle sowohl „Eingabe-Token“ als auch „Ausgabe-Token“ aus, um deine vollständige Nutzung im Nutzungsdashboard zu sehen.
Du kannst die kostenlosen Token auch in deinem Dashboard unter https://platform.openai.com/usage/chat-completions anzeigen, indem du nach „Servicestufe“ gruppierst. Die kostenlosen Token werden als „Anreizstufe für Datenfreigabe – Eingabe-/Ausgabe-Token“ angezeigt. Beziehe sowohl Eingabe- als auch Ausgabe-Token ein, um die gesamte Nutzung zu sehen. Beachte, dass die Gesamtzahl der Token in der Anreizstufe für Datenfreigabe je nach Anfragegröße von genau 1 Mio. oder 10 Mio. abweichen kann (siehe „Wie funktioniert das Token-Limit und wann wird es zurückgesetzt?“ weiter unten).
Welche Modelle sind in diesem Angebot enthalten?
Dieses Angebot gilt nur für die folgenden Modelle. Das Token-Kontingent wird innerhalb der Modellgruppen gemeinsam genutzt. Per Fine-Tuning angepasste Modelle, Fine-Tuning-Training, Evaluierungen und die Nutzung von Tools sind nicht enthalten.
Gruppe mit 1 Mio. Token für Launch und Grow (250.000 für Build):
gpt-6.1-sol
gpt-6-astra
gpt-6-sol
gpt-6-luna
gpt-5.6-sol
gpt-5.5-2026-04-23
gpt-5.4-2026-03-05
gpt-5.2-2025-12-11
gpt-5.1-2025-11-13
gpt-5.1-codex
gpt-5-codex
gpt-5-2025-08-07
gpt-5-chat-latest
gpt-4.5-preview-2025-02-27 (veraltet und seit dem 14.07.2025 abgeschaltet)
gpt-4.1-2025-04-14
gpt-4o-2024-05-13
gpt-4o-2024-08-06
gpt-4o-2024-11-20
o3-2025-04-16
o1-preview-2024-09-12
o1-2024-12-17
Gruppe mit 10 Mio. Token für Launch und Grow (2,5 Mio. für Build):
gpt-5.6-terra
gpt-5.6-luna
gpt-5.4-mini-2026-03-17
gpt-5.4-nano-2026-03-17
gpt-5.1-codex-mini
gpt-5-mini-2025-08-07
gpt-5-nano-2025-08-07
gpt-4.1-mini-2025-04-14
gpt-4.1-nano-2025-04-14
gpt-4o-mini-2024-07-18
o4-mini-2025-04-16
o1-mini-2024-09-12
codex-mini-latest
Wie funktioniert das Token-Limit und wann wird es zurückgesetzt?
Für jede der oben aufgeführten Modellgruppen gilt ein eigenes tägliches Limit für kostenlose Token, das alle Modelle der jeweiligen Gruppe gemeinsam nutzen. Berechtigte Organisationen in Build erhalten bis zu 250.000 Token für die erste Gruppe und 2,5 Millionen für die zweite. Berechtigte Organisationen in Launch und Grow erhalten bis zu 1 Million Token für die erste Gruppe und 10 Millionen für die zweite.
Wenn deine Gesamtnutzung innerhalb der jeweiligen Modellgruppe das Limit von 1 Mio./250.000 bzw. 10 Mio./2,5 Mio. Token überschreitet, wird der Mehrverbrauch zu den regulären Preisen berechnet. Wenn du beispielsweise an einem Tag 750.000 Token mit o1 und anschließend 500.000 Token mit gpt-4o nutzt, werden dir 250.000 Token als Mehrverbrauch berechnet.
Bei jeder neuen Anfrage prüfen wir Ihre laufende Tagessumme. Würde eine einzelne Anfrage dazu führen, dass Ihre Tagessumme die Token-Quote überschreitet, wird diese gesamte Anfrage zu den regulären Sätzen berechnet.
Beispiel für das tägliche Kontingent von 1 Mio. Tokens:
| Uhrzeit (UTC) | Tokens in der Anfrage | Laufende Summe | Kostenlos oder kostenpflichtig? |
| 09:15 | 120 k | 120 k | Kostenlos |
| 12:40 | 140 k | 260 k | Kostenlos |
| 14:30 | 150 k | 410 k | Kostenlos |
| 16:00 | 150 k | 560 k | Kostenlos |
| 18:05 | 150 k | 710 k | Kostenlos |
| 20:20 | 150 k | 860 k | Kostenlos |
| 22:15 | 115 k | 975 k | Kostenlos |
| 23:10 | 30 k | 1 005 k | Kostenpflichtig (alle 30.000) |
In diesem Beispiel sind die ersten sieben Anfragen kostenlos. Mit der achten Anfrage würde die Summe 1 Million Tokens überschreiten. Daher wird sie vollständig berechnet. Der Zähler für kostenlose Tokens wird täglich um 00:00 Uhr UTC zurückgesetzt.
Seit dem 6. März 2025 werden die Tokens täglich um 00:00 Uhr UTC zurückgesetzt. Diese Änderung verbessert die Vorhersehbarkeit und Nachvollziehbarkeit.
Kann ich mich abmelden, wenn ich meine Daten nicht teilen oder diese Tokens nicht erhalten möchte?
Du kannst die Teilnahme jederzeit auf deiner Einstellungsseite zur Datenfreigabe beenden.
Wer kann in meiner API-Organisation auf diese Einstellung zugreifen und sie aktivieren oder deaktivieren?
Nur Organisationsinhaber können auf diese Einstellung zugreifen und sie aktivieren oder deaktivieren.
Weitere Informationen zur Verarbeitung deiner Daten findest du in diesem Artikel im Hilfecenter und auf unserer Seite zum Datenschutz für Unternehmen.