
OpenAI setzt sich für ein sichereres und transparenteres KI-Ökosystem ein. Dazu nutzen wir Herkunftssignale, die Menschen helfen zu erkennen, ob Inhalte mit einem OpenAI-Modell generiert wurden.
Herkunftssignale können nützliche Informationen zur Herkunft liefern. Sie garantieren jedoch nicht, dass Inhalte korrekt, unbearbeitet, rechtmäßig im Besitz einer Person oder Organisation oder im richtigen Kontext dargestellt sind.
Herkunftssignale von OpenAI
Welche Herkunftssignale verwendet OpenAI?
OpenAI verwendet je nach Inhaltstyp unterschiedliche Herkunftssignale.
| Inhaltstyp | Herkunftssignale | Hinweise |
|---|---|---|
| Bilder | Content Credentials und SynthID-Wasserzeichen | Bilder, die mit ChatGPT, Codex oder der OpenAI API generiert werden, enthalten beide Signale. |
| Audio | SynthID-Wasserzeichen | Audio, das mit ChatGPT oder der OpenAI API generiert wird, enthält ein unhörbares Wasserzeichen, das in das Audiomaterial selbst eingebettet ist. |
| Text | textGrain-Wasserzeichen (nur EU) | In der EU wird bei Texten, die ChatGPT generiert, die zufällige Wortauswahl des Modells unsichtbar verändert, um die EU-KI-Verordnung einzuhalten. Wer die API nutzt, kann weltweit in den Projekt- oder Organisationseinstellungen Textwasserzeichen für Textausgaben aktivieren. |
| Video | Content Credentials | Sora wurde eingestellt. Mehr erfahren. |
Die Abdeckung kann je nach Produkt, Modell, Exportweg, Dateityp und Erstellungszeitpunkt des Inhalts variieren. API-Ausgaben sind abgedeckt, ausgenommen Modelle, deren baldige Einstellung geplant ist, darunter gpt-image-1, gpt-image-1.5 und sora-2.
Warum werden bei manchen Inhaltstypen mehrere Signale verwendet?
Wenn es technisch möglich ist, kombiniert OpenAI Metadaten und Wasserzeichen, damit sie ihre jeweiligen Schwächen gegenseitig ausgleichen können. Metadaten können detaillierte Informationen enthalten, aber durch Plattformen, Bearbeitungstools und Dateikonvertierungen entfernt werden. Wasserzeichen enthalten weniger Kontext. Da sie jedoch in den generierten Inhalt selbst eingebettet sind, können sie manche Veränderungen überstehen, bei denen Metadaten entfernt werden.
Wie robust sind Herkunftssignale gegenüber Änderungen am Inhalt?
SynthID-Wasserzeichen für Bilder und Audio sowie textGrain-Wasserzeichen für Text sind darauf ausgelegt, gängige Änderungen zu überstehen. Je nach Inhaltstyp können dazu kleinere Bearbeitungen, Kopieren und Einfügen, Zuschneiden oder Screenshots gehören. Umfangreichere Änderungen wie starkes Zuschneiden von Bildern, Dateikomprimierung, erhebliche Umformulierungen oder Übersetzungen können dazu führen, dass ein Wasserzeichen nicht mehr erkennbar ist. Nach umfangreichen Änderungen kann auch die Beschreibung des Ergebnisses als „von OpenAI generiert“ weniger aussagekräftig sein.
Content Credentials, die von der Coalition for Content Provenance and Authenticity entwickelt wurden, können bei alltäglichen Vorgängen verloren gehen, etwa beim Erstellen eines Screenshots oder beim Konvertieren einer Datei. Bleiben sie erhalten, können sie mehr Details über die Herkunft und den Verlauf einer Datei liefern als ein Wasserzeichen allein.
Wo es technisch möglich ist, nutzen wir beide Methoden, damit Herkunftsinformationen Änderungen am Inhalt mit höherer Wahrscheinlichkeit überstehen.
Was sind Content Credentials und was ermöglichen sie?
Content Credentials fügen einer Datei Informationen über ihre Herkunft und ihren Verlauf hinzu, etwa mit welchem Tool und wann sie erstellt wurde. Sie nutzen einen offenen Standard der Coalition for Content Provenance and Authenticity (C2PA) und werden deshalb manchmal als „C2PA-Metadaten“ bezeichnet.
Content Credentials helfen Menschen, die Herkunft von Inhalten zu überprüfen. Sie werden nicht nur für KI-generierte Inhalte verwendet: Auch Kamerahersteller, Nachrichtenorganisationen und andere nutzen den Standard, um die Quelle und den Verlauf ihrer Medien zu bescheinigen. Mehr über C2PA erfahren.
Was ist SynthID und was ermöglicht es?
SynthID ist eine von Google DeepMind entwickelte Technologie für unsichtbare Wasserzeichen, die ein Signal direkt in generierte Medien einbettet. Anders als Metadaten ist das Signal Teil des Inhalts selbst und kann manche Bearbeitungen oder Veränderungen überstehen. SynthID liefert neben C2PA-Metadaten ein zusätzliches Herkunftssignal. Werden beispielsweise Metadaten aus einer Datei entfernt, kann ein eingebettetes Wasserzeichen weiterhin darauf hinweisen, dass der Inhalt mit unterstützten OpenAI-Tools generiert wurde. Mehr über SynthID erfahren.
Warum verseht ihr Textausgaben mit Wasserzeichen?
Wir führen Textwasserzeichen für Menschen ein, die ChatGPT in der EU nutzen, um die EU-KI-Verordnung einzuhalten. Dies entspricht auch unseren Zusagen im Rahmen des EU-Verhaltenskodex zur Transparenz KI-generierter Inhalte, den OpenAI zusammen mit mehreren anderen großen KI-Anbietern unterzeichnet hat.
Was ist textGrain und was ermöglicht es?
textGrain ist die Technologie von OpenAI für Textwasserzeichen. Sie verändert geringfügig, wie das Modell beim Schreiben zufällig zwischen möglichen Wörtern oder Wortteilen auswählt. Über eine Textpassage hinweg entsteht dadurch ein Muster, nach dem ein Detektor suchen kann, auch nach manchen Bearbeitungen.
Das Wasserzeichen ist Teil der Formulierung selbst und beim Lesen nicht sichtbar. Es fügt keine versteckten Zeichen, unsichtbaren Leerzeichen oder ungewöhnlichen Satzzeichen hinzu. Textwasserzeichen unterstützen die Einhaltung der in der EU-KI-Verordnung vorgesehenen Pflicht, generierte Texte zu kennzeichnen.
Tools von OpenAI zur Überprüfung
Wie kann ich prüfen, ob Inhalte mit Tools von OpenAI generiert wurden?
Auf openai.com/verify kannst du prüfen, ob eine unterstützte Bild- oder Audiodatei Herkunftssignale enthält, die auf mit OpenAI-Tools generierte oder exportierte Inhalte hinweisen. Nachdem du eine unterstützte Datei hochgeladen hast, sucht das Tool nach unterstützten Herkunftssignalen von OpenAI, etwa einem SynthID-Wasserzeichen oder einem vertrauenswürdigen C2PA-Manifest, das OpenAI zugeordnet ist. Findet das Tool ein unterstütztes Herkunftssignal von OpenAI, deutet dies darauf hin, dass der Inhalt wahrscheinlich von einem OpenAI-Modell generiert wurde.
Entwicklungsteams und Organisationen können auch die Content Provenance API von OpenAI nutzen, um Bilder und Audio auf Herkunftssignale von OpenAI zu prüfen und die Überprüfung in ihre eigenen Anwendungen oder Arbeitsabläufe zu integrieren. Organisationen mit einem geeigneten Anwendungsfall können höhere Limits beantragen.
Im Einklang mit unseren Verpflichtungen aus der EU-KI-Verordnung können Organisationen mit einem geeigneten Anwendungsfall Zugang zum Textdetektor beantragen. Dazu zählen Hochschulen und Forschungseinrichtungen, die die Herkunft von Texten, die Zuverlässigkeit der Erkennung oder das Verständnis von Ergebnissen zur Herkunftsprüfung untersuchen. Wir prüfen die Anträge geeigneter Organisationen im Einzelfall und melden uns gegebenenfalls mit Neuigkeiten oder der Bitte um weitere Informationen. Unser Ansatz für den Zugang kann sich mit neuen Erkenntnissen und Verbesserungen der Technologie weiterentwickeln.
Wir arbeiten derzeit mit einer kleinen Gruppe von Forschenden zusammen, um die Möglichkeiten und Grenzen der Technologie besser zu verstehen und Textwasserzeichen zu verbessern. Dazu gehören John Thickstun, Assistant Professor of Computer Science an der Cornell University, Martin Vechev, Professor of Computer Science an der ETH Zurich und Scientific Director von INSAIT, sowie Forschende am Kempelen Institute of Intelligent Technologies (KInIT).
Wer erhält höhere Limits für die Überprüfung und sind die Prüfungen kostenpflichtig?
Prüfungen über die Content Provenance API sind derzeit kostenlos und unterliegen Nutzungslimits. Das Programm für höhere Limits richtet sich an geeignete Projekte zur Herkunftsprüfung im öffentlichen Interesse und an Arbeitsabläufe zur Wahrung der Informationsintegrität. Dazu zählen etwa Überprüfungen in Redaktionen, Faktenchecks, Forschung zur Herkunft von Inhalten und behördliche Aufsicht.
Allgemeine geschäftliche Anwendungen fallen derzeit nicht unter das Programm, etwa kommerzielle Betrugsprävention, Authentifizierung und Überprüfung oder der Weiterverkauf als Teil gebündelter Dienste zur Herkunftsprüfung und Datenanalyse.
Organisationen mit einem geeigneten Anwendungsfall können höhere Limits beantragen. Das Einreichen eines Antrags garantiert jedoch keine Genehmigung. Die öffentliche API bleibt mit ihren Standardlimits verfügbar, auch für kleinere Evaluationen. Die aktuellen Nutzungslimits findest du in der Dokumentation zur Content Provenance API.
Wer erhält Zugang zum Textdetektor und sind die Prüfungen kostenpflichtig?
Prüfungen mit dem Textdetektor sind derzeit kostenlos. Zu den geeigneten Anwendungsfällen zählen Untersuchungen von Hochschulen und Forschungseinrichtungen zur Herkunft von Texten, zur Zuverlässigkeit der Erkennung oder dazu, wie Menschen Ergebnisse zur Herkunftsprüfung verstehen.
Allgemeine geschäftliche Anwendungen fallen derzeit nicht unter das Programm, etwa kommerzielle Betrugsprävention, Authentifizierung und Überprüfung oder der Weiterverkauf als Teil gebündelter Dienste zur Herkunftsprüfung und Datenanalyse.
Anwendungen zur Wahrung der akademischen Integrität fallen ebenfalls derzeit nicht unter das Programm. Dazu zählt etwa die Prüfung studentischer Arbeiten auf KI-Nutzung, beispielsweise beim Schreiben von Essays oder Abschlussarbeiten.
Was bedeuten die Prüfergebnisse?
Wenn über openai.com/verify oder die Content Provenance API von OpenAI ein Signal erkannt wird, bedeutet dies, dass der hochgeladene Inhalt ein unterstütztes Herkunftssignal enthält, das OpenAI zugeordnet ist. Das Tool bestätigt nicht, dass der Inhalt korrekt, unbearbeitet, rechtmäßig im Besitz einer Person oder Organisation oder im richtigen Kontext dargestellt ist. Es zeigt auch nicht, wer den Inhalt erstellt hat oder warum er erstellt wurde.
Wird kein Signal erkannt, bedeutet dies, dass das Tool keine von OpenAI ausgegebenen Herkunftssignale in der hochgeladenen Datei gefunden hat. Der Inhalt könnte dennoch von OpenAI generiert oder exportiert worden sein, wenn einer der folgenden Fälle zutrifft:
Der Inhalt wurde erstellt, bevor Herkunftssignale verfügbar waren.
Der Inhalt stammt aus einem nicht unterstützten Produkt, Modell, Exportweg oder Dateityp.
Metadaten wurden beim Hochladen, Herunterladen, Bearbeiten, Konvertieren oder Teilen entfernt.
Ein Wasserzeichen wurde durch Komprimierung, Zuschneiden, Rauschen, Bearbeitungen, Formatkonvertierung oder andere Veränderungen beeinträchtigt.
Ein Audioclip ist zu kurz oder wurde erheblich verändert.
Wie erhalte ich ein möglichst zuverlässiges Prüfergebnis?
Lade jeweils nur eine unterstützte Datei hoch und verwende nach Möglichkeit die ursprünglich exportierte Datei. Schneide Bilder vor der Prüfung nicht zu und konvertiere die Datei nicht. Bei Audio liefern Clips mit einer Länge von 10 bis 60 Sekunden in der Regel die besten Ergebnisse. Berücksichtige auch dann die Quelle und den Kontext der Datei, wenn kein Signal erkannt wird, bevor du eine Schlussfolgerung ziehst.
Zeigen die Ergebnisse meinen Prompt oder persönliche Informationen?
Herkunftssignale enthalten keine Angaben zur Person, die das Tool nutzt, zur Organisation oder zum Prompt.
Was passiert mit Inhalten, die ich über openai.com/verify oder die Content Provenance API überprüfe?
Inhalte, die auf openai.com/verify hochgeladen oder zur Überprüfung an unsere Content Provenance API übermittelt werden, werden ausschließlich verarbeitet, um sie auf unterstützte Herkunftssignale zu prüfen. Die Inhalte werden nur gespeichert, wenn dies gesetzlich vorgeschrieben ist, und nicht zum Training von OpenAI-Modellen verwendet.
Kann OpenAI Inhalte erkennen, die mit anderen KI-Tools generiert wurden?
Unsere Tools zur Herkunftsprüfung sind darauf ausgelegt, unterstützte Herkunftssignale zu erkennen, die auf mit OpenAI-Modellen generierte oder mit OpenAI-Tools exportierte Inhalte hinweisen. Sie sind nicht dafür ausgelegt, Inhalte zu erkennen, die von anderen KI-Modellen generiert wurden. Auch von OpenAI generierte Inhalte werden möglicherweise nicht erkannt, wenn das relevante Signal fehlt, nicht unterstützt wird oder beeinträchtigt ist.
So funktionieren Wasserzeichen
Klären Wasserzeichen die Urheberschaft, Eigentumsrechte oder rechtliche Verantwortung?
Nein. Ein Wasserzeichen ist ein Hinweis darauf, dass ein OpenAI-Modell den Inhalt wahrscheinlich generiert oder verarbeitet hat. Für sich genommen belegt es nicht, wer den Inhalt verfasst hat oder besitzt, ob eine Offenlegung erforderlich war oder wer rechtlich verantwortlich ist. Es zeigt auch nicht, ob das Modell Inhalte bearbeitet hat, die eine Person hochgeladen hat.
Zeigen Wasserzeichen, in welchem Umfang ein OpenAI-Modell beteiligt war?
Nein. Der Detektor meldet, ob er ein Wasserzeichen gefunden hat. Ein gefundenes Wasserzeichen ist ein Hinweis darauf, dass ein OpenAI-Modell den Inhalt wahrscheinlich generiert oder verarbeitet hat. Es zeigt aber nicht, ob das Modell einen Teil oder den gesamten Inhalt generiert hat oder wie viel eine Person dazu beigetragen hat.
Wie funktionieren Textwasserzeichen?
Textwasserzeichen erzeugen beim Schreiben ein geheimes Muster in der Auswahl von Wörtern und Wortteilen, den sogenannten „Token“, durch das Modell.
Bei jedem Schritt weist das Modell jedem möglichen nächsten Token eine Wahrscheinlichkeit zu. Das Wasserzeichensystem erzeugt mehrere angepasste Verteilungen dieser Wahrscheinlichkeiten. Jede davon bevorzugt anhand eines geheimen Schlüssels andere Auswahlmöglichkeiten. Die Verteilungen sind so aufeinander abgestimmt, dass ihr Mittelwert den ursprünglichen Wahrscheinlichkeiten des Modells entspricht. Der Schlüssel bestimmt, welche Verteilung verwendet wird. Das Modell trifft dann anhand dieser Verteilung eine neue zufällige Auswahl.
Ein Detektor mit demselben Schlüssel und passenden Einstellungen kann später prüfen, ob der Text dem geheimen Muster häufiger folgt, als es durch Zufall zu erwarten wäre.
Werden Textwasserzeichen auch bei faktischen und bereitgestellten Texten verwendet?
Textwasserzeichen setzen voraus, dass das Modell etwas auf verschiedene Arten ausdrücken kann. Dieser Spielraum ist kleiner, wenn eine Antwort sehr faktengetreu oder präzise sein muss, etwa bei einer Mathematikaufgabe, oder wenn das Modell einen bereitgestellten Text unverändert wiedergeben soll. In diesen Fällen hat das Modell weniger Möglichkeiten, seine Formulierungen ohne merklichen Unterschied zu verändern. Das Wasserzeichen wird deshalb möglicherweise nicht erkannt.
Werden Textwasserzeichen auch bei kurzen Antworten und Code verwendet?
Kurze Passagen enthalten meist nicht genug Text, um Wasserzeichen zuverlässig zu erkennen. Auch Code lässt sich schwerer mit Wasserzeichen versehen, weil es für die Fortsetzung weniger plausible Möglichkeiten gibt als bei gewöhnlichen Texten.
Um diesen Einschränkungen Rechnung zu tragen, verlangt der Verhaltenskodex zur Transparenz KI-generierter Inhalte im Rahmen der EU-KI-Verordnung keine Wasserzeichen in Modellergebnissen mit weniger als 200 Token (etwa 150 Wörtern auf Englisch) oder in Codeausschnitten.
Wie unterscheidet sich die Erkennung von Textwasserzeichen je nach Sprache?
Die Erkennungsraten unterscheiden sich je nach Sprache. In manchen Sprachen lassen sich Wasserzeichen derzeit leichter erkennen als in anderen. Wir können die Stärke des Wasserzeichens anpassen, um die Erkennung in Sprachen mit einem schwächeren Signal zu verbessern.
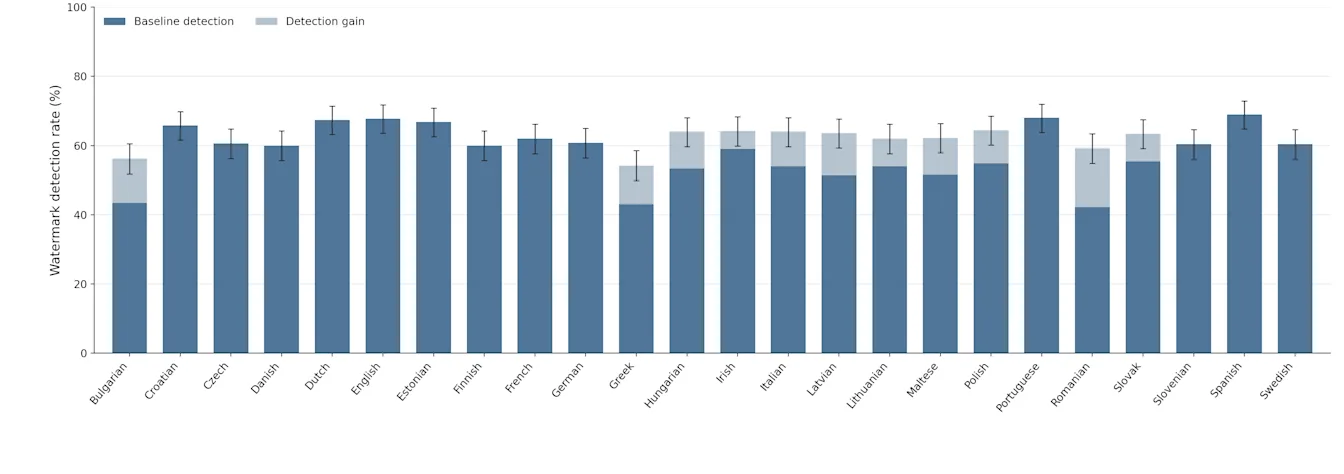
Dieses Diagramm zeigt die Erkennungsrate für alle 24 Amtssprachen der EU. Wir haben zunächst 500 synthetische englische Prompts zu unterschiedlichen Themen generiert und sie dann in die anderen 23 Sprachen übersetzt. Bei einer Falsch-Positiv-Rate von 1 % hat Spanisch die höchste Erkennungsrate (69,0 %), während Rumänisch die niedrigste aufweist (42,2 %). Unser Wasserzeichen verfügt über einen einstellbaren Stärkeparameter: einen „Regler“, der das Wasserzeichensignal für verschiedene Anwendungsbereiche verstärkt oder abschwächt. Mit diesem Regler konnten wir die Stärke für Sprachen mit Erkennungsraten unter 60 % erhöhen. Die hellblauen Abschnitte der Balken zeigen die dadurch erzielten Verbesserungen.
Verringern Textwasserzeichen die Modellqualität?
Unseren Tests zufolge nicht. Bei den Benchmarks, mit denen wir Astra, unser neuestes Frontier-Modell, bewerten, liegen die Leistungsunterschiede mit und ohne Wasserzeichen innerhalb der üblichen Schwankungen zwischen Evaluationsdurchläufen. Auch frühere Tests in ChatGPT zeigten nach der Einführung von Wasserzeichen keine Veränderung beim Anteil der Daumen-runter-Bewertungen oder bei anderen Produktkennzahlen.
Verringern Textwasserzeichen die Modellgeschwindigkeit?
Textwasserzeichen haben einen vernachlässigbaren Einfluss auf die Geschwindigkeit unserer Modelle.
Wie unterscheiden sich die Textwasserzeichen von OpenAI von KI-Erkennungstools anderer Anbieter?
Erkennungstools anderer Anbieter wie Pangram verwenden in der Regel Klassifikatoren, um KI-generierte Texte anhand von Mustern wie der Wortwahl zu erkennen. Dieser Ansatz analysiert den Text nach der Generierung, statt ein eingebettetes Signal zu erkennen. Die EU-KI-Verordnung verlangt ausdrücklich, dass ein Signal in generierte Texte eingebettet wird.
Warum verwendet ihr eigene Textwasserzeichen statt TextSeal oder SynthID?
Wir haben mit textGrain ein eigenes Verfahren für Textwasserzeichen entwickelt. Es gibt uns mehr Kontrolle als SynthID oder TextSeal über das Verhältnis zwischen der Erkennbarkeit von Wasserzeichen und der Vielfalt der Antworten, die aus demselben Prompt generiert werden. In unseren Tests erkannte unser Ansatz einen ähnlich hohen oder höheren Anteil der mit Wasserzeichen versehenen Textproben korrekt als SynthID für Text. Wir planen, textGrain als Open-Source-Technologie zu veröffentlichen, damit andere darauf aufbauen und zur Verbesserung von Textwasserzeichen beitragen können.
Fügen Textwasserzeichen versteckte Zeichen, zusätzliche Token oder sichtbare Änderungen hinzu?
Nein. Textwasserzeichen verändern das statistische Muster der Wortwahl. Sie fügen weder versteckte Zeichen noch Token hinzu, die nur dem Wasserzeichen dienen. Das Wasserzeichen ist beim Lesen nicht sichtbar. Auch beim Kopieren und Einfügen des Textes werden keine versteckten Inhalte hinzugefügt.
Hinweise zur Nutzung
Ich nutze die API. Wie aktiviere ich Textwasserzeichen?
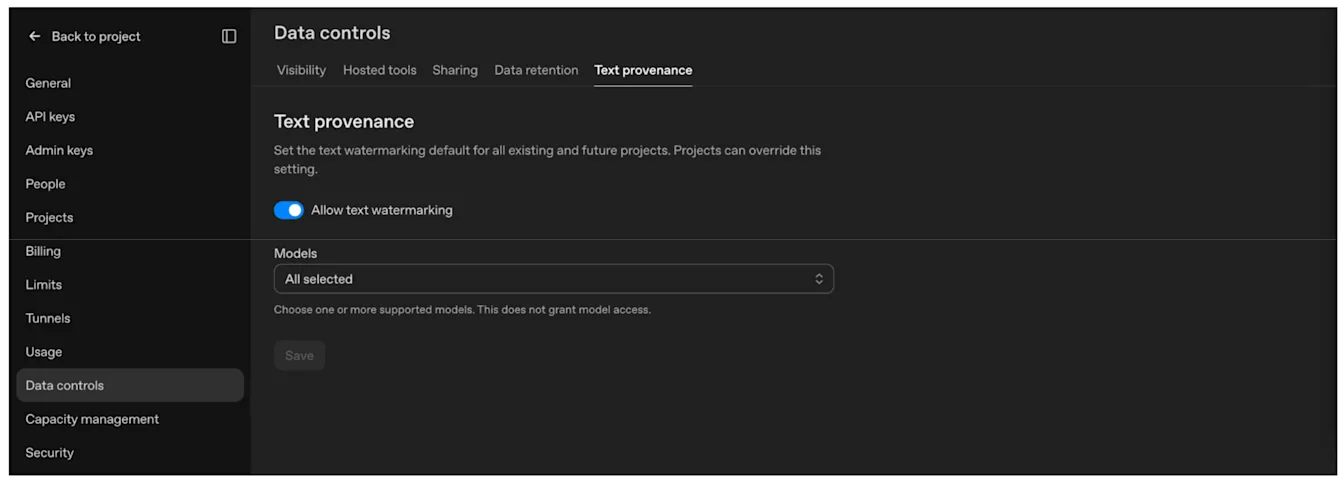
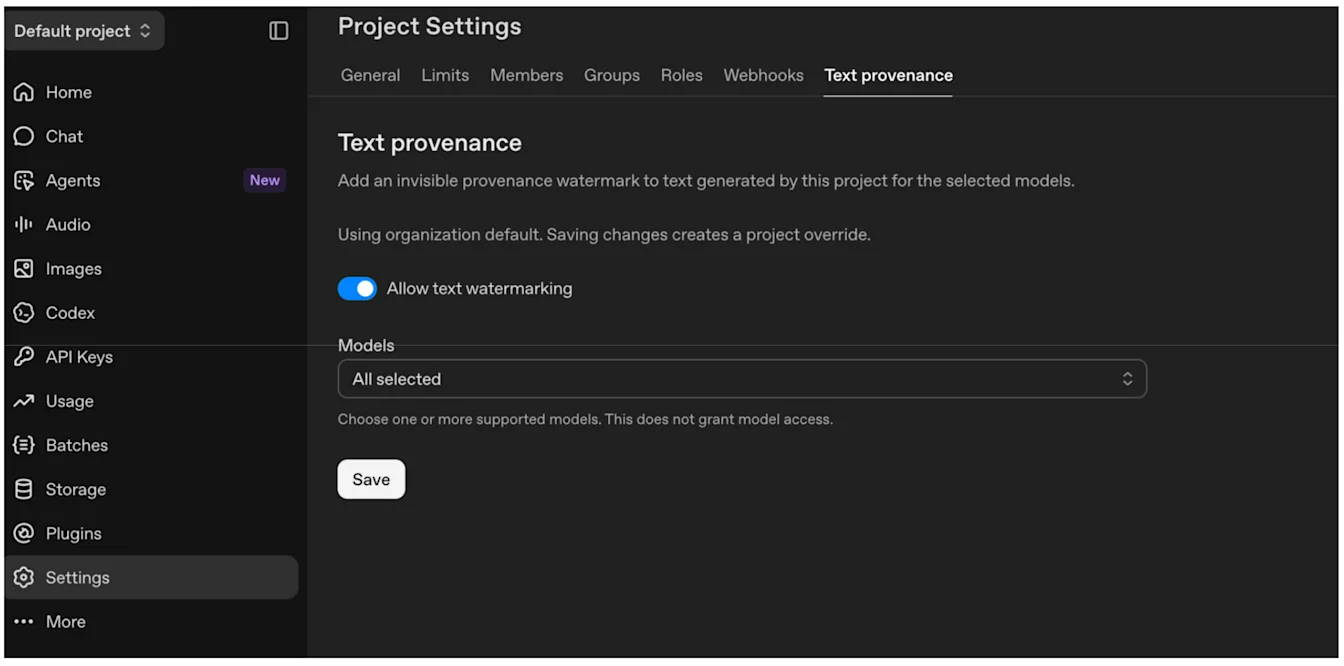
Wenn du die OpenAI API nutzt, kannst du Textwasserzeichen in den Einstellungen für ein bestimmtes Projekt oder in den Organisationseinstellungen für deine gesamte Organisation aktivieren. Du kannst dabei jeweils auswählen, für welche Modelle Textwasserzeichen verwendet werden. Sobald die Funktion für ein unterstütztes Modell aktiviert ist, fügt OpenAI das Wasserzeichen während der Textgenerierung hinzu. Du musst die Antworten nicht einzeln mit einer zusätzlichen Kennzeichnung versehen.
Aktiviere „Textwasserzeichen zulassen“, wähle deine Modelle aus und wähle dann „Speichern“.
Organisationsstandard: Organisationseinstellungen → Datenkontrollen → Textherkunft.
Abweichende Projekteinstellung: Projekteinstellungen → Textherkunft.
Für welche Modelle kann ich Wasserzeichen aktivieren?
In den Einstellungen und den Organisationseinstellungen findest du eine Liste der Modelle, für die derzeit Wasserzeichen verfügbar sind. In den kommenden Wochen werden wir die Unterstützung auf alle älteren Modelle ausweiten.
Erhalte ich durch das Aktivieren von Textwasserzeichen auch Zugang zum Textdetektor?
Nein. Der Zugang zum Textdetektor ist derzeit auf zugelassene Forschungseinrichtungen und Hochschulen beschränkt, die daran arbeiten, Textwasserzeichen zuverlässiger und einfacher nutzbar zu machen sowie die Technologie und ihre Ergebnisse verständlicher zu erklären. Dies entspricht unseren Zusagen im Rahmen des Verhaltenskodex zur Transparenz KI-generierter Inhalte der EU-KI-Verordnung.
Bleiben die Signale erhalten, wenn ich Inhalte verändere?
Das ist möglich, hängt aber vom Signal und deinen Änderungen ab.
Bewahre bei unterstützten Bildern und Audiodateien eine Originalkopie auf und nutze die Content Provenance API, um repräsentative Dateien nach der Bearbeitung, Konvertierung und Veröffentlichung zu testen. Bei Bildern können Zuschneiden, das Hinzufügen von Rauschen, die Konvertierung in JPEG und das Erstellen von Screenshots die Erkennung von Signalen erschweren. Texte kannst du auf diese Weise nur testen, wenn deine Organisation einen genehmigten Zugang zum Textdetektor hat.
Wenn dein Dateiformat und dein Arbeitsablauf es unterstützen, behalte vorhandene C2PA-Metadaten bei und füge den von dir erstellten Dateien Content Credentials hinzu. Du kannst auch eigene Kennzeichnungen hinzufügen, damit Herkunftsinformationen länger erhalten bleiben oder nützlicher werden. Einzelheiten zur Implementierung findest du in der technischen Dokumentation von C2PA.
Bei Texten ist das Wasserzeichen Teil der Wortwahl des Modells. Wenn du den Wortlaut beibehältst, bleibt das Signal bei der Weiterverwendung des Textes voraussichtlich erhalten, ohne zusätzlichen Integrationsaufwand. Umfangreiche Überarbeitungen, Umformulierungen oder Übersetzungen können die Erkennung weniger zuverlässig machen. Auch ein unveränderter Wortlaut garantiert kein erkennbares Wasserzeichen, insbesondere bei kurzen Passagen oder Texten mit wenig Spielraum für eine andere Wortwahl.
Ich greife über einen Cloud-Dienst auf die Modelle von OpenAI zu. Enthalten auch diese Modellergebnisse Herkunftssignale?
Wir arbeiten mit allen unseren Cloud- und Vertriebspartnern daran, Herkunftssignale einschließlich Wasserzeichen in alle geeigneten Modellergebnisse einzubetten, darunter Bilder, Audio und Text. Die Verfügbarkeit kann je nach Modellergebnis und Partnerunternehmen variieren.
Ersetzen Herkunftssignale sichtbare KI-Kennzeichnungen oder andere Offenlegungen?
Nein. Wasserzeichen und C2PA-Metadaten liefern Informationen, die Software auslesen kann. Sie ersetzen keine sichtbaren Kennzeichnungen, Banner oder sonstigen Hinweise, die möglicherweise erforderlich sind.
Ob du eine zusätzliche Offenlegung benötigst, hängt davon ab, wie und wo du die Inhalte verwendest. OpenAI kann dich nicht zu deinen konkreten rechtlichen Pflichten beraten. Dein Rechtsteam sollte die Anforderungen für deine Nutzung prüfen.
Ich habe weitere Fragen zur EU-KI-Verordnung
Bitte reiche eine Anfrage zur EU-KI-Verordnung ein. Wir melden uns bei dir.