
OpenAI setzt sich für ein sichereres, transparenteres KI-Ökosystem ein. Dazu nutzt OpenAI Herkunftssignale, die Menschen helfen zu erkennen, ob Inhalte mit einem OpenAI-Modell generiert wurden.
Herkunftssignale können nützliche Informationen über den Ursprung liefern. Sie garantieren jedoch nicht, dass Inhalte korrekt, unbearbeitet oder im richtigen Kontext dargestellt sind oder dass jemand rechtmäßig die Rechte daran besitzt.
Herkunftssignale von OpenAI
Welche Herkunftssignale verwendet OpenAI?
OpenAI verwendet je nach Inhaltstyp unterschiedliche Herkunftssignale.
| Inhaltstyp | Unterstützte Formate | Herkunftssignale | Hinweise |
|---|---|---|---|
| Bilder | PNG, JPEG/JPG, WebP, GIF | Content Credentials und SynthID-Wasserzeichen | Bilder, die mit ChatGPT oder der OpenAI API generiert werden, enthalten beide Signale. |
| Audio | MP3, WAV, AAC, FLAC, OGG, Opus, PCM | SynthID-Wasserzeichen | Audioinhalte, die mit ChatGPT oder der OpenAI API generiert werden, enthalten ein unhörbares Wasserzeichen, das direkt in das Audiosignal eingebettet ist. |
| Text | Freitext; nicht an ein Dateiformat gebunden | textGrain-Wasserzeichen (nur EU) | In der EU wird bei Texten, die ChatGPT generiert, die Zufallsauswahl der Wörter durch das Modell unsichtbar verändert, um die EU-KI-Verordnung einzuhalten. Wer die API nutzt, kann weltweit in den Projekt- oder Organisationseinstellungen Wasserzeichen für generierte Texte aktivieren. Mehr erfahren. |
| Video | Nicht zutreffend | Nicht zutreffend | Sora wurde eingestellt.Mehr erfahren. |
| PDFs | PDF (.pdf) | Content Credentials (C2PA-Metadaten) | PDFs, die aus unterstützten Tools von OpenAI exportiert werden, enthalten in die Datei eingebettete C2PA-Metadaten. |
Die Abdeckung kann je nach Produkt, Modell, Exportweg, Dateityp und Erstellungszeitpunkt des Inhalts variieren. API-Ergebnisse sind abgedeckt. Ausgenommen sind Modelle, deren Unterstützung in Kürze eingestellt werden soll, darunter gpt-image-1, gpt-image-1.5 und sora-2.
Warum werden bei manchen Inhaltstypen mehrere Signale verwendet?
Wenn es technisch möglich ist, kombiniert OpenAI Metadaten und Wasserzeichen, damit sie ihre jeweiligen Schwächen gegenseitig ausgleichen können. Metadaten können detaillierte Informationen enthalten, aber durch Plattformen, Bearbeitungstools und Dateikonvertierungen entfernt werden. Wasserzeichen enthalten weniger Kontext. Da sie jedoch in den generierten Inhalt selbst eingebettet sind, können sie manche Veränderungen überstehen, bei denen Metadaten entfernt werden.
Wie robust sind Herkunftssignale gegenüber Änderungen am Inhalt?
SynthID-Wasserzeichen für Bilder und Audio sowie textGrain-Wasserzeichen für Text sind so konzipiert, dass sie gängige Änderungen überstehen. Je nach Inhaltstyp können dazu leichte Bearbeitungen, Kopieren und Einfügen, Zuschneiden oder Screenshots gehören. Umfangreichere Änderungen, etwa starkes Zuschneiden von Bildern, Dateikomprimierung, weitgehendes Umformulieren oder Übersetzen, können dazu führen, dass ein Wasserzeichen nicht mehr erkennbar ist. Nach umfangreichen Änderungen kann es zudem weniger aussagekräftig sein, das Ergebnis als „von OpenAI generiert“ zu bezeichnen.
Content Credentials, die von der Coalition for Content Provenance and Authenticity entwickelt wurden, können durch alltägliche Aktionen verloren gehen, etwa beim Erstellen eines Screenshots oder beim Konvertieren einer Datei. Bleiben sie erhalten, können sie mehr Einzelheiten über die Herkunft und den Verlauf einer Datei liefern als ein Wasserzeichen allein.
Wo es technisch möglich ist, setzen wir beide Methoden ein, damit Herkunftsinformationen bei Änderungen am Inhalt mit höherer Wahrscheinlichkeit erhalten bleiben.
Was sind Content Credentials und was ermöglichen sie?
Content Credentials fügen einer Datei Informationen über ihre Herkunft und ihren Verlauf hinzu, etwa mit welchem Tool und wann sie erstellt wurde. Sie nutzen einen offenen Standard der Coalition for Content Provenance and Authenticity (C2PA) und werden deshalb manchmal als „C2PA-Metadaten“ bezeichnet.
Content Credentials helfen Menschen, die Herkunft von Inhalten zu überprüfen. Sie werden nicht nur für KI-generierte Inhalte verwendet: Auch Kamerahersteller, Nachrichtenorganisationen und andere nutzen den Standard, um die Quelle und den Verlauf ihrer Medien zu bescheinigen. Mehr über C2PA erfahren.
Was ist SynthID und was ermöglicht es?
SynthID ist eine von Google DeepMind entwickelte Technologie für unsichtbare Wasserzeichen, die ein Signal direkt in generierte Medien einbettet. Anders als Metadaten ist das Signal Teil des Inhalts selbst und kann manche Bearbeitungen oder Veränderungen überstehen. SynthID liefert neben C2PA-Metadaten ein zusätzliches Herkunftssignal. Werden beispielsweise Metadaten aus einer Datei entfernt, kann ein eingebettetes Wasserzeichen weiterhin darauf hinweisen, dass der Inhalt mit unterstützten OpenAI-Tools generiert wurde. Mehr über SynthID erfahren.
Warum verseht ihr generierte Texte mit Wasserzeichen?
Wir führen Textwasserzeichen für Menschen ein, die ChatGPT in der EU nutzen, um die EU-KI-Verordnung einzuhalten. Dies entspricht auch unseren Zusagen im Rahmen des EU-Verhaltenskodex zur Transparenz KI-generierter Inhalte, den OpenAI und mehrere andere große KI-Anbieter unterzeichnet haben.
Was ist textGrain und was ermöglicht es?
textGrain ist die Technologie von OpenAI für Textwasserzeichen. Sie verändert geringfügig, wie das Modell beim Schreiben zufällig zwischen möglichen Wörtern oder Wortteilen auswählt. Über einen Textabschnitt hinweg entsteht durch diese Auswahl ein Muster, nach dem ein Detektor auch nach einigen Bearbeitungen suchen kann.
Das Wasserzeichen ist Teil der Formulierung selbst und beim Lesen nicht sichtbar. Es fügt keine verborgenen Zeichen, unsichtbaren Leerzeichen oder ungewöhnlichen Satzzeichen hinzu. Textwasserzeichen unterstützen die Einhaltung der Vorgabe der EU-KI-Verordnung, generierte Texte zu kennzeichnen.
Weitere Einzelheiten zur Funktionsweise von textGrain findest du in unserem technischen Bericht.
Tools von OpenAI zur Überprüfung
Wie kann ich prüfen, ob Inhalte mit Tools von OpenAI verarbeitet wurden?
Auf openai.com/verify kannst du prüfen, ob ein unterstütztes Bild, eine Audiodatei oder ein PDF Herkunftssignale enthält, die auf eine Verarbeitung mit Tools von OpenAI hinweisen. Nachdem du eine unterstützte Datei hochgeladen hast, sucht das Tool nach unterstützten Herkunftssignalen von OpenAI, etwa einem SynthID-Wasserzeichen oder einem vertrauenswürdigen C2PA-Manifest, das OpenAI zugeordnet ist. Findet das Tool ein unterstütztes Herkunftssignal von OpenAI, deutet dies darauf hin, dass der Inhalt wahrscheinlich mit einem Tool von OpenAI verarbeitet wurde.
Entwicklungsteams und Organisationen können auch die Content Provenance API von OpenAI nutzen, um Bilder, Audiodateien und PDFs auf Herkunftssignale von OpenAI zu prüfen und die Überprüfung in ihre eigenen Anwendungen oder Arbeitsabläufe zu integrieren. Organisationen mit einem geeigneten Anwendungsfall können höhere Limits beantragen.
Im Einklang mit unseren Verpflichtungen aus der EU-KI-Verordnung können Organisationen mit einem geeigneten Anwendungsfall Zugang zum Textdetektor beantragen. Dazu zählen Forschungseinrichtungen, Hochschulen und ähnliche Institutionen, die die Herkunft von Texten, die Zuverlässigkeit der Erkennung oder das Verständnis von Menschen für Ergebnisse der Herkunftsprüfung untersuchen. Wir prüfen Anträge berechtigter Organisationen im Einzelfall und melden uns gegebenenfalls mit Neuigkeiten oder der Bitte um weitere Informationen. Unser Ansatz für den Zugang kann sich mit neuen Erkenntnissen und Verbesserungen der Technologie weiterentwickeln.
Derzeit arbeiten wir mit einer kleinen Gruppe von Forschenden zusammen, darunter John Thickstun, Assistant Professor of Computer Science an der Cornell University, Martin Vechev, Professor of Computer Science an der ETH Zurich und Scientific Director von INSAIT, sowie Forschende am Kempelen Institute of Intelligent Technologies (KInIT). Gemeinsam wollen wir die Möglichkeiten und Grenzen der Technologie besser verstehen und Erkenntnisse für die Verbesserung von Textwasserzeichen gewinnen.
Wer erhält höhere Limits für die Überprüfung und sind die Prüfungen kostenpflichtig?
Prüfungen über die Content Provenance API sind derzeit kostenlos und unterliegen Nutzungslimits. Das Programm für höhere Limits richtet sich an geeignete Projekte zur Herkunftsprüfung im öffentlichen Interesse und an Arbeitsabläufe zur Wahrung der Informationsintegrität. Dazu zählen etwa Überprüfungen in Redaktionen, Faktenchecks, Forschung zur Herkunft von Inhalten und behördliche Aufsicht.
Allgemeine geschäftliche Anwendungen fallen derzeit nicht unter das Programm, etwa kommerzielle Betrugsprävention, Authentifizierung und Überprüfung oder der Weiterverkauf als Teil gebündelter Dienste zur Herkunftsprüfung und Datenanalyse.
Organisationen mit einem geeigneten Anwendungsfall können höhere Limits beantragen. Das Einreichen eines Antrags garantiert jedoch keine Genehmigung. Die öffentliche API bleibt mit ihren Standardlimits verfügbar, auch für kleinere Evaluationen. Die aktuellen Nutzungslimits findest du in der Dokumentation zur Content Provenance API.
Wer kann Zugang zum Textdetektor erhalten und sind die Prüfungen kostenpflichtig?
Prüfungen mit dem Textdetektor sind derzeit kostenlos. Antragsberechtigt sind Forschungseinrichtungen, Hochschulen und ähnliche Institutionen, die die Herkunft von Texten, die Zuverlässigkeit der Erkennung oder das Verständnis von Menschen für Ergebnisse der Herkunftsprüfung untersuchen. Andere Anträge fallen derzeit nicht in den Rahmen des Programms.
Was bedeuten die Prüfergebnisse?
Wird über openai.com/verify oder die Content Provenance API von OpenAI ein Signal erkannt, bedeutet dies, dass der hochgeladene Inhalt ein unterstütztes Herkunftssignal enthält, das OpenAI zugeordnet ist. Dies deutet auf eine Verarbeitung mit einem Tool von OpenAI hin. Das Signal allein zeigt nicht, ob oder in welchem Umfang der Inhalt mit Tools von OpenAI generiert oder bearbeitet wurde. Das Tool bestätigt nicht, dass der Inhalt korrekt oder unbearbeitet ist, rechtmäßig besessen wird oder im richtigen Kontext dargestellt wird. Es zeigt auch nicht, wer den Inhalt erstellt hat oder warum er erstellt wurde.
Wird kein Signal erkannt, bedeutet dies, dass das Tool in der hochgeladenen Datei keine von OpenAI ausgegebenen Herkunftssignale gefunden hat. Der Inhalt könnte dennoch von OpenAI verarbeitet worden sein, wenn:
Der Inhalt erstellt wurde, bevor Herkunftssignale verfügbar waren.
Der Inhalt aus einem nicht unterstützten Produkt, Modell, Exportweg oder Dateityp stammt.
Metadaten beim Hochladen, Herunterladen, Bearbeiten, Konvertieren oder Teilen entfernt wurden.
Ein Wasserzeichen durch Komprimierung, Zuschneiden, Rauschen, Bearbeitungen, Formatkonvertierung oder andere Veränderungen beeinträchtigt wurde.
Ein Audioclip zu kurz ist oder erheblich verändert wurde.
Wie erhalte ich ein möglichst zuverlässiges Prüfergebnis?
Lade jeweils nur eine unterstützte Datei hoch und verwende nach Möglichkeit die ursprünglich exportierte Datei. Schneide Bilder vor der Prüfung nicht zu und konvertiere die Datei nicht. Bei Audio liefern Clips mit einer Länge von 10 bis 60 Sekunden in der Regel die besten Ergebnisse. Berücksichtige auch dann die Quelle und den Kontext der Datei, wenn kein Signal erkannt wird, bevor du eine Schlussfolgerung ziehst.
Zeigen die Ergebnisse meinen Prompt oder persönliche Informationen?
Herkunftssignale enthalten keine Angaben zur Person, die das Tool nutzt, zur Organisation oder zum Prompt.
Was passiert mit Inhalten, die ich über openai.com/verify oder die Content Provenance API überprüfe?
Inhalte, die auf openai.com/verify hochgeladen oder zur Überprüfung an unsere Content Provenance API übermittelt werden, werden ausschließlich zur Suche nach unterstützten Herkunftssignalen verarbeitet. Die Inhalte werden nur gespeichert, wenn dies gesetzlich vorgeschrieben ist, und nicht zum Training von OpenAI-Modellen verwendet.
Kann OpenAI Inhalte erkennen, die mit anderen KI-Tools generiert wurden?
Unsere Tools zur Herkunftsprüfung sind darauf ausgelegt, unterstützte Herkunftssignale zu erkennen, die auf mit OpenAI-Modellen generierte oder mit OpenAI-Tools exportierte Inhalte hinweisen. Sie sind nicht dafür ausgelegt, Inhalte zu erkennen, die von anderen KI-Modellen generiert wurden. Auch von OpenAI generierte Inhalte werden möglicherweise nicht erkannt, wenn das relevante Signal fehlt, nicht unterstützt wird oder beeinträchtigt ist.
So funktionieren Wasserzeichen
Klären Wasserzeichen die Urheberschaft, Eigentumsrechte oder rechtliche Verantwortung?
Nein. Ein Wasserzeichen ist ein Hinweis darauf, dass ein OpenAI-Modell den Inhalt wahrscheinlich generiert oder verarbeitet hat. Für sich genommen belegt es nicht, wer den Inhalt verfasst hat oder besitzt, ob eine Offenlegung erforderlich war oder wer rechtlich verantwortlich ist. Es zeigt auch nicht, ob das Modell Inhalte bearbeitet hat, die eine Person hochgeladen hat.
Zeigen Wasserzeichen, in welchem Umfang ein OpenAI-Modell beteiligt war?
Nein. Der Detektor meldet, ob er ein Wasserzeichen gefunden hat. Ein gefundenes Wasserzeichen ist ein Hinweis darauf, dass ein OpenAI-Modell den Inhalt wahrscheinlich generiert oder verarbeitet hat. Es zeigt aber nicht, ob das Modell einen Teil oder den gesamten Inhalt generiert hat oder wie viel eine Person dazu beigetragen hat.
Wie funktionieren Textwasserzeichen?
Textwasserzeichen erzeugen beim Schreiben ein geheimes Muster in der Auswahl von Wörtern und Wortteilen, den sogenannten „Token“, durch das Modell.
Bei jedem Schritt weist das Modell jedem möglichen nächsten Token eine Wahrscheinlichkeit zu. Das Wasserzeichensystem erzeugt mehrere angepasste Verteilungen dieser Wahrscheinlichkeiten. Jede davon bevorzugt anhand eines geheimen Schlüssels andere Auswahlmöglichkeiten. Die Verteilungen sind so aufeinander abgestimmt, dass ihr Mittelwert den ursprünglichen Wahrscheinlichkeiten des Modells entspricht. Der Schlüssel bestimmt, welche Verteilung verwendet wird. Das Modell trifft dann anhand dieser Verteilung eine neue zufällige Auswahl.
Ein Detektor mit demselben Schlüssel und passenden Einstellungen kann später prüfen, ob der Text dem geheimen Muster häufiger folgt, als es durch Zufall zu erwarten wäre.
Werden Textwasserzeichen auch bei faktischen und bereitgestellten Texten verwendet?
Textwasserzeichen setzen voraus, dass das Modell etwas auf verschiedene Arten ausdrücken kann. Dieser Spielraum ist kleiner, wenn eine Antwort sehr faktengetreu oder präzise sein muss, etwa bei einer Mathematikaufgabe, oder wenn das Modell einen bereitgestellten Text unverändert wiedergeben soll. In diesen Fällen hat das Modell weniger Möglichkeiten, seine Formulierungen ohne merklichen Unterschied zu verändern. Das Wasserzeichen wird deshalb möglicherweise nicht erkannt.
Werden Textwasserzeichen auch bei kurzen Antworten und Code verwendet?
Kurze Passagen enthalten meist nicht genug Text, um Wasserzeichen zuverlässig zu erkennen. Auch Code lässt sich schwerer mit Wasserzeichen versehen, weil es für die Fortsetzung weniger plausible Möglichkeiten gibt als bei gewöhnlichen Texten.
Um diesen Einschränkungen Rechnung zu tragen, verlangt der Verhaltenskodex zur Transparenz KI-generierter Inhalte im Rahmen der EU-KI-Verordnung keine Wasserzeichen in Modellergebnissen mit weniger als 200 Token (etwa 150 Wörtern auf Englisch) oder in Codeausschnitten.
Wie unterscheidet sich die Erkennung von Textwasserzeichen je nach Sprache?
Die Erkennungsraten unterscheiden sich je nach Sprache. In einigen Sprachen lassen sich Wasserzeichen derzeit leichter erkennen als in anderen. Wir können die Stärke des Wasserzeichens anpassen, um die Erkennung in Sprachen mit schwächerem Signal zu verbessern.
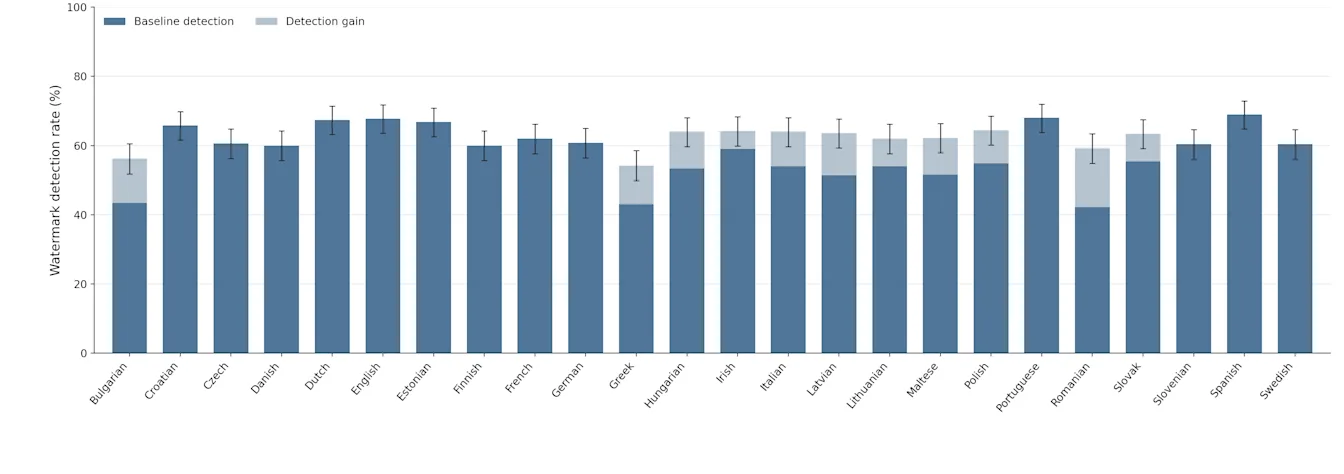
Dieses Diagramm zeigt die Erkennungsrate für alle 24 Amtssprachen der EU. Wir haben zunächst 500 synthetische englische Prompts zu unterschiedlichen Themen generiert und sie anschließend in die anderen 23 Sprachen übersetzt. Bei einer Falsch-Positiv-Rate von 1 % hat Spanisch die höchste Erkennungsrate (69,0 %) und Rumänisch die niedrigste (42,2 %). Unser Wasserzeichen verfügt über einen einstellbaren Stärkeparameter: einen „Regler“, der das Wasserzeichensignal für verschiedene Anwendungsbereiche verstärkt oder abschwächt. Mit diesem Regler konnten wir die Stärke für Sprachen mit Erkennungsraten unter 60 % erhöhen. Die hellblauen Abschnitte der Balken zeigen die dadurch erzielten Verbesserungen.
Verringern Textwasserzeichen die Modellqualität?
Unseren Tests zufolge nicht. Bei den Benchmarks, mit denen wir Astra, unser neuestes Frontier-Modell, bewerten, liegen die Leistungsunterschiede mit und ohne Wasserzeichen innerhalb der üblichen Schwankungen zwischen Evaluationsdurchläufen. Auch frühere Tests in ChatGPT zeigten nach der Einführung von Wasserzeichen keine Veränderung beim Anteil der Daumen-runter-Bewertungen oder bei anderen Produktkennzahlen.
Verringern Textwasserzeichen die Modellgeschwindigkeit?
Textwasserzeichen haben einen vernachlässigbaren Einfluss auf die Geschwindigkeit unserer Modelle.
Wie unterscheiden sich die Textwasserzeichen von OpenAI von KI-Erkennungstools anderer Anbieter?
Erkennungstools anderer Anbieter wie Pangram verwenden in der Regel Klassifikatoren, um KI-generierte Texte anhand von Mustern wie der Wortwahl zu erkennen. Dieser Ansatz analysiert den Text nach der Generierung, statt ein eingebettetes Signal zu erkennen. Die KI-Verordnung der EU verlangt ausdrücklich, dass ein Signal in generierte Texte eingebettet wird.
Warum verwendet ihr eigene Textwasserzeichen statt TextSeal oder SynthID?
Wir haben mit textGrain ein eigenes Verfahren für Textwasserzeichen entwickelt. Es gibt uns mehr Kontrolle als SynthID oder TextSeal über das Verhältnis zwischen der Erkennbarkeit von Wasserzeichen und der Vielfalt der Antworten, die aus demselben Prompt generiert werden. In unseren Tests erkannte unser Ansatz einen ähnlich hohen oder höheren Anteil der mit Wasserzeichen versehenen Textproben korrekt als SynthID für Text. Wir planen, textGrain als Open-Source-Technologie zu veröffentlichen, damit andere darauf aufbauen und zur Verbesserung von Textwasserzeichen beitragen können.
Fügen Textwasserzeichen versteckte Zeichen, zusätzliche Token oder sichtbare Änderungen hinzu?
Nein. Textwasserzeichen verändern das statistische Muster der Wortwahl. Sie fügen weder versteckte Zeichen noch Token hinzu, die nur dem Wasserzeichen dienen. Das Wasserzeichen ist beim Lesen nicht sichtbar. Auch beim Kopieren und Einfügen des Textes werden keine versteckten Inhalte hinzugefügt.
Hinweise zur Nutzung
Wie aktiviere ich Textwasserzeichen, wenn ich die API nutze?
Wenn du die OpenAI API nutzt, kannst du Textwasserzeichen für ein bestimmtes Projekt über die Einstellungen oder für deine gesamte Organisation über die Organisationseinstellungen aktivieren. In beiden Fällen kannst du auswählen, für welche Modelle Textwasserzeichen verwendet werden. Sobald du Textwasserzeichen für ein unterstütztes Modell aktivierst, fügt OpenAI das Wasserzeichen während der Textgenerierung hinzu. Du musst nicht jede Antwort gesondert kennzeichnen.
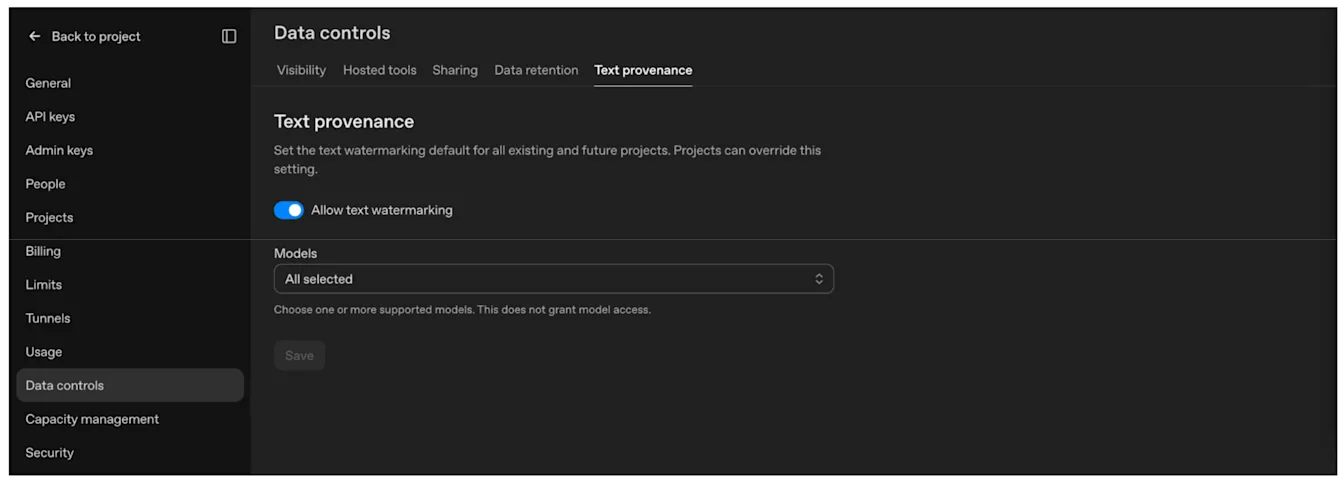
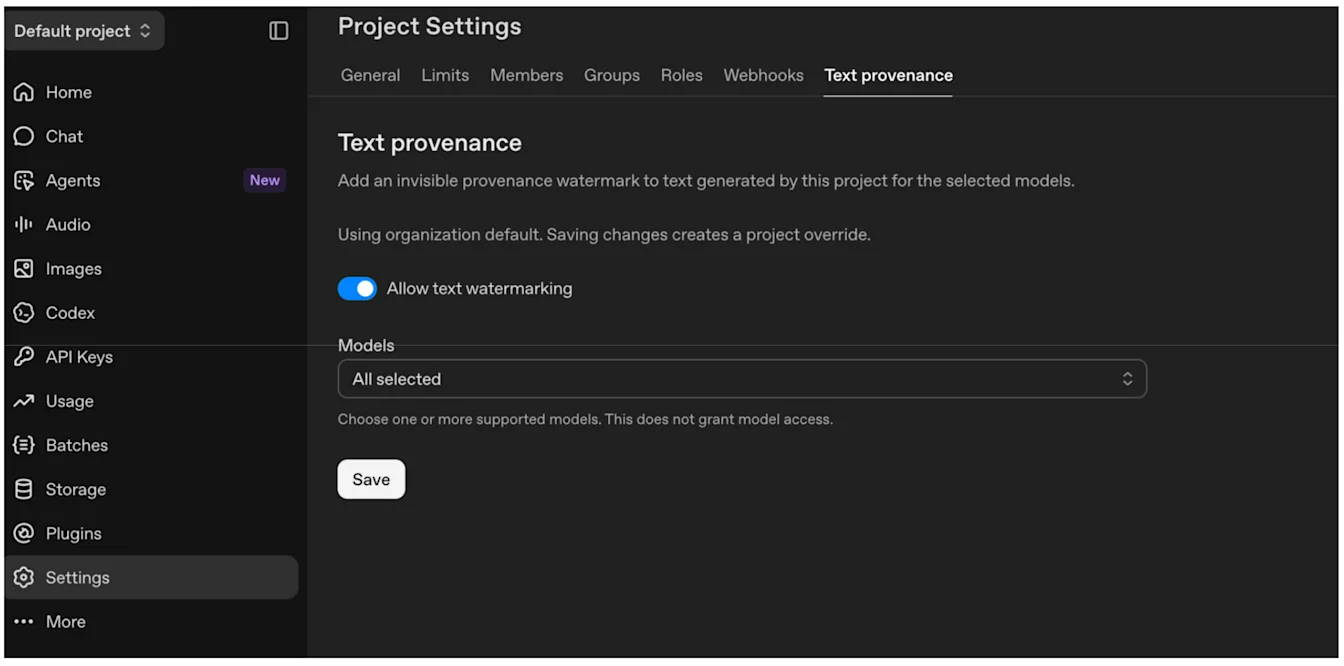
Aktiviere „Textwasserzeichen zulassen“, wähle deine Modelle aus und klicke dann auf „Speichern“.
Standard für die Organisation: Gehe zu Organisationseinstellungen > Datenkontrollen.
Wähle „Textherkunft“.
Abweichende Projekteinstellung: Gehe zu Projekteinstellungen > Textherkunft.
Für welche Modelle kann ich Wasserzeichen aktivieren?
In den Einstellungen und den Organisationseinstellungen findest du die Liste der Modelle, für die derzeit Wasserzeichen verfügbar sind. In den kommenden Wochen werden wir die Unterstützung auf alle älteren Modelle ausweiten.
Erhalte ich durch das Aktivieren von Textwasserzeichen auch Zugang zum Textdetektor?
Nein. Der Zugang zum Textdetektor ist derzeit auf zugelassene Forschungseinrichtungen und Hochschulen beschränkt, die daran arbeiten, Textwasserzeichen zuverlässiger und einfacher nutzbar zu machen sowie die Technologie und ihre Ergebnisse verständlicher zu erklären. Dies entspricht unseren Zusagen im Rahmen des Verhaltenskodex zur Transparenz KI-generierter Inhalte der EU-KI-Verordnung.
Bleiben die Signale erhalten, wenn ich die Inhalte verändere?
Das ist möglich, hängt aber vom Signal und deinen Änderungen ab.
Bewahre bei unterstützten Bildern und Audiodateien eine Originalkopie auf und prüfe mit der Content Provenance API repräsentative Dateien nach der Bearbeitung, Konvertierung und Veröffentlichung. Bei Bildern können Zuschneiden, das Hinzufügen von Rauschen, die Konvertierung in JPEG und das Erstellen von Screenshots die Erkennung der Signale erschweren. Text kannst du auf diese Weise nur prüfen, wenn deiner Organisation der Zugang zum Textdetektor genehmigt wurde.
Wenn dein Dateiformat und dein Arbeitsablauf es unterstützen, bewahre vorhandene C2PA-Metadaten und füge den von dir erstellten Dateien Content Credentials hinzu. Du kannst auch eigene Kennzeichnungen hinzufügen, damit Herkunftsinformationen länger erhalten bleiben oder nützlicher werden. Details zur Implementierung findest du in der technischen Dokumentation von C2PA.
Bei Text ist das Wasserzeichen Teil der Wortwahl des Modells. Wenn du den Wortlaut beibehältst, bleibt das Signal bei der Wiederverwendung des Textes voraussichtlich erhalten, ohne zusätzlichen Integrationsaufwand. Umfangreiches Umschreiben, Paraphrasieren oder Übersetzen kann die Zuverlässigkeit der Erkennung verringern. Auch ein unveränderter Wortlaut garantiert kein erkennbares Wasserzeichen, insbesondere bei kurzen Passagen oder Texten mit wenig Spielraum bei der Wortwahl.
Ich greife über einen Cloud-Dienst auf die Modelle von OpenAI zu. Enthalten diese Modellergebnisse ebenfalls Herkunftssignale?
In welchem Umfang Wasserzeichen für über Azure bereitgestellte Modelle von OpenAI verfügbar sind, hängt vom Modell und der Modalität ab. Informationen zur aktuellen Verfügbarkeit und Abdeckung erhältst du von Microsoft. Wir arbeiten daran, Herkunftssignale auch in Modellergebnisse einzubinden, die über andere Cloud-Dienste bereitgestellt werden.
Ersetzen Herkunftssignale sichtbare KI-Kennzeichnungen oder andere Offenlegungen?
Nein. Wasserzeichen und C2PA-Metadaten liefern Informationen, die Software auslesen kann. Sie ersetzen keine sichtbaren Kennzeichnungen, Banner oder sonstigen Hinweise, die möglicherweise erforderlich sind.
Ob du eine zusätzliche Offenlegung benötigst, hängt davon ab, wie und wo du die Inhalte verwendest. OpenAI kann dich nicht zu deinen konkreten rechtlichen Pflichten beraten. Dein Rechtsteam sollte die Anforderungen für deine Nutzung prüfen.
Ich habe weitere Fragen zur EU-KI-Verordnung
Sende uns bitte eine Anfrage zur EU-KI-Verordnung. Wir melden uns bei dir.