
Osana oma pühendumusest turvalisemale ja läbipaistvamale tehisintellekti ökosüsteemile kasutab OpenAI päritolutunnuseid, et aidata inimestel mõista, kas sisu on loodud OpenAI mudeliga.
Päritolutunnused võivad anda kasulikku teavet päritolu kohta, kuid need ei taga, et sisu on täpne, muutmata, seaduslikus omanduses või esitatud õiges kontekstis.
OpenAI päritolutunnused
Milliseid päritolutunnuseid OpenAI kasutab?
OpenAI kasutab eri sisutüüpide jaoks erinevaid päritolutunnuseid.
| Sisutüüp | Päritolutunnused | Märkused |
|---|---|---|
| Pildid | Sisu päritolutõendid ja SynthID vesimärgid | ChatGPT, Codexi või OpenAI API abil loodud pildid sisaldavad mõlemat tunnust. |
| Heli | SynthID vesimärgid | ChatGPT või OpenAI API abil loodud heli sisaldab kuuldamatut vesimärki, mis on põimitud helisse endasse. |
| Tekst | textGraini vesimärgid (ainult ELis) | ELi tehisintellektimääruse täitmiseks sisaldab ELis ChatGPT-ga loodud tekst nähtamatut muudatust mudeli sõnavalikute juhuslikkuses. API kliendid kogu maailmas saavad oma projekti või organisatsiooni seadetes lülitada sisse tekstiväljundite vesimärgistamise. |
| Video | Sisu päritolutõendid | Sora on kasutuselt kõrvaldatud. Loe lisateavet. |
Tugi võib erineda olenevalt tootest, mudelist, ekspordiviisist, failitüübist ja sisu loomise ajast. Tugi hõlmab API väljundeid, välja arvatud peagi kasutuselt kõrvaldatavate mudelite, sealhulgas gpt-image-1, gpt-image-1.5 ja sora-2 väljundid.
Miks kasutatakse mõne sisutüübi puhul mitut tunnust?
Kui see on tehniliselt võimalik, kombineerib OpenAI metaandmeid ja vesimärke, et need saaksid teineteise piiranguid leevendada. Metaandmed võivad sisaldada üksikasjalikku teavet, kuid platvormid, töötlustööriistad ja failide teisendamine võivad need eemaldada. Vesimärgid annavad vähem taustteavet, kuid kuna need on põimitud loodud sisusse endasse, võivad need säilida ka pärast mõningaid muudatusi, mille käigus metaandmed kaovad.
Kui hästi peavad päritolutunnused vastu sisu muutmisele?
Piltide ja heli SynthID vesimärgid ning teksti textGraini vesimärgid on loodud taluma tavapäraseid muudatusi. Olenevalt sisutüübist võivad need hõlmata kerget töötlemist, kopeerimist ja kleepimist, kärpimist või kuvatõmmiste tegemist. Ulatuslikumad muudatused, näiteks pildi tugev kärpimine, faili tihendamine, põhjalik ümbersõnastamine või tõlkimine, võivad muuta vesimärgi tuvastamatuks. Pärast ulatuslikke muudatusi võib ka tulemuse nimetamine „OpenAI-ga looduks“ olla vähem sisukas.
Sisu päritolu ja autentsuse koalitsiooni välja töötatud sisu päritolutõendid võivad kaduda igapäevaste toimingute, näiteks kuvatõmmise tegemise või faili teisendamise käigus. Kui need säilivad, võivad need anda faili päritolu ja ajaloo kohta rohkem üksikasju kui vesimärk üksi.
Kui see on tehniliselt võimalik, kasutame mõlemat meetodit, et päritoluteave säiliks sisu muutmisel suurema tõenäosusega.
Mis on sisu päritolutõendid ja mida need võimaldavad?
Sisu päritolutõendid lisavad failile teavet selle päritolu ja ajaloo kohta, näiteks millise tööriistaga ja millal see loodi. Need kasutavad sisu päritolu ja autentsuse koalitsiooni (C2PA) välja töötatud avatud standardit, mistõttu nimetatakse neid mõnikord ka „C2PA metaandmeteks“.
Sisu päritolutõendid aitavad inimestel kontrollida, kust sisu pärineb. Neid ei kasutata ainult tehisintellektiga loodud sisu puhul: ka kaameratootjad, uudisteorganisatsioonid ja teised kasutavad seda standardit oma meediasisu allika ja ajaloo tõendamiseks. Loe C2PA kohta lisateavet.
Mis on SynthID ja mida see võimaldab?
SynthID on Google DeepMindi välja töötatud nähtamatu vesimärgistamise tehnoloogia, mis põimib tunnuse otse loodud meediasisusse. Erinevalt metaandmetest on tunnus osa sisust endast ja võib säilida ka pärast mõningast töötlemist või teisendamist. SynthID pakub C2PA metaandmete kõrval täiendavat päritolutunnust. Näiteks kui failist eemaldatakse metaandmed, võib sellesse põimitud vesimärk siiski viidata sellele, et sisu loodi toetatud OpenAI tööriistadega. Loe SynthID kohta lisateavet.
Miks lisate tekstiväljunditele vesimärke?
Võtame ELi ChatGPT kasutajate jaoks kasutusele teksti vesimärgistamise, et täita ELi tehisintellektimäärust ja oma kohustusi ELi tehisintellektiga loodud sisu läbipaistvuse tegevusjuhendi alusel, millele OpenAI on koos mitme teise suure tehisintellektiteenuste pakkujaga alla kirjutanud.
Mis on textGrain ja mida see võimaldab?
textGrain on OpenAI tehnoloogia tekstile vesimärkide lisamiseks. See muudab õrnalt viisi, kuidas mudel valib kirjutamise ajal juhuslikult võimalike sõnade või sõnaosade vahel. Need valikud loovad tekstilõigus mustri, mida detektor saab otsida ka pärast mõningaid muudatusi.
Vesimärk on osa sõnastusest endast ega ole lugejale nähtav. See ei lisa peidetud märke, nähtamatuid tühikuid ega ebatavalisi kirjavahemärke. Teksti vesimärgistamine aitab täita ELi tehisintellektimääruse nõuet märgistada genereeritud teksti.
OpenAI kontrollitööriistad
Kuidas kontrollida, kas sisu on loodud OpenAI tööriistadega?
Aadressil openai.com/verify saad kontrollida, kas toetatud pildi- või helifail sisaldab OpenAI tööriistadega loodud või eksporditud sisuga seotud päritolutunnuseid. Pärast toetatud faili üleslaadimist otsib tööriist toetatud OpenAI päritolutunnuseid, näiteks SynthID vesimärki või OpenAI-ga seotud usaldusväärset C2PA avaldust. Kui tööriist leiab toetatud OpenAI päritolutunnuse, viitab see sellele, et sisu on tõenäoliselt loodud OpenAI mudeliga.
Arendajad ja organisatsioonid saavad kasutada ka OpenAI sisu päritolu API-t, et otsida piltidest ja helist OpenAI päritolutunnuseid ning integreerida kontrollimine oma rakendustesse või töövoogudesse. Sobiva kasutusjuhuga organisatsioonid saavad taotleda suuremaid kasutuspiiranguid.
Kooskõlas meie kohustustega ELi tehisintellektimääruse alusel saavad sobiva kasutusjuhuga organisatsioonid taotleda juurdepääsu tekstidetektorile. Nende hulka kuuluvad näiteks akadeemilised ja teadusorganisatsioonid, kes uurivad teksti päritolu, tuvastamise usaldusväärsust või seda, kuidas inimesed päritolu kontrollimise tulemusi mõistavad. Vaatame sobivate organisatsioonide taotlused läbi ükshaaval ning anname vajaduse korral edasisest teada või küsime lisateavet. Meie lähenemine juurdepääsule võib muutuda, kui saame uusi teadmisi ja täiustame tehnoloogiat.
Teeme praegu koostööd piiratud arvu teadlastega, sealhulgas Cornelli ülikooli arvutiteaduse abiprofessori John Thickstuniga, ETH Zürichi arvutiteaduse professori ja INSAIT-i teadusdirektori Martin Vecheviga ning Kempeleni intelligentsete tehnoloogiate instituudi (KInIT) teadlastega, et mõista paremini tehnoloogia võimalusi ja piiranguid ning täiustada selle põhjal teksti vesimärgistamist.
Kellel on õigus suurematele kontrollipiirangutele ja kas kontrollid on tasulised?
Sisu päritolu API kaudu kontrollimine on praegu tasuta ja sellele kehtivad kasutuspiirangud. Suuremate kasutuspiirangute programm keskendub tingimustele vastavatele avalikes huvides päritoluprojektidele ja teabe usaldusväärsust tagavatele töövoogudele, nagu kontrollimine uudistetoimetustes, faktikontroll, sisu päritolu uurimine ja regulatiivne järelevalve.
Üldised ärilised kasutusjuhud ei kuulu praegu programmi alla. Nende hulka kuuluvad näiteks äriline pettuste ennetamine, autentimine ja kontrollimine ning edasimüük päritolu- ja andmeanalüüsiteenuste pakettide osana.
Sobiva kasutusjuhuga organisatsioonid saavad taotleda suuremaid kasutuspiiranguid, kuid taotluse esitamine ei taga selle heakskiitmist. Avalik API on endiselt saadaval vaikimisi kasutuspiirangutega, sealhulgas väiksemahulisteks hindamisteks. Kehtivad kasutuspiirangud leiad sisu päritolu API dokumentatsioonist.
Kellel on õigus saada juurdepääs tekstidetektorile ja kas kontrollid on tasulised?
Tekstidetektoriga kontrollimine on praegu tasuta. Sobivate kasutusjuhtude hulka kuulub akadeemiliste ja teadusorganisatsioonide töö teksti päritolu, tuvastamise usaldusväärsuse või selle uurimisel, kuidas inimesed päritolu kontrollimise tulemusi mõistavad.
Üldised ärilised kasutusjuhud ei kuulu praegu programmi alla. Nende hulka kuuluvad näiteks äriline pettuste ennetamine, autentimine ja kontrollimine ning edasimüük päritolu- ja andmeanalüüsiteenuste pakettide osana.
Ka akadeemilise aususe kontrollimise kasutusjuhud, näiteks õppijate tööde kontrollimine tehisintellekti kasutamise suhtes (nt esseede või lõputööde kirjutamisel), ei kuulu praegu programmi alla.
Mida kontrollitulemused tähendavad?
Kui openai.com/verify või OpenAI sisu päritolu API kaudu tuvastatakse tunnus, tähendab see, et üles laaditud sisu sisaldab toetatud OpenAI-ga seotud päritolutunnust. Tööriist ei kinnita, et sisu on täpne, muutmata, seaduslikus omanduses või esitatud õiges kontekstis. Samuti ei tuvasta see, kes sisu lõi või miks see loodi.
Kui ühtki tunnust ei tuvastata, tähendab see, et tööriist ei leidnud üles laaditud failist OpenAI lisatud päritolutunnuseid. Sisu võib siiski olla OpenAI abil loodud või eksporditud, kui:
Sisu loodi enne päritolutunnuste kasutuselevõttu.
Sisu pärines tootest, mudelist, ekspordiviisist või failitüübist, mida ei toetata.
Metaandmed eemaldati üles- või allalaadimise, töötlemise, teisendamise või jagamise käigus.
Vesimärk kahjustus tihendamise, kärpimise, müra, töötlemise, vormingu teisendamise või muude muudatuste tõttu.
Heliklipp on liiga lühike või seda on oluliselt muudetud.
Kuidas saada kõige usaldusväärsem kontrollitulemus?
Laadi üles üks toetatud fail korraga ja kasuta võimaluse korral algset eksporditud faili. Piltide puhul väldi enne kontrollimist faili kärpimist või teisendamist. Heli puhul annavad tavaliselt parima tulemuse 10–60 sekundi pikkused klipid. Isegi kui ühtki tunnust ei tuvastata, arvesta enne järelduse tegemist faili allika ja kontekstiga.
Kas tulemused näitavad minu viipa või isikuandmeid?
Päritolutunnused ei sisalda üksikasju kasutaja, organisatsiooni ega viiba kohta.
Mis saab sisust, mida kontrollin openai.com/verify või sisu päritolu API kaudu?
Aadressile openai.com/verify üles laaditud või meie sisu päritolu API-le kontrollimiseks saadetud sisu töödeldakse ainult toetatud päritolutunnuste otsimiseks. Sisu ei salvestata, välja arvatud juhul, kui seadus seda nõuab, ning seda ei kasutata OpenAI mudelite treenimiseks.
Kas OpenAI suudab tuvastada teiste tehisintellektitööriistadega loodud sisu?
Meie sisu päritolu tööriistad on mõeldud tuvastama toetatud päritolutunnuseid, mis on seotud OpenAI mudelitega loodud või OpenAI tööriistadega eksporditud sisuga. Need ei ole mõeldud tuvastama teiste tehisintellektimudelitega loodud sisu ning võivad jätta tuvastamata ka OpenAI-ga loodud sisu, kui vajalik tunnus puudub, ei ole toetatud või on kahjustunud.
Kuidas vesimärgistamine toimib
Kas vesimärgid määravad autorsuse, omandiõiguse või õigusliku vastutuse?
Ei. Vesimärk on tõend selle kohta, et OpenAI mudel on sisu tõenäoliselt loonud või töödelnud. Ainuüksi vesimärk ei tõenda, kes on sisu autor või omanik, kas tehisintellekti kasutamisest tuli teavitada või kes õiguslikult vastutab. Samuti ei näita see, kas mudel töötles kasutaja üles laaditud sisu.
Kas vesimärgid näitavad, kui suurt rolli OpenAI mudel sisu loomisel mängis?
Ei. Detektor annab teada, kas see leidis vesimärgi. Vesimärgi leidmine on tõend selle kohta, et OpenAI mudel on sisu tõenäoliselt loonud või töödelnud, kuid see ei näita, kas mudel lõi osa sisust või kogu sisu ega seda, kui suur oli inimese panus.
Kuidas teksti vesimärgistamine toimib?
Teksti vesimärgistamine loob salajase mustri selles, kuidas mudel valib kirjutamise ajal sõnu ja sõnaosi ehk „tokeneid“.
Igal sammul määrab mudel igale võimalikule järgmisele tokenile tõenäosuse. Vesimärgistamissüsteem loob neist tõenäosustest mitu kohandatud komplekti, millest igaüks eelistab salajase võtme alusel eri valikuid. Komplektid on tasakaalustatud nii, et nende keskmised vastavad mudeli algsetele tõenäosustele. Võti määrab, millist komplekti kasutada, ja mudel teeb seejärel selle komplekti põhjal uue juhusliku valiku.
Sama võtme ja vastavate seadetega detektor saab hiljem kontrollida, kas tekst järgib salajast mustrit sagedamini, kui võiks juhuse tõttu eeldada.
Kas teksti vesimärke lisatakse ka faktitekstile ja kasutaja esitatud tekstile?
Teksti vesimärgistamine eeldab, et mudel saab sama mõtet mitmel viisil väljendada. Valikuvabadust on vähem siis, kui vastus peab olema rangelt faktipõhine või täpne, näiteks matemaatikaülesande vastus, või kui mudelil palutakse esitatud teksti muutmata kujul korrata. Sellistel juhtudel on mudelil vähem võimalusi sõnastust märkamatult muuta, mistõttu ei pruugi vesimärk olla tuvastatav.
Kas teksti vesimärke lisatakse ka lühivastustele ja koodile?
Lühikesed lõigud ei sisalda tavaliselt piisavalt teksti, et vesimärki usaldusväärselt tuvastada. Ka koodile on raskem vesimärki lisada, sest selles on järgmise elemendi jaoks vähem sobivaid valikuid kui tavalises proosas.
Neid piiranguid arvestades ei nõua ELi tehisintellektimääruse kohane tehisintellektiga loodud sisu läbipaistvuse tegevusjuhend vesimärke väljundites, mis on lühemad kui 200 tokenit ehk umbes 150 ingliskeelset sõna, ega koodilõikudes.
Kuidas erineb teksti vesimärkide tuvastamine keeliti?
Tuvastamismäärad erinevad keeliti ning mõnes keeles on vesimärke praegu lihtsam tuvastada kui teises. Saame vesimärgi tugevust reguleerida, et parandada tuvastamist keeltes, kus signaal on nõrgem.
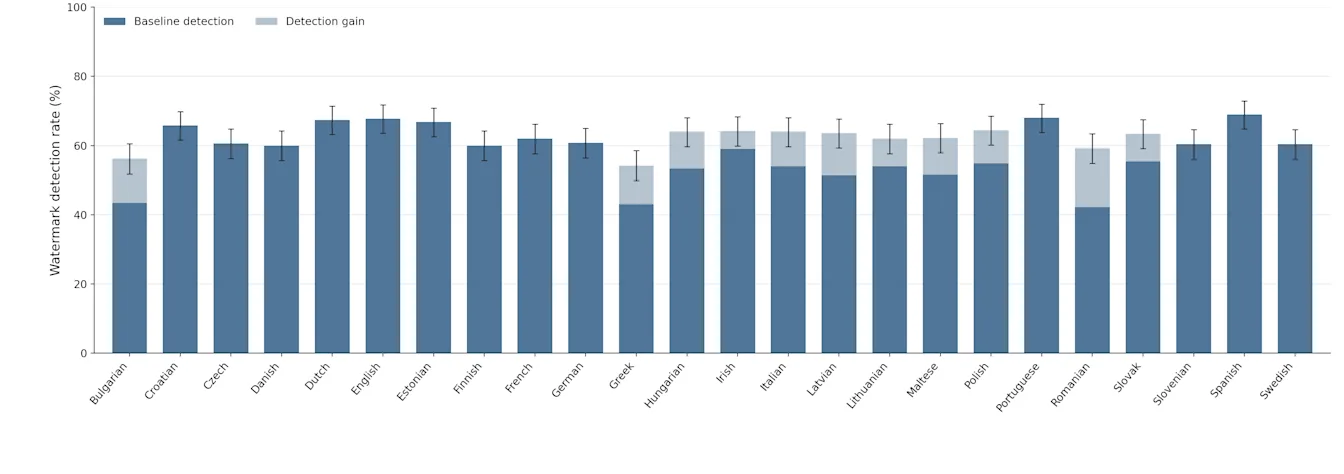
See diagramm näitab tuvastamismäära kõigis ELi 24 ametlikus keeles. Kõigepealt genereerisime 500 sünteetilist ingliskeelset viipa eri teemadel ning tõlkisime need seejärel ülejäänud 23 keelde. 1% valepositiivsete määra juures on tuvastamismäär kõrgeim hispaania keeles (69,0%) ja madalaim rumeenia keeles (42,2%). Meie vesimärgil on reguleeritav tugevusparameeter ehk „nupp“, millega saab vesimärgi signaali eri valdkondades tugevdada või nõrgendada. Selle nupu abil saime suurendada tugevust keeltes, mille tuvastamismäär jäi alla 60%; tulpade helesinised osad näitavad sellest saadud paranemist.
Kas teksti vesimärgid halvendavad mudeli kvaliteeti?
Meie katsete põhjal mitte. Võrdlustestides, mida kasutame oma uusima tipptasemel mudeli Astra hindamiseks, jäävad vesimärgistamisega ja vesimärgistamiseta tulemuste erinevused tavapärase hindamiskordade vahelise kõikumise piiresse. Ka varasemad katsed ChatGPT-s näitasid, et vesimärgistamise kasutuselevõtt ei muutnud negatiivsete hinnangute osakaalu ega muid tootenäitajaid.
Kas teksti vesimärgid aeglustavad mudelit?
Teksti vesimärgistamise mõju meie mudelite kiirusele on tühine.
Mille poolest erinevad OpenAI teksti vesimärgid kolmandate osapoolte tehisintellektisisu tuvastamise tööriistadest?
Kolmandate osapoolte tuvastustööriistad, näiteks Pangram, kasutavad tavaliselt klassifikaatoreid, et tuvastada tehisintellektiga loodud teksti selliste mustrite põhjal nagu sõnavalik. See meetod analüüsib teksti pärast selle loomist, mitte ei tuvasta teksti põimitud tunnust. ELi tehisintellektimäärus nõuab konkreetselt tunnuse põimimist loodud teksti.
Miks kasutate TextSeali või SynthID asemel oma teksti vesimärke?
Töötasime välja oma teksti vesimärgistamise meetodi textGrain, et saaksime SynthID või TextSealiga võrreldes paremini reguleerida tasakaalu vesimärgi tuvastatavuse ja sama viiba põhjal loodud vastuste mitmekesisuse vahel. Meie katsetes tuvastas meie meetod õigesti sama suure või suurema osa vesimärgistatud tekstinäidistest kui tekstile mõeldud SynthID. Plaanime avaldada textGraini avatud lähtekoodiga tehnoloogiana, et teised saaksid sellele tugineda ja aidata teksti vesimärgistamist täiustada.
Kas teksti vesimärgistamine lisab peidetud märke, lisatokeneid või nähtavaid muudatusi?
Ei. Teksti vesimärgistamine muudab sõnavalikute statistilist mustrit; see ei lisa peidetud märke ega üksnes vesimärgi jaoks mõeldud tokeneid. Vesimärk ei ole lugejale nähtav ning teksti kopeerimine ja kleepimine ei lisa peidetud sisu.
Juhised klientidele
Olen API klient. Kuidas teksti vesimärgid sisse lülitada?
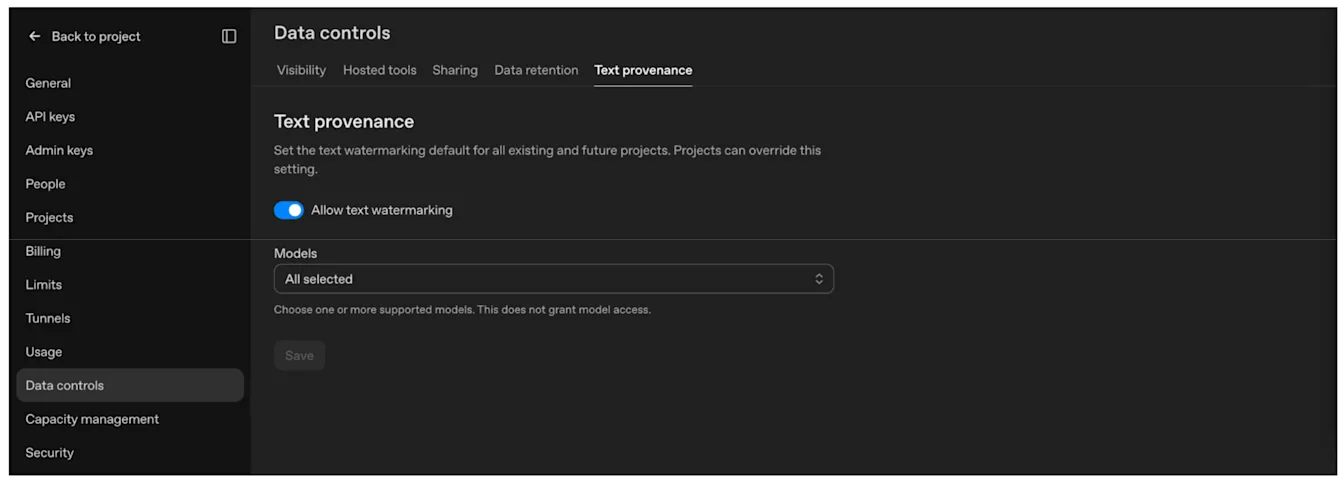
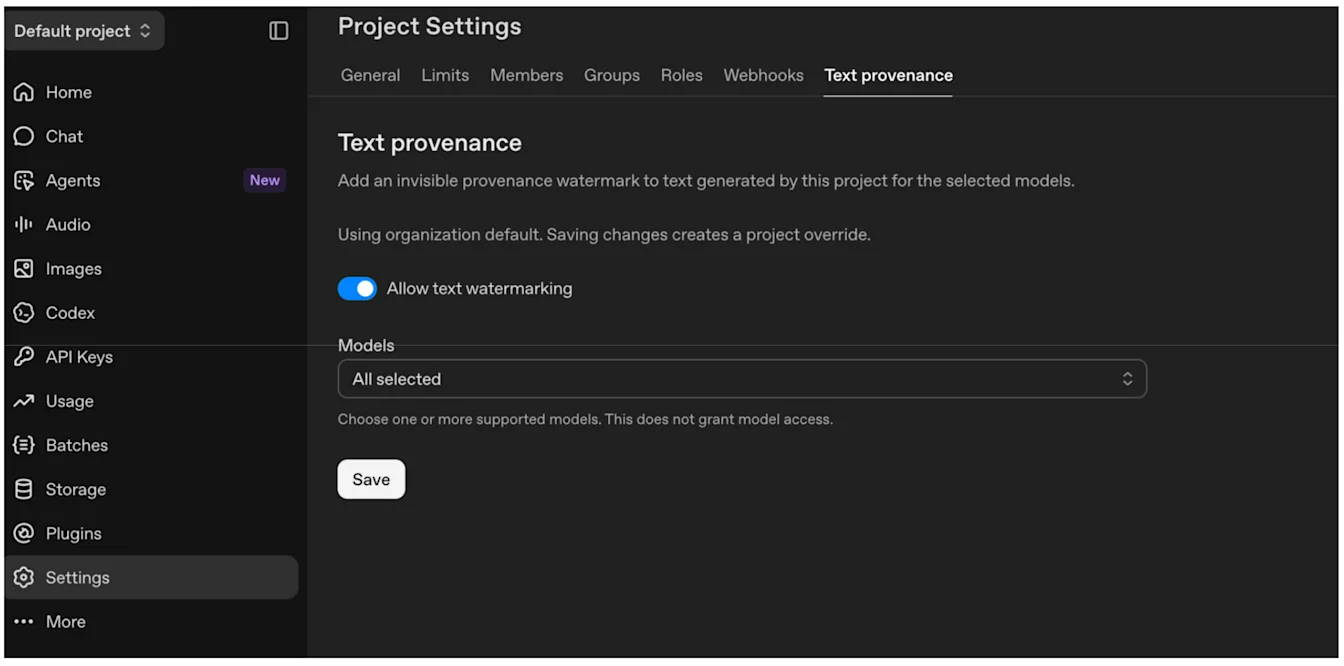
OpenAI API kliendid saavad lülitada teksti vesimärgistamise sisse konkreetse projekti jaoks seadetes või kogu organisatsiooni jaoks organisatsiooni seadetes. Mõlemal juhul saavad kliendid valida, milliste mudelite tekstile vesimärk lisatakse. Kui funktsioon on toetatud mudeli jaoks sisse lülitatud, lisab OpenAI vesimärgi teksti loomise ajal. Kliendid ei pea igale vastusele eraldi märgistust lisama.
Lülita sisse „Luba teksti vesimärgistamine“, vali mudelid ja seejärel „Salvesta“.
Organisatsiooni vaikesäte: Organisatsiooni seaded → Andmehaldus → Teksti päritolu.
Projekti erisäte: Projekti seaded → Teksti päritolu.
Milliste mudelite puhul saan vesimärgid sisse lülitada?
Kliendid näevad seadetes ja organisatsiooni seadetes loendit mudelitest, mille puhul on vesimärgistamine praegu saadaval. Lähinädalatel laiendame tuge kõigile varasematele mudelitele.
Kas teksti vesimärkide sisselülitamine annab mulle ka juurdepääsu tekstidetektorile?
Ei. Juurdepääs tekstidetektorile on praegu piiratud heakskiidetud teadus- ja akadeemiliste organisatsioonidega, kes töötavad selle nimel, et teksti vesimärgistamine oleks usaldusväärsem ja lihtsam kasutada ning tehnoloogiat ja selle tulemusi saaks selgemini selgitada. See on kooskõlas meie kohustustega ELi tehisintellektimääruse kohase tehisintellektiga loodud sisu läbipaistvuse tegevusjuhendi alusel.
Kas tunnused jäävad sisule alles ka pärast selle muutmist?
Võivad jääda, kuid see sõltub tunnusest ja tehtud muudatustest.
Toetatud piltide ja heli puhul säilita originaalkoopia ning kasuta sisu päritolu API-t, et kontrollida esinduslikku valikut failidest pärast töötlemist, teisendamist ja avaldamist. Piltide puhul võivad kärpimine, müra lisamine, JPEG-vormingusse teisendamine ja kuvatõmmiste tegemine muuta tunnuste tuvastamise raskemaks. Teksti saad sel viisil kontrollida ainult siis, kui sinu organisatsioonile on antud juurdepääs tekstidetektorile.
Kui failivorming ja töövoog seda toetavad, säilita olemasolevad C2PA metaandmed ning lisa loodud failidele sisu päritolutõendid. Võid kaaluda ka oma märgistuste lisamist, et päritoluteave säiliks paremini või oleks kasulikum. Rakendamise üksikasjad leiad C2PA tehnilisest dokumentatsioonist.
Teksti puhul on vesimärk osa mudeli sõnavalikutest. Kui säilitad sõnastuse, peaks tunnus teksti taaskasutamisel alles jääma, ilma et oleks vaja täiendavat integreerimist. Ulatuslik ümberkirjutamine, ümbersõnastamine või tõlkimine võib muuta tuvastamise vähem usaldusväärseks. Isegi muutmata sõnastus ei taga tuvastatavat vesimärki, eriti lühikestes lõikudes või tekstis, kus sõnavalikuteks on vähe võimalusi.
Kasutan OpenAI mudeleid pilveteenuse kaudu. Kas ka need väljundid sisaldavad päritolutunnuseid?
Teeme koostööd kõigi oma pilveteenuste ja levituspartneritega, et päritolutunnused, sealhulgas vesimärgid, lisataks kõigile sobivatele väljunditele, sealhulgas piltidele, helile ja tekstile. Kättesaadavus võib väljundi ja partneri lõikes erineda.
Kas päritolutunnused asendavad nähtavaid tehisintellektimärgiseid või muid teavitusi?
Ei. Vesimärgid ja C2PA metaandmed pakuvad tarkvaraga loetavat teavet. Need ei asenda nähtavaid märgiseid, bännereid ega muid teateid, mis võivad olla nõutud.
Täiendava teavituse vajadus sõltub sellest, kuidas ja kus sa sisu kasutad. OpenAI ei saa sind nõustada sinu konkreetsete õiguslike kohustuste osas; sinu kasutusjuhule kehtivaid nõudeid peaksid hindama sinu õigusnõustajad.
Mul on veel küsimusi ELi tehisintellektimääruse kohta
Palun esita päring ELi tehisintellektimääruse kohta ja võtame sinuga ühendust.