
OpenAI on pühendunud turvalisema ja läbipaistvama tehisintellekti ökosüsteemi loomisele ning kasutab päritolusignaale, et aidata inimestel mõista, kas sisu on loodud OpenAI mudeliga.
Päritolusignaalid võivad anda kasulikku teavet sisu päritolu kohta, kuid need ei taga, et sisu on täpne, muutmata või esitatud õiges kontekstis ega kinnita selle seaduslikku omandiõigust.
OpenAI päritolutunnused
Milliseid päritolusignaale OpenAI kasutab?
OpenAI kasutab eri sisutüüpide puhul erinevaid päritolusignaale.
| Sisutüüp | Päritolusignaalid | Märkused |
|---|---|---|
| Pildid | Content Credentialsi andmed ja SynthID vesimärgid | ChatGPT, Codexi või OpenAI API-ga loodud pildid sisaldavad mõlemat signaali. |
| Heli | SynthID vesimärgid | ChatGPT või OpenAI API-ga loodud heli sisaldab kuuldamatut vesimärki, mis on lisatud helisse endasse. |
| Tekst | textGraini vesimärgid (ainult EL-is) | EL-is sisaldab ChatGPT-ga loodud tekst nähtamatut muudatust mudeli sõnavalikute juhuslikkuses, et täita EL-i tehisintellektimääruse nõudeid. API kliendid üle maailma saavad oma projekti või organisatsiooni seadetes lülitada sisse tekstiväljundite vesimärgistamise. |
| Video | Content Credentialsi andmed | Sora on kasutuselt kõrvaldatud. Loe lähemalt. |
Signaalide olemasolu võib sõltuda tootest, mudelist, ekspordiviisist, failitüübist ja sisu loomise ajast. API väljundid sisaldavad signaale, välja arvatud peagi kasutuselt kõrvaldatavate mudelite puhul, sealhulgas gpt-image-1, gpt-image-1.5 ja sora-2.
Miks kasutatakse mõne sisutüübi puhul mitut tunnust?
Kui see on tehniliselt võimalik, kombineerib OpenAI metaandmeid ja vesimärke, et need saaksid teineteise piiranguid leevendada. Metaandmed võivad sisaldada üksikasjalikku teavet, kuid platvormid, töötlustööriistad ja failide teisendamine võivad need eemaldada. Vesimärgid annavad vähem taustteavet, kuid kuna need on põimitud loodud sisusse endasse, võivad need säilida ka pärast mõningaid muudatusi, mille käigus metaandmed kaovad.
Kui hästi peavad päritolutunnused vastu sisu muutmisele?
Piltide ja heli SynthID vesimärgid ning teksti textGraini vesimärgid on loodud taluma tavapäraseid muudatusi. Olenevalt sisutüübist võivad need hõlmata kerget töötlemist, kopeerimist ja kleepimist, kärpimist või kuvatõmmiste tegemist. Ulatuslikumad muudatused, näiteks pildi tugev kärpimine, faili tihendamine, põhjalik ümbersõnastamine või tõlkimine, võivad muuta vesimärgi tuvastamatuks. Pärast ulatuslikke muudatusi võib ka tulemuse nimetamine „OpenAI-ga looduks“ olla vähem sisukas.
Sisu päritolu ja autentsuse koalitsiooni välja töötatud sisu päritolutõendid võivad kaduda igapäevaste toimingute, näiteks kuvatõmmise tegemise või faili teisendamise käigus. Kui need säilivad, võivad need anda faili päritolu ja ajaloo kohta rohkem üksikasju kui vesimärk üksi.
Kui see on tehniliselt võimalik, kasutame mõlemat meetodit, et päritoluteave säiliks sisu muutmisel suurema tõenäosusega.
Mis on sisu päritolutõendid ja mida need võimaldavad?
Sisu päritolutõendid lisavad failile teavet selle päritolu ja ajaloo kohta, näiteks millise tööriistaga ja millal see loodi. Need kasutavad sisu päritolu ja autentsuse koalitsiooni (C2PA) välja töötatud avatud standardit, mistõttu nimetatakse neid mõnikord ka „C2PA metaandmeteks“.
Sisu päritolutõendid aitavad inimestel kontrollida, kust sisu pärineb. Neid ei kasutata ainult tehisintellektiga loodud sisu puhul: ka kaameratootjad, uudisteorganisatsioonid ja teised kasutavad seda standardit oma meediasisu allika ja ajaloo tõendamiseks. Loe C2PA kohta lisateavet.
Mis on SynthID ja mida see võimaldab?
SynthID on Google DeepMindi välja töötatud nähtamatu vesimärgistamise tehnoloogia, mis põimib tunnuse otse loodud meediasisusse. Erinevalt metaandmetest on tunnus osa sisust endast ja võib säilida ka pärast mõningast töötlemist või teisendamist. SynthID pakub C2PA metaandmete kõrval täiendavat päritolutunnust. Näiteks kui failist eemaldatakse metaandmed, võib sellesse põimitud vesimärk siiski viidata sellele, et sisu loodi toetatud OpenAI tööriistadega. Loe SynthID kohta lisateavet.
Miks lisate tekstiväljunditele vesimärke?
Võtame ELi ChatGPT kasutajate jaoks kasutusele teksti vesimärgistamise, et täita ELi tehisintellektimäärust ja oma kohustusi ELi tehisintellektiga loodud sisu läbipaistvuse tegevusjuhendi alusel, millele OpenAI on koos mitme teise suure tehisintellektiteenuste pakkujaga alla kirjutanud.
Mis on textGrain ja mida see võimaldab?
textGrain on OpenAI tehnoloogia tekstile vesimärkide lisamiseks. See muudab õrnalt viisi, kuidas mudel valib kirjutamise ajal juhuslikult võimalike sõnade või sõnaosade vahel. Need valikud loovad tekstilõigus mustri, mida detektor saab otsida ka pärast mõningaid muudatusi.
Vesimärk on osa sõnastusest endast ega ole lugejale nähtav. See ei lisa peidetud märke, nähtamatuid tühikuid ega ebatavalisi kirjavahemärke. Teksti vesimärgistamine aitab täita ELi tehisintellektimääruse nõuet märgistada genereeritud teksti.
OpenAI kontrollitööriistad
Kuidas kontrollida, kas sisu on loodud OpenAI tööriistadega?
Lehel openai.com/verify saad kontrollida, kas toetatud pildi- või helifail sisaldab päritolusignaale, mis on seotud OpenAI tööriistadega loodud või eksporditud sisuga. Pärast toetatud faili üleslaadimist otsib tööriist sellest toetatud OpenAI päritolusignaale, näiteks SynthID vesimärki või OpenAI-ga seotud usaldusväärset C2PA avaldust. Kui tööriist leiab toetatud OpenAI päritolusignaali, viitab see sellele, et sisu on tõenäoliselt loonud OpenAI mudel.
Arendajad ja organisatsioonid saavad kasutada ka OpenAI sisu päritolu API-t, et kontrollida OpenAI päritolusignaalide olemasolu piltides ja helis ning lõimida kontroll oma rakendustesse või töövoogudesse. Organisatsioonid, mille kasutusjuht vastab tingimustele, saavad taotleda suuremaid kasutuslimiite.
Kooskõlas meie kohustustega EL-i tehisintellektimääruse alusel saavad tingimustele vastava kasutusjuhuga organisatsioonid taotleda juurdepääsu tekstituvastustööriistale. Nende hulka kuuluvad näiteks akadeemilised ja teadusorganisatsioonid, mis uurivad teksti päritolu, tuvastamise usaldusväärsust või seda, kuidas inimesed päritolukontrolli tulemusi mõistavad. Vaatame tingimustele vastavate organisatsioonide taotlused läbi juhtumipõhiselt ning võtame vajaduse korral ühendust, et jagada uut teavet või küsida lisainfot. Meie lähenemine juurdepääsu võimaldamisele võib muutuda, kui saame uusi teadmisi ja täiustame tehnoloogiat.
Teeme praegu koostööd väikese teadlaste rühmaga, et mõista paremini tehnoloogia võimalusi ja piiranguid ning kasutada saadud teadmisi teksti vesimärgistamise täiustamiseks. Partnerite hulka kuuluvad Cornelli ülikooli arvutiteaduse abiprofessor John Thickstun, ETH Zürichi arvutiteaduse professor ja INSAIT-i teadusdirektor Martin Vechev ning Kempeleni intelligentsete tehnoloogiate instituudi (KInIT) teadlased.
Kellel on õigus suurematele kontrollipiirangutele ja kas kontrollid on tasulised?
Sisu päritolu API kaudu kontrollimine on praegu tasuta ja sellele kehtivad kasutuspiirangud. Suuremate kasutuspiirangute programm keskendub tingimustele vastavatele avalikes huvides päritoluprojektidele ja teabe usaldusväärsust tagavatele töövoogudele, nagu kontrollimine uudistetoimetustes, faktikontroll, sisu päritolu uurimine ja regulatiivne järelevalve.
Üldised ärilised kasutusjuhud ei kuulu praegu programmi alla. Nende hulka kuuluvad näiteks äriline pettuste ennetamine, autentimine ja kontrollimine ning edasimüük päritolu- ja andmeanalüüsiteenuste pakettide osana.
Sobiva kasutusjuhuga organisatsioonid saavad taotleda suuremaid kasutuspiiranguid, kuid taotluse esitamine ei taga selle heakskiitmist. Avalik API on endiselt saadaval vaikimisi kasutuspiirangutega, sealhulgas väiksemahulisteks hindamisteks. Kehtivad kasutuspiirangud leiad sisu päritolu API dokumentatsioonist.
Kellel on õigus saada juurdepääs tekstidetektorile ja kas kontrollid on tasulised?
Tekstidetektoriga kontrollimine on praegu tasuta. Sobivate kasutusjuhtude hulka kuulub akadeemiliste ja teadusorganisatsioonide töö teksti päritolu, tuvastamise usaldusväärsuse või selle uurimisel, kuidas inimesed päritolu kontrollimise tulemusi mõistavad.
Üldised ärilised kasutusjuhud ei kuulu praegu programmi alla. Nende hulka kuuluvad näiteks äriline pettuste ennetamine, autentimine ja kontrollimine ning edasimüük päritolu- ja andmeanalüüsiteenuste pakettide osana.
Ka akadeemilise aususe kontrollimise kasutusjuhud, näiteks õppijate tööde kontrollimine tehisintellekti kasutamise suhtes (nt esseede või lõputööde kirjutamisel), ei kuulu praegu programmi alla.
Mida kontrolli tulemused tähendavad?
Kui lehel openai.com/verify või OpenAI sisu päritolu API kaudu tuvastatakse signaal, tähendab see, et üleslaaditud sisu sisaldab toetatud päritolusignaali, mis on seotud OpenAI-ga. Tööriist ei kinnita, et sisu on täpne, muutmata või esitatud õiges kontekstis, ega tõenda selle seaduslikku omandiõigust. Samuti ei tuvasta see, kes sisu lõi või miks see loodi.
Kui ühtegi signaali ei tuvastata, tähendab see, et tööriist ei leidnud üleslaaditud failist OpenAI lisatud päritolusignaale. Sisu võib siiski olla OpenAI tööriistadega loodud või eksporditud, kui:
Sisu loodi enne päritolusignaalide kasutuselevõttu.
Sisu pärineb toetamata tootest või mudelist, on eksporditud toetamata viisil või on toetamata failitüübis.
Metaandmed eemaldati üleslaadimise, allalaadimise, töötlemise, teisendamise või jagamise käigus.
Vesimärk sai kahjustada tihendamise, kärpimise, müra, töötluste, vormingu teisendamise või muude muudatuste tõttu.
Heliklipp on liiga lühike või seda on oluliselt muudetud.
Kuidas saada kõige usaldusväärsem kontrollitulemus?
Laadi üles üks toetatud fail korraga ja kasuta võimaluse korral algset eksporditud faili. Piltide puhul väldi enne kontrollimist faili kärpimist või teisendamist. Heli puhul annavad tavaliselt parima tulemuse 10–60 sekundi pikkused klipid. Isegi kui ühtki tunnust ei tuvastata, arvesta enne järelduse tegemist faili allika ja kontekstiga.
Kas tulemused näitavad minu viipa või isikuandmeid?
Päritolutunnused ei sisalda üksikasju kasutaja, organisatsiooni ega viiba kohta.
Mis saab sisust, mida kontrollin lehel openai.com/verify või sisu päritolu API kaudu?
Lehele openai.com/verify üles laaditud või meie sisu päritolu API-le kontrollimiseks saadetud sisu töödeldakse ainult toetatud päritolusignaalide otsimiseks. Sisu ei säilitata, välja arvatud juhul, kui seadus seda nõuab, ning seda ei kasutata OpenAI mudelite treenimiseks.
Kas OpenAI suudab tuvastada teiste tehisintellektitööriistadega loodud sisu?
Meie sisu päritolu tööriistad on mõeldud tuvastama toetatud päritolutunnuseid, mis on seotud OpenAI mudelitega loodud või OpenAI tööriistadega eksporditud sisuga. Need ei ole mõeldud tuvastama teiste tehisintellektimudelitega loodud sisu ning võivad jätta tuvastamata ka OpenAI-ga loodud sisu, kui vajalik tunnus puudub, ei ole toetatud või on kahjustunud.
Kuidas vesimärgistamine toimib
Kas vesimärgid määravad autorsuse, omandiõiguse või õigusliku vastutuse?
Ei. Vesimärk on tõend selle kohta, et OpenAI mudel on sisu tõenäoliselt loonud või töödelnud. Ainuüksi vesimärk ei tõenda, kes on sisu autor või omanik, kas tehisintellekti kasutamisest tuli teavitada või kes õiguslikult vastutab. Samuti ei näita see, kas mudel töötles kasutaja üles laaditud sisu.
Kas vesimärgid näitavad, kui suurt rolli OpenAI mudel sisu loomisel mängis?
Ei. Detektor annab teada, kas see leidis vesimärgi. Vesimärgi leidmine on tõend selle kohta, et OpenAI mudel on sisu tõenäoliselt loonud või töödelnud, kuid see ei näita, kas mudel lõi osa sisust või kogu sisu ega seda, kui suur oli inimese panus.
Kuidas teksti vesimärgistamine toimib?
Teksti vesimärgistamine loob salajase mustri selles, kuidas mudel valib kirjutamise ajal sõnu ja sõnaosi ehk „tokeneid“.
Igal sammul määrab mudel igale võimalikule järgmisele tokenile tõenäosuse. Vesimärgistamissüsteem loob neist tõenäosustest mitu kohandatud komplekti, millest igaüks eelistab salajase võtme alusel eri valikuid. Komplektid on tasakaalustatud nii, et nende keskmised vastavad mudeli algsetele tõenäosustele. Võti määrab, millist komplekti kasutada, ja mudel teeb seejärel selle komplekti põhjal uue juhusliku valiku.
Sama võtme ja vastavate seadetega detektor saab hiljem kontrollida, kas tekst järgib salajast mustrit sagedamini, kui võiks juhuse tõttu eeldada.
Kas teksti vesimärke lisatakse ka faktitekstile ja kasutaja esitatud tekstile?
Teksti vesimärgistamine eeldab, et mudel saab sama mõtet mitmel viisil väljendada. Valikuvabadust on vähem siis, kui vastus peab olema rangelt faktipõhine või täpne, näiteks matemaatikaülesande vastus, või kui mudelil palutakse esitatud teksti muutmata kujul korrata. Sellistel juhtudel on mudelil vähem võimalusi sõnastust märkamatult muuta, mistõttu ei pruugi vesimärk olla tuvastatav.
Kas teksti vesimärke lisatakse ka lühivastustele ja koodile?
Lühikesed lõigud ei sisalda tavaliselt piisavalt teksti, et vesimärki usaldusväärselt tuvastada. Ka koodile on raskem vesimärki lisada, sest selles on järgmise elemendi jaoks vähem sobivaid valikuid kui tavalises proosas.
Neid piiranguid arvestades ei nõua ELi tehisintellektimääruse kohane tehisintellektiga loodud sisu läbipaistvuse tegevusjuhend vesimärke väljundites, mis on lühemad kui 200 tokenit ehk umbes 150 ingliskeelset sõna, ega koodilõikudes.
Kuidas erineb teksti vesimärkide tuvastamine keeliti?
Tuvastamismäärad erinevad keeliti ning mõnes keeles on vesimärke praegu lihtsam tuvastada kui teises. Saame vesimärgi tugevust reguleerida, et parandada tuvastamist keeltes, kus signaal on nõrgem.
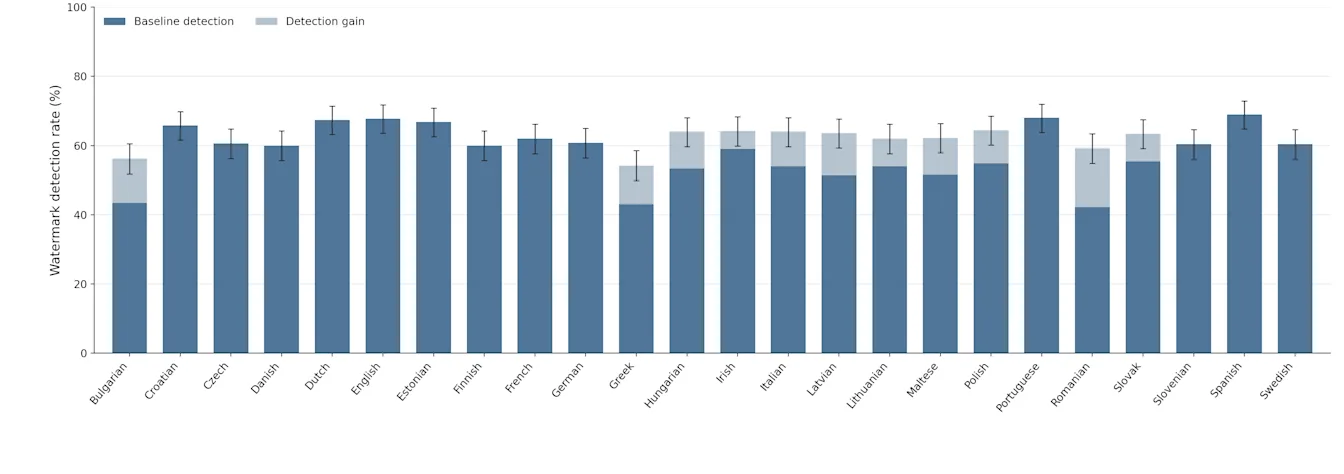
See diagramm näitab tuvastamismäära kõigis ELi 24 ametlikus keeles. Kõigepealt genereerisime 500 sünteetilist ingliskeelset viipa eri teemadel ning tõlkisime need seejärel ülejäänud 23 keelde. 1% valepositiivsete määra juures on tuvastamismäär kõrgeim hispaania keeles (69,0%) ja madalaim rumeenia keeles (42,2%). Meie vesimärgil on reguleeritav tugevusparameeter ehk „nupp“, millega saab vesimärgi signaali eri valdkondades tugevdada või nõrgendada. Selle nupu abil saime suurendada tugevust keeltes, mille tuvastamismäär jäi alla 60%; tulpade helesinised osad näitavad sellest saadud paranemist.
Kas teksti vesimärgid halvendavad mudeli kvaliteeti?
Meie katsete põhjal mitte. Võrdlustestides, mida kasutame oma uusima tipptasemel mudeli Astra hindamiseks, jäävad vesimärgistamisega ja vesimärgistamiseta tulemuste erinevused tavapärase hindamiskordade vahelise kõikumise piiresse. Ka varasemad katsed ChatGPT-s näitasid, et vesimärgistamise kasutuselevõtt ei muutnud negatiivsete hinnangute osakaalu ega muid tootenäitajaid.
Kas teksti vesimärgid aeglustavad mudelit?
Teksti vesimärgistamise mõju meie mudelite kiirusele on tühine.
Mille poolest erinevad OpenAI tekstivesimärgid kolmandate osapoolte tehisintellekti tuvastamise tööriistadest?
Kolmandate osapoolte tuvastustööriistad, näiteks Pangram, kasutavad tavaliselt klassifikaatoreid, et tuvastada tehisintellekti loodud teksti selliste mustrite nagu sõnavaliku põhjal. See lähenemine analüüsib teksti pärast selle loomist, mitte ei tuvasta sellesse lisatud signaali. EL-i tehisintellektimäärus nõuab konkreetselt signaali lisamist loodud teksti.
Miks kasutate TextSeali või SynthID asemel oma teksti vesimärke?
Töötasime välja oma teksti vesimärgistamise meetodi textGrain, et saaksime SynthID või TextSealiga võrreldes paremini reguleerida tasakaalu vesimärgi tuvastatavuse ja sama viiba põhjal loodud vastuste mitmekesisuse vahel. Meie katsetes tuvastas meie meetod õigesti sama suure või suurema osa vesimärgistatud tekstinäidistest kui tekstile mõeldud SynthID. Plaanime avaldada textGraini avatud lähtekoodiga tehnoloogiana, et teised saaksid sellele tugineda ja aidata teksti vesimärgistamist täiustada.
Kas teksti vesimärgistamine lisab peidetud märke, lisatokeneid või nähtavaid muudatusi?
Ei. Teksti vesimärgistamine muudab sõnavalikute statistilist mustrit; see ei lisa peidetud märke ega üksnes vesimärgi jaoks mõeldud tokeneid. Vesimärk ei ole lugejale nähtav ning teksti kopeerimine ja kleepimine ei lisa peidetud sisu.
Juhised klientidele
Olen API klient. Kuidas tekstivesimärgid sisse lülitada?
OpenAI API kliendid saavad lülitada teksti vesimärgistamise sisse kindla projekti jaoks seadetes või kogu organisatsiooni jaoks organisatsiooni seadetes. Mõlemal juhul saavad kliendid valida, milliste mudelite tekstile vesimärk lisatakse. Kui vesimärgistamine on toetatud mudeli puhul sisse lülitatud, lisab OpenAI vesimärgi teksti loomise ajal. Kliendid ei pea igale vastusele eraldi märgist lisama.
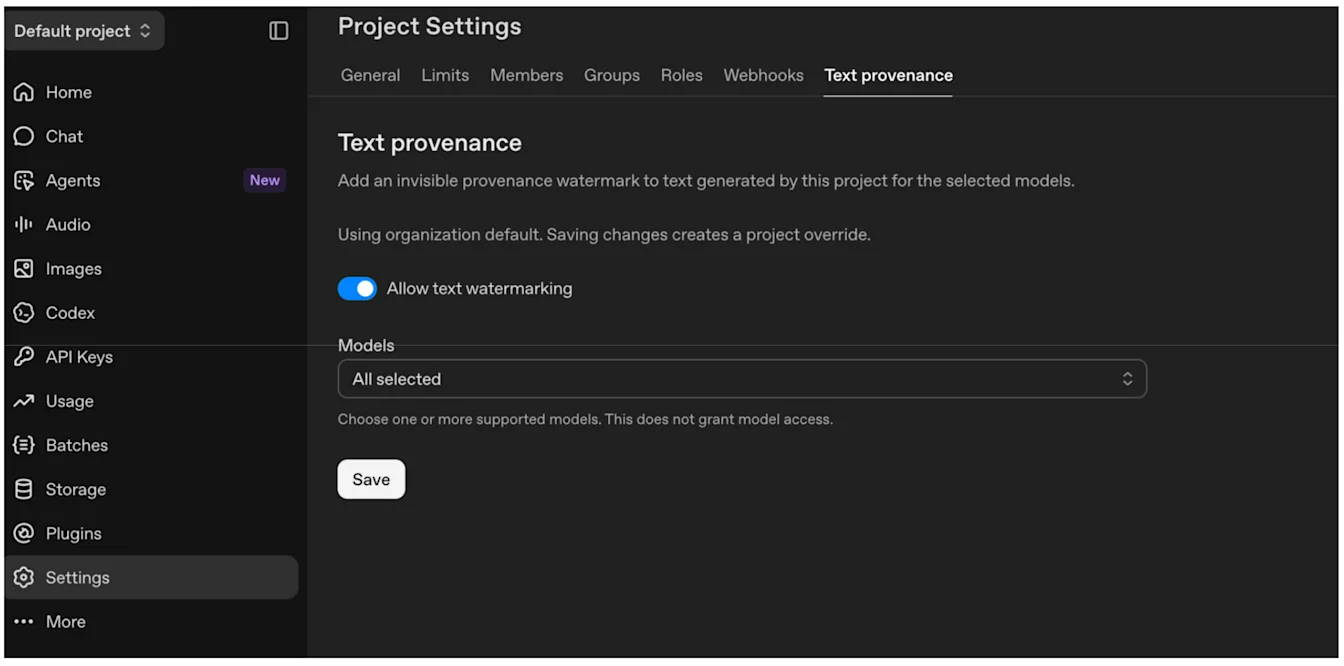
Lülita sisse Luba teksti vesimärgistamine, vali mudelid ja seejärel Salvesta.
Organisatsiooni vaikeseade: ava Organisatsiooni seaded > Andmehaldus.
Vali Teksti päritolu.
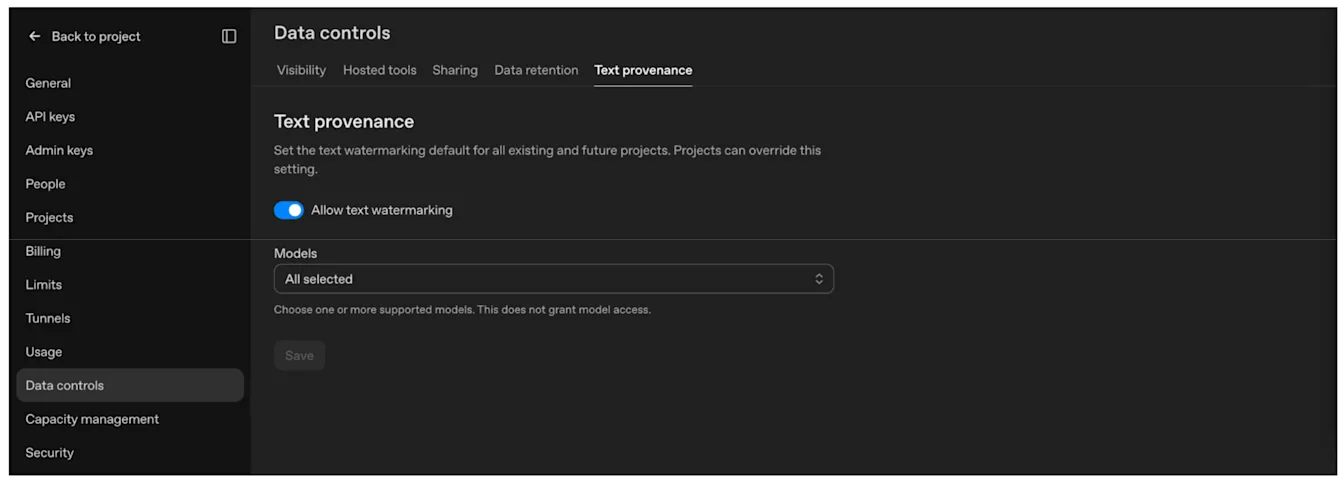
Projektipõhine erand: ava Projekti seaded > Teksti päritolu.
Milliste mudelite puhul saan vesimärgid sisse lülitada?
Seadetes ja organisatsiooni seadetes näevad kliendid nende mudelite loendit, mille puhul on vesimärgistamine praegu saadaval. Lähinädalatel laiendame toe kõigile varasematele mudelitele.
Kas teksti vesimärkide sisselülitamine annab mulle ka juurdepääsu tekstidetektorile?
Ei. Juurdepääs tekstidetektorile on praegu piiratud heakskiidetud teadus- ja akadeemiliste organisatsioonidega, kes töötavad selle nimel, et teksti vesimärgistamine oleks usaldusväärsem ja lihtsam kasutada ning tehnoloogiat ja selle tulemusi saaks selgemini selgitada. See on kooskõlas meie kohustustega ELi tehisintellektimääruse kohase tehisintellektiga loodud sisu läbipaistvuse tegevusjuhendi alusel.
Kas signaalid jäävad sisuga seotuks ka pärast selle muutmist?
Need võivad säilida, kuid see sõltub signaalist ja tehtud muudatustest.
Säilita toetatud pildi- ja helifailide originaalkoopia ning kasuta sisu päritolu API-t, et kontrollida tüüpilisi näidisfaile pärast töötlemist, teisendamist ja avaldamist. Piltide kärpimine, müra lisamine, JPEG-vormingusse teisendamine ja kuvatõmmiste tegemine võib raskendada signaalide tuvastamist. Teksti saad sel viisil kontrollida ainult siis, kui sinu organisatsioonile on antud juurdepääs tekstituvastustööriistale.
Kui failivorming ja töövoog seda toetavad, säilita olemasolevad C2PA metaandmed ning lisa loodavatele failidele Content Credentialsi andmed. Võid kaaluda ka oma märgiste lisamist, et päritoluteave säiliks paremini või oleks kasulikum. Rakendamise üksikasjad leiad C2PA tehnilisest dokumentatsioonist.
Teksti puhul peitub vesimärk mudeli sõnavalikutes. Kui jätad sõnastuse samaks, peaks signaal teksti taaskasutamisel säilima ilma täiendava lõimimistööta. Ulatuslik ümberkirjutamine, ümbersõnastamine või tõlkimine võib vähendada tuvastamise usaldusväärsust. Ka muutmata sõnastus ei taga, et vesimärk on tuvastatav, eriti lühikestes lõikudes või tekstis, kus sõnavaliku võimalused on piiratud.
Kasutan OpenAI mudeleid pilveteenuse kaudu. Kas ka need väljundid sisaldavad päritolusignaale?
Teeme koostööd kõigi oma pilve- ja levituspartneritega, et päritolusignaalid, sealhulgas vesimärgid, lisataks kõigisse sobivatesse väljunditesse, sealhulgas piltidesse, helisse ja teksti. Saadavus võib väljunditi ja partneriti erineda.
Kas päritolutunnused asendavad nähtavaid tehisintellektimärgiseid või muid teavitusi?
Ei. Vesimärgid ja C2PA metaandmed pakuvad tarkvaraga loetavat teavet. Need ei asenda nähtavaid märgiseid, bännereid ega muid teateid, mis võivad olla nõutud.
Täiendava teavituse vajadus sõltub sellest, kuidas ja kus sa sisu kasutad. OpenAI ei saa sind nõustada sinu konkreetsete õiguslike kohustuste osas; sinu kasutusjuhule kehtivaid nõudeid peaksid hindama sinu õigusnõustajad.
Mul on EL-i tehisintellektimääruse kohta veel küsimusi
Saada päring EL-i tehisintellektimääruse kohta ja võtame sinuga ühendust.