
OpenAI در راستای تعهد خود به ایجاد زیستبومی ایمنتر و شفافتر برای هوش مصنوعی، از نشانگرهای منشأ استفاده میکند تا به افراد کمک کند تشخیص دهند آیا محتوا با یکی از مدلهای OpenAI تولید شده است یا خیر.
نشانگرهای منشأ میتوانند اطلاعات مفیدی دربارهٔ خاستگاه محتوا ارائه دهند، اما درستی محتوا، ویرایشنشدن آن، قانونیبودن مالکیت آن یا ارائهٔ آن در بافت و زمینهٔ درست را تضمین نمیکنند.
نشانگرهای منشأ OpenAI
OpenAI از چه نشانگرهای منشأیی استفاده میکند؟
OpenAI برای انواع مختلف محتوا از نشانگرهای منشأ متفاوتی استفاده میکند.
| نوع محتوا | نشانگرهای منشأ | توضیحات |
|---|---|---|
| تصاویر | گواهیهای اصالت محتوا و واترمارکهای SynthID | تصاویر تولیدشده با ChatGPT، Codex یا API شرکت OpenAI هر دو نشانگر را دارند. |
| صدا | واترمارکهای SynthID | صدای تولیدشده با ChatGPT یا API شرکت OpenAI دارای واترمارکی ناشنیدنی است که در خود صدا تعبیه میشود. |
| متن | واترمارکهای textGrain (فقط در اتحادیهٔ اروپا) | در اتحادیهٔ اروپا، برای رعایت قانون هوش مصنوعی این اتحادیه، متن تولیدشده با ChatGPT دارای تغییری نامرئی در تصادفیبودن فرایند انتخاب واژهها توسط مدل است. مشتریان API در سراسر جهان میتوانند از بخش تنظیمات پروژه یا سازمان خود، واترمارک متن را برای خروجیهای متنی فعال کنند. |
| ویدیو | گواهیهای اصالت محتوا | ارائهٔ Sora متوقف شده است. بیشتر بدانید. |
پوشش این قابلیت ممکن است بسته به محصول، مدل، روش خروجیگرفتن، نوع فایل و زمان ایجاد محتوا متفاوت باشد. خروجیهای API تحت پوشش هستند، بهجز مدلهایی که قرار است بهزودی از رده خارج شوند، از جمله gpt-image-1، gpt-image-1.5 و sora-2.
چرا برای بعضی انواع محتوا از چند نشانگر استفاده میشود؟
هرجا از نظر فنی امکانپذیر باشد، OpenAI فراداده و واترمارک را با هم به کار میبرد تا هرکدام محدودیتهای دیگری را جبران کند. فراداده میتواند اطلاعات مفصلی را در خود جای دهد، اما ممکن است پلتفرمها، ابزارهای ویرایش و فرایند تبدیل فایل آن را حذف کنند. واترمارکها اطلاعات زمینهای کمتری دارند، اما چون در خودِ محتوای تولیدشده تعبیه میشوند، ممکن است پس از برخی تغییراتی که فراداده را حذف میکنند، باقی بمانند.
نشانگرهای منشأ در برابر تغییرات محتوا چقدر مقاوماند؟
واترمارکهای SynthID برای تصویر و صدا، و واترمارکهای textGrain برای متن، طوری طراحی شدهاند که در برابر تغییرات رایج دوام بیاورند. بسته به نوع محتوا، این تغییرات میتوانند شامل ویرایش جزئی، کپی و جایگذاری، برشدادن یا گرفتن نماگرفت باشند. تغییرات گستردهتر — مانند برش شدید تصویر، فشردهسازی فایل، بازنویسی عمده یا ترجمه — میتوانند واترمارک را غیرقابلتشخیص کنند. پس از تغییرات گسترده، توصیف نتیجه بهعنوان «تولیدشده با OpenAI» نیز ممکن است معنای کمتری داشته باشد.
گواهیهای محتوا، که ائتلاف منشأ و اصالت محتوا آنها را توسعه داده است، ممکن است بر اثر کارهای روزمرهای مثل گرفتن نماگرفت یا تبدیل فایل از بین بروند. اگر این گواهیها باقی بمانند، میتوانند در مقایسه با واترمارک بهتنهایی، جزئیات بیشتری دربارهٔ منشأ و سابقهٔ فایل ارائه دهند.
هرجا از نظر فنی ممکن باشد، از هر دو روش استفاده میکنیم تا احتمال باقیماندن اطلاعات منشأ پس از تغییر محتوا بیشتر شود.
گواهیهای محتوا چیستند و چه قابلیتی فراهم میکنند؟
گواهیهای محتوا اطلاعاتی دربارهٔ منشأ و سابقهٔ یک فایل به آن پیوست میکنند؛ مثلاً اینکه با چه ابزاری و در چه زمانی ایجاد شده است. این گواهیها از استاندارد بازی استفاده میکنند که ائتلاف منشأ و اصالت محتوا (C2PA) توسعه داده است؛ به همین دلیل، گاهی «فرادادهٔ C2PA» نامیده میشوند.
گواهیهای محتوا به افراد کمک میکنند منشأ محتوا را راستیآزمایی کنند. کاربرد آنها به محتوای تولیدشده با هوش مصنوعی محدود نیست: تولیدکنندگان دوربین، سازمانهای خبری و دیگران نیز از این استاندارد برای تأیید منشأ و سابقهٔ محتوای رسانهای خود استفاده میکنند. دربارهٔ C2PA بیشتر بدانید.
SynthID چیست و چه قابلیتی فراهم میکند؟
SynthID فناوری واترمارکگذاری نامرئیِ توسعهیافته توسط گوگل دیپمایند است که نشانگری را مستقیماً در محتوای رسانهای تولیدشده تعبیه میکند. برخلاف فراداده، این نشانگر بخشی از خودِ محتواست و ممکن است پس از برخی ویرایشها یا تغییرات باقی بماند. SynthID در کنار فرادادهٔ C2PA، نشانگر منشأ دیگری فراهم میکند. مثلاً اگر فراداده از یک فایل حذف شود، واترمارک تعبیهشده ممکن است همچنان نشان دهد که محتوا با ابزارهای پشتیبانیشدهٔ OpenAI تولید شده است. دربارهٔ SynthID بیشتر بدانید.
چرا خروجیهای متنی را واترمارکگذاری میکنید؟
ما واترمارکگذاری متن را برای کاربران ChatGPT در اتحادیهٔ اروپا پیادهسازی میکنیم تا قانون هوش مصنوعی اتحادیهٔ اروپا را رعایت کنیم و به تعهداتمان ذیل آییننامهٔ اجرایی اتحادیهٔ اروپا دربارهٔ شفافیت محتوای تولیدشده با هوش مصنوعی عمل کنیم؛ آییننامهای که OpenAI به همراه چند ارائهدهندهٔ بزرگ دیگر هوش مصنوعی امضا کرده است.
textGrain چیست و چه قابلیتی فراهم میکند؟
textGrain فناوری واترمارکگذاری متنِ OpenAI است. این فناوری هنگام نوشتن، نحوهٔ انتخاب تصادفی مدل از میان کلمهها یا بخشهای کلمهٔ ممکن را بهطور نامحسوس تنظیم میکند. این انتخابها در سراسر متن الگویی ایجاد میکنند که ابزار تشخیص میتواند حتی پس از برخی ویرایشها آن را جستوجو کند.
واترمارک بخشی از خودِ جملهبندی است و برای خوانندگان قابلمشاهده نیست. این فناوری نویسهٔ پنهان، فاصلهٔ نامرئی یا نشانهگذاری غیرمعمول اضافه نمیکند. واترمارکگذاری متن به رعایت الزام قانون هوش مصنوعی اتحادیهٔ اروپا برای علامتگذاری متن تولیدشده کمک میکند.
ابزارهای راستیآزمایی OpenAI
چطور میتوانم بررسی کنم که آیا محتوایی با ابزارهای OpenAI تولید شده است؟
میتوانید به openai.com/verify مراجعه کنید تا بررسی کنید آیا یک فایل تصویری یا صوتی پشتیبانیشده، نشانگرهای منشأ مربوط به محتوای تولیدشده یا خروجیگرفتهشده با ابزارهای OpenAI را دارد یا خیر. پس از بارگذاری یک فایل پشتیبانیشده، ابزار به دنبال نشانگرهای منشأ پشتیبانیشدهٔ OpenAI میگردد؛ مانند واترمارک SynthID یا اساس نامهٔ معتبر C2PA مرتبط با OpenAI. اگر ابزار یک نشانگر منشأ پشتیبانیشدهٔ OpenAI پیدا کند، این نشان میدهد که محتوا احتمالاً با یکی از مدلهای OpenAI تولید شده است.
توسعهدهندگان و سازمانها همچنین میتوانند از API منشأ محتوای OpenAI برای بررسی نشانگرهای منشأ OpenAI در تصاویر و فایلهای صوتی استفاده کنند و قابلیت بررسی منشأ را در برنامهها یا گردشکارهای خود ادغام کنند. سازمانهایی که مورد استفادهٔ آنها واجد شرایط است، میتوانند برای افزایش سقف استفاده درخواست دهند.
در مورد متن، مطابق با تعهدات ما در چارچوب قانون هوش مصنوعی اتحادیهٔ اروپا، سازمانهایی با مورد استفادهٔ واجد شرایط میتوانند برای دسترسی به ابزار تشخیص متن درخواست دهند؛ برای مثال، سازمانهای دانشگاهی و پژوهشی که منشأ متن، قابلیت اعتماد تشخیص، یا نحوهٔ برداشت افراد از نتایج بررسی منشأ را مطالعه میکنند. درخواستهای سازمانهای واجد شرایط را بهصورت موردی بررسی میکنیم و در صورت لزوم، برای اطلاعرسانی دربارهٔ وضعیت درخواست یا دریافت اطلاعات بیشتر با آنها تماس میگیریم. با افزایش شناخت ما و بهبود این فناوری، ممکن است رویکردمان به ارائهٔ دسترسی تغییر کند.
در حال حاضر با گروه محدودی از پژوهشگران همکاری میکنیم؛ از جمله جان تیکستون، استادیار علوم رایانه در دانشگاه کرنل، مارتین وچف، استاد علوم رایانه در دانشگاه ETH زوریخ و مدیر علمی INSAIT، و پژوهشگران مؤسسهٔ فناوریهای هوشمند کمپلن (KInIT). هدف این همکاری، شناخت بهتر قابلیتها و محدودیتهای این فناوری و استفاده از یافتهها برای بهبود واترمارکگذاری متن است.
چه کسانی واجد شرایط سقف بالاتر راستیآزمایی هستند و آیا بررسیها هزینه دارند؟
بررسی با API منشأ محتوا در حال حاضر رایگان است و مشمول محدودیتهای استفاده میشود. برنامهٔ افزایش سقف استفاده بر پروژههای واجد شرایطِ منشأ محتوا در راستای منافع عمومی و گردشکارهای حفظ سلامت اطلاعات تمرکز دارد؛ مانند راستیآزمایی در تحریریهها، بررسی صحت ادعاها، پژوهش دربارهٔ منشأ محتوا و نظارت نهادهای تنظیمگر.
کاربردهای عمومی کسبوکار در حال حاضر خارج از دامنهٔ این برنامه هستند؛ مانند پیشگیری از تقلب، احراز اصالت و راستیآزمایی برای مقاصد تجاری، یا فروش مجدد در قالب بستههای خدمات منشأ محتوا و تحلیل داده.
سازمانهایی که مورد استفادهٔ واجد شرایطی دارند، میتوانند برای افزایش سقف استفاده درخواست دهند، اما ارسال درخواست تضمینی برای تأیید آن نیست. API عمومی همچنان با سقفهای پیشفرض خود، از جمله برای ارزیابیهای کوچکتر، در دسترس است. برای اطلاع از سقفهای فعلی استفاده، به مستندات API منشأ محتوا مراجعه کنید.
چه کسانی واجد شرایط دسترسی به ابزار تشخیص متن هستند و آیا بررسیها هزینه دارند؟
بررسی با ابزار تشخیص متن در حال حاضر رایگان است. موارد استفادهٔ واجد شرایط شامل فعالیت سازمانهای دانشگاهی و پژوهشی است که منشأ متن، قابلیت اعتماد تشخیص یا نحوهٔ درک افراد از نتایج بررسی منشأ را مطالعه میکنند.
کاربردهای عمومی کسبوکار در حال حاضر خارج از دامنهٔ این برنامه هستند؛ مانند پیشگیری از تقلب، احراز اصالت و راستیآزمایی برای مقاصد تجاری، یا فروش مجدد در قالب بستههای خدمات منشأ محتوا و تحلیل داده.
کاربردهای مربوط به درستکاری علمی، مانند بررسی آثار دانشجویان از نظر استفاده از هوش مصنوعی (مثلاً در نگارش مقاله یا پایاننامه)، نیز در حال حاضر خارج از دامنهٔ این برنامه هستند.
نتایج بررسی منشأ چه معنایی دارند؟
اگر نشانگری از طریق openai.com/verify یا API منشأ محتوای OpenAI تشخیص داده شود، به این معناست که محتوای بارگذاریشده دارای یک نشانگر منشأ پشتیبانیشدهٔ مرتبط با OpenAI است. این ابزار درستی محتوا، ویرایشنشدن آن، قانونیبودن مالکیت آن یا ارائهٔ آن در بافت و زمینهٔ درست را تأیید نمیکند. همچنین مشخص نمیکند چه کسی محتوا را ایجاد کرده یا چرا آن را ایجاد کرده است.
اگر هیچ نشانگری تشخیص داده نشود، به این معناست که ابزار در فایل بارگذاریشده نشانگر منشأیی از سوی OpenAI پیدا نکرده است. در موارد زیر، همچنان ممکن است محتوا با ابزارهای OpenAI تولید یا از آنها خروجی گرفته شده باشد:
محتوا پیش از در دسترس قرار گرفتن نشانگرهای منشأ ایجاد شده باشد.
محتوا از محصول، مدل، روش خروجیگرفتن یا نوع فایلی باشد که پشتیبانی نمیشود.
فرادادهها هنگام بارگذاری، دانلود، ویرایش، تبدیل یا اشتراکگذاری حذف شده باشند.
واترمارک بر اثر فشردهسازی، برش، نویز، ویرایش، تبدیل قالب یا تغییرات دیگر آسیب دیده باشد.
قطعهٔ صوتی بیش از حد کوتاه باشد یا تغییرات قابلتوجهی در آن ایجاد شده باشد.
چطور قابلاعتمادترین نتیجهٔ راستیآزمایی را بگیرم؟
هر بار یک فایل پشتیبانیشده بارگذاری کنید و در صورت امکان، از فایل خروجی اصلی استفاده کنید. در مورد تصاویر، پیش از بررسی فایل از برشدادن یا تبدیل آن خودداری کنید. در مورد صدا، کلیپهای ۱۰ تا ۶۰ ثانیهای معمولاً بهترین نتایج را به دست میدهند. حتی اگر هیچ نشانگری تشخیص داده نشد، پیش از نتیجهگیری، منبع فایل و زمینهٔ آن را در نظر بگیرید.
آیا نتایج، اعلان یا اطلاعات شخصی من را نشان میدهند؟
نشانگرهای منشأ شامل جزئیاتی دربارهٔ کاربر، سازمان یا اعلان نیستند.
چه اتفاقی برای محتوایی میافتد که منشأ آن را با openai.com/verify یا API منشأ محتوا بررسی میکنم؟
محتوایی که در openai.com/verify بارگذاری یا برای بررسی منشأ به API منشأ محتوای ما ارسال میشود، فقط برای جستوجوی نشانگرهای منشأ پشتیبانیشده پردازش میشود. محتوا ذخیره نمیشود، مگر آنکه قانون الزام کند، و برای آموزش مدلهای OpenAI استفاده نمیشود.
آیا OpenAI میتواند محتوای تولیدشده با ابزارهای دیگر هوش مصنوعی را تشخیص دهد؟
ابزارهای منشأ محتوای ما برای تشخیص نشانگرهای منشأ پشتیبانیشدهای طراحی شدهاند که به محتوای تولیدشده با مدلهای OpenAI یا خروجیگرفتهشده با ابزارهای OpenAI مربوط میشوند. این ابزارها برای تشخیص محتوای تولیدشده با مدلهای دیگر هوش مصنوعی طراحی نشدهاند. همچنین اگر نشانگر مربوطه وجود نداشته باشد، پشتیبانی نشود یا آسیب دیده باشد، ممکن است محتوای تولیدشده با OpenAI را هم تشخیص ندهند.
واترمارکگذاری چگونه کار میکند
آیا واترمارکها پدیدآورندگی، مالکیت یا مسئولیت قانونی را مشخص میکنند؟
خیر. وجود واترمارک شاهدی است بر اینکه محتوا احتمالاً با یک مدل OpenAI تولید یا پردازش شده است. واترمارک بهتنهایی مشخص نمیکند چه کسی پدیدآورنده یا مالک محتواست، آیا اطلاعرسانی الزامی بوده است یا چه کسی مسئولیت قانونی دارد. همچنین مشخص نمیکند که آیا مدل در حال ویرایش محتوایی بوده که کاربر بارگذاری کرده است یا نه.
آیا واترمارکها میزان نقش یک مدل OpenAI را مشخص میکنند؟
خیر. ابزار تشخیص گزارش میدهد که واترمارکی پیدا کرده است یا نه. پیداشدن واترمارک شاهدی است بر اینکه محتوا احتمالاً با یک مدل OpenAI تولید یا پردازش شده است، اما نشان نمیدهد مدل بخشی از آن را تولید کرده یا همهٔ آن را، یا سهم انسان در تولید آن چقدر بوده است.
واترمارکگذاری متن چگونه کار میکند؟
واترمارکگذاری متن هنگام نوشتن، الگویی محرمانه در انتخاب کلمهها و بخشهای کلمه توسط مدل ایجاد میکند؛ این واحدها «توکن» نام دارند.
در هر مرحله، مدل به هر توکنِ ممکن برای ادامه، احتمالی اختصاص میدهد. سامانهٔ واترمارکگذاری چند مجموعهٔ تعدیلشده از این احتمالها ایجاد میکند که هرکدام، بر اساس یک کلید محرمانه، انتخابهای متفاوتی را ترجیح میدهند. این مجموعهها طوری متعادل شدهاند که میانگین آنها با احتمالهای اولیهٔ مدل برابر باشد. کلید مشخص میکند از کدام مجموعه استفاده شود و سپس مدل انتخاب تصادفی تازهای از آن مجموعه انجام میدهد.
ابزار تشخیصی با همان کلید و تنظیمات متناظر، بعداً میتواند بررسی کند که آیا میزان پیروی متن از الگوی محرمانه، بیش از چیزی است که بهطور تصادفی انتظار میرود یا نه.
آیا واترمارکهای متنی در متنهای مبتنی بر واقعیت و متنهای ارائهشده توسط کاربر هم به کار میروند؟
واترمارکگذاری متن به این بستگی دارد که مدل راههای متفاوتی برای بیان یک مطلب داشته باشد. وقتی پاسخ باید کاملاً مبتنی بر واقعیت یا دقیق باشد، مثل پاسخ یک مسئلهٔ ریاضی، یا وقتی از مدل خواسته میشود متن ارائهشده را بدون تغییر بازتولید کند، انعطاف کمتری وجود دارد. در این موارد، مدل آزادی کمتری برای تغییر جملهبندی بدون ایجاد تفاوتی محسوس دارد؛ بنابراین ممکن است واترمارک تشخیص داده نشود.
آیا واترمارکهای متنی در پاسخهای کوتاه و کد هم به کار میروند؟
متنهای کوتاه معمولاً برای تشخیص قابلاعتماد واترمارک، طول کافی ندارند. واترمارکگذاری کد هم دشوارتر است، چون در مقایسه با متن عادی، گزینههای معقول کمتری برای ادامهٔ آن وجود دارد.
با توجه به این محدودیتها، آییننامهٔ اجرایی شفافیت محتوای تولیدشده با هوش مصنوعی، ذیل قانون هوش مصنوعی اتحادیهٔ اروپا، واترمارکگذاری خروجیهای کوتاهتر از ۲۰۰ توکن — حدود ۱۵۰ کلمه به انگلیسی — یا قطعهکدها را الزامی نمیداند.
تشخیص واترمارک متنی در زبانهای مختلف چه تفاوتی دارد؟
نرخ تشخیص بسته به زبان متفاوت است و در حال حاضر، تشخیص در برخی زبانها آسانتر از دیگر زبانهاست. میتوانیم شدت واترمارک را تنظیم کنیم تا تشخیص در زبانهایی که نشانگر ضعیفتری دارند بهتر شود.
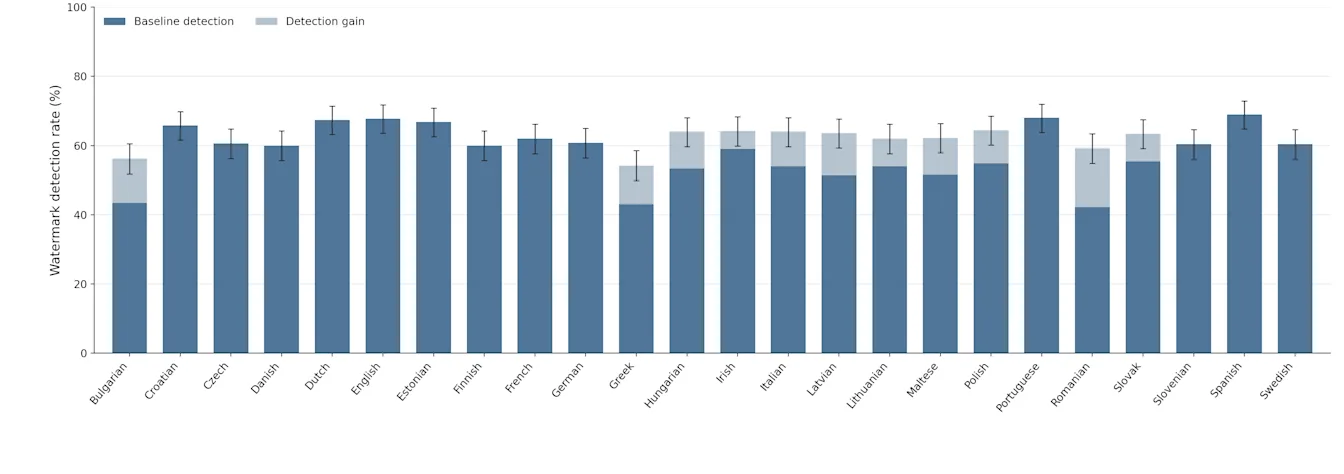
این نمودار نرخ تشخیص را در هر ۲۴ زبان رسمی اتحادیهٔ اروپا ارزیابی میکند. ابتدا ۵۰۰ اعلان مصنوعی به زبان انگلیسی با موضوعات متنوع تولید کردیم، سپس آنها را به ۲۳ زبان دیگر ترجمه کردیم. با نرخ مثبت کاذب ۱٪، اسپانیایی بالاترین نرخ تشخیص (۶۹٫۰٪) و رومانیایی پایینترین نرخ (۴۲٫۲٪) را دارد. واترمارک ما پارامتری برای تنظیم شدت دارد؛ نوعی «پیچ تنظیم» که نشانگر واترمارک را برای حوزههای مختلف تقویت یا تضعیف میکند. با استفاده از این تنظیم، توانستیم شدت را برای زبانهایی با نرخ تشخیص کمتر از ۶۰٪ افزایش دهیم؛ بخشهای آبی روشن ستونها میزان بهبود حاصل را نشان میدهند.
آیا واترمارکهای متنی کیفیت مدل را کاهش میدهند؟
بر اساس آزمایشهای ما، خیر. در همهٔ بنچمارکهایی که برای ارزیابی Astra، جدیدترین مدل پیشرو ما، به کار میبریم، تفاوت عملکرد با واترمارکگذاری و بدون آن، در محدودهٔ نوسانهای تصادفیای است که معمولاً بین دفعات اجرای ارزیابی مشاهده میکنیم. آزمایشهای قبلی در ChatGPT نیز نشان دادند که افزودن واترمارکگذاری تغییری در نرخ بازخورد منفی یا سایر شاخصهای محصول ایجاد نمیکند.
آیا واترمارکهای متنی سرعت مدل را کاهش میدهند؟
واترمارکگذاری متن تأثیر ناچیزی بر سرعت مدلهای ما دارد.
واترمارکهای متنی OpenAI چه تفاوتی با ابزارهای تشخیص هوش مصنوعیِ سایر شرکتها دارند؟
ابزارهای تشخیص سایر شرکتها، مانند Pangram، معمولاً از طبقهبندها استفاده میکنند تا متن تولیدشده با هوش مصنوعی را بر اساس الگوهایی مانند انتخاب واژهها شناسایی کنند. این رویکرد، بهجای تشخیص یک نشانگر تعبیهشده، متن را پس از تولید تحلیل میکند. قانون هوش مصنوعی اتحادیهٔ اروپا مشخصاً الزام میکند که نشانگری در متن تولیدشده تعبیه شود.
چرا بهجای TextSeal یا SynthID از واترمارکهای متنی خودتان استفاده میکنید؟
ما روش واترمارکگذاری متنِ خودمان را با نام textGrain توسعه دادیم تا در مقایسه با SynthID یا TextSeal، کنترل بیشتری بر تعادل میان قابلتشخیصبودن واترمارک و تنوع پاسخهای تولیدشده برای یک اعلان یکسان داشته باشیم. در آزمایشهای ما، این روش در مقایسه با نسخهٔ متنی SynthID، درصدی مشابه یا بیشتر از نمونههای متنی واترمارکدار را بهدرستی شناسایی کرد. قصد داریم textGrain را بهصورت فناوری متنباز منتشر کنیم تا دیگران بتوانند بر پایهٔ آن توسعه دهند و به بهبود واترمارکگذاری متن کمک کنند.
آیا واترمارکگذاری متن، نویسههای پنهان، توکنهای اضافی یا تغییرات قابلمشاهده اضافه میکند؟
خیر. واترمارکگذاری متن الگوی آماری انتخاب واژهها را تغییر میدهد؛ نویسهٔ پنهان درج نمیکند و توکنهایی صرفاً برای واترمارکگذاری اضافه نمیکند. واترمارک برای خوانندگان قابلمشاهده نیست و کپی و جایگذاری متن، محتوای پنهانی وارد آن نمیکند.
راهنمای مشتریان
من مشتری API هستم؛ چطور واترمارک متن را فعال کنم؟
مشتریان API شرکت OpenAI میتوانند واترمارکگذاری متن را برای یک پروژهٔ مشخص از طریق تنظیمات، یا برای کل سازمان خود از طریق تنظیمات سازمان فعال کنند. در هر دو حالت، مشتریان میتوانند انتخاب کنند که خروجی کدام مدل یا مدلها واترمارک متنی داشته باشد. پس از فعالسازی این قابلیت برای یک مدل پشتیبانیشده، OpenAI واترمارک را هنگام تولید متن اضافه میکند. مشتریان نیازی ندارند به هر پاسخ، نشان جداگانهای اضافه کنند.
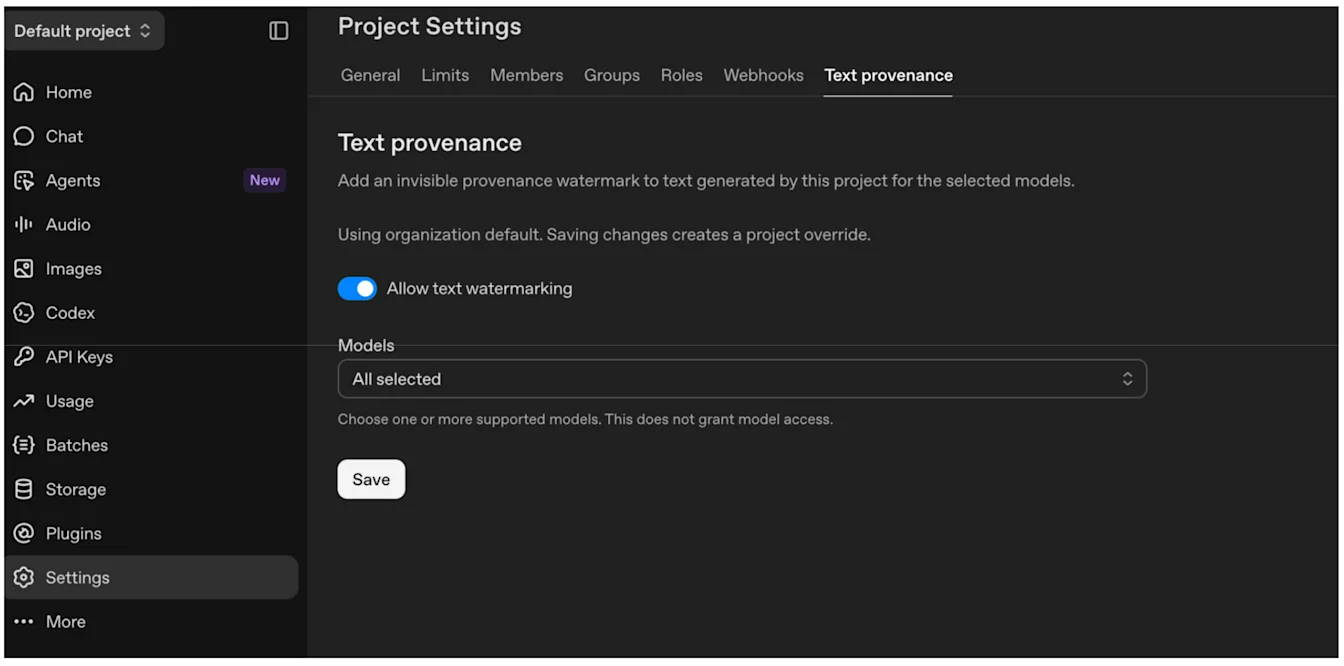
گزینهٔ اجازهٔ واترمارکگذاری متن را روشن کنید، مدلهایتان را انتخاب کنید و سپس ذخیره را بزنید.
پیشفرض سازمان: به تنظیمات سازمان > کنترلهای داده بروید.
منشأ متن را انتخاب کنید.
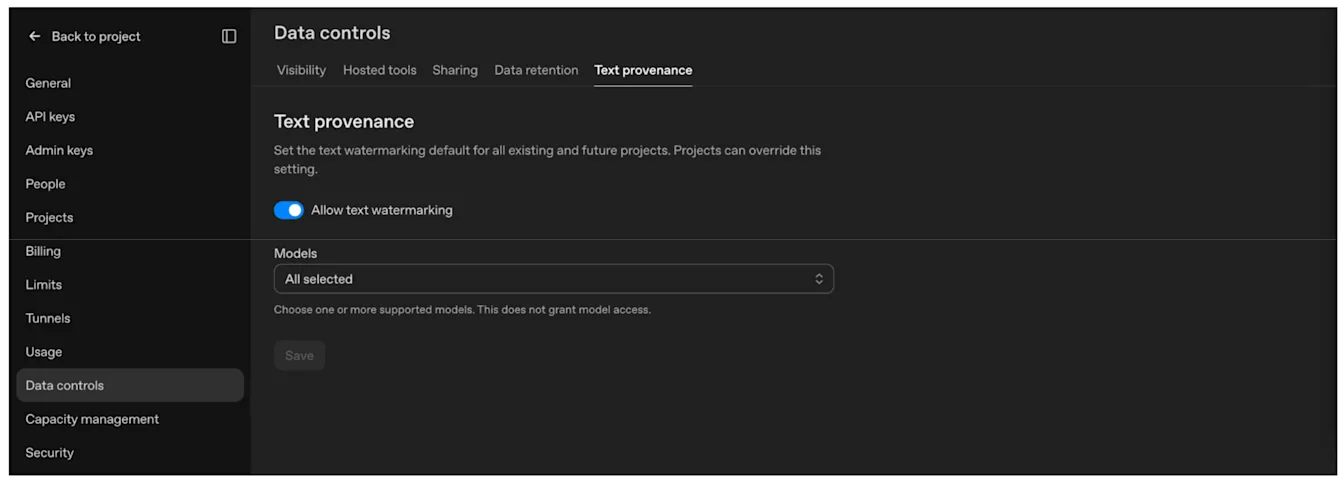
جایگزینی تنظیمات برای پروژه: به تنظیمات پروژه > منشأ متن بروید.
برای کدام مدلها میتوانم واترمارک را فعال کنم؟
مشتریان میتوانند در تنظیمات و تنظیمات سازمان، فهرست مدلهایی را ببینند که در حال حاضر قابلیت واترمارکگذاری برای آنها در دسترس است. در هفتههای آینده، پوشش این قابلیت را به همهٔ مدلهای قدیمی گسترش خواهیم داد.
آیا با فعالکردن واترمارکهای متنی، به ابزار تشخیص متن هم دسترسی پیدا میکنم؟
خیر. دسترسی به ابزار تشخیص متن در حال حاضر به سازمانهای پژوهشی و دانشگاهی تأییدشدهای محدود است که برای افزایش قابلیت اعتماد واترمارکگذاری متن، آسانترشدن استفاده از آن و روشنترشدن توضیح این فناوری و نتایجش فعالیت میکنند. این رویکرد با تعهدات ما ذیل آییننامهٔ اجرایی شفافیت محتوای تولیدشده با هوش مصنوعی، در چارچوب قانون هوش مصنوعی اتحادیهٔ اروپا، همسو است.
آیا پس از تغییر محتوا، نشانگرها در آن باقی میمانند؟
ممکن است باقی بمانند، اما این موضوع به نوع نشانگر و تغییراتی که اعمال میکنید بستگی دارد.
برای تصاویر و فایلهای صوتی پشتیبانیشده، یک نسخهٔ اصلی نگه دارید و پس از ویرایش، تبدیل و انتشار، نمونههایی از فایلها را که نمایندهٔ مجموعه هستند با API منشأ محتوا آزمایش کنید. در مورد تصاویر، برش دادن، افزودن نویز، تبدیل به JPEG و گرفتن اسکرینشات ممکن است تشخیص نشانگرها را دشوارتر کند. فقط در صورتی میتوانید متن را به این روش آزمایش کنید که دسترسی سازمان شما به ابزار تشخیص متن تأیید شده باشد.
اگر قالب فایل و گردشکار شما این امکان را فراهم میکند، فرادادههای موجود C2PA را حفظ کنید و گواهیهای اصالت محتوا را در فایلهایی که تولید میکنید بگنجانید. همچنین میتوانید نشانهای خودتان را اضافه کنید تا اطلاعات منشأ ماندگارتر یا کاربردیتر شود. برای جزئیات پیادهسازی، به مستندات فنی C2PA مراجعه کنید.
در مورد متن، واترمارک در نحوهٔ انتخاب واژهها توسط مدل جای میگیرد. اگر واژهها و عبارتهای متن را تغییر ندهید، انتظار میرود هنگام استفادهٔ مجدد از متن، نشانگر بدون نیاز به یکپارچهسازی فنی بیشتر باقی بماند. بازنویسی گسترده، بیان مطلب با کلمات دیگر یا ترجمه میتواند قابلیت اعتماد تشخیص را کاهش دهد. حتی دستنخورده ماندن واژهها و عبارتها هم تضمین نمیکند که واترمارک قابل تشخیص باشد؛ بهویژه در متنهای کوتاه یا متنهایی که امکان انتخاب واژههای متفاوت در آنها محدود است.
من از طریق یک سرویس ابری به مدلهای OpenAI دسترسی دارم. آیا آن خروجیها هم نشانگرهای منشأ دارند؟
ما با همهٔ ارائهدهندگان خدمات ابری و توزیعکنندگان خود همکاری میکنیم تا اطمینان یابیم نشانگرهای منشأ، از جمله واترمارکها، در تمام خروجیهای واجد شرایط، شامل تصویر، صدا و متن، تعبیه میشوند. در دسترس بودن این قابلیت ممکن است بسته به خروجی و شریک ارائهدهنده متفاوت باشد.
آیا نشانگرهای منشأ جایگزین برچسبهای قابلمشاهدهٔ هوش مصنوعی یا سایر اطلاعرسانیها میشوند؟
خیر. واترمارکها و فرادادهٔ C2PA اطلاعاتی ارائه میدهند که نرمافزار میتواند آنها را بخواند. این نشانگرها جایگزین برچسبهای قابلمشاهده، بنرها یا سایر اعلانهایی نمیشوند که ممکن است الزامی باشند.
نیاز به اطلاعرسانی بیشتر به این بستگی دارد که محتوا را چگونه و در کجا استفاده میکنید. OpenAI نمیتواند دربارهٔ تعهدات قانونی خاص شما مشاوره بدهد؛ تیم حقوقی شما باید الزامات مربوط به نوع استفادهتان را ارزیابی کند.
دربارهٔ قانون هوش مصنوعی اتحادیهٔ اروپا پرسشهای بیشتری دارم
لطفاً پرسش خود دربارهٔ قانون هوش مصنوعی اتحادیهٔ اروپا را ارسال کنید تا به شما پاسخ دهیم.