
Dans le cadre de son engagement envers un écosystème d’IA plus sûr et plus transparent, OpenAI utilise des signaux de provenance pour aider les gens à déterminer si un contenu a été généré avec un modèle d’OpenAI.
Les signaux de provenance peuvent fournir des renseignements utiles sur l’origine du contenu, mais ils ne garantissent pas que celui-ci est exact, non modifié, détenu légalement ou présenté dans le bon contexte.
Les signaux de provenance d’OpenAI
Quels signaux de provenance OpenAI utilise-t-elle?
OpenAI utilise différents signaux de provenance selon le type de contenu.
| Type de contenu | Signaux de provenance | Remarques |
|---|---|---|
| Images | Content Credentials et filigranes SynthID | Les images générées avec ChatGPT, Codex ou l’API d’OpenAI incluent les deux signaux. |
| Audio | Filigranes SynthID | L’audio généré par ChatGPT ou l’API d’OpenAI inclut un filigrane inaudible intégré à l’audio lui-même. |
| Texte | Filigranes textGrain (UE seulement) | Dans l’UE, le texte généré par ChatGPT inclut une modification invisible du caractère aléatoire des choix de mots du modèle afin de respecter le règlement de l’UE sur l’IA. Les clients de l’API du monde entier peuvent activer les filigranes pour les sorties textuelles dans les paramètres de leur projet ou de leur organisation. |
| Vidéo | Content Credentials | Sora n’est plus disponible. En savoir plus. |
La prise en charge peut varier selon le produit, le modèle, le mode d’exportation, le type de fichier et la date de création du contenu. Les sorties de l’API sont prises en charge, sauf pour les modèles dont l’abandon est imminent, notamment gpt-image-1, gpt-image-1.5 et sora-2.
Pourquoi certains types de contenu utilisent-ils plusieurs signaux?
Lorsque c’est techniquement possible, OpenAI combine les métadonnées et les filigranes afin que chaque méthode puisse compenser les limites de l’autre. Les métadonnées peuvent contenir des renseignements détaillés, mais les plateformes, les outils de modification et les conversions de fichiers peuvent les supprimer. Les filigranes fournissent moins de contexte, mais comme ils sont intégrés au contenu généré lui-même, ils peuvent subsister après certaines transformations qui suppriment les métadonnées.
Dans quelle mesure les signaux de provenance résistent-ils aux modifications du contenu?
Les filigranes SynthID pour les images et l’audio, ainsi que les filigranes textGrain pour le texte, sont conçus pour résister aux modifications courantes. Selon le type de contenu, il peut s’agir de modifications légères, de copier-coller, de recadrages ou de captures d’écran. Des modifications plus importantes — comme un recadrage marqué de l’image, la compression du fichier, une paraphrase substantielle ou une traduction — peuvent rendre un filigrane indétectable. Après des modifications importantes, il peut aussi être moins pertinent de qualifier le résultat de « généré par OpenAI ».
Les Content Credentials, développés par la Coalition for Content Provenance and Authenticity, peuvent être perdus lors d’actions courantes, comme une capture d’écran ou une conversion de fichier. Lorsqu’ils restent disponibles, ils peuvent fournir plus de détails sur l’origine et l’historique d’un fichier qu’un filigrane seul.
Lorsque c’est techniquement possible, nous utilisons les deux méthodes pour augmenter les chances que les renseignements de provenance subsistent après des modifications du contenu.
Que sont les Content Credentials et que permettent-ils?
Les Content Credentials joignent des renseignements sur l’origine et l’historique d’un fichier, comme l’outil qui l’a créé et la date de sa création. Ils utilisent une norme ouverte élaborée par la Coalition for Content Provenance and Authenticity (C2PA), ce qui explique pourquoi on les appelle parfois « métadonnées C2PA ».
Les Content Credentials aident les gens à vérifier l’origine du contenu. Leur utilisation ne se limite pas au contenu généré par l’IA : les fabricants d’appareils photo, les organes de presse et d’autres intervenants utilisent aussi la norme pour certifier la source et l’historique de leurs médias. En savoir plus sur la C2PA.
Qu’est-ce que SynthID et que permet cette technologie?
SynthID est une technologie de filigranage invisible développée par Google DeepMind qui intègre un signal directement dans les médias générés. Contrairement aux métadonnées, le signal fait partie du contenu lui-même et peut subsister après certaines modifications ou transformations. SynthID fournit un signal de provenance supplémentaire en complément des métadonnées C2PA. Par exemple, si les métadonnées d’un fichier sont supprimées, un filigrane intégré peut encore indiquer que le contenu a été généré avec des outils d’OpenAI pris en charge. En savoir plus sur SynthID.
Pourquoi appliquez-vous des filigranes aux sorties textuelles?
Nous mettons en place le filigranage textuel pour les utilisateurs de ChatGPT dans l’UE afin de respecter le règlement de l’UE sur l’IA et nos engagements au titre du code de bonnes pratiques de l’UE sur la transparence du contenu généré par l’IA, qu’OpenAI a signé avec plusieurs autres grands fournisseurs d’IA.
Qu’est-ce que textGrain et que permet cette technologie?
textGrain est la technologie de filigranage textuel d’OpenAI. Elle ajuste subtilement la façon dont le modèle choisit aléatoirement parmi les mots ou fragments de mots possibles pendant la rédaction. À l’échelle d’un passage, ces choix créent un motif qu’un détecteur peut rechercher, même après certaines modifications.
Le filigrane fait partie de la formulation elle-même et n’est pas visible pour les lecteurs. Il n’ajoute pas de caractères cachés, d’espaces invisibles ni de ponctuation inhabituelle. Le filigranage textuel contribue au respect de l’exigence du règlement de l’UE sur l’IA concernant le marquage du texte généré.
Les outils de vérification d’OpenAI
Comment puis-je vérifier si un contenu a été généré avec les outils d’OpenAI?
Vous pouvez consulter openai.com/verify pour vérifier si une image ou un fichier audio pris en charge contient des signaux de provenance associés à du contenu généré ou exporté par les outils d’OpenAI. Après le téléversement d’un fichier pris en charge, l’outil recherche les signaux de provenance d’OpenAI pris en charge, comme un filigrane SynthID ou un manifeste C2PA de confiance associé à OpenAI. Si l’outil trouve un signal de provenance d’OpenAI pris en charge, cela indique que le contenu a probablement été généré par un modèle d’OpenAI.
Les développeurs et les organisations peuvent aussi utiliser l’API de provenance du contenu d’OpenAI pour rechercher des signaux de provenance d’OpenAI dans les images et les fichiers audio et intégrer la vérification à leurs propres applications ou flux de travail. Les organisations ayant un cas d’utilisation admissible peuvent présenter une demande pour obtenir des limites plus élevées.
Pour le texte, conformément à nos obligations en vertu du règlement de l’UE sur l’IA, les organisations ayant un cas d’utilisation admissible, comme les établissements universitaires et les organismes de recherche qui étudient la provenance des textes, la fiabilité de la détection ou la façon dont les gens comprennent les résultats de provenance, peuvent présenter une demande d’accès au détecteur de texte. Nous examinerons les demandes des organisations admissibles au cas par cas et effectuerons un suivi au besoin pour fournir des mises à jour ou demander des renseignements supplémentaires. Notre approche en matière d’accès pourrait évoluer à mesure que nous en apprenons davantage et améliorons la technologie.
Nous collaborons actuellement avec un groupe restreint de chercheurs, dont John Thickstun, professeur adjoint d’informatique à l’Université Cornell, Martin Vechev, professeur d’informatique à l’ETH Zurich et directeur scientifique d’INSAIT, ainsi que des chercheurs de l’Institut Kempelen des technologies intelligentes (KInIT), afin de mieux comprendre les capacités et les limites de la technologie et d’orienter les améliorations du filigranage du texte.
Qui est admissible à des limites de vérification plus élevées, et les vérifications sont-elles facturées?
Les vérifications de l’API de provenance du contenu sont actuellement gratuites et soumises à des limites d’utilisation. Le programme de limites plus élevées vise les projets admissibles de provenance d’intérêt public et les flux de travail liés à l’intégrité de l’information, comme la vérification en salle de rédaction, la vérification des faits, la recherche sur la provenance du contenu et la surveillance réglementaire.
Les applications commerciales générales sont actuellement exclues du programme, notamment la prévention de la fraude, l’authentification et la vérification à des fins commerciales, ou la revente dans le cadre d’offres groupées de services de provenance et d’analyse de données.
Les organisations dont le cas d’utilisation est admissible peuvent demander des limites plus élevées, mais le dépôt d’une demande ne garantit pas son approbation. L’API publique reste disponible avec ses limites par défaut, y compris pour les évaluations à plus petite échelle. Consultez la documentation de l’API de provenance du contenu pour connaître les limites d’utilisation actuelles.
Qui est admissible à l’accès au détecteur de texte, et les vérifications sont-elles facturées?
Les vérifications effectuées avec le détecteur de texte sont actuellement gratuites. Les cas d’utilisation admissibles comprennent ceux des établissements universitaires et des organismes de recherche qui étudient la provenance du texte, la fiabilité de la détection ou la façon dont les gens comprennent les résultats de provenance.
Les applications commerciales générales sont actuellement exclues du programme, notamment la prévention de la fraude, l’authentification et la vérification à des fins commerciales, ou la revente dans le cadre d’offres groupées de services de provenance et d’analyse de données.
Les applications liées à l’intégrité universitaire, comme la vérification des travaux étudiants pour détecter l’utilisation de l’IA (p. ex. dans la rédaction de dissertations ou de thèses), sont aussi actuellement exclues du programme.
Que signifient les résultats de la vérification?
Si un signal est détecté au moyen d’openai.com/verify ou de l’API de provenance du contenu d’OpenAI, cela signifie que le contenu téléversé contient un signal de provenance pris en charge associé à OpenAI. L’outil ne confirme pas que le contenu est exact, non modifié, détenu légalement ou présenté dans le bon contexte. Il n’identifie pas non plus la personne qui a créé le contenu ni la raison de sa création.
Si aucun signal n’est détecté, cela signifie que l’outil n’a pas trouvé de signaux de provenance émis par OpenAI dans le fichier téléversé. Le contenu pourrait tout de même avoir été généré ou exporté par OpenAI si :
Le contenu a été créé avant que les signaux de provenance soient disponibles.
Le contenu provient d’un produit, d’un modèle, d’un mode d’exportation ou d’un type de fichier non pris en charge.
Les métadonnées ont été supprimées lors du téléversement, du téléchargement, de la modification, de la conversion ou du partage.
Un filigrane a été dégradé par la compression, le recadrage, le bruit, des modifications, une conversion de format ou d’autres transformations.
Un extrait audio est trop court ou a été considérablement modifié.
Comment puis-je obtenir le résultat de vérification le plus fiable possible?
Téléversez un seul fichier pris en charge à la fois et, si possible, utilisez le fichier exporté d’origine. Pour les images, évitez de recadrer ou de convertir le fichier avant de le vérifier. Pour l’audio, les extraits de 10 à 60 secondes donnent généralement les meilleurs résultats. Même si aucun signal n’est détecté, tenez compte de la source et du contexte du fichier avant de tirer une conclusion.
Les résultats affichent-ils mon invite ou mes renseignements personnels?
Les signaux de provenance ne comprennent aucun détail sur l’utilisateur, l’organisation ou l’invite.
Qu’arrive-t-il au contenu que je vérifie à l’aide d’openai.com/verify ou de l’API de provenance du contenu?
Le contenu téléversé sur openai.com/verify ou soumis à notre API de provenance du contenu pour vérification est traité uniquement pour rechercher les signaux de provenance pris en charge. Le contenu n’est pas conservé, sauf si la loi l’exige, et n’est pas utilisé pour entraîner les modèles d’OpenAI.
OpenAI peut-elle détecter du contenu généré avec d’autres outils d’IA?
Nos outils de provenance du contenu sont conçus pour détecter les signaux de provenance pris en charge associés au contenu généré par les modèles d’OpenAI ou exporté par les outils d’OpenAI. Ils ne sont pas conçus pour détecter le contenu généré par d’autres modèles d’IA et peuvent aussi ne pas détecter le contenu généré par OpenAI si le signal pertinent est absent, non pris en charge ou dégradé.
Fonctionnement du filigranage
Les filigranes déterminent-ils la paternité, la propriété ou la responsabilité juridique du contenu?
Non. Un filigrane constitue un indice qu’un modèle d’OpenAI a probablement généré ou traité le contenu. À lui seul, il ne permet pas d’établir qui a créé le contenu ou qui en est propriétaire, si une divulgation était requise ou qui en est juridiquement responsable. Il n’indique pas non plus si le modèle modifiait du contenu téléversé par un utilisateur.
Les filigranes indiquent-ils dans quelle mesure un modèle d’OpenAI est intervenu?
Non. Le détecteur indique s’il a trouvé un filigrane. La présence d’un filigrane constitue un indice qu’un modèle d’OpenAI a probablement généré ou traité le contenu, mais ne révèle pas si le modèle en a généré une partie ou la totalité, ni l’ampleur de la contribution humaine.
Comment fonctionne le filigranage textuel?
Le filigranage textuel crée un motif secret dans les choix de mots et de fragments de mots du modèle, appelés « tokens », pendant la rédaction.
À chaque étape, le modèle attribue une probabilité à chaque token suivant possible. Le système de filigranage crée plusieurs ensembles ajustés de ces probabilités, chacun favorisant des choix différents selon une clé secrète. Les ensembles sont équilibrés de sorte que leur moyenne corresponde aux probabilités initiales du modèle. La clé sélectionne l’ensemble à utiliser, puis le modèle effectue un nouveau choix aléatoire à partir de cet ensemble.
Un détecteur disposant de la même clé et des paramètres correspondants peut ensuite vérifier si le texte suit le motif secret plus souvent que ce à quoi on s’attendrait par hasard.
Les filigranes textuels s’appliquent-ils aux textes factuels et aux textes fournis par l’utilisateur?
Le filigranage textuel repose sur la possibilité pour le modèle de dire la même chose de différentes façons. La souplesse est moindre lorsqu’une réponse doit être très factuelle ou précise, comme la réponse à un problème mathématique, ou lorsqu’on demande au modèle de reproduire un texte fourni sans le modifier. Dans ces cas, le modèle a moins de latitude pour modifier sa formulation sans différence perceptible; le filigrane peut donc ne pas être détecté.
Les filigranes textuels s’appliquent-ils aux réponses courtes et au code?
Les passages courts ne contiennent généralement pas assez de texte pour permettre une détection fiable des filigranes. Il est aussi plus difficile d’appliquer un filigrane au code, car les choix plausibles pour la suite sont moins nombreux que dans un texte ordinaire.
Pour tenir compte de ces limites, le code de bonnes pratiques sur la transparence du contenu généré par l’IA, associé au règlement de l’UE sur l’IA, n’exige pas de filigranes dans les sorties de moins de 200 tokens — environ 150 mots en anglais — ni dans les extraits de code.
Comment la détection des filigranes textuels varie-t-elle selon la langue?
Les taux de détection varient selon la langue, et la détection est actuellement plus facile dans certaines langues que dans d’autres. Nous pouvons ajuster l’intensité du filigrane pour améliorer la détection dans les langues où le signal est plus faible.
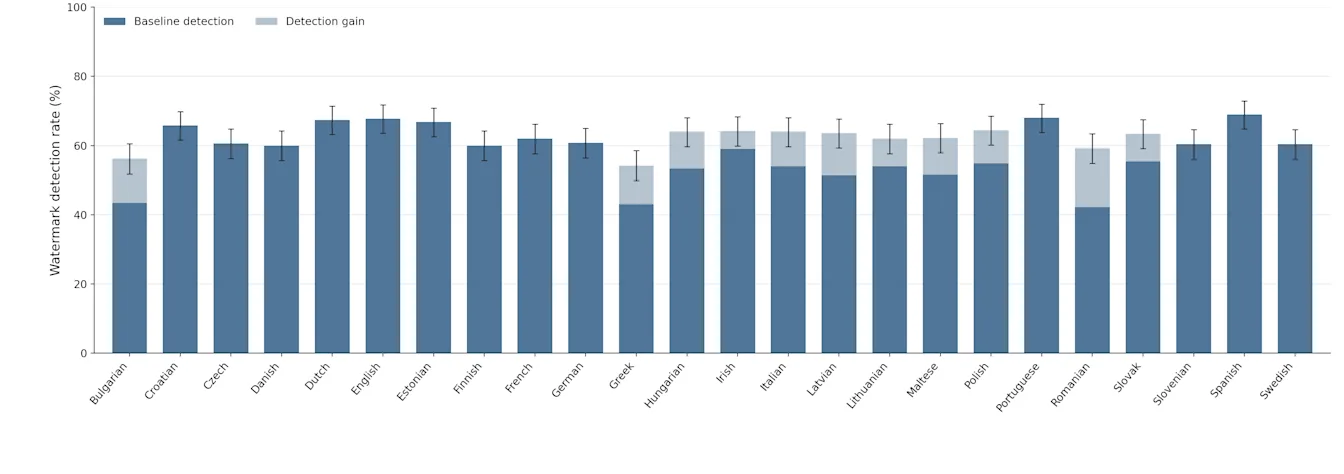
Ce graphique évalue le taux de détection dans les 24 langues officielles de l’UE. Nous avons d’abord généré 500 invites synthétiques en anglais couvrant divers sujets, puis nous les avons traduites dans les 23 autres langues. À un taux de faux positifs de 1 %, l’espagnol présente le taux de détection le plus élevé (69,0 %), tandis que le roumain présente le plus faible (42,2 %). Notre filigrane dispose d’un paramètre d’intensité réglable — un « bouton de réglage » qui renforce ou atténue le signal du filigrane selon le domaine. Grâce à ce réglage, nous avons pu augmenter l’intensité pour les langues dont le taux de détection était inférieur à 60 %; les portions bleu pâle des barres montrent les gains obtenus.
Les filigranes textuels réduisent-ils la qualité du modèle?
D’après nos tests, non. Dans les tests de référence que nous utilisons pour évaluer Astra, notre plus récent modèle de pointe, les différences de performance avec et sans filigranage se situent dans les fluctuations que nous observons habituellement d’une évaluation à l’autre. Des tests antérieurs dans ChatGPT n’ont pas non plus montré de changement dans les taux de pouces vers le bas ni dans les autres indicateurs du produit après l’introduction du filigranage.
Les filigranes textuels réduisent-ils la vitesse du modèle?
Le filigranage textuel a un effet négligeable sur la vitesse de nos modèles.
En quoi les filigranes de texte d’OpenAI diffèrent-ils des outils tiers de détection de l’IA?
Les outils de détection tiers comme Pangram utilisent généralement des classificateurs pour repérer le texte généré par l’IA à partir de tendances comme le choix des mots. Cette approche analyse le texte après sa génération plutôt que de détecter un signal intégré. Le règlement de l’UE sur l’IA exige expressément qu’un signal soit intégré au texte généré.
Pourquoi utilisez-vous vos propres filigranes textuels plutôt que TextSeal ou SynthID?
Nous avons développé notre propre méthode de filigranage textuel, appelée textGrain, pour mieux contrôler qu’avec SynthID ou TextSeal l’équilibre entre la détectabilité du filigrane et la variété des réponses générées à partir d’une même invite. Dans nos tests, notre approche a correctement identifié une proportion similaire ou supérieure d’échantillons de texte filigranés par rapport à SynthID pour le texte. Nous prévoyons de publier textGrain en tant que technologie à code source ouvert pour que d’autres puissent s’en inspirer et contribuer à améliorer le filigranage textuel.
Le filigranage textuel ajoute-t-il des caractères cachés, des tokens supplémentaires ou des modifications visibles?
Non. Le filigranage textuel modifie le motif statistique des choix de mots; il n’insère pas de caractères cachés et n’ajoute pas de tokens servant uniquement au filigrane. Le filigrane n’est pas visible pour les lecteurs, et copier-coller le texte n’introduit aucun élément caché.
Conseils aux clients
J’utilise l’API. Comment puis-je activer les filigranes de texte?
Les clients de l’API d’OpenAI peuvent activer le filigranage du texte pour un projet précis dans les Paramètres, ou pour l’ensemble de leur organisation dans les Paramètres de l’organisation. Dans chaque cas, les clients peuvent sélectionner les modèles auxquels appliquer un filigrane de texte. Une fois le filigranage activé pour un modèle pris en charge, OpenAI ajoute le filigrane pendant la génération du texte. Les clients n’ont pas besoin d’ajouter une marque distincte à chaque réponse.
Activez Autoriser le filigranage du texte, sélectionnez vos modèles, puis sélectionnez Enregistrer.
Paramètre par défaut de l’organisation : Accédez à Paramètres de l’organisation > Contrôles des données.
Sélectionnez Provenance du texte.
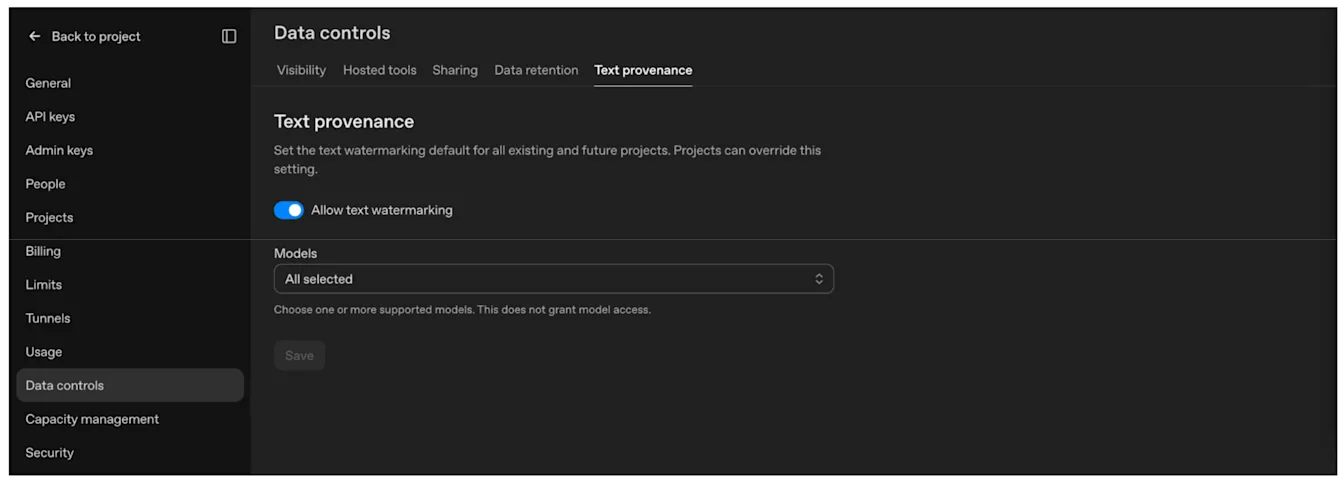
Paramètre propre au projet : Accédez à Paramètres du projet > Provenance du texte.
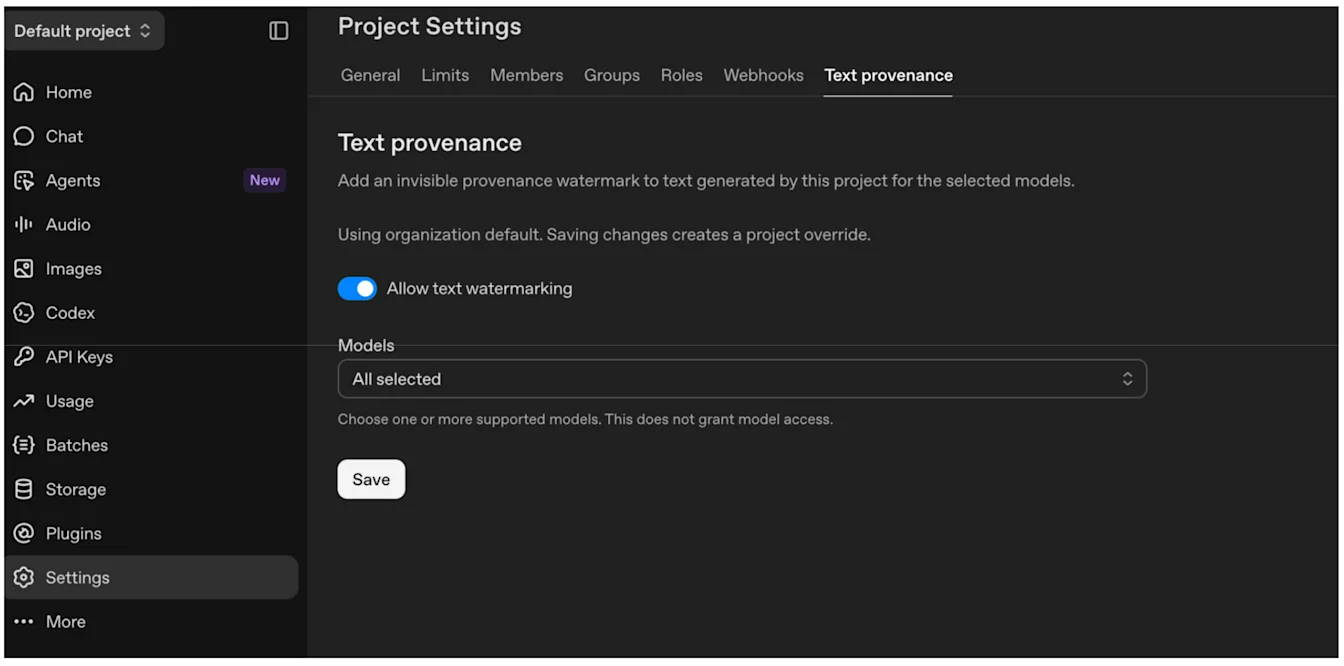
Pour quels modèles puis-je activer les filigranes?
Dans les Paramètres et les Paramètres de l’organisation, les clients peuvent consulter la liste des modèles pour lesquels le filigranage est actuellement disponible. Au cours des prochaines semaines, nous étendrons la prise en charge à tous les anciens modèles.
L’activation des filigranes textuels me donne-t-elle aussi accès au détecteur de texte?
Non. L’accès au détecteur de texte est actuellement limité aux organismes de recherche et aux établissements universitaires approuvés qui travaillent à améliorer la fiabilité et la facilité d’utilisation du filigranage textuel, ainsi que la clarté des explications sur la technologie et ses résultats. Cela est conforme à nos engagements au titre du code de bonnes pratiques sur la transparence du contenu généré par l’IA, associé au règlement de l’UE sur l’IA.
Les signaux resteront-ils associés au contenu après sa transformation?
C’est possible, mais cela dépend du signal et des modifications apportées.
Pour les images et les fichiers audio pris en charge, conservez une copie originale et utilisez l’API de provenance du contenu pour tester des fichiers représentatifs après leur modification, leur conversion et leur publication. Pour les images, le recadrage, l’ajout de bruit, la conversion au format JPEG et les captures d’écran peuvent rendre les signaux plus difficiles à détecter. Vous pouvez tester du texte de cette façon seulement si votre organisation dispose d’un accès approuvé au détecteur de texte.
Lorsque votre format de fichier et votre flux de travail le permettent, préservez les métadonnées C2PA existantes et incluez les Content Credentials dans les fichiers que vous produisez. Vous pouvez aussi envisager d’ajouter vos propres marques pour rendre les renseignements sur la provenance plus durables ou utiles. Consultez la documentation technique de C2PA pour en savoir plus sur la mise en œuvre.
Pour le texte, le filigrane fait partie des choix de mots du modèle. Si vous conservez la formulation, le signal devrait rester présent lorsque vous réutilisez le texte, sans travail d’intégration supplémentaire. Une réécriture importante, une reformulation ou une traduction peuvent rendre la détection moins fiable. Même une formulation inchangée ne garantit pas un filigrane détectable, surtout dans les passages courts ou les textes offrant peu de possibilités de varier le choix des mots.
J’accède aux modèles d’OpenAI par l’intermédiaire d’un service infonuagique. Ces sorties contiennent-elles aussi des signaux de provenance?
Nous travaillons avec tous nos fournisseurs de services infonuagiques et de distribution pour que des signaux de provenance, y compris des filigranes, soient intégrés à toutes les sorties admissibles, notamment les images, l’audio et le texte. La disponibilité peut varier selon la sortie et le partenaire.
Les signaux de provenance remplacent-ils les étiquettes visibles indiquant l’utilisation de l’IA ou d’autres divulgations?
Non. Les filigranes et les métadonnées C2PA fournissent des renseignements lisibles par les logiciels. Ils ne remplacent pas les étiquettes visibles, les bannières ou les autres avis qui pourraient être requis.
La nécessité d’une divulgation supplémentaire dépend de la façon dont vous utilisez le contenu et de l’endroit où vous l’utilisez. OpenAI ne peut pas vous conseiller sur vos obligations juridiques particulières; votre équipe juridique devrait évaluer les exigences liées à votre utilisation.
J’ai d’autres questions sur le règlement de l’UE sur l’IA
Veuillez soumettre une demande de renseignements sur le règlement de l’UE sur l’IA et nous vous répondrons.