Dans le cadre de son engagement pour un écosystème d’IA plus sûr et plus transparent, OpenAI utilise des signaux de provenance pour aider chacun à déterminer si un contenu a été généré avec un modèle OpenAI.
Les signaux de provenance peuvent fournir des informations utiles sur l’origine d’un contenu, mais ils ne garantissent pas son exactitude, l’absence de modifications, la légitimité de sa propriété ni sa présentation dans le bon contexte.
Les signaux de provenance d’OpenAI
Quels signaux de provenance OpenAI utilise-t-il ?
OpenAI utilise différents signaux de provenance selon les types de contenu.
| Type de contenu | Formats pris en charge | Signaux de provenance | Remarques |
|---|---|---|---|
| Images | PNG, JPEG/JPG, WebP, GIF | Content Credentials et filigranes SynthID | Les images générées avec ChatGPT ou l’API OpenAI incluent les deux signaux. |
| Audio | MP3, WAV, AAC, FLAC, OGG, Opus, PCM | Filigranes SynthID | L’audio généré par ChatGPT ou l’API OpenAI inclut un filigrane inaudible intégré à l’audio lui-même. |
| Texte | Texte libre ; sans lien avec un format de fichier | Filigranes textGrain (UE uniquement) | Dans l’UE, les textes générés par ChatGPT incluent une modification invisible de l’aléa utilisé dans les choix de mots du modèle, afin de respecter le règlement européen sur l’IA. Les clients de l’API du monde entier peuvent activer les filigranes sur les textes générés depuis les paramètres de leur projet ou de leur organisation. En savoir plus. |
| Vidéo | Sans objet | Sans objet | Sora n’est plus disponible.En savoir plus. |
| PDF (.pdf) | Content Credentials (métadonnées C2PA) | Les PDF exportés depuis les outils d’OpenAI pris en charge incluent des métadonnées C2PA intégrées au fichier. |
La couverture peut varier selon le produit, le modèle, le mode d’exportation, le type de fichier et la date de création du contenu. Les contenus générés par l’API sont couverts, sauf ceux des modèles dont l’abandon est imminent, notamment gpt-image-1, gpt-image-1.5 et sora-2.
Pourquoi certains types de contenus utilisent-ils plusieurs signaux ?
Lorsque cela est techniquement possible, OpenAI combine métadonnées et filigranes afin que chacun puisse compenser les limites de l’autre. Les métadonnées peuvent contenir des informations détaillées, mais les plateformes, les outils de modification et les conversions de fichiers peuvent les supprimer. Les filigranes fournissent moins de contexte, mais comme ils sont intégrés au contenu généré lui-même, ils peuvent résister à certaines transformations qui suppriment les métadonnées.
Dans quelle mesure les signaux de provenance résistent-ils aux modifications du contenu ?
Les filigranes SynthID pour les images et l’audio et les filigranes textGrain pour le texte sont conçus pour résister aux modifications courantes. Selon le type de contenu, il peut s’agir de retouches légères, de copier-coller, de recadrages ou de captures d’écran. Des modifications plus importantes, comme un recadrage marqué de l’image, la compression du fichier, une reformulation substantielle ou une traduction, peuvent rendre un filigrane indétectable. Après des modifications importantes, qualifier le résultat de « généré par OpenAI » peut également être moins pertinent.
Les Content Credentials, développés par la Coalition for Content Provenance and Authenticity, peuvent être perdus lors d’actions courantes, comme une capture d’écran ou la conversion d’un fichier. Lorsqu’ils restent disponibles, ils peuvent fournir plus de détails sur l’origine et l’historique d’un fichier qu’un filigrane seul.
Lorsque cela est techniquement possible, nous utilisons les deux méthodes pour augmenter les chances que les informations de provenance subsistent après des modifications du contenu.
Que sont les Content Credentials et à quoi servent-ils ?
Les Content Credentials joignent à un fichier des informations sur son origine et son historique, notamment l’outil qui l’a créé et la date de création. Ils utilisent une norme ouverte développée par la Coalition for Content Provenance and Authenticity (C2PA), ce qui explique pourquoi on les appelle parfois « métadonnées C2PA ».
Les Content Credentials aident les utilisateurs à vérifier l’origine d’un contenu. Leur utilisation ne se limite pas aux contenus générés par l’IA : les fabricants d’appareils photo, les organes de presse et d’autres acteurs utilisent également cette norme pour certifier la source et l’historique de leurs médias. En savoir plus sur la C2PA.
Qu’est-ce que SynthID et à quoi sert-il ?
SynthID est une technologie de filigranage invisible développée par Google DeepMind qui intègre un signal directement dans les médias générés. Contrairement aux métadonnées, le signal fait partie du contenu lui-même et peut subsister après certaines modifications ou transformations. SynthID fournit un signal de provenance supplémentaire en complément des métadonnées C2PA. Par exemple, si les métadonnées d’un fichier sont supprimées, un filigrane intégré peut encore signaler que le contenu a été généré avec des outils OpenAI pris en charge. En savoir plus sur SynthID.
Pourquoi ajoutez-vous des filigranes aux textes générés ?
Nous mettons en place le filigranage de texte pour les utilisateurs de ChatGPT dans l’UE afin de respecter le règlement européen sur l’IA, conformément à nos engagements au titre du code de bonnes pratiques de l’UE sur la transparence des contenus générés par l’IA, signé par OpenAI et plusieurs autres grands fournisseurs d’IA.
Qu’est-ce que textGrain et que permet cette technologie ?
textGrain est la technologie de filigranage de texte d’OpenAI. Elle ajuste subtilement la façon dont le modèle choisit aléatoirement parmi les mots ou fragments de mots possibles au fil de la rédaction. À l’échelle d’un passage, ces choix créent un motif qu’un détecteur peut repérer, même après certaines modifications.
Le filigrane fait partie de la formulation elle-même et n’est pas visible pour les lecteurs. Il n’ajoute ni caractères cachés, ni espaces invisibles, ni ponctuation inhabituelle. Le filigranage de texte contribue au respect de l’obligation de marquage des textes générés prévue par le règlement européen sur l’IA.
Vous trouverez plus de détails sur le fonctionnement de textGrain dans notre rapport technique.
Les outils de vérification d’OpenAI
Comment vérifier si un contenu a été traité par les outils d’OpenAI ?
Vous pouvez consulter openai.com/verify pour vérifier si une image, un fichier audio ou un PDF pris en charge contient des signaux de provenance associés à un contenu traité par les outils d’OpenAI. Après l’importation d’un fichier pris en charge, l’outil recherche les signaux de provenance OpenAI reconnus, tels qu’un filigrane SynthID ou un manifeste C2PA de confiance associé à OpenAI. Si l’outil trouve un signal de provenance OpenAI reconnu, cela indique que le contenu a probablement été traité par un outil d’OpenAI.
Les développeurs et les organisations peuvent également utiliser l’API de provenance du contenu d’OpenAI pour rechercher des signaux de provenance OpenAI dans des images, des fichiers audio et des PDF, et intégrer la vérification à leurs propres applications ou flux de travail. Les organisations ayant un cas d’usage admissible peuvent demander une augmentation des limites.
Pour le texte, conformément à nos obligations au titre du règlement européen sur l’IA, les organisations ayant un cas d’usage admissible, telles que les établissements de recherche, les établissements universitaires et les institutions similaires qui étudient la provenance des textes, la fiabilité de la détection ou la manière dont les personnes comprennent les résultats de provenance, peuvent demander l’accès au détecteur de texte. Nous examinerons au cas par cas les demandes des organisations admissibles et leur communiquerons, si nécessaire, des mises à jour ou des demandes d’informations complémentaires. Notre approche de l’accès pourra évoluer à mesure que nous approfondirons nos connaissances et améliorerons la technologie.
Nous collaborons actuellement avec un groupe restreint de chercheurs, dont John Thickstun, professeur adjoint d’informatique à l’université Cornell, Martin Vechev, professeur d’informatique à l’ETH Zurich et directeur scientifique de l’INSAIT, ainsi que des chercheurs de l’Institut Kempelen des technologies intelligentes (KInIT), afin de mieux comprendre les capacités et les limites de cette technologie et d’orienter les améliorations du filigranage de texte.
Qui peut bénéficier de limites de vérification plus élevées, et les vérifications sont-elles facturées ?
Les vérifications via l’API de provenance des contenus sont actuellement gratuites et soumises à des limites d’utilisation. Le programme de limites supérieures cible les projets éligibles de provenance d’intérêt public et les workflows d’intégrité de l’information, comme la vérification en rédaction, la vérification des faits, la recherche sur la provenance des contenus et la supervision réglementaire.
Les applications commerciales générales sont actuellement exclues du périmètre du programme, notamment la prévention de la fraude, l’authentification et la vérification à des fins commerciales, ou la revente dans le cadre d’offres de services de provenance et d’analyse de données.
Les organisations dont le cas d’usage est éligible peuvent demander une augmentation des limites, mais le dépôt d’une demande ne garantit pas son approbation. L’API publique reste disponible avec ses limites par défaut, y compris pour les évaluations à plus petite échelle. Consultez la documentation de l’API de provenance des contenus pour connaître les limites d’utilisation actuelles.
Qui peut accéder au détecteur de texte, et les vérifications sont-elles payantes ?
Les vérifications effectuées avec le détecteur de texte sont actuellement gratuites. Les demandeurs admissibles comprennent les établissements de recherche, les établissements universitaires et les institutions similaires qui étudient la provenance des textes, la fiabilité de la détection ou la manière dont les personnes comprennent les résultats de provenance. Les autres demandes ne relèvent pas actuellement du périmètre du programme.
Que signifient les résultats de vérification ?
Si un signal est détecté via openai.com/verify ou l’API de provenance du contenu d’OpenAI, cela signifie que le contenu importé contient un signal de provenance reconnu associé à OpenAI. Cela indique un traitement par un outil d’OpenAI ; le signal seul ne permet pas de savoir si le contenu a été généré ou modifié à l’aide des outils d’OpenAI, ni dans quelle mesure. L’outil ne confirme pas que le contenu est exact, non modifié, détenu légalement ou présenté dans le bon contexte. Il ne permet pas non plus d’identifier qui a créé le contenu ni pourquoi il a été créé.
Si aucun signal n’est détecté, cela signifie que l’outil n’a pas trouvé de signaux de provenance émis par OpenAI dans le fichier importé. Le contenu peut néanmoins avoir été traité par OpenAI si :
Le contenu a été créé avant la mise à disposition des signaux de provenance.
Le contenu provient d’un produit, d’un modèle, d’un mode d’exportation ou d’un type de fichier non pris en charge.
Les métadonnées ont été supprimées lors de l’importation, du téléchargement, de la modification, de la conversion ou du partage.
Un filigrane a été dégradé par la compression, le recadrage, le bruit, des modifications, la conversion de format ou d’autres transformations.
Un extrait audio est trop court ou a été considérablement modifié.
Comment obtenir le résultat de vérification le plus fiable possible ?
Importez un seul fichier pris en charge à la fois et, si possible, utilisez le fichier exporté d’origine. Pour les images, évitez de recadrer ou de convertir le fichier avant de le vérifier. Pour l’audio, les extraits de 10 à 60 secondes donnent généralement les meilleurs résultats. Même si aucun signal n’est détecté, tenez compte de la source et du contexte du fichier avant de tirer une conclusion.
Les résultats affichent-ils mon prompt ou mes informations personnelles ?
Les signaux de provenance n’incluent aucun détail sur l’utilisateur, l’organisation ou le prompt.
Que devient le contenu que je vérifie avec openai.com/verify ou l’API de provenance du contenu ?
Le contenu importé sur openai.com/verify ou soumis à notre API de provenance du contenu pour vérification est traité uniquement pour rechercher les signaux de provenance pris en charge. Le contenu n’est pas stocké, sauf obligation légale, et n’est pas utilisé pour entraîner les modèles d’OpenAI.
OpenAI peut-il détecter du contenu généré avec d’autres outils d’IA ?
Nos outils de provenance des contenus sont conçus pour détecter les signaux de provenance pris en charge associés aux contenus générés par les modèles OpenAI ou exportés par les outils OpenAI. Ils ne sont pas conçus pour détecter du contenu généré par d’autres modèles d’IA et peuvent également ne pas détecter du contenu généré par OpenAI si le signal concerné est absent, non pris en charge ou dégradé.
Fonctionnement du filigranage
Les filigranes permettent-ils de déterminer la paternité, la propriété ou la responsabilité juridique d’un contenu ?
Non. Un filigrane est un indice qu’un modèle OpenAI a probablement généré ou traité le contenu. À lui seul, il ne permet pas d’établir qui est l’auteur ou le propriétaire du contenu, si une mention était requise ou qui en est juridiquement responsable. Il ne permet pas non plus de savoir si le modèle modifiait un contenu importé par un utilisateur.
Les filigranes indiquent-ils dans quelle mesure un modèle OpenAI est intervenu ?
Non. Le détecteur indique s’il a trouvé un filigrane. La présence d’un filigrane est un indice qu’un modèle OpenAI a probablement généré ou traité le contenu, mais elle ne montre pas si le modèle en a généré une partie ou la totalité, ni l’ampleur de la contribution humaine.
Comment fonctionne le filigranage de texte ?
Le filigranage de texte crée un motif secret dans les choix de mots et de fragments de mots, appelés « tokens », effectués par le modèle au fil de la rédaction.
À chaque étape, le modèle attribue une probabilité à chaque token suivant possible. Le système de filigranage crée plusieurs ensembles ajustés de ces probabilités, chacun favorisant différents choix selon une clé secrète. Ces ensembles sont équilibrés de sorte que leur moyenne corresponde aux probabilités d’origine du modèle. La clé sélectionne l’ensemble à utiliser, puis le modèle effectue un nouveau choix aléatoire à partir de cet ensemble.
Un détecteur disposant de la même clé et de paramètres correspondants peut ensuite vérifier si le texte suit le motif secret plus souvent que ne le laisserait prévoir le hasard.
Les filigranes textuels s’appliquent-ils aux textes factuels et aux textes fournis par les utilisateurs ?
Le filigranage de texte suppose que le modèle dispose de différentes façons de dire quelque chose. La marge de manœuvre est plus réduite lorsqu’une réponse doit être très factuelle ou précise, comme la réponse à un problème de mathématiques, ou lorsqu’on demande au modèle de reproduire un texte fourni sans le modifier. Dans ces cas, le modèle a moins de latitude pour modifier sa formulation sans différence perceptible ; le filigrane peut donc ne pas être détecté.
Les filigranes textuels s’appliquent-ils aux réponses courtes et au code ?
Les passages courts ne contiennent généralement pas assez de texte pour permettre une détection fiable du filigrane. Le code est également plus difficile à filigraner, car les choix plausibles pour la suite du texte sont moins nombreux qu’en prose ordinaire.
Pour tenir compte de ces limites, le code de bonnes pratiques sur la transparence des contenus générés par l’IA, associé au règlement européen sur l’IA, n’exige pas de filigranes dans les sorties de moins de 200 tokens, soit environ 150 mots en anglais, ni dans les extraits de code.
Comment la détection des filigranes de texte varie-t-elle selon la langue ?
Les taux de détection varient selon la langue, et la détection est actuellement plus facile dans certaines langues que dans d’autres. Nous pouvons ajuster l’intensité du filigrane pour améliorer la détection dans les langues où le signal est plus faible.
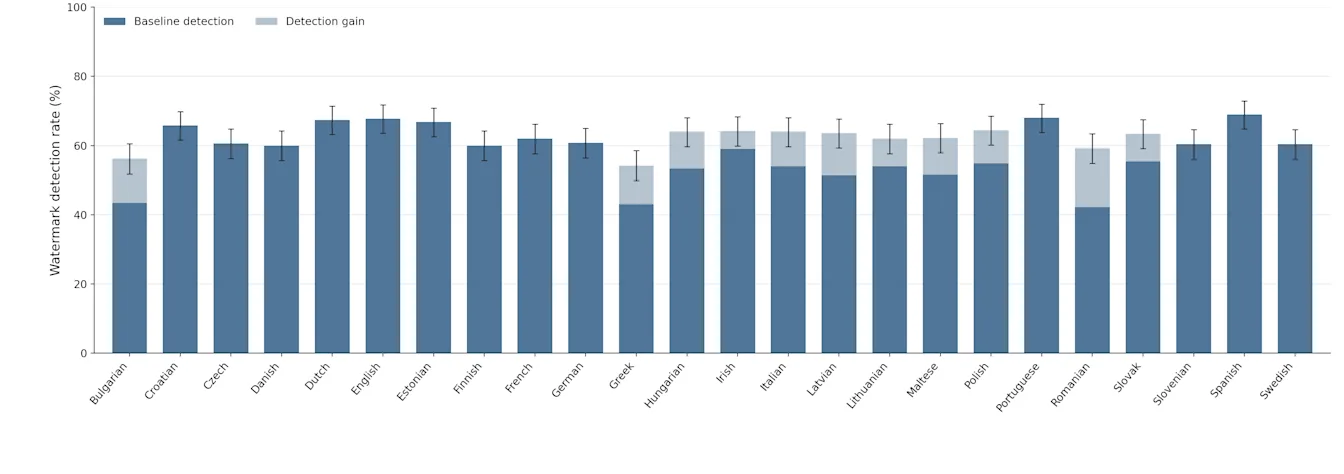
Ce graphique évalue le taux de détection dans les 24 langues officielles de l’UE. Nous avons d’abord généré 500 prompts synthétiques en anglais couvrant divers sujets, puis les avons traduits dans les 23 autres langues. Avec un taux de faux positifs de 1 %, l’espagnol affiche le taux de détection le plus élevé (69,0 %), et le roumain le plus faible (42,2 %). Notre filigrane dispose d’un paramètre d’intensité réglable : un « curseur » qui renforce ou atténue le signal du filigrane selon les domaines. Grâce à ce curseur, nous avons pu augmenter l’intensité pour les langues dont le taux de détection était inférieur à 60 % ; les parties bleu clair des barres montrent les gains obtenus.
Les filigranes textuels réduisent-ils la qualité du modèle ?
D’après nos tests, non. Sur l’ensemble des benchmarks que nous utilisons pour évaluer Astra, notre dernier modèle de pointe, les écarts de performance avec et sans filigranage restent dans la marge de variation que nous observons habituellement d’une évaluation à l’autre. Des tests antérieurs dans ChatGPT n’ont pas non plus montré de changement du taux de pouces vers le bas ou d’autres indicateurs du produit après l’introduction du filigranage.
Les filigranes textuels réduisent-ils la vitesse du modèle ?
Le filigranage de texte a un impact négligeable sur la vitesse de nos modèles.
En quoi les filigranes de texte d’OpenAI diffèrent-ils des outils tiers de détection de l’IA ?
Les outils de détection tiers comme Pangram utilisent généralement des classificateurs pour repérer les textes générés par l’IA à partir de caractéristiques telles que le choix des mots. Cette approche analyse le texte après sa génération plutôt que de détecter un signal intégré. Le règlement européen sur l’IA exige spécifiquement qu’un signal soit intégré au texte généré.
Pourquoi utilisez-vous vos propres filigranes textuels plutôt que TextSeal ou SynthID ?
Nous avons développé notre propre méthode de filigranage de texte, appelée textGrain, pour mieux maîtriser qu’avec SynthID ou TextSeal l’équilibre entre la détectabilité du filigrane et la diversité des réponses générées à partir d’un même prompt. Lors de nos tests, notre approche a correctement identifié une proportion d’échantillons de texte filigranés similaire ou supérieure à celle de SynthID pour le texte. Nous prévoyons de publier textGrain en open source afin que d’autres puissent s’en servir et contribuer à améliorer le filigranage de texte.
Le filigranage de texte ajoute-t-il des caractères cachés, des tokens supplémentaires ou des modifications visibles ?
Non. Le filigranage de texte modifie le motif statistique des choix de mots ; il n’insère pas de caractères cachés et n’ajoute pas de tokens uniquement dédiés au filigrane. Le filigrane n’est pas visible pour les lecteurs, et copier-coller le texte n’introduit aucun élément caché.
Conseils aux clients
En tant que client de l’API, comment activer les filigranes de texte ?
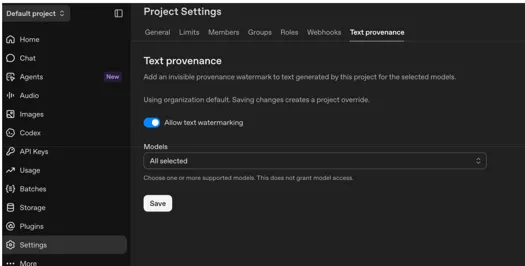
Les clients de l’API OpenAI peuvent activer le filigranage de texte pour un projet spécifique via les Paramètres, ou pour l’ensemble de leur organisation via les Paramètres de l’organisation. Dans chaque cas, les clients peuvent sélectionner les modèles auxquels appliquer un filigrane de texte. Une fois le filigranage de texte activé pour un modèle pris en charge, OpenAI ajoute le filigrane lors de la génération du texte. Les clients n’ont pas besoin d’ajouter un marquage distinct à chaque réponse.
Activez Autoriser le filigranage de texte, sélectionnez vos modèles, puis sélectionnez Enregistrer.
Réglage par défaut de l’organisation : accédez à Paramètres de l’organisation > Contrôles des données.
Sélectionnez Provenance du texte.
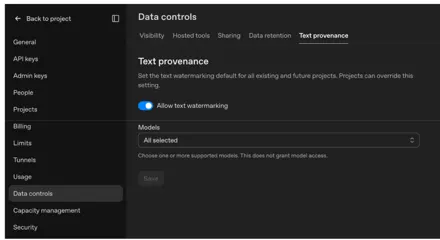
Réglage spécifique au projet : accédez à Paramètres du projet > Provenance du texte.
Pour quels modèles puis-je activer les filigranes ?
Dans les Paramètres et les Paramètres de l’organisation, les clients peuvent consulter la liste des modèles pour lesquels le filigranage est actuellement disponible. Au cours des prochaines semaines, nous étendrons cette prise en charge à tous les anciens modèles.
L’activation des filigranes textuels me donne-t-elle aussi accès au détecteur de texte ?
Non. L’accès au détecteur de texte est actuellement limité aux organismes de recherche et établissements universitaires approuvés qui œuvrent à améliorer la fiabilité du filigranage de texte, sa facilité d’utilisation et la clarté des explications sur cette technologie et ses résultats. Cela est conforme à nos engagements au titre du code de bonnes pratiques sur la transparence des contenus générés par l’IA, associé au règlement européen sur l’IA.
Les signaux resteront-ils associés au contenu après sa transformation ?
C’est possible, mais cela dépend du signal et des modifications apportées.
Pour les images et les fichiers audio pris en charge, conservez une copie originale et utilisez l’API de provenance du contenu pour tester des fichiers représentatifs après modification, conversion et publication. Pour les images, le recadrage, l’ajout de bruit, la conversion en JPEG et les captures d’écran peuvent rendre les signaux plus difficiles à détecter. Vous ne pouvez tester du texte de cette manière que si votre organisation dispose d’un accès approuvé au détecteur de texte.
Lorsque votre format de fichier et votre processus le permettent, préservez les métadonnées C2PA existantes et incluez des Content Credentials dans les fichiers que vous produisez. Vous pouvez aussi envisager d’ajouter vos propres marquages pour rendre les informations de provenance plus durables ou plus utiles. Consultez la documentation technique C2PA pour connaître les détails de mise en œuvre.
Pour le texte, le filigrane est intégré aux choix de mots du modèle. Si vous conservez la formulation, le signal devrait subsister lors de la réutilisation du texte, sans travail d’intégration supplémentaire. Une réécriture importante, une reformulation ou une traduction peuvent rendre la détection moins fiable. Même une formulation inchangée ne garantit pas un filigrane détectable, surtout dans les passages courts ou les textes laissant peu de latitude dans le choix des mots.
J’accède aux modèles d’OpenAI via un service cloud. Les contenus ainsi générés contiennent-ils aussi des signaux de provenance ?
La couverture du filigranage pour les modèles d’OpenAI distribués via Azure varie selon le modèle et la modalité. Contactez Microsoft pour connaître la disponibilité et la couverture actuelles. Nous travaillons à étendre la couverture des signaux de provenance aux contenus générés distribués via d’autres services cloud.
Les signaux de provenance remplacent-ils les mentions visibles d’utilisation de l’IA ou d’autres mentions ?
Non. Les filigranes et les métadonnées C2PA fournissent des informations lisibles par les logiciels. Ils ne remplacent pas les mentions visibles, les bannières ou les autres avertissements éventuellement requis.
La nécessité d’une mention supplémentaire dépend de la manière dont vous utilisez le contenu et de l’endroit où vous l’utilisez. OpenAI ne peut pas vous conseiller sur vos obligations légales spécifiques ; votre équipe juridique doit évaluer les exigences applicables à votre utilisation.
J’ai d’autres questions concernant le règlement européen sur l’IA
Veuillez soumettre une demande concernant le règlement européen sur l’IA, et nous vous répondrons.