
Nell'ambito del suo impegno per un ecosistema dell'IA più sicuro e trasparente, OpenAI usa segnali di provenienza per aiutare le persone a capire se un contenuto è stato generato con un modello di OpenAI.
I segnali di provenienza possono fornire informazioni utili sull'origine, ma non garantiscono che un contenuto sia accurato, non modificato, detenuto legittimamente o presentato nel contesto corretto.
I segnali di provenienza di OpenAI
Quali segnali di provenienza usa OpenAI?
OpenAI usa segnali di provenienza diversi a seconda del tipo di contenuto.
| Tipo di contenuto | Segnali di provenienza | Note |
|---|---|---|
| Immagini | Content Credentials e watermark SynthID | Le immagini generate con ChatGPT, Codex o l'API di OpenAI includono entrambi i segnali. |
| Audio | Watermark SynthID | L'audio generato da ChatGPT o dall'API di OpenAI include un watermark non udibile incorporato nell'audio stesso. |
| Testo | Watermark textGrain (solo nell'UE) | Nell'UE, il testo generato da ChatGPT include una modifica invisibile alla componente casuale delle scelte lessicali del modello, per rispettare il regolamento europeo sull'IA. I clienti API di tutto il mondo possono attivare i watermark per gli output testuali dalle impostazioni del progetto o dell'organizzazione. |
| Video | Content Credentials | Sora non è più disponibile. Scopri di più. |
La presenza dei segnali può variare in base al prodotto, al modello, alla modalità di esportazione, al tipo di file e al momento in cui il contenuto è stato creato. I segnali sono presenti negli output API, ad eccezione di quelli dei modelli di cui è prevista l'imminente deprecazione, tra cui gpt-image-1, gpt-image-1.5 e sora-2.
Perché alcuni tipi di contenuti utilizzano più segnali?
Quando è tecnicamente possibile, OpenAI combina metadati e watermark in modo che ciascuno possa compensare i limiti dell’altro. I metadati possono contenere informazioni dettagliate, ma le piattaforme, gli strumenti di modifica e le conversioni dei file possono rimuoverli. I watermark forniscono meno contesto, ma essendo incorporati nel contenuto generato possono resistere ad alcune trasformazioni che rimuovono i metadati.
Quanto resistono i segnali di provenienza alle modifiche dei contenuti?
I watermark SynthID per immagini e audio e i watermark textGrain per il testo sono progettati per resistere alle modifiche più comuni. A seconda del tipo di contenuto, queste possono includere piccole modifiche, copia e incolla, ritagli o screenshot. Modifiche più estese, come ritagli marcati delle immagini, compressione dei file, parafrasi sostanziali o traduzioni, possono rendere un watermark non rilevabile. Dopo modifiche estese, anche descrivere il risultato come “generato da OpenAI” può essere meno significativo.
Le Content Credentials, sviluppate dalla Coalition for Content Provenance and Authenticity, possono andare perse con operazioni comuni, come acquisire uno screenshot o convertire un file. Quando restano disponibili, possono fornire più dettagli sull’origine e sulla cronologia di un file rispetto a un watermark da solo.
Quando è tecnicamente possibile, usiamo entrambi i metodi per aumentare le probabilità che le informazioni sulla provenienza si conservino dopo le modifiche al contenuto.
Che cosa sono le Content Credentials e a cosa servono?
Le Content Credentials associano a un file informazioni sulla sua origine e sulla sua cronologia, ad esempio quale strumento lo ha creato e quando. Utilizzano uno standard aperto sviluppato dalla Coalition for Content Provenance and Authenticity (C2PA), motivo per cui a volte vengono chiamate “metadati C2PA”.
Le Content Credentials aiutano le persone a verificare da dove proviene un contenuto. Non vengono utilizzate solo per i contenuti generati dall’IA: anche produttori di fotocamere, testate giornalistiche e altri soggetti usano lo standard per certificare la fonte e la cronologia dei propri contenuti multimediali. Scopri di più su C2PA.
Che cos’è SynthID e a cosa serve?
SynthID è una tecnologia di watermarking invisibile sviluppata da Google DeepMind che incorpora un segnale direttamente nei contenuti multimediali generati. A differenza dei metadati, il segnale è parte integrante del contenuto e può conservarsi dopo alcune modifiche o trasformazioni. SynthID fornisce un ulteriore segnale di provenienza oltre ai metadati C2PA. Ad esempio, se i metadati vengono rimossi da un file, un watermark incorporato può comunque indicare che il contenuto è stato generato con gli strumenti OpenAI supportati. Scopri di più su SynthID.
Perché inserite watermark negli output testuali?
Stiamo introducendo i watermark testuali per gli utenti di ChatGPT nell’UE per rispettare il regolamento europeo sull’IA e in linea con i nostri impegni ai sensi del codice di buone pratiche dell’UE sulla trasparenza dei contenuti generati dall’IA, che OpenAI ha sottoscritto insieme a diversi altri importanti fornitori di IA.
Che cos’è textGrain e a cosa serve?
textGrain è la tecnologia di OpenAI per l’inserimento di watermark nel testo. Modifica in modo impercettibile il modo in cui il modello sceglie casualmente tra le possibili parole o parti di parole mentre scrive. Nell’arco di un passaggio, queste scelte creano uno schema che un rilevatore può individuare, anche dopo alcune modifiche.
Il watermark è parte integrante della formulazione del testo e non è visibile a chi legge. Non aggiunge caratteri nascosti, spazi invisibili o punteggiatura insolita. L’inserimento di watermark testuali contribuisce al rispetto dell’obbligo di contrassegnare il testo generato, previsto dal regolamento europeo sull’IA.
Gli strumenti di verifica di OpenAI
Come posso verificare se un contenuto è stato generato con gli strumenti di OpenAI?
Puoi visitare openai.com/verify per verificare se un'immagine o un file audio supportato contiene segnali di provenienza associati a contenuti generati o esportati dagli strumenti di OpenAI. Dopo aver caricato un file supportato, lo strumento cercherà i segnali di provenienza di OpenAI supportati, come un watermark SynthID o un manifesto C2PA attendibile associato a OpenAI. Se lo strumento rileva un segnale di provenienza di OpenAI supportato, significa che il contenuto è stato probabilmente generato da un modello di OpenAI.
Gli sviluppatori e le organizzazioni possono anche usare l'API Content Provenance di OpenAI per cercare segnali di provenienza di OpenAI nelle immagini e nei file audio e integrare la verifica nelle proprie applicazioni o nei propri flussi di lavoro. Le organizzazioni con un caso d'uso idoneo possono richiedere limiti più elevati.
Per quanto riguarda il testo, in linea con i nostri obblighi ai sensi del regolamento europeo sull'IA, le organizzazioni con un caso d'uso idoneo, come gli enti accademici e di ricerca che studiano la provenienza dei testi, l'affidabilità del rilevamento o il modo in cui le persone interpretano i risultati relativi alla provenienza, possono richiedere l'accesso al rilevatore di testo. Esamineremo le richieste delle organizzazioni idonee caso per caso e, ove opportuno, forniremo aggiornamenti o richiederemo ulteriori informazioni. Il nostro approccio all'accesso potrà evolversi man mano che approfondiremo le nostre conoscenze e miglioreremo la tecnologia.
Attualmente collaboriamo con un gruppo ristretto di ricercatori, tra cui John Thickstun, professore assistente di informatica alla Cornell University, Martin Vechev, professore di informatica al Politecnico federale di Zurigo e direttore scientifico di INSAIT, e ricercatori del Kempelen Institute of Intelligent Technologies (KInIT), per comprendere meglio le capacità e i limiti della tecnologia e orientare i miglioramenti del watermarking del testo.
Chi può ottenere limiti di verifica più elevati e le verifiche sono a pagamento?
Le verifiche tramite l’API Content Provenance sono attualmente gratuite e soggette a limiti di utilizzo. Il programma per limiti più elevati è rivolto a progetti idonei sulla provenienza di interesse pubblico e a flussi di lavoro per l’integrità dell’informazione, come le verifiche nelle redazioni, la verifica dei fatti, la ricerca sulla provenienza dei contenuti e la vigilanza normativa.
Le applicazioni aziendali generiche sono attualmente escluse dall’ambito del programma, ad esempio la prevenzione delle frodi, l’autenticazione e la verifica a fini commerciali, oppure la rivendita nell’ambito di pacchetti di servizi per la provenienza e l’analisi dei dati.
Le organizzazioni con un caso d’uso idoneo possono richiedere un aumento dei limiti, ma l’invio della richiesta non ne garantisce l’approvazione. L’API pubblica resta disponibile con i limiti predefiniti, anche per valutazioni su scala ridotta. Consulta la documentazione dell’API Content Provenance per conoscere i limiti di utilizzo attuali.
Chi può accedere al rilevatore per il testo e le verifiche sono a pagamento?
Le verifiche con il rilevatore per il testo sono attualmente gratuite. Tra i casi d’uso idonei rientrano quelli degli enti accademici e di ricerca che studiano la provenienza del testo, l’affidabilità del rilevamento o il modo in cui le persone comprendono i risultati sulla provenienza.
Le applicazioni aziendali generiche sono attualmente escluse dall’ambito del programma, ad esempio la prevenzione delle frodi, l’autenticazione e la verifica a fini commerciali, oppure la rivendita nell’ambito di pacchetti di servizi per la provenienza e l’analisi dei dati.
Anche le applicazioni per l’integrità accademica, come la verifica dell’uso dell’IA nei lavori degli studenti (ad esempio nella stesura di saggi o tesi), sono attualmente escluse dall’ambito del programma.
Che cosa significano i risultati della verifica?
Se viene rilevato un segnale tramite openai.com/verify o l'API Content Provenance di OpenAI, significa che il contenuto caricato contiene un segnale di provenienza supportato associato a OpenAI. Lo strumento non conferma che il contenuto sia accurato, non modificato, detenuto legittimamente o presentato nel contesto corretto. Inoltre, non identifica chi ha creato il contenuto né perché è stato creato.
Se non viene rilevato alcun segnale, significa che lo strumento non ha trovato segnali di provenienza emessi da OpenAI nel file caricato. Il contenuto potrebbe comunque essere stato generato o esportato da OpenAI se:
Il contenuto è stato creato prima che i segnali di provenienza fossero disponibili.
Il contenuto proviene da un prodotto, un modello, una modalità di esportazione o un tipo di file non supportato.
I metadati sono stati rimossi durante il caricamento, il download, la modifica, la conversione o la condivisione.
Un watermark è stato degradato dalla compressione, dal ritaglio, dal rumore, da modifiche, dalla conversione del formato o da altre trasformazioni.
Una clip audio è troppo breve o è stata modificata in modo significativo.
Come posso ottenere il risultato di verifica più affidabile?
Carica un file supportato alla volta e, quando possibile, usa il file esportato originale. Per le immagini, evita di ritagliare o convertire il file prima della verifica. Per l’audio, le clip di durata compresa tra 10 e 60 secondi offrono generalmente i risultati migliori. Anche quando non viene rilevato alcun segnale, considera la fonte e il contesto del file prima di trarre una conclusione.
I risultati mostrano il mio prompt o le mie informazioni personali?
I segnali di provenienza non includono dettagli sull’utente, sull’organizzazione o sul prompt.
Che cosa succede ai contenuti che verifico tramite openai.com/verify o l'API Content Provenance?
I contenuti caricati su openai.com/verify o inviati alla nostra API Content Provenance per la verifica vengono elaborati esclusivamente per cercare i segnali di provenienza supportati. I contenuti non vengono conservati, salvo ove richiesto dalla legge, e non vengono usati per addestrare i modelli di OpenAI.
OpenAI può rilevare contenuti generati con altri strumenti di IA?
I nostri strumenti per la provenienza dei contenuti sono progettati per rilevare i segnali di provenienza supportati associati a contenuti generati dai modelli OpenAI o esportati dagli strumenti di OpenAI. Non sono progettati per rilevare contenuti generati da altri modelli di IA e potrebbero non rilevare nemmeno quelli generati da OpenAI se il relativo segnale è assente, non supportato o degradato.
Come funziona il watermarking
I watermark determinano la paternità, la proprietà o la responsabilità legale dei contenuti?
No. Un watermark è un’indicazione che il contenuto è stato probabilmente generato o elaborato da un modello OpenAI. Da solo, non stabilisce chi sia l’autore o il proprietario del contenuto, se fosse necessario dichiarare l’uso dell’IA o chi ne sia legalmente responsabile. Inoltre, non indica se il modello stesse modificando un contenuto caricato da un utente.
I watermark indicano in quale misura è intervenuto un modello OpenAI?
No. Il rilevatore indica se ha trovato un watermark. Trovarne uno è un’indicazione che un modello OpenAI ha probabilmente generato o elaborato il contenuto, ma non chiarisce se il modello lo abbia generato in parte o per intero, né quanto abbia contribuito una persona.
Come funziona il watermarking testuale?
Il watermarking testuale crea uno schema segreto nelle scelte di parole e parti di parole, chiamate “token”, che il modello compie mentre scrive.
A ogni passaggio, il modello assegna una probabilità a ciascun possibile token successivo. Il sistema di watermarking crea diversi insiemi modificati di queste probabilità, ciascuno dei quali favorisce scelte diverse in base a una chiave segreta. Gli insiemi sono bilanciati in modo che, calcolandone la media, si ottengano le probabilità originali del modello. La chiave seleziona l’insieme da usare e il modello effettua quindi una nuova scelta casuale da quell’insieme.
Un rilevatore con la stessa chiave e impostazioni corrispondenti può poi verificare se il testo segue lo schema segreto più spesso di quanto ci si aspetterebbe per puro caso.
I watermark testuali si applicano ai testi fattuali e a quelli forniti dagli utenti?
L’inserimento di watermark testuali dipende dalla possibilità del modello di esprimere lo stesso concetto in modi diversi. La flessibilità è minore quando una risposta deve essere strettamente fattuale o precisa, come la risposta a un problema matematico, oppure quando al modello viene chiesto di riprodurre un testo fornito senza modificarlo. In questi casi, il modello ha meno margine per cambiare la formulazione senza introdurre differenze evidenti, quindi il watermark potrebbe non essere rilevato.
I watermark testuali si applicano alle risposte brevi e al codice?
I passaggi brevi di solito non contengono abbastanza testo per rilevare un watermark in modo affidabile. Anche nel codice è più difficile inserire un watermark, perché le opzioni plausibili per ciò che segue sono meno numerose rispetto alla prosa ordinaria.
Per tenere conto di questi limiti, il codice di buone pratiche sulla trasparenza dei contenuti generati dall’IA, previsto dal regolamento europeo sull’IA, non richiede watermark negli output inferiori a 200 token (circa 150 parole in inglese) né nei frammenti di codice.
Come varia il rilevamento dei watermark testuali in base alla lingua?
I tassi di rilevamento variano in base alla lingua e attualmente rilevare i watermark è più facile in alcune lingue rispetto ad altre. Possiamo regolare l’intensità del watermark per migliorare il rilevamento nelle lingue in cui il segnale è più debole.
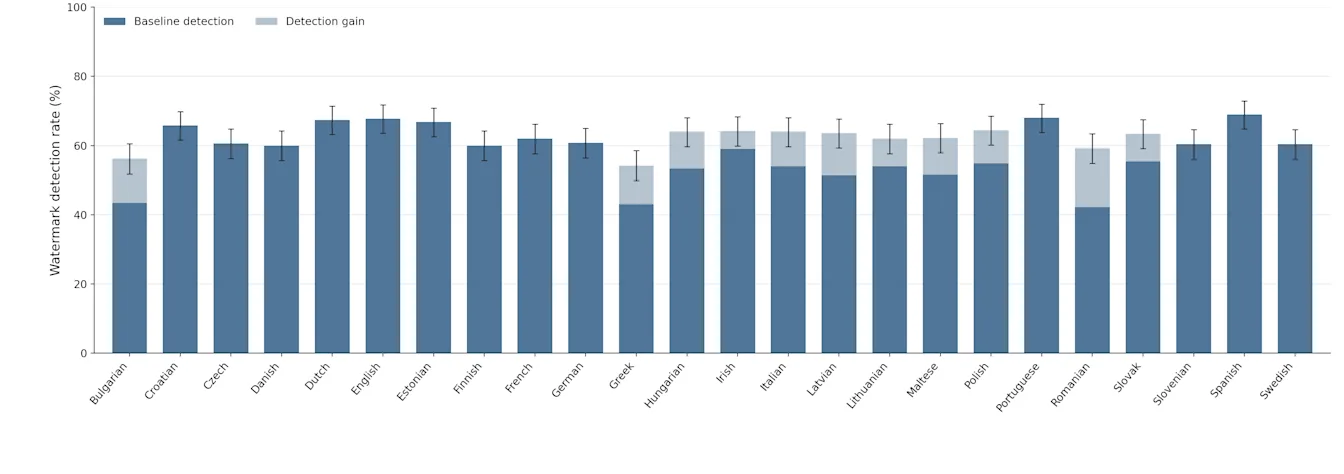
Questo grafico valuta il tasso di rilevamento in tutte le 24 lingue ufficiali dell’UE. Abbiamo prima generato 500 prompt sintetici in inglese su argomenti diversi, poi li abbiamo tradotti nelle altre 23 lingue. Con un tasso di falsi positivi dell’1%, lo spagnolo ha il tasso di rilevamento più alto (69,0%), mentre il rumeno ha quello più basso (42,2%). Il nostro watermark ha un parametro di intensità regolabile: una “manopola” che rafforza o indebolisce il segnale del watermark per i diversi ambiti. Usando questa manopola, abbiamo potuto aumentare l’intensità per le lingue con tassi di rilevamento inferiori al 60%; le porzioni azzurre delle barre mostrano i miglioramenti ottenuti.
I watermark testuali riducono la qualità del modello?
Secondo i nostri test, no. Nei benchmark che usiamo per valutare Astra, il nostro più recente modello di frontiera, le differenze di prestazioni con e senza watermark rientrano nelle normali oscillazioni che osserviamo tra una valutazione e l’altra. Anche i test precedenti su ChatGPT non hanno mostrato variazioni nei tassi di feedback negativi o in altre metriche del prodotto a seguito dell’introduzione dei watermark.
I watermark testuali riducono la velocità del modello?
Il watermarking testuale ha un impatto trascurabile sulla velocità dei nostri modelli.
In cosa si differenziano i watermark testuali di OpenAI dagli strumenti di terze parti per il rilevamento di testi generati dall'IA?
Gli strumenti di rilevamento di terze parti, come Pangram, usano in genere classificatori per individuare il testo generato dall'IA in base a schemi ricorrenti, ad esempio nelle scelte lessicali. Questo approccio analizza il testo dopo la generazione, anziché rilevare un segnale incorporato. Il regolamento europeo sull'IA richiede espressamente che nel testo generato sia incorporato un segnale.
Perché usate watermark testuali sviluppati da voi anziché TextSeal o SynthID?
Abbiamo sviluppato un nostro metodo per inserire watermark nel testo, chiamato textGrain, per avere un maggiore controllo, rispetto a SynthID o TextSeal, sull’equilibrio tra la rilevabilità del watermark e la varietà delle risposte generate a partire dallo stesso prompt. Nei nostri test, il nostro approccio ha identificato correttamente una percentuale di campioni di testo con watermark pari o superiore a quella di SynthID per il testo. Prevediamo di rilasciare textGrain come tecnologia open source, così che altri possano svilupparla ulteriormente e contribuire a migliorare i watermark testuali.
Il watermarking testuale aggiunge caratteri nascosti, token extra o modifiche visibili?
No. Il watermarking testuale modifica lo schema statistico delle scelte lessicali; non inserisce caratteri nascosti né aggiunge token destinati esclusivamente al watermark. Il watermark non è visibile a chi legge e copiare e incollare il testo non introduce contenuti nascosti.
Indicazioni per i clienti
Sono un cliente API: come posso attivare i watermark testuali?
I clienti dell'API di OpenAI possono attivare il watermarking del testo per un progetto specifico tramite le Impostazioni, oppure per l'intera organizzazione tramite le Impostazioni dell'organizzazione. In entrambi i casi, i clienti possono selezionare i modelli per i quali attivare il watermark testuale. Una volta attivata la funzione per un modello supportato, OpenAI aggiunge il watermark durante la generazione del testo. I clienti non devono aggiungere un contrassegno separato a ogni risposta.
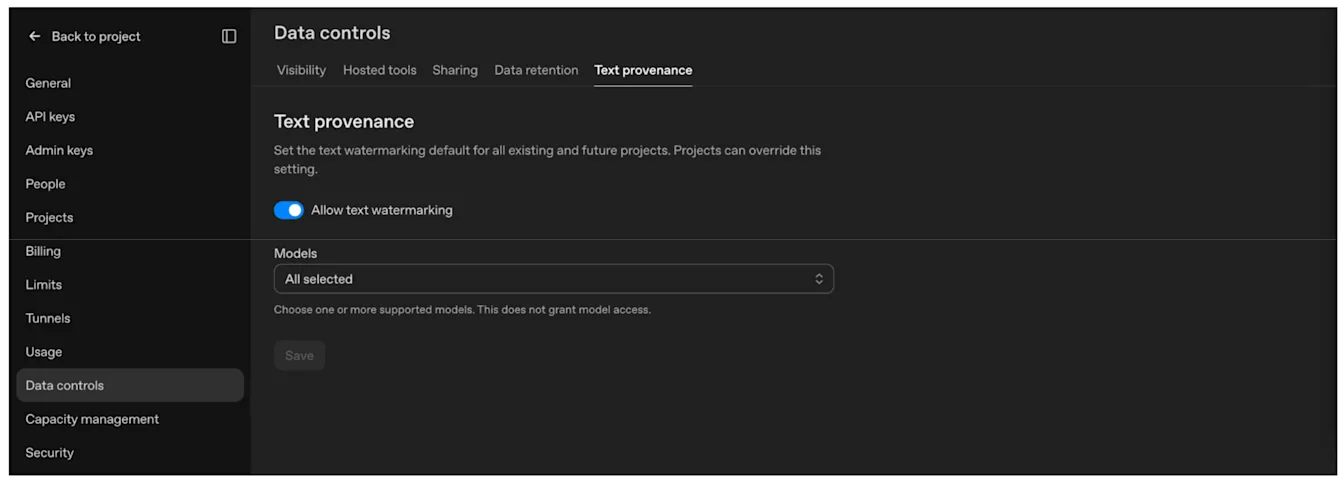
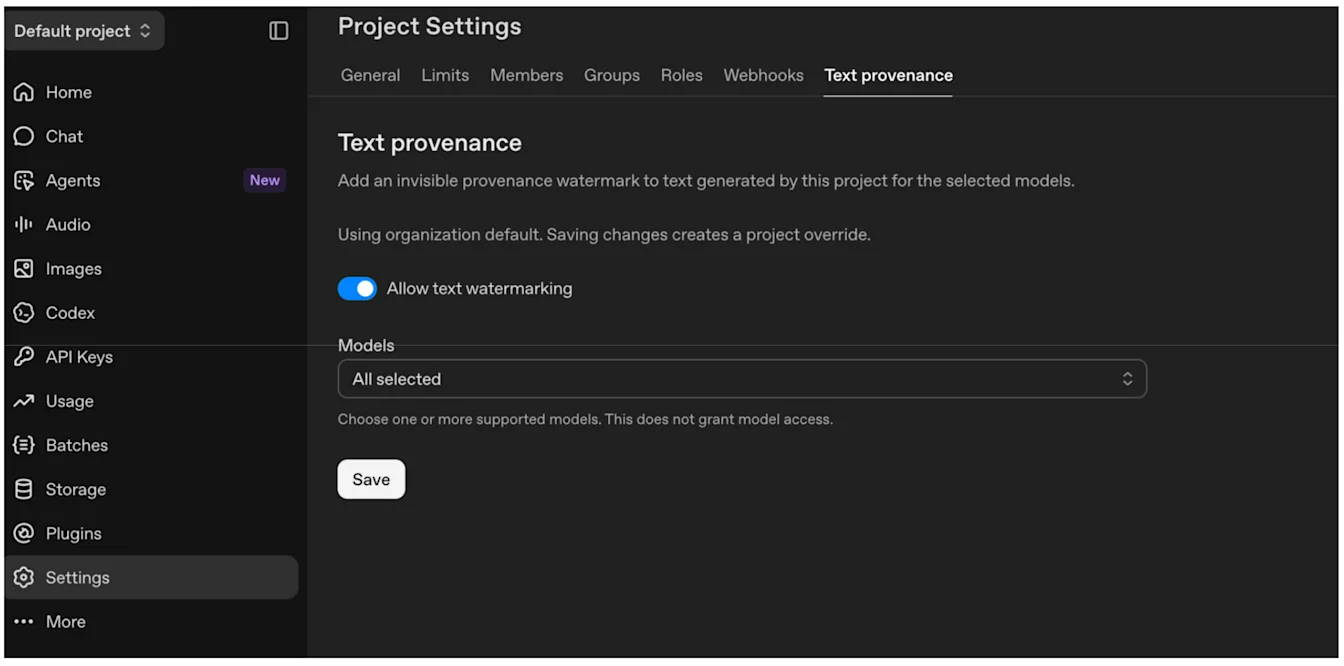
Attiva Consenti watermarking del testo, seleziona i modelli, quindi seleziona Salva.
Impostazione predefinita dell'organizzazione: vai a Impostazioni dell'organizzazione > Controlli dei dati.
Seleziona Provenienza del testo.
Impostazione specifica del progetto: vai a Impostazioni del progetto > Provenienza del testo.
Per quali modelli posso attivare i watermark?
Nelle Impostazioni e nelle Impostazioni dell'organizzazione, i clienti possono consultare l'elenco dei modelli per i quali è attualmente disponibile il watermarking. Nelle prossime settimane estenderemo il supporto a tutti i modelli precedenti.
Attivando i watermark testuali ottengo anche l’accesso al rilevatore per il testo?
No. L’accesso al rilevatore per il testo è attualmente limitato agli enti di ricerca e accademici autorizzati che lavorano per migliorare l’affidabilità e la facilità d’uso dei watermark testuali, nonché la chiarezza con cui è possibile spiegare la tecnologia e i suoi risultati. Questo è in linea con i nostri impegni ai sensi del codice di buone pratiche sulla trasparenza dei contenuti generati dall’IA, previsto dal regolamento europeo sull’IA.
I segnali rimarranno associati al contenuto dopo una trasformazione?
È possibile, ma dipende dal segnale e dalle modifiche che apporti.
Per le immagini e i file audio supportati, conserva una copia originale e usa l'API Content Provenance per verificare un campione rappresentativo di file dopo la modifica, la conversione e la pubblicazione. Per le immagini, il ritaglio, l'aggiunta di rumore, la conversione in JPEG e l'acquisizione di screenshot possono rendere i segnali più difficili da rilevare. Puoi verificare il testo in questo modo solo se la tua organizzazione ha ottenuto l'autorizzazione ad accedere al rilevatore di testo.
Se il formato dei file e il flusso di lavoro lo consentono, conserva i metadati C2PA esistenti e includi le Content Credentials nei file che produci. Puoi anche valutare l'aggiunta di contrassegni personalizzati per rendere le informazioni sulla provenienza più durature o utili. Consulta la documentazione tecnica di C2PA per i dettagli sull'implementazione.
Nel caso del testo, il watermark è insito nelle scelte lessicali del modello. Se mantieni la formulazione originale, il segnale dovrebbe rimanere quando riutilizzi il testo, senza ulteriori interventi di integrazione. Una riscrittura sostanziale, una parafrasi o una traduzione possono rendere il rilevamento meno affidabile. Anche mantenendo la formulazione originale, non è garantito che il watermark sia rilevabile, soprattutto nei passaggi brevi o nei testi che lasciano poco spazio a scelte lessicali alternative.
Accedo ai modelli di OpenAI tramite un servizio cloud. Anche questi output contengono segnali di provenienza?
Stiamo collaborando con tutti i nostri fornitori di servizi cloud e partner di distribuzione per garantire che i segnali di provenienza, inclusi i watermark, siano incorporati in tutti gli output idonei, tra cui immagini, audio e testo. La disponibilità può variare in base all'output e al partner.
I segnali di provenienza sostituiscono le etichette visibili sull’uso dell’IA o altre informative?
No. I watermark e i metadati C2PA forniscono informazioni leggibili dai software. Non sostituiscono etichette visibili, banner o altri avvisi eventualmente richiesti.
La necessità di un’ulteriore informativa dipende da come e dove usi il contenuto. OpenAI non può fornire consulenza sui tuoi specifici obblighi legali; il tuo team legale dovrebbe valutare i requisiti applicabili al tuo utilizzo.
Ho altre domande sul regolamento europeo sull'IA
Invia una richiesta di informazioni sul regolamento europeo sull'IA e ti risponderemo.