
OpenAI は、より安全で透明性の高い AI エコシステムの実現に向けた取り組みの一環として、出所シグナルを活用しています。これにより、コンテンツが OpenAI のモデルで生成されたものかどうかを人々が判断できるよう支援しています。
出所シグナルは、コンテンツの出所に関する有用な情報を提供できます。ただし、コンテンツが正確であること、未編集であること、適法に所有されていること、適切な文脈で提示されていることを保証するものではありません。
OpenAI の出所シグナル
OpenAI が使用する出所シグナル
OpenAI は、コンテンツの種類に応じて異なる出所シグナルを使用しています。
| コンテンツの種類 | 出所シグナル | 備考 |
|---|---|---|
| 画像 | コンテンツ認証情報と SynthID 電子透かし | ChatGPT、Codex、OpenAI API で生成された画像には、両方のシグナルが含まれます。 |
| 音声 | SynthID 電子透かし | ChatGPT や OpenAI API で生成された音声には、耳には聞こえない電子透かしが音声自体に埋め込まれています。 |
| テキスト | textGrain 電子透かし(EU のみ) | EU では、EU AI 法を遵守するため、ChatGPT が生成するテキストにおいて、モデルの言葉の選び方に用いられるランダム性に目には見えない変更を加えています。世界中の API のお客様は、プロジェクト設定または組織設定から、テキスト出力への電子透かしを有効にできます。 |
| 動画 | コンテンツ認証情報 | Sora の提供は終了しました。詳細はこちら。 |
対応範囲は、製品、モデル、エクスポート方法、ファイル形式、コンテンツの作成時期によって異なる場合があります。API の出力は対応対象ですが、gpt-image-1、gpt-image-1.5、sora-2 など、近く廃止を予定しているモデルは除きます。
一部のコンテンツで複数のシグナルを併用する理由
OpenAI は、技術的に可能な場合、メタデータと電子透かしを組み合わせることで、それぞれの制約を補い合っています。メタデータには詳細な情報を含められますが、プラットフォームや編集ツールでの処理、ファイル変換によって削除されることがあります。電子透かしに含められる背景情報は少ないものの、生成コンテンツ自体に埋め込まれているため、メタデータが失われるような加工を経ても残る場合があります。
コンテンツの変更に対する出所シグナルの耐性
画像・音声向けの SynthID 電子透かしと、テキスト向けの textGrain 電子透かしは、一般的な変更に耐えられるよう設計されています。コンテンツの種類によって異なりますが、軽微な編集、コピー&ペースト、トリミング、スクリーンショットの撮影などがこれに含まれます。画像の大幅なトリミング、ファイル圧縮、大幅な言い換え、翻訳など、より大きな変更を加えると、電子透かしを検出できなくなることがあります。また、大幅に変更されたコンテンツを「OpenAI が生成したもの」と表現しても、実態を十分に表さなくなる場合があります。
Coalition for Content Provenance and Authenticity が開発したコンテンツ認証情報は、スクリーンショットの撮影やファイル変換といった日常的な操作で失われることがあります。コンテンツ認証情報が保持されている場合は、電子透かしだけの場合よりも、ファイルの出所や履歴について詳しい情報を提供できます。
当社は技術的に可能な場合、両方の方式を併用し、コンテンツに変更が加えられても出所情報が残りやすくなるようにしています。
コンテンツ認証情報の概要と役割
コンテンツ認証情報は、どのツールでいつ作成されたかなど、ファイルの出所や履歴に関する情報を付与します。Coalition for Content Provenance and Authenticity(C2PA)が開発したオープン標準を使用しているため、「C2PA メタデータ」とも呼ばれます。
コンテンツ認証情報は、コンテンツの出所を確認するのに役立ちます。用途は AI 生成コンテンツに限りません。カメラメーカーや報道機関なども、自社のメディアの出所や履歴を証明するためにこの標準を利用しています。C2PA の詳細はこちら。
SynthID の概要と役割
SynthID は Google DeepMind が開発した不可視の電子透かし技術で、生成メディアにシグナルを直接埋め込みます。メタデータとは異なり、シグナルはコンテンツ自体の一部となるため、編集や加工を経ても残る場合があります。SynthID は、C2PA メタデータに加えて、もう 1 つの出所シグナルを提供します。たとえば、ファイルからメタデータが削除されても、埋め込まれた電子透かしが、対応する OpenAI のツールで生成されたことを示すシグナルとして残る場合があります。SynthID の詳細はこちら。
テキスト出力に電子透かしを導入する理由
当社は EU AI 法を遵守するため、また、OpenAI が他の主要な AI プロバイダー数社とともに署名した EU の「AI 生成コンテンツの透明性に関する実務規範」に基づくコミットメントに沿って、EU 内の ChatGPT ユーザーを対象にテキスト電子透かしを導入しています。
textGrain の概要と役割
textGrain は、OpenAI のテキスト電子透かし技術です。モデルが文章を生成する際、候補となる単語や単語の一部をランダムに選ぶ仕組みをわずかに調整します。こうした選択が文章全体でパターンを形成し、多少の編集が加えられた後でも、検出器がそのパターンを探せるようになります。
電子透かしは言葉の選び方そのものに組み込まれているため、読者には見えません。隠し文字や不可視のスペース、特殊な句読点が追加されることはありません。テキスト電子透かしは、生成テキストへの識別情報の付与を求める EU AI 法の要件への準拠に役立ちます。
OpenAI の検証ツール
OpenAI のツールで生成されたコンテンツの確認方法
openai.com/verify では、対応する画像や音声ファイルに、OpenAI のツールで生成またはエクスポートされたコンテンツに関連する出所シグナルが含まれているかを確認できます。対応するファイルをアップロードすると、ツールが SynthID 電子透かしや OpenAI に関連付けられた信頼できる C2PA マニフェストなど、対応する OpenAI の出所シグナルを探します。対応する OpenAI の出所シグナルが見つかった場合、そのコンテンツは OpenAI のモデルで生成された可能性が高いことを示します。
開発者や組織は、OpenAI の Content Provenance API を使って画像や音声に OpenAI の出所シグナルがあるかを確認し、自社のアプリケーションやワークフローに検証機能を組み込むこともできます。対象となるユースケースを持つ組織は、利用上限の引き上げを申請できます。
テキストについては、EU AI 法に基づく当社の義務に沿って、対象となるユースケースを持つ組織がテキスト検出器の利用を申請できます。たとえば、テキストの出所、検出の信頼性、出所の検証結果が人々にどう理解されるかを研究する学術・研究機関などが対象です。対象となる組織からの申請は個別に審査し、必要に応じて進捗のご連絡や追加情報のお願いをいたします。知見の蓄積や技術の改善に伴い、利用に関する方針は変わる可能性があります。
現在、コーネル大学コンピューターサイエンス助教の John Thickstun 氏、チューリッヒ工科大学コンピューターサイエンス教授で INSAIT の科学ディレクターを務める Martin Vechev 氏、ケンペレン知能技術研究所(KInIT)の研究者など、限られた研究者グループと連携しています。この技術の能力と限界への理解を深め、テキスト電子透かしの改善につなげることを目指しています。
検証の利用上限引き上げの対象と料金
Content Provenance API による検証は現在無料ですが、利用上限が設けられています。利用上限を引き上げるプログラムは、対象となる公益目的の出所確認プロジェクトや、情報の信頼性を守るワークフローを重視しています。たとえば、報道機関による検証、ファクトチェック、コンテンツの出所に関する研究、規制当局による監督などです。
商用の不正防止、認証、検証や、出所確認・データ分析サービスのパッケージに組み込んでの再販売など、一般的なビジネス用途は、現在、本プログラムの対象外です。
対象となるユースケースを持つ組織は、利用上限の引き上げを申請できます。ただし、申請しても承認が保証されるわけではありません。公開 API は、小規模な評価を含め、引き続き標準の利用上限内で利用できます。現在の利用上限については、Content Provenance API のドキュメントをご確認ください。
テキスト検出器の利用対象と検証料金
テキスト検出器による検証は、現在無料です。対象となるユースケースには、学術・研究機関による、テキストの出所、検出の信頼性、出所の検証結果が人々にどう理解されるかについての研究などが含まれます。
商用の不正防止、認証、検証や、出所確認・データ分析サービスのパッケージに組み込んでの再販売など、一般的なビジネス用途は、現在、本プログラムの対象外です。
学生の提出物で AI が使われているかの確認(エッセイや論文の執筆など)といった、学術的誠実性に関わる用途も、現在、本プログラムの対象外です。
検証結果の意味
openai.com/verify または OpenAI の Content Provenance API でシグナルが検出された場合、アップロードしたコンテンツに、OpenAI に関連する対応済みの出所シグナルが含まれていることを意味します。このツールは、コンテンツが正確であること、未編集であること、適法に所有されていること、適切な文脈で提示されていることを確認するものではありません。また、コンテンツの作成者や作成の目的を特定するものでもありません。
シグナルが検出されなかった場合、アップロードしたファイルから、OpenAI が付与した出所シグナルをツールが見つけられなかったことを意味します。次のような場合は、シグナルが検出されなくても、コンテンツが OpenAI によって生成またはエクスポートされた可能性があります。
出所シグナルの導入前に作成されたコンテンツ
未対応の製品、モデル、エクスポート方法、ファイル形式によるコンテンツ
アップロード、ダウンロード、編集、変換、共有の過程でのメタデータの削除
圧縮、トリミング、ノイズ、編集、形式変換、その他の加工による電子透かしの劣化
短すぎる音声クリップや、大幅に変更された音声クリップ
検証結果の信頼性を高める方法
対応するファイルを一度に 1 つずつアップロードし、可能な限り、エクスポートされた元のファイルを使用してください。画像の場合は、確認前のトリミングやファイル変換を避けてください。音声の場合、通常は 10~60 秒のクリップで最も良い結果が得られます。シグナルが検出されなかった場合も、結論を出す前にファイルの出所や背景を考慮してください。
検証結果へのプロンプトや個人情報の表示
出所シグナルには、ユーザー、組織、プロンプトに関する詳細情報は含まれません。
openai.com/verify や Content Provenance API で検証するコンテンツの取り扱い
openai.com/verify にアップロードされたコンテンツや、検証のために当社の Content Provenance API に送信されたコンテンツは、対応する出所シグナルの確認のみに使用されます。コンテンツは、法律で義務付けられる場合を除いて保存されず、OpenAI のモデルの学習にも使用されません。
他の AI ツールで生成されたコンテンツの検出への対応
当社のコンテンツ出所確認ツールは、OpenAI のモデルで生成されたコンテンツや、OpenAI のツールでエクスポートされたコンテンツに関連する、対応済みの出所シグナルを検出するよう設計されています。他の AI モデルが生成したコンテンツを検出するためのものではありません。また、OpenAI が生成したコンテンツでも、該当するシグナルが欠落している、未対応である、または劣化している場合は検出できないことがあります。
電子透かしの仕組み
電子透かしと著作者・所有権・法的責任の関係
電子透かしによって、これらが確定するわけではありません。電子透かしは、OpenAI のモデルがコンテンツを生成または処理した可能性が高いことを示す証拠です。電子透かしだけでは、コンテンツの著作者や所有者、開示義務の有無、法的責任を負う人を確定することはできません。また、モデルがユーザーのアップロードしたコンテンツを編集していたかどうかもわかりません。
電子透かしからわかる OpenAI モデルの関与の範囲
電子透かしでは、関与の程度まではわかりません。検出器が報告するのは、電子透かしが見つかったかどうかです。電子透かしが見つかることは、OpenAI のモデルがコンテンツを生成または処理した可能性が高いことを示す証拠です。ただし、モデルが一部を生成したのか、全体を生成したのか、あるいは人間がどの程度関与したのかはわかりません。
テキスト電子透かしの仕組み
テキスト電子透かしは、モデルが文章を生成する際に、「トークン」と呼ばれる単語や単語の一部の選び方に秘密のパターンを作り出します。
各ステップで、モデルは次に続くトークンの候補それぞれに確率を割り当てます。電子透かしシステムは、その確率を調整した複数のセットを作成します。各セットでは、秘密鍵に基づいて、それぞれ異なる候補が選ばれやすくなっています。これらのセットは、平均するとモデルの元の確率に一致するようにバランスが取られています。鍵によって使用するセットが選ばれ、モデルはそのセットから改めてランダムにトークンを選びます。
同じ鍵と一致する設定を持つ検出器は、後から、そのテキストが偶然に想定される頻度を超えて秘密のパターンに従っているかどうかを確認できます。
事実を述べるテキストやユーザー提供テキストへの電子透かしの適用
テキスト電子透かしは、モデルが同じ内容を複数の言い方で表現できることを前提としています。数学の問題への回答のように、事実に忠実で厳密な回答が求められる場合や、提供されたテキストを変更せずに再現するよう求められる場合は、表現の自由度が低くなります。こうした場合、目立った違いを生じさせずにモデルが文言を変えられる余地が少ないため、電子透かしを検出できないことがあります。
短い回答やコードへのテキスト電子透かしの適用
短い文章では通常、電子透かしを確実に検出するために必要なテキスト量が足りません。コードも、通常の文章に比べて次に続く内容の選択肢が少ないため、電子透かしを埋め込むことが難しくなります。
こうした制約を踏まえ、EU AI 法の「AI 生成コンテンツの透明性に関する実務規範」では、200 トークン未満(英語で約 150 語)の出力やコードスニペットへの電子透かしを義務付けていません。
言語によるテキスト電子透かしの検出率の違い
検出率は言語によって異なり、現時点では、他の言語より検出しやすい言語もあります。シグナルが弱い言語では、電子透かしの強度を調整することで検出率を改善できます。
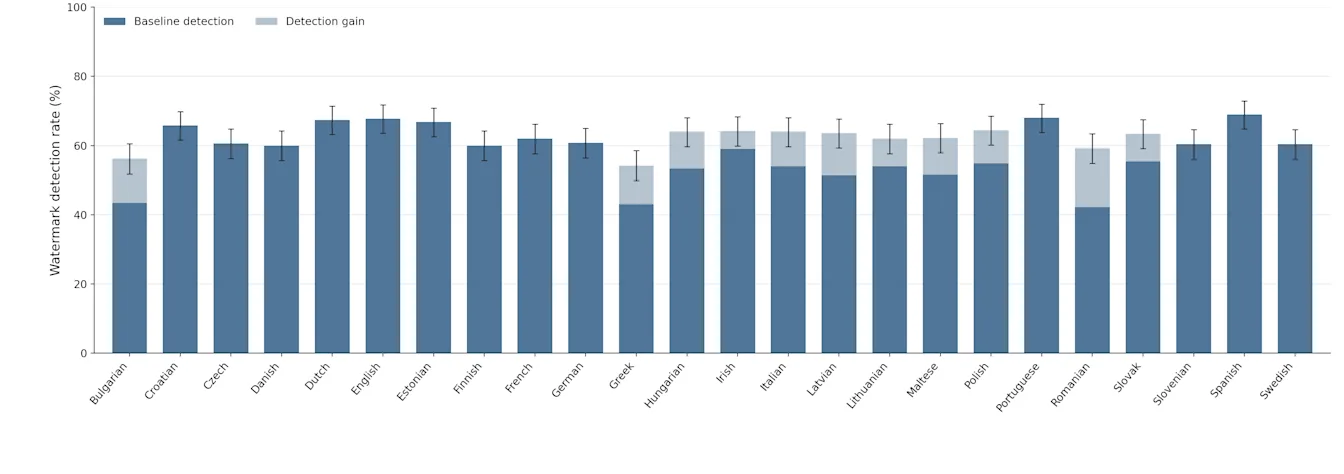
このグラフは、EU の全 24 公用語における検出率の評価結果を示しています。まず、さまざまなトピックを扱う英語の合成プロンプトを 500 件生成し、それらを残りの 23 言語に翻訳しました。偽陽性率を 1% とした場合、検出率が最も高かったのはスペイン語(69.0%)、最も低かったのはルーマニア語(42.2%)でした。当社の電子透かしには強度を調整できるパラメーターがあります。これは、分野に応じて電子透かしのシグナルを強めたり弱めたりする「調整つまみ」に相当します。この調整機能を使い、検出率が 60% 未満の言語で電子透かしの強度を高めました。棒グラフの水色の部分は、その結果得られた検出率の向上を示しています。
テキスト電子透かしのモデル品質への影響
当社のテストでは、品質の低下は見られませんでした。最新のフロンティアモデルである Astra の評価に使用する各ベンチマークでは、電子透かしの有無による性能差は、評価を繰り返す際に通常見られるばらつきの範囲内に収まっています。以前に ChatGPT で実施したテストでも、電子透かしの導入によって低評価の割合やその他の製品指標に変化は見られませんでした。
テキスト電子透かしのモデル速度への影響
テキスト電子透かしが当社のモデルの速度に与える影響は、ごくわずかです。
OpenAI のテキスト電子透かしとサードパーティ製 AI 検出ツールの違い
Pangram などのサードパーティ製検出ツールは通常、分類器を使い、言葉の選び方などのパターンから AI 生成テキストを識別します。この方式は、埋め込まれたシグナルを検出するのではなく、生成後のテキストを分析するものです。EU AI 法は、生成テキストへのシグナルの埋め込みを明確に義務付けています。
TextSeal や SynthID ではなく独自のテキスト電子透かしを採用する理由
当社は、電子透かしの検出しやすさと、同じプロンプトから生成される回答の多様性のバランスを、SynthID や TextSeal より柔軟に調整できるよう、textGrain という独自のテキスト電子透かし方式を開発しました。当社のテストでは、この方式で電子透かし付きテキストのサンプルを正しく識別できた割合は、テキスト用 SynthID と同等以上でした。他の方々がこの技術を基に開発を進め、テキスト電子透かしの改善に貢献できるよう、textGrain をオープンソース技術として公開する予定です。
テキスト電子透かしによる隠し文字・追加トークン・見た目の変化の有無
これらが生じることはありません。テキスト電子透かしは、言葉の選び方の統計的なパターンを変えるもので、隠し文字を挿入したり、電子透かし専用のトークンを追加したりするものではありません。電子透かしは読者には見えず、テキストをコピー&ペーストしても、隠された情報が追加されることはありません。
お客様向けのご案内
API のお客様向け:テキスト電子透かしの有効化方法
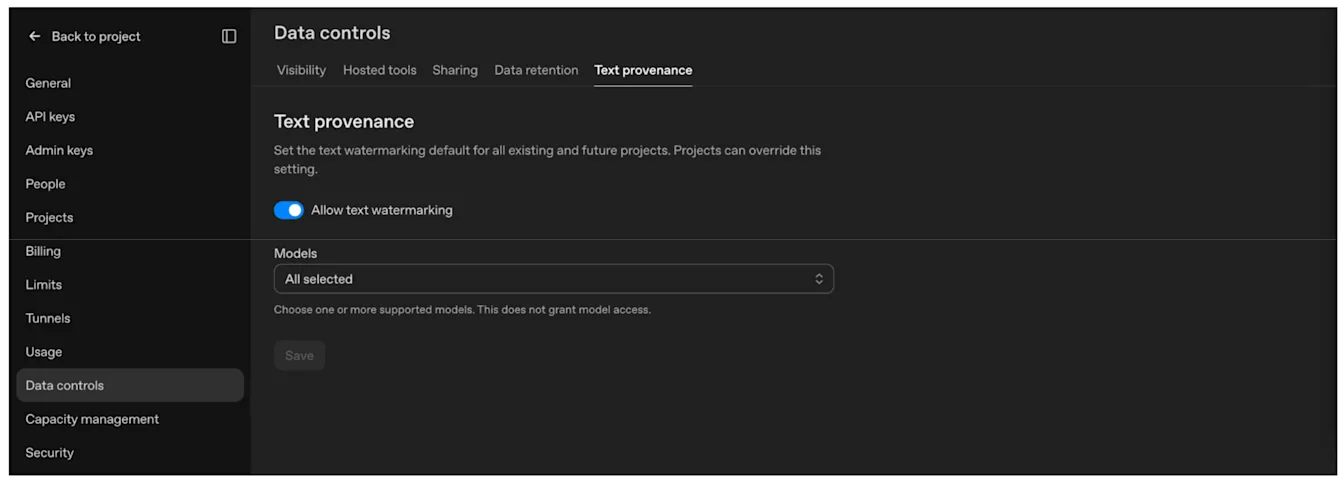
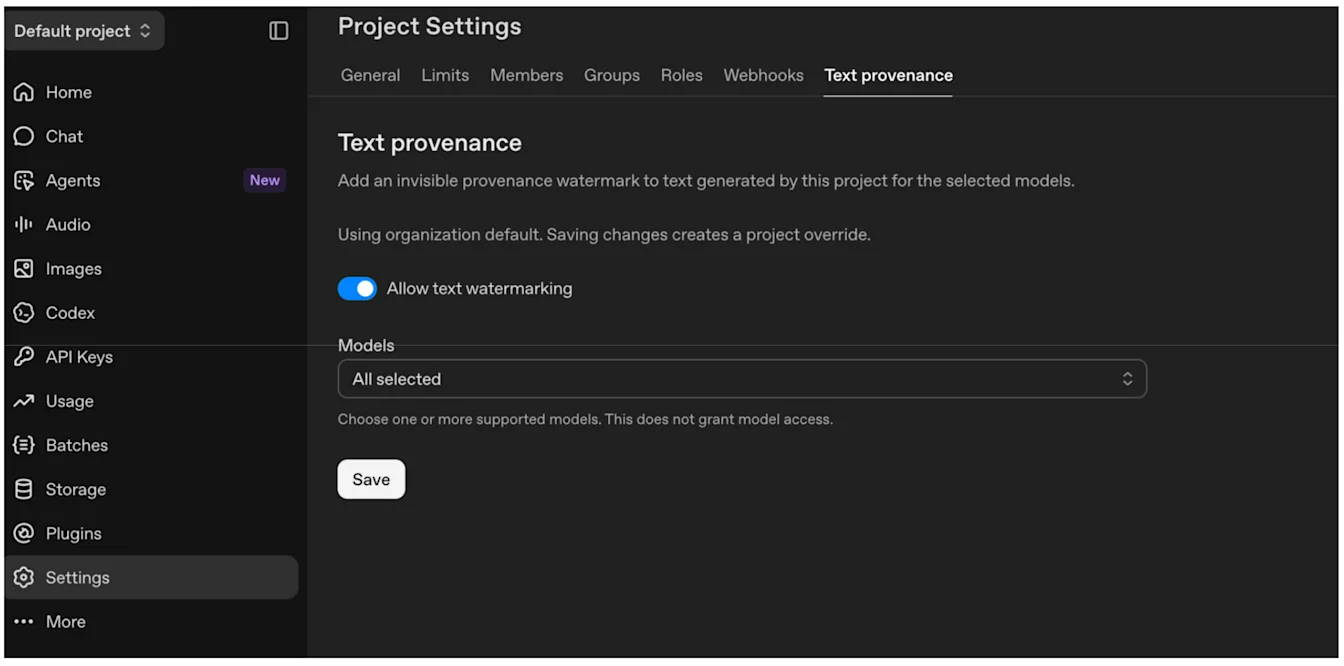
OpenAI API のお客様は、設定から特定のプロジェクトのテキスト電子透かしを有効にするか、組織設定から組織全体で有効にできます。いずれの場合も、テキスト電子透かしを適用するモデルを選択できます。対応するモデルで有効にすると、OpenAI がテキスト生成時に電子透かしを追加します。お客様が回答ごとに別途識別情報を付与する必要はありません。
「テキスト電子透かしを許可」をオンにしてモデルを選び、「保存」を選択してください。
組織のデフォルト設定:組織設定 → データコントロール → テキストの出所
プロジェクト単位の上書き設定:プロジェクト設定 → テキストの出所
テキスト電子透かしの有効化とテキスト検出器の利用資格
電子透かしを有効にしても、テキスト検出器を利用できるようにはなりません。現在、テキスト検出器を利用できるのは、テキスト電子透かしの信頼性や使いやすさ、技術と検出結果の説明のわかりやすさの向上に取り組む、承認済みの研究・学術機関に限られています。これは、EU AI 法の「AI 生成コンテンツの透明性に関する実務規範」に基づく当社のコミットメントに沿ったものです。
コンテンツの加工後におけるシグナルの保持
保持される場合もありますが、シグナルの種類や加えた変更によって異なります。
対応する画像や音声については、元のファイルを保存したうえで、編集、変換、公開後の代表的なファイルを Content Provenance API でテストしてください。画像の場合、トリミング、ノイズの追加、JPEG への変換、スクリーンショットの撮影によって、シグナルが検出しにくくなることがあります。テキストを同様にテストできるのは、組織がテキスト検出器の利用を承認されている場合に限られます。
ファイル形式とワークフローが対応している場合は、既存の C2PA メタデータを保持し、作成するファイルにコンテンツ認証情報を含めてください。出所情報をより失われにくくし、有用性を高めるため、独自の識別情報を追加することも検討できます。実装の詳細については、C2PA の技術ドキュメントをご覧ください。
テキストの電子透かしは、モデルの言葉の選び方に組み込まれています。文言を変えずにテキストを再利用する場合、追加の組み込み作業を行わなくても、シグナルは保持されると考えられます。大幅な書き換えや言い換え、翻訳によって、検出の信頼性が低下することがあります。文言を変えなくても、電子透かしを検出できるとは限りません。特に、短い文章や、別の言葉を選ぶ余地が少ないテキストでは検出が難しくなります。
クラウドサービス経由での OpenAI モデルの利用その出力にも出所シグナルは含まれますか?
当社は、すべてのクラウドサービスおよびモデル提供のパートナーと協力し、画像、音声、テキストなど、対象となるすべての出力に電子透かしを含む出所シグナルが埋め込まれるよう取り組んでいます。対応状況は、出力の種類やパートナーによって異なる場合があります。
出所シグナルと、目に見える AI ラベルやその他の開示との関係
出所シグナルは、これらの代わりにはなりません。電子透かしと C2PA メタデータは、ソフトウェアが読み取れる情報を提供します。表示が必要となる場合がある、目に見えるラベル、バナー、その他の通知に代わるものではありません。
追加の開示が必要かどうかは、コンテンツをどのように、どこで使用するかによって異なります。OpenAI は、お客様固有の法的義務について助言することはできません。ご利用にあたっての要件は、お客様の法務チームでご確認ください。
EU AI 法に関するその他のご質問
EU AI 法に関するお問い合わせを送信してください。担当者からご連絡いたします。