
ხელოვნური ინტელექტის უფრო უსაფრთხო და გამჭვირვალე ეკოსისტემის შექმნის ვალდებულების ფარგლებში, OpenAI წარმომავლობის სიგნალებს იყენებს, რათა ადამიანებს დაეხმაროს იმის გაგებაში, გენერირებულია თუ არა შიგთავსი OpenAI-ის მოდელით.
წარმომავლობის სიგნალები შეიძლება სასარგებლო ინფორმაციას იძლეოდეს წარმოშობის შესახებ, თუმცა არ იძლევა გარანტიას, რომ შიგთავსი ზუსტია, არ არის რედაქტირებული, კანონიერ მფლობელობაშია ან სწორ კონტექსტშია წარმოდგენილი.
OpenAI-ის წარმომავლობის სიგნალები
წარმომავლობის რომელ სიგნალებს იყენებს OpenAI?
სხვადასხვა ტიპის შიგთავსისთვის OpenAI წარმომავლობის სხვადასხვა სიგნალს იყენებს.
| შიგთავსის ტიპი | წარმომავლობის სიგნალები | შენიშვნები |
|---|---|---|
| გამოსახულებები | შიგთავსის სერტიფიკატები და SynthID-ის წყლის ნიშნები | ChatGPT-ით, Codex-ით ან OpenAI-ის API-ით გენერირებული გამოსახულებები ორივე სიგნალს შეიცავს. |
| აუდიო | SynthID-ის წყლის ნიშნები | ChatGPT-ით ან OpenAI-ის API-ით გენერირებული აუდიო შეიცავს თავად აუდიოში ჩაშენებულ, სმენისთვის შეუმჩნეველ წყლის ნიშანს. |
| ტექსტი | textGrain-ის წყლის ნიშნები (მხოლოდ ევროკავშირში) | ევროკავშირში, ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტის მოთხოვნების შესასრულებლად, ChatGPT-ით ტექსტის გენერირებისას შეუმჩნევლად იცვლება შემთხვევითობის მექანიზმი, რომელსაც მოდელი სიტყვების შესარჩევად იყენებს. API-ის მომხმარებლებს მთელ მსოფლიოში შეუძლიათ გენერირებული ტექსტისთვის წყლის ნიშნების ჩართვა პროექტის ან ორგანიზაციის პარამეტრებიდან. |
| ვიდეო | შიგთავსის სერტიფიკატები | Sora-ს მუშაობა შეწყვეტილია. შეიტყვეთ მეტი. |
მხარდაჭერა შესაძლოა განსხვავდებოდეს პროდუქტის, მოდელის, ექსპორტის გზის, ფაილის ტიპისა და შიგთავსის შექმნის დროის მიხედვით. მხარდაჭერა ვრცელდება API-ის შედეგებზე, გარდა იმ მოდელებისა, რომელთა მხარდაჭერის შეწყვეტაც უახლოეს მომავალშია დაგეგმილი, მათ შორის gpt-image-1, gpt-image-1.5 და sora-2.
რატომ გამოიყენება რამდენიმე სიგნალი ზოგიერთი ტიპის შიგთავსისთვის?
როცა ეს ტექნიკურად შესაძლებელია, OpenAI მეტამონაცემებსა და წყლის ნიშნებს აერთიანებს, რათა მათ ერთმანეთის შეზღუდვები დააბალანსონ. მეტამონაცემები შეიძლება დეტალურ ინფორმაციას შეიცავდეს, თუმცა პლატფორმებმა, რედაქტირების ხელსაწყოებმა და ფაილის კონვერტაციამ შესაძლოა ისინი წაშალოს. წყლის ნიშნები ნაკლებ კონტექსტს შეიცავს, მაგრამ, რადგან თავად გენერირებულ შიგთავსშია ჩაშენებული, შესაძლოა გაუძლოს ზოგიერთ ისეთ გარდაქმნას, რომელიც მეტამონაცემებს შლის.
რამდენად გამძლეა წარმომავლობის სიგნალები შიგთავსის ცვლილებების მიმართ?
გამოსახულებებისა და აუდიოსთვის განკუთვნილი SynthID-ის წყლის ნიშნები და ტექსტისთვის განკუთვნილი textGrain-ის წყლის ნიშნები ისეა შექმნილი, რომ გავრცელებულ ცვლილებებს გაუძლოს. შიგთავსის ტიპის მიხედვით, ეს შეიძლება მოიცავდეს მცირე შესწორებებს, კოპირებასა და ჩასმას, ჩამოჭრას ან ეკრანის ანაბეჭდების გადაღებას. უფრო მასშტაბური ცვლილებების შემდეგ — როგორიცაა გამოსახულების დიდი ნაწილის ჩამოჭრა, ფაილის შეკუმშვა, არსებითი პერიფრაზირება ან თარგმნა — წყლის ნიშნის გამოვლენა შესაძლოა შეუძლებელი გახდეს. მასშტაბური ცვლილებების შემდეგ შედეგის „OpenAI-ით გენერირებულად“ აღწერაც შესაძლოა ნაკლებად მართებული იყოს.
შიგთავსის წარმომავლობისა და ავთენტიკურობის კოალიციის მიერ შემუშავებული შიგთავსის სერტიფიკატები შესაძლოა ისეთი ყოველდღიური მოქმედებების დროს დაიკარგოს, როგორიცაა ეკრანის ანაბეჭდის გადაღება ან ფაილის კონვერტაცია. თუ ისინი შენარჩუნდება, ფაილის წარმოშობისა და ისტორიის შესახებ უფრო დეტალურ ინფორმაციას იძლევა, ვიდრე მხოლოდ წყლის ნიშანი.
სადაც ტექნიკურად შესაძლებელია, ორივე მეთოდს ვიყენებთ, რათა შიგთავსის ცვლილებების შემდეგ წარმომავლობის ინფორმაციის შენარჩუნების ალბათობა გაიზარდოს.
რა არის შიგთავსის სერტიფიკატები და რა შესაძლებლობებს იძლევა ისინი?
შიგთავსის სერტიფიკატები ფაილს ურთავს ინფორმაციას მისი წარმოშობისა და ისტორიის შესახებ, მაგალითად, რომელი ხელსაწყოთი და როდის შეიქმნა ის. ისინი იყენებს შიგთავსის წარმომავლობისა და ავთენტიკურობის კოალიციის (C2PA) მიერ შემუშავებულ ღია სტანდარტს, რის გამოც მათ ზოგჯერ „C2PA მეტამონაცემებს“ უწოდებენ.
შიგთავსის სერტიფიკატები ადამიანებს შიგთავსის წარმომავლობის გადამოწმებაში ეხმარება. მათი გამოყენება მხოლოდ ხელოვნური ინტელექტით გენერირებული შიგთავსით არ შემოიფარგლება: კამერების მწარმოებლები, საინფორმაციო ორგანიზაციები და სხვებიც იყენებენ ამ სტანდარტს თავიანთი მედიამასალის წყაროსა და ისტორიის დასადასტურებლად. შეიტყვეთ მეტი C2PA-ის შესახებ.
რა არის SynthID და რა შესაძლებლობებს იძლევა ის?
SynthID არის Google DeepMind-ის მიერ შემუშავებული უხილავი წყლის ნიშნების ტექნოლოგია, რომელიც სიგნალს უშუალოდ გენერირებულ მედიამასალაში აშენებს. მეტამონაცემებისგან განსხვავებით, სიგნალი თავად შიგთავსის ნაწილია და შესაძლოა გარკვეული შესწორებებისა თუ გარდაქმნების შემდეგაც შენარჩუნდეს. SynthID C2PA მეტამონაცემებთან ერთად წარმომავლობის დამატებით სიგნალს იძლევა. მაგალითად, თუ ფაილიდან მეტამონაცემები წაიშლება, ჩაშენებული წყლის ნიშანი შესაძლოა კვლავ მიუთითებდეს, რომ შიგთავსი OpenAI-ის მხარდაჭერილი ხელსაწყოებითაა გენერირებული. შეიტყვეთ მეტი SynthID-ის შესახებ.
რატომ ამატებთ წყლის ნიშნებს გენერირებულ ტექსტს?
ევროკავშირში ChatGPT-ის მომხმარებლებისთვის ტექსტში წყლის ნიშნების ჩაშენებას ვნერგავთ ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტის მოთხოვნების შესასრულებლად. ეს ასევე შეესაბამება ჩვენს ვალდებულებებს ევროკავშირის ხელოვნური ინტელექტით გენერირებული შიგთავსის გამჭვირვალობის პრაქტიკის კოდექსის მიხედვით, რომელსაც OpenAI-მ და ხელოვნური ინტელექტის რამდენიმე სხვა მსხვილმა მომწოდებელმა მოაწერეს ხელი.
რა არის textGrain და რა შესაძლებლობებს იძლევა ის?
textGrain არის OpenAI-ის ტექნოლოგია ტექსტში წყლის ნიშნების ჩასაშენებლად. ის მცირედ ცვლის პროცესს, რომლითაც მოდელი წერისას შესაძლო სიტყვებსა თუ სიტყვის ნაწილებს შორის შემთხვევით არჩევანს აკეთებს. ტექსტის მონაკვეთში ეს არჩევანი ქმნის კანონზომიერებას, რომლის ძებნაც დეტექტორს გარკვეული შესწორებების შემდეგაც შეუძლია.
წყლის ნიშანი თავად ფორმულირებაშია ჩაშენებული და მკითხველისთვის უხილავია. ის არ ამატებს დამალულ სიმბოლოებს, უხილავ გამოტოვებებს ან უჩვეულო პუნქტუაციას. ტექსტში წყლის ნიშნების ჩაშენება ხელს უწყობს ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტის მოთხოვნის შესრულებას, რომელიც გენერირებული ტექსტის მონიშვნას ითვალისწინებს.
OpenAI-ის შემოწმების ხელსაწყოები
როგორ შევამოწმო, გენერირებულია თუ არა შიგთავსი OpenAI-ის ხელსაწყოებით?
გადადით გვერდზე openai.com/verify და შეამოწმეთ, შეიცავს თუ არა მხარდაჭერილი გამოსახულება ან აუდიოფაილი წარმომავლობის სიგნალებს, რომლებიც OpenAI-ის ხელსაწყოებით გენერირებულ ან ექსპორტირებულ შიგთავსს უკავშირდება. მხარდაჭერილი ფაილის ატვირთვის შემდეგ ხელსაწყო მოძებნის OpenAI-ის წარმომავლობის მხარდაჭერილ სიგნალებს, მაგალითად, SynthID-ის წყლის ნიშანს ან OpenAI-სთან დაკავშირებულ სანდო C2PA აღწერის ფაილს. თუ ხელსაწყო OpenAI-ის წარმომავლობის მხარდაჭერილ სიგნალს აღმოაჩენს, ეს მიუთითებს, რომ შიგთავსი, სავარაუდოდ, OpenAI-ის მოდელმა დააგენერირა.
დეველოპერებსა და ორგანიზაციებს ასევე შეუძლიათ გამოიყენონ OpenAI-ის შიგთავსის წარმომავლობის API, რათა გამოსახულებებსა და აუდიოში შეამოწმონ OpenAI-ის წარმომავლობის სიგნალების არსებობა და შემოწმება საკუთარ აპლიკაციებსა თუ სამუშაო პროცესებში ჩართონ. ორგანიზაციებს, რომელთა გამოყენების მიზანიც კრიტერიუმებს აკმაყოფილებს, შეუძლიათ განაცხადი წარადგინონ ლიმიტების გასაზრდელად.
რაც შეეხება ტექსტს, ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტით ნაკისრი ვალდებულებების შესაბამისად, ორგანიზაციებს, რომელთა გამოყენების მიზანიც კრიტერიუმებს აკმაყოფილებს, შეუძლიათ განაცხადი წარადგინონ ტექსტის დეტექტორზე წვდომის მისაღებად. მათ შორისაა აკადემიური და კვლევითი ორგანიზაციები, რომლებიც სწავლობენ ტექსტის წარმომავლობას, გამოვლენის საიმედოობას ან იმას, თუ როგორ ესმით ადამიანებს წარმომავლობის შემოწმების შედეგები. კრიტერიუმების შესაბამისი ორგანიზაციების განაცხადებს ინდივიდუალურად განვიხილავთ და საჭიროებისამებრ დავუკავშირდებით მათ განახლებული ინფორმაციის მისაწოდებლად ან დამატებითი ინფორმაციის გამოსათხოვად. წვდომისადმი ჩვენი მიდგომა შესაძლოა შეიცვალოს ცოდნის დაგროვებისა და ტექნოლოგიის გაუმჯობესების კვალდაკვალ.
ამჟამად ვთანამშრომლობთ მკვლევართა მცირე ჯგუფთან, მათ შორის კორნელის უნივერსიტეტის კომპიუტერული მეცნიერების ასისტენტ-პროფესორ ჯონ თიქსტუნთან, ციურიხის ფედერალური ტექნოლოგიური ინსტიტუტის კომპიუტერული მეცნიერების პროფესორსა და INSAIT-ის სამეცნიერო დირექტორ მარტინ ვეჩევთან, ასევე კემპელენის ინტელექტუალური ტექნოლოგიების ინსტიტუტის (KInIT) მკვლევრებთან. ჩვენი მიზანია, უკეთ გავიგოთ ტექნოლოგიის შესაძლებლობები და შეზღუდვები და მიღებული ცოდნა ტექსტში წყლის ნიშნების ჩაშენების გასაუმჯობესებლად გამოვიყენოთ.
ვის შეუძლია შემოწმების გაზრდილი ლიმიტების მიღება და ფასიანია თუ არა შემოწმება?
შიგთავსის წარმომავლობის API-ით შემოწმება ამჟამად უფასოა და გამოყენების ლიმიტები მოქმედებს. გაზრდილი ლიმიტების პროგრამა განკუთვნილია კრიტერიუმების შესაბამისი, საზოგადოებრივი ინტერესის მქონე წარმომავლობის პროექტებისა და ინფორმაციის სანდოობის უზრუნველყოფის სამუშაო პროცესებისთვის. მათ შორისაა რედაქციებში გადამოწმება, ფაქტების შემოწმება, შიგთავსის წარმომავლობის კვლევა და მარეგულირებელი ზედამხედველობა.
ზოგადი ბიზნესგამოყენება ამჟამად არ შედის პროგრამის ფარგლებში. ეს მოიცავს, მაგალითად, თაღლითობის პრევენციის, ავთენტიფიკაციისა და გადამოწმების კომერციულ მიზნებს ან გადაყიდვას წარმომავლობისა და მონაცემთა ანალიზის მომსახურების პაკეტების ნაწილად.
ორგანიზაციებს, რომელთა გამოყენების მიზანიც კრიტერიუმებს აკმაყოფილებს, შეუძლიათ განაცხადი წარადგინონ ლიმიტების გასაზრდელად, თუმცა განაცხადის წარდგენა დამტკიცების გარანტიას არ იძლევა. საჯარო API კვლავ ხელმისაწვდომია ნაგულისხმევი ლიმიტებით, მათ შორის მცირე მასშტაბის შეფასებებისთვის. გამოყენების მიმდინარე ლიმიტებისთვის იხილეთ შიგთავსის წარმომავლობის API-ის დოკუმენტაცია.
ვის შეუძლია ტექსტის დეტექტორზე წვდომის მიღება და ფასიანია თუ არა შემოწმება?
ტექსტის დეტექტორით შემოწმება ამჟამად უფასოა. კრიტერიუმებს აკმაყოფილებს აკადემიური და კვლევითი ორგანიზაციების საქმიანობა, რომელიც ტექსტის წარმომავლობას, გამოვლენის საიმედოობას ან ადამიანების მიერ წარმომავლობის შემოწმების შედეგების გაგებას შეისწავლის.
ზოგადი ბიზნესგამოყენება ამჟამად არ შედის პროგრამის ფარგლებში. ეს მოიცავს, მაგალითად, თაღლითობის პრევენციის, ავთენტიფიკაციისა და გადამოწმების კომერციულ მიზნებს ან გადაყიდვას წარმომავლობისა და მონაცემთა ანალიზის მომსახურების პაკეტების ნაწილად.
აკადემიური კეთილსინდისიერების მიზნებისთვის გამოყენებაც ამჟამად არ შედის პროგრამის ფარგლებში. ამის მაგალითია სტუდენტურ ნაშრომებში ხელოვნური ინტელექტის გამოყენების შემოწმება (მაგ., ესეების ან სადიპლომო ნაშრომების წერისას).
რას ნიშნავს შემოწმების შედეგები?
თუ openai.com/verify-ის ან OpenAI-ის შიგთავსის წარმომავლობის API-ის საშუალებით სიგნალი გამოვლინდა, ეს ნიშნავს, რომ ატვირთული შიგთავსი შეიცავს OpenAI-სთან დაკავშირებულ წარმომავლობის მხარდაჭერილ სიგნალს. ხელსაწყო არ ადასტურებს, რომ შიგთავსი ზუსტია, არ არის რედაქტირებული, კანონიერ მფლობელობაშია ან სწორ კონტექსტშია წარმოდგენილი. ის ასევე არ ადგენს, ვინ ან რატომ შექმნა შიგთავსი.
თუ სიგნალი არ გამოვლინდა, ეს ნიშნავს, რომ ხელსაწყომ ატვირთულ ფაილში OpenAI-ის მიერ დამატებული წარმომავლობის სიგნალები ვერ იპოვა. შიგთავსი მაინც შეიძლება OpenAI-ით იყოს გენერირებული ან ექსპორტირებული, თუ:
შიგთავსი წარმომავლობის სიგნალების დანერგვამდე შეიქმნა.
შიგთავსი მიღებულია მხარდაუჭერელი პროდუქტით, მოდელით, ექსპორტის გზით ან ფაილის ტიპით.
მეტამონაცემები წაიშალა ატვირთვის, ჩამოტვირთვის, რედაქტირების, კონვერტაციის ან გაზიარებისას.
წყლის ნიშანი დაზიანდა შეკუმშვის, ჩამოჭრის, ხმაურის, შესწორებების, ფორმატის კონვერტაციის ან სხვა გარდაქმნების შედეგად.
აუდიოჩანაწერი ზედმეტად მოკლეა ან მნიშვნელოვნადაა შეცვლილი.
როგორ მივიღო შემოწმების ყველაზე საიმედო შედეგი?
ერთ ჯერზე ატვირთეთ ერთი მხარდაჭერილი ფაილი და, შეძლებისდაგვარად, გამოიყენეთ თავდაპირველად ექსპორტირებული ფაილი. გამოსახულებების შემთხვევაში, შემოწმებამდე მოერიდეთ ჩამოჭრას ან ფაილის კონვერტაციას. აუდიოს შემთხვევაში, საუკეთესო შედეგს, როგორც წესი, 10-დან 60 წამამდე ხანგრძლივობის ჩანაწერები იძლევა. მაშინაც კი, თუ სიგნალი არ გამოვლინდა, დასკვნის გამოტანამდე გაითვალისწინეთ ფაილის წყარო და კონტექსტი.
ჩანს თუ არა შედეგებში ჩემი მოთხოვნა ან პირადი ინფორმაცია?
წარმომავლობის სიგნალები არ შეიცავს დეტალებს მომხმარებლის, ორგანიზაციის ან მოთხოვნის შესახებ.
რა ემართება შიგთავსს, რომელსაც openai.com/verify-ის ან შიგთავსის წარმომავლობის API-ის საშუალებით ვამოწმებ?
openai.com/verify-ზე ატვირთული ან ჩვენს შიგთავსის წარმომავლობის API-ში შესამოწმებლად გაგზავნილი შიგთავსი მუშავდება მხოლოდ წარმომავლობის მხარდაჭერილი სიგნალების შესამოწმებლად. შიგთავსი არ ინახება, თუ ამას კანონი არ მოითხოვს, და არ გამოიყენება OpenAI-ის მოდელების გასაწვრთნელად.
შეუძლია თუ არა OpenAI-ს ხელოვნური ინტელექტის სხვა ხელსაწყოებით გენერირებული შიგთავსის ამოცნობა?
შიგთავსის წარმომავლობის ჩვენი ხელსაწყოები შექმნილია იმ მხარდაჭერილი წარმომავლობის სიგნალების გამოსავლენად, რომლებიც OpenAI-ის მოდელებით გენერირებულ ან OpenAI-ის ხელსაწყოებით ექსპორტირებულ შიგთავსს უკავშირდება. ისინი არ არის განკუთვნილი ხელოვნური ინტელექტის სხვა მოდელებით გენერირებული შიგთავსის ამოსაცნობად. მათ ასევე შესაძლოა ვერ ამოიცნონ OpenAI-ით გენერირებული შიგთავსი, თუ შესაბამისი სიგნალი არ არსებობს, მხარდაჭერილი არ არის ან დაზიანებულია.
როგორ მუშაობს წყლის ნიშნების ჩაშენება
ადგენს თუ არა წყლის ნიშნები ავტორობას, საკუთრებას ან სამართლებრივ პასუხისმგებლობას?
არა. წყლის ნიშანი მიუთითებს, რომ შიგთავსი, სავარაუდოდ, OpenAI-ის მოდელმა დააგენერირა ან დაამუშავა. თავისთავად ის არ ადგენს, ვინ არის შიგთავსის ავტორი ან მესაკუთრე, იყო თუ არა საჭირო ინფორმაციის გამჟღავნება ან ვის ეკისრება სამართლებრივი პასუხისმგებლობა. ის ასევე არ გეუბნებათ, არედაქტირებდა თუ არა მოდელი მომხმარებლის მიერ ატვირთულ შიგთავსს.
აჩვენებს თუ არა წყლის ნიშნები OpenAI-ის მოდელის მონაწილეობის მასშტაბს?
არა. დეტექტორი გატყობინებთ, აღმოაჩინა თუ არა წყლის ნიშანი. მისი აღმოჩენა მიუთითებს, რომ შიგთავსი, სავარაუდოდ, OpenAI-ის მოდელმა დააგენერირა ან დაამუშავა. თუმცა ეს არ აჩვენებს, მოდელმა შიგთავსი ნაწილობრივ დააგენერირა თუ მთლიანად, ან რამდენად დიდი იყო ადამიანის წვლილი.
როგორ მუშაობს ტექსტში წყლის ნიშნების ჩაშენება?
ტექსტში წყლის ნიშნის ჩაშენება ქმნის საიდუმლო კანონზომიერებას მოდელის მიერ წერისას სიტყვებისა და სიტყვის ნაწილების — ე.წ. „ტოკენების“ — შერჩევაში.
ყოველ ნაბიჯზე მოდელი თითოეულ შესაძლო მომდევნო ტოკენს ალბათობას ანიჭებს. წყლის ნიშნების სისტემა ამ ალბათობების რამდენიმე შესწორებულ ნაკრებს ქმნის. თითოეული მათგანი, საიდუმლო გასაღების მიხედვით, უპირატესობას სხვადასხვა ვარიანტს ანიჭებს. ნაკრები ისეა დაბალანსებული, რომ მათი გასაშუალოებით მოდელის თავდაპირველი ალბათობები მიიღება. გასაღები განსაზღვრავს, რომელი ნაკრები გამოიყენება, შემდეგ კი მოდელი ამ ნაკრების მიხედვით ახალ შემთხვევით არჩევანს აკეთებს.
იმავე გასაღებისა და შესაბამისი პარამეტრების მქონე დეტექტორს მოგვიანებით შეუძლია შეამოწმოს, მიჰყვება თუ არა ტექსტი საიდუმლო კანონზომიერებას იმაზე ხშირად, ვიდრე ეს შემთხვევით იქნებოდა მოსალოდნელი.
ვრცელდება თუ არა ტექსტური წყლის ნიშნები ფაქტობრივ და მომხმარებლის მიერ მოწოდებულ ტექსტზე?
ტექსტში წყლის ნიშნის ჩაშენება დამოკიდებულია იმაზე, აქვს თუ არა მოდელს სათქმელის სხვადასხვაგვარად გადმოცემის შესაძლებლობა. არჩევანი უფრო შეზღუდულია, როცა პასუხი მკაცრად ფაქტობრივი ან ზუსტი უნდა იყოს, მაგალითად, მათემატიკური ამოცანის პასუხის შემთხვევაში, ან როცა მოდელს მოწოდებული ტექსტის უცვლელად გამეორებას სთხოვენ. ასეთ შემთხვევებში მოდელს ნაკლები შესაძლებლობა აქვს, ფორმულირება შესამჩნევი სხვაობის გარეშე შეცვალოს, ამიტომ წყლის ნიშანი შესაძლოა ვერ გამოვლინდეს.
ვრცელდება თუ არა ტექსტური წყლის ნიშნები მოკლე პასუხებსა და კოდზე?
მოკლე მონაკვეთები, როგორც წესი, არ შეიცავს საკმარის ტექსტს წყლის ნიშნის საიმედოდ გამოსავლენად. კოდში წყლის ნიშნის ჩაშენებაც უფრო რთულია, რადგან ჩვეულებრივ პროზასთან შედარებით, მის გასაგრძელებლად ნაკლები შესაფერისი ვარიანტი არსებობს.
ამ შეზღუდვების გათვალისწინებით, ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტის ფარგლებში შემუშავებული, ხელოვნური ინტელექტით გენერირებული შიგთავსის გამჭვირვალობის პრაქტიკის კოდექსი არ მოითხოვს წყლის ნიშნებს 200 ტოკენზე — ინგლისურად დაახლოებით 150 სიტყვაზე — მოკლე შედეგებში ან კოდის ფრაგმენტებში.
როგორ იცვლება ტექსტური წყლის ნიშნების გამოვლენა ენის მიხედვით?
გამოვლენის მაჩვენებლები ენის მიხედვით განსხვავდება და ამჟამად ზოგიერთ ენაში წყლის ნიშნის გამოვლენა უფრო მარტივია, ვიდრე სხვებში. შეგვიძლია წყლის ნიშნის სიძლიერე შევცვალოთ, რათა გამოვლენა გავაუმჯობესოთ იმ ენებში, რომლებშიც სიგნალი უფრო სუსტია.
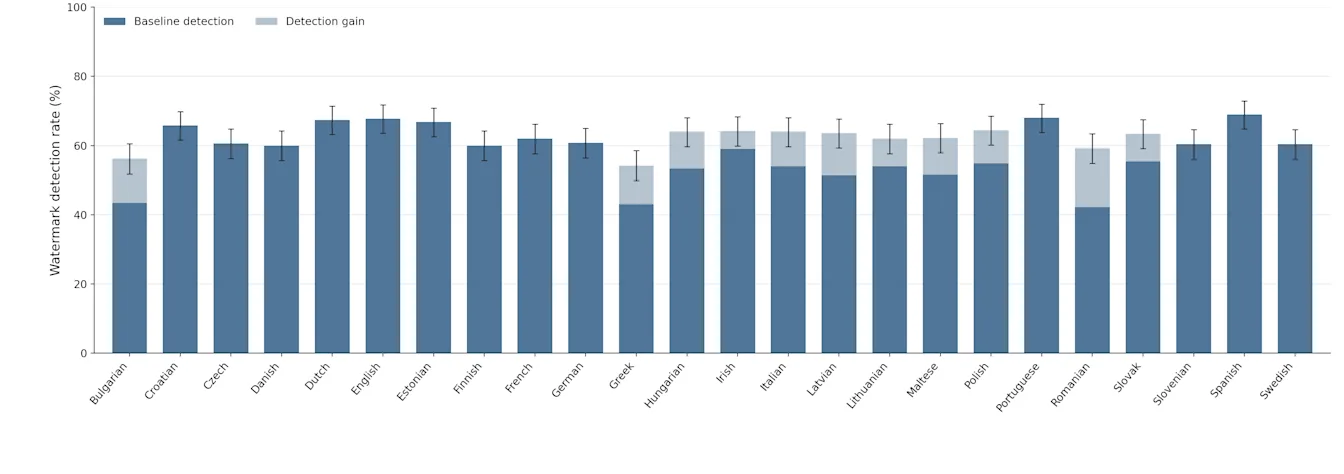
ეს დიაგრამა ევროკავშირის 24-ვე ოფიციალურ ენაში გამოვლენის მაჩვენებელს აფასებს. თავდაპირველად დავაგენერირეთ 500 სინთეზური მოთხოვნა ინგლისურად, სხვადასხვა თემაზე, შემდეგ კი ისინი დანარჩენ 23 ენაზე ვთარგმნეთ. ცრუ დადებითი შედეგების 1%-იანი მაჩვენებლის პირობებში გამოვლენის მაჩვენებელი ყველაზე მაღალია ესპანურში (69,0%), ხოლო ყველაზე დაბალი — რუმინულში (42,2%). ჩვენს წყლის ნიშანს აქვს სიძლიერის რეგულირებადი პარამეტრი — ერთგვარი „რეგულატორი“, რომელიც სხვადასხვა სფეროსთვის წყლის ნიშნის სიგნალს აძლიერებს ან ასუსტებს. ამ რეგულატორით შევძელით სიგნალის გაძლიერება იმ ენებისთვის, რომლებშიც გამოვლენის მაჩვენებელი 60%-ზე დაბალი იყო; სვეტების ღია ცისფერი ნაწილები მიღწეულ გაუმჯობესებას აჩვენებს.
აუარესებს თუ არა ტექსტური წყლის ნიშნები მოდელის ხარისხს?
ჩვენი ტესტების მიხედვით — არა. იმ ტესტებში, რომლებითაც ჩვენს უახლეს მოწინავე მოდელ Astra-ს ვაფასებთ, წყლის ნიშნებითა და მათ გარეშე მიღებულ შედეგებს შორის სხვაობა იმ ჩვეულებრივი მერყეობის ფარგლებშია, რომელსაც შეფასებების გამეორებისას ვხედავთ. ChatGPT-ში ჩატარებულმა წინა ტესტებმაც აჩვენა, რომ წყლის ნიშნების დანერგვას არც უარყოფითი შეფასებების სიხშირე შეუცვლია და არც პროდუქტის სხვა მაჩვენებლები.
ანელებს თუ არა ტექსტური წყლის ნიშნები მოდელის მუშაობას?
ტექსტში წყლის ნიშნების ჩაშენებას ჩვენი მოდელების სიჩქარეზე უმნიშვნელო გავლენა აქვს.
რით განსხვავდება OpenAI-ის ტექსტური წყლის ნიშნები მესამე მხარის ხელსაწყოებისგან, რომლებიც ხელოვნური ინტელექტით გენერირებულ ტექსტს ამოიცნობს?
მესამე მხარის ამომცნობი ხელსაწყოები, მაგალითად, Pangram, როგორც წესი, კლასიფიკატორებს იყენებს, რათა ხელოვნური ინტელექტით გენერირებული ტექსტი ისეთი თავისებურებებით ამოიცნოს, როგორიცაა სიტყვების შერჩევა. ეს მიდგომა ტექსტს გენერირების შემდეგ აანალიზებს და არა მასში ჩაშენებულ სიგნალს ავლენს. ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტი კონკრეტულად მოითხოვს სიგნალის ჩაშენებას გენერირებულ ტექსტში.
რატომ იყენებთ საკუთარ ტექსტურ წყლის ნიშნებს TextSeal-ის ან SynthID-ის ნაცვლად?
შევიმუშავეთ ტექსტში წყლის ნიშნების ჩაშენების საკუთარი მეთოდი, textGrain, რათა SynthID-სა და TextSeal-თან შედარებით უკეთ ვაკონტროლოთ ბალანსი წყლის ნიშნის გამოვლენის შესაძლებლობასა და ერთი და იმავე მოთხოვნით გენერირებული პასუხების მრავალფეროვნებას შორის. ჩვენს ტესტებში ჩვენმა მიდგომამ წყლის ნიშნიანი ტექსტის ნიმუშების ისეთივე ან უფრო მაღალი წილი ამოიცნო სწორად, როგორც ტექსტისთვის განკუთვნილმა SynthID-მა. ვგეგმავთ textGrain-ის ღია კოდის მქონე ტექნოლოგიად გამოშვებას, რათა სხვებმაც შეძლონ მასზე დაყრდნობით მუშაობა და ტექსტში წყლის ნიშნების ჩაშენების გაუმჯობესებაში წვლილის შეტანა.
ამატებს თუ არა ტექსტში წყლის ნიშნების ჩაშენება დამალულ სიმბოლოებს, დამატებით ტოკენებს ან ხილულ ცვლილებებს?
არა. ტექსტში წყლის ნიშნის ჩაშენება ცვლის სიტყვების შერჩევის სტატისტიკურ კანონზომიერებას; ის არ სვამს დამალულ სიმბოლოებს და არ ამატებს მხოლოდ წყლის ნიშნისთვის განკუთვნილ ტოკენებს. წყლის ნიშანი მკითხველისთვის უხილავია, ხოლო ტექსტის კოპირება და ჩასმა დამალულ მასალას არ ამატებს.
რეკომენდაციები მომხმარებლებისთვის
API-ის მომხმარებელი ვარ. როგორ ჩავრთო ტექსტური წყლის ნიშნები?
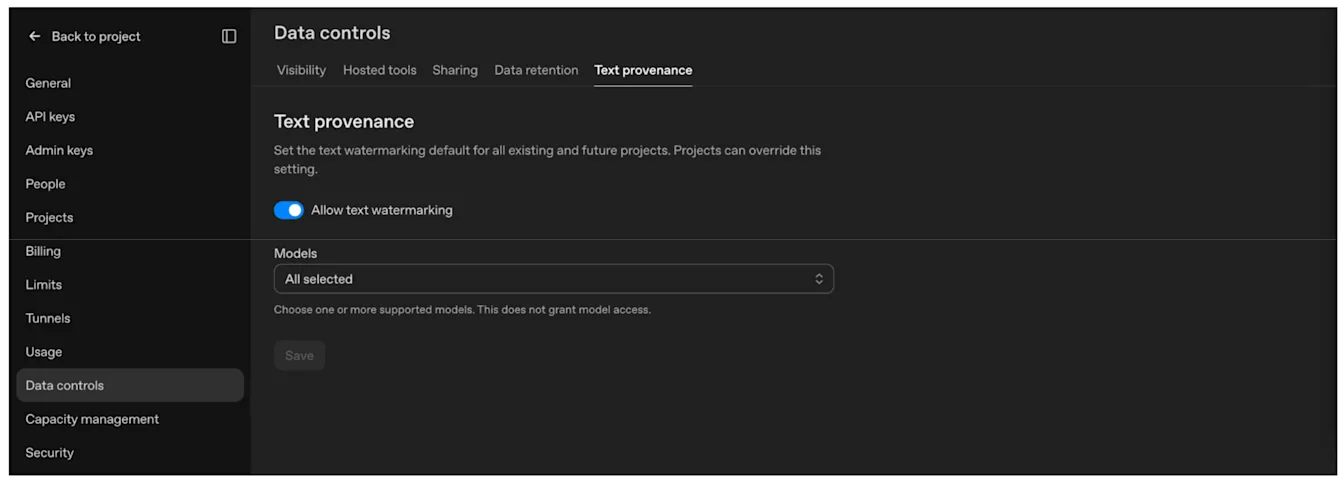
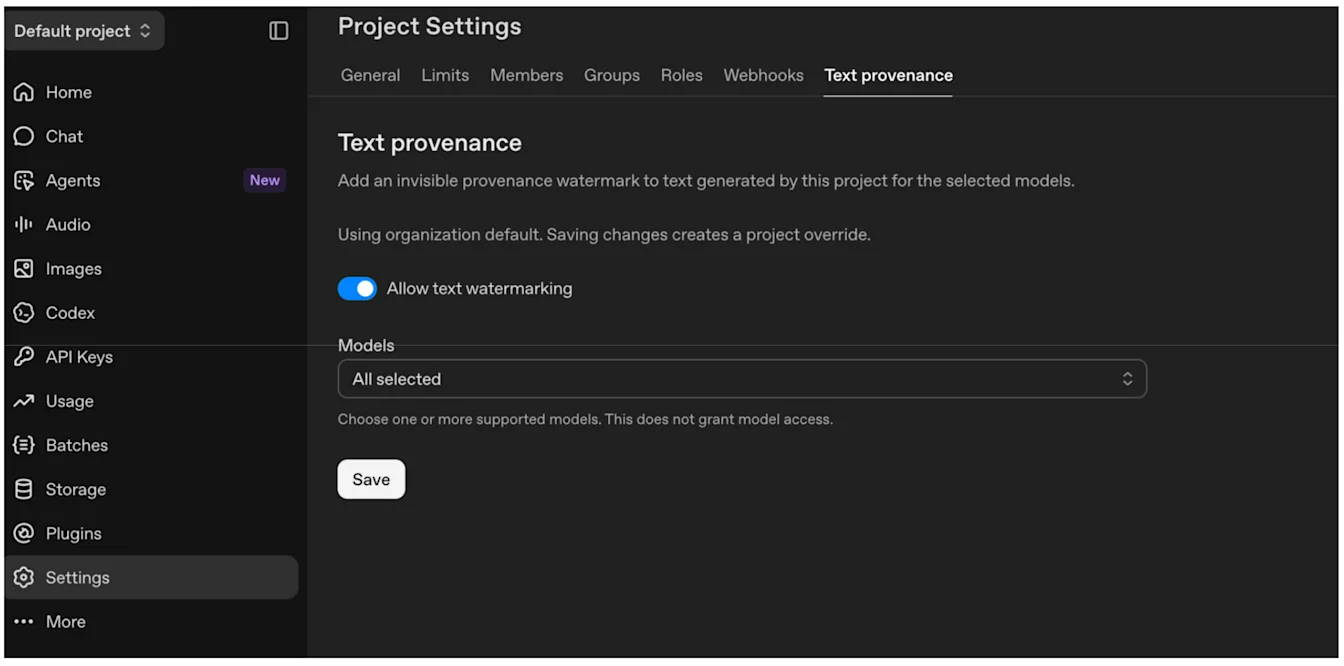
OpenAI-ის API-ის მომხმარებლებს შეუძლიათ ტექსტში წყლის ნიშნების ჩაშენება კონკრეტული პროექტისთვის პარამეტრებიდან ჩართონ, ხოლო მთელი ორგანიზაციისთვის — ორგანიზაციის პარამეტრებიდან. ორივე შემთხვევაში მომხმარებლებს შეუძლიათ აირჩიონ, რომელი მოდელის ან მოდელების ტექსტს დაემატება წყლის ნიშანი. მხარდაჭერილი მოდელისთვის ამ ფუნქციის ჩართვის შემდეგ OpenAI წყლის ნიშანს ტექსტის გენერირებისას ამატებს. მომხმარებლებს არ სჭირდებათ თითოეული პასუხის ცალკე მონიშვნა.
ჩართეთ „ტექსტში წყლის ნიშნების ჩაშენების დაშვება“, აირჩიეთ მოდელები და შემდეგ — „შენახვა“.
ორგანიზაციის ნაგულისხმევი პარამეტრი: ორგანიზაციის პარამეტრები → მონაცემთა მართვა → ტექსტის წარმომავლობა.
პროექტისთვის ჩანაცვლება: პროექტის პარამეტრები → ტექსტის წარმომავლობა.
რომელი მოდელებისთვის შემიძლია წყლის ნიშნების ჩართვა?
პარამეტრებსა და ორგანიზაციის პარამეტრებში მომხმარებლებს შეუძლიათ ნახონ იმ მოდელების სია, რომლებისთვისაც წყლის ნიშნების ჩართვა ამჟამად ხელმისაწვდომია. მომდევნო კვირების განმავლობაში მხარდაჭერას ყველა ძველ მოდელზე გავავრცელებთ.
ტექსტური წყლის ნიშნების ჩართვით ტექსტის დეტექტორზეც მივიღებ წვდომას?
არა. ტექსტის დეტექტორზე წვდომა ამჟამად მხოლოდ დამტკიცებულ კვლევით და აკადემიურ ორგანიზაციებს აქვთ. ისინი მუშაობენ ტექსტში წყლის ნიშნების ჩაშენების საიმედოობის, გამოყენების სიმარტივისა და თავად ტექნოლოგიისა თუ მისი შედეგების მკაფიოდ ახსნის შესაძლებლობის გაუმჯობესებაზე. ეს შეესაბამება ჩვენს ვალდებულებებს ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტის ფარგლებში შემუშავებული, ხელოვნური ინტელექტით გენერირებული შიგთავსის გამჭვირვალობის პრაქტიკის კოდექსის მიხედვით.
შენარჩუნდება თუ არა სიგნალები შიგთავსის გარდაქმნის შემდეგ?
შესაძლოა შენარჩუნდეს, თუმცა ეს სიგნალსა და თქვენ მიერ შეტანილ ცვლილებებზეა დამოკიდებული.
შეინახეთ მხარდაჭერილი გამოსახულებებისა და აუდიოს ორიგინალი ასლები და შიგთავსის წარმომავლობის API-ით შეამოწმეთ ტიპური ფაილები რედაქტირების, კონვერტაციისა და გამოქვეყნების შემდეგ. გამოსახულებებში ჩამოჭრამ, ხმაურის დამატებამ, JPEG-ად კონვერტაციამ და ეკრანის ანაბეჭდების გადაღებამ შესაძლოა სიგნალების გამოვლენა გაართულოს. ტექსტის ამგვარად შემოწმება მხოლოდ იმ შემთხვევაში შეგიძლიათ, თუ თქვენს ორგანიზაციას ტექსტის დეტექტორზე დამტკიცებული წვდომა აქვს.
თუ ფაილის ფორმატი და სამუშაო პროცესი ამის საშუალებას იძლევა, შეინარჩუნეთ არსებული C2PA მეტამონაცემები და თქვენ მიერ შექმნილ ფაილებს შიგთავსის სერტიფიკატები დაურთეთ. ასევე შეგიძლიათ საკუთარი მონიშვნების დამატება, რათა წარმომავლობის შესახებ ინფორმაცია უფრო გამძლე ან სასარგებლო გახდეს. დანერგვის დეტალებისთვის იხილეთ C2PA-ის ტექნიკური დოკუმენტაცია.
ტექსტში წყლის ნიშანი მოდელის მიერ სიტყვების შერჩევაშია ჩაშენებული. თუ ფორმულირებას უცვლელად დატოვებთ, ტექსტის ხელახლა გამოყენებისას სიგნალიც, სავარაუდოდ, შენარჩუნდება, ინტეგრაციისთვის დამატებითი სამუშაოს გარეშე. მნიშვნელოვანმა გადამუშავებამ, პერიფრაზირებამ ან თარგმნამ შესაძლოა გამოვლენის საიმედოობა შეამციროს. უცვლელი ფორმულირებაც კი არ იძლევა წყლის ნიშნის გამოვლენის გარანტიას, განსაკუთრებით მოკლე მონაკვეთებში ან ტექსტში, სადაც სიტყვების არჩევანი შეზღუდულია.
OpenAI-ის მოდელებზე წვდომას ღრუბლოვანი სერვისით ვიღებ. ასე მიღებული შედეგებიც შეიცავს წარმომავლობის სიგნალებს?
ვმუშაობთ ღრუბლოვანი და სადისტრიბუციო სერვისების ყველა ჩვენს მომწოდებელთან, რათა წარმომავლობის სიგნალები, მათ შორის წყლის ნიშნები, ჩაიშენოს ყველა შესაბამის შედეგში, გამოსახულების, აუდიოსა და ტექსტის ჩათვლით. ხელმისაწვდომობა შესაძლოა შედეგისა და პარტნიორის მიხედვით განსხვავდებოდეს.
ანაცვლებს თუ არა წარმომავლობის სიგნალები ხელოვნური ინტელექტის გამოყენების ხილულ ნიშნულებს ან სხვა შეტყობინებებს?
არა. წყლის ნიშნები და C2PA მეტამონაცემები იძლევა ინფორმაციას, რომლის წაკითხვაც პროგრამულ უზრუნველყოფას შეუძლია. ისინი არ ანაცვლებს ხილულ ნიშნულებს, ბანერებს ან სხვა შეტყობინებებს, რომლებიც შესაძლოა საჭირო იყოს.
დამატებითი ინფორმაციის გამჟღავნების საჭიროება დამოკიდებულია იმაზე, თუ როგორ და სად იყენებთ შიგთავსს. OpenAI ვერ გაგიწევთ კონსულტაციას თქვენი კონკრეტული სამართლებრივი ვალდებულებების შესახებ; თქვენს გამოყენებასთან დაკავშირებული მოთხოვნები თქვენმა იურიდიულმა გუნდმა უნდა შეაფასოს.
დამატებითი კითხვები მაქვს ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტთან დაკავშირებით
გთხოვთ, გამოგვიგზავნოთ შეკითხვა ხელოვნური ინტელექტის შესახებ ევროკავშირის აქტთან დაკავშირებით და დაგიკავშირდებით.