
Како дел од заложбата за побезбеден и потранспарентен екосистем на вештачка интелигенција, OpenAI користи сигнали за потекло за да им помогне на луѓето да утврдат дали некоја содржина е генерирана со модел на OpenAI.
Сигналите за потекло може да дадат корисни информации за потеклото, но не гарантираат дека содржината е точна, неизменета, во законска сопственост или претставена во соодветниот контекст.
Сигналите за потекло на OpenAI
Кои сигнали за потекло ги користи OpenAI?
OpenAI користи различни сигнали за потекло за различни видови содржина.
| Вид на содржина | Поддржани формати | Сигнали за потекло | Забелешки |
|---|---|---|---|
| Слики | PNG, JPEG/JPG, WebP, GIF | Content Credentials и водени жигови SynthID | Сликите генерирани со ChatGPT или со API на OpenAI ги содржат двата сигнала. |
| Аудио | MP3, WAV, AAC, FLAC, OGG, Opus, PCM | Водени жигови SynthID | Аудиото генерирано со ChatGPT или со API на OpenAI содржи нечуен воден жиг вграден во самото аудио. |
| Текст | Текст во слободна форма; не е врзан за формат на датотека | Водени жигови textGrain (само во ЕУ) | Во ЕУ, текстот генериран со ChatGPT вклучува невидлива промена во случајноста со која моделот ги избира зборовите, за да се исполнат барањата на Актот на ЕУ за ВИ. Корисниците на API ширум светот може да вклучат водени жигови за генерираниот текст преку поставките на проектот или организацијата. Дознајте повеќе. |
| Видео | Не е применливо | Не е применливо | Sora повеќе не е достапна.Дознајте повеќе. |
| PDF-датотеки | PDF (.pdf) | Content Credentials (метаподатоци C2PA) | PDF-датотеките извезени од поддржани алатки на OpenAI содржат метаподатоци C2PA вградени во датотеката. |
Опфатот може да се разликува според производот, моделот, начинот на извоз, видот на датотеката и времето кога е создадена содржината. Резултатите од API се опфатени, освен кај моделите што наскоро се планира да се повлечат од употреба, вклучувајќи ги gpt-image-1, gpt-image-1.5 и sora-2.
Зошто за некои видови содржина се користат повеќе сигнали?
Кога е технички изводливо, OpenAI комбинира метаподатоци и водени жигови за меѓусебно да ги надополнат своите ограничувања. Метаподатоците може да содржат детални информации, но платформите, алатките за уредување и конверзиите на датотеки може да ги отстранат. Водените жигови даваат помалку контекст, но бидејќи се вградени во самата генерирана содржина, може да опстојат по некои трансформации што ги отстрануваат метаподатоците.
Колку се отпорни сигналите за потекло на измени на содржината?
Водените жигови SynthID за слики и аудио и водените жигови textGrain за текст се дизајнирани да издржат вообичаени измени. Во зависност од видот на содржината, тоа може да вклучува мали измени, копирање и лепење, отсекување или снимање на екранот. Пообемните измени — како отсекување голем дел од сликата, компресирање на датотеката, значително преформулирање или превод — може да оневозможат откривање на водениот жиг. По обемни измени, може да биде и помалку оправдано резултатот да се опише како „генериран од OpenAI“.
Content Credentials, развиени од Коалицијата за потекло и автентичност на содржината, може да се изгубат при секојдневни дејства, како што се снимање на екранот или конвертирање датотека. Кога ќе се зачуваат, тие може да дадат повеќе детали за потеклото и историјата на датотеката отколку само водениот жиг.
Каде што е технички можно, ги користиме двата метода за да ја зголемиме веројатноста информациите за потеклото да се зачуваат по измени на содржината.
Што се Потврди за содржина и што овозможуваат?
Потврдите за содржина приложуваат информации за потеклото и историјата на датотеката, како на пример со која алатка е создадена и кога. Тие користат отворен стандард развиен од Коалицијата за потекло и автентичност на содржината (C2PA), поради што понекогаш се нарекуваат „метаподатоци C2PA“.
Потврдите за содржина им помагаат на луѓето да проверат од каде потекнува содржината. Не се користат само за содржина генерирана со ВИ: производителите на камери, новинските организации и други го користат стандардот за да ги потврдат изворот и историјата на своите медиумски содржини. Дознајте повеќе за C2PA.
Што е SynthID и што овозможува?
SynthID е технологија за невидливи водени жигови развиена од Google DeepMind, која вградува сигнал директно во генерираната медиумска содржина. За разлика од метаподатоците, сигналот е дел од самата содржина и може да остане по одредени измени или трансформации. SynthID обезбедува дополнителен сигнал за потекло покрај метаподатоците C2PA. На пример, ако метаподатоците се отстранат од датотека, вградениот воден жиг сепак може да укаже дека содржината е генерирана со поддржани алатки на OpenAI. Дознајте повеќе за SynthID.
Зошто вградувате водени жигови во генерираниот текст?
Воведуваме водени жигови во текст за корисниците на ChatGPT во ЕУ за да ги исполниме барањата на Актот на ЕУ за ВИ и нашите обврски според Кодексот на практики на ЕУ за транспарентност на содржината генерирана со ВИ, кој го потпишаа OpenAI и неколку други големи даватели на услуги со ВИ.
Што е textGrain и што овозможува?
textGrain е технологија на OpenAI за вградување водени жигови во текст. Таа суптилно го приспособува начинот на кој моделот случајно избира меѓу можните зборови или делови од зборови додека пишува. Низ текстот, овие избори создаваат образец што детекторот може да го препознае, дури и по одредени измени.
Водениот жиг е дел од самата формулација на текстот и не е видлив за читателите. Тој не додава скриени знаци, невидливи празни места или невообичаена интерпункција. Вградувањето водени жигови во текст помага да се исполни барањето од Актот на ЕУ за ВИ за означување на генерираниот текст.
Повеќе детали за тоа како функционира textGrain можете да најдете во нашиот технички извештај.
Алатките за проверка на OpenAI
Како да проверам дали содржината е обработена со алатки на OpenAI?
Посетете ја страницата openai.com/verify за да проверите дали поддржана слика, аудиодатотека или PDF содржи сигнали за потекло поврзани со содржина обработена со алатки на OpenAI. Откако ќе поставите поддржана датотека, алатката ќе побара поддржани сигнали за потекло од OpenAI, како што се воден жиг SynthID или доверлив манифест C2PA поврзан со OpenAI. Ако алатката најде поддржан сигнал за потекло од OpenAI, тоа укажува дека содржината веројатно е обработена со алатка на OpenAI.
Програмерите и организациите може да го користат и API на OpenAI за потекло на содржината за да проверуваат слики, аудио и PDF-датотеки за сигнали за потекло од OpenAI и да ја вградат проверката во сопствените апликации или работни процеси. Организациите чија намена на користење ги исполнува условите може да поднесат барање за повисоки лимити.
За текст, во согласност со нашите обврски според Актот на ЕУ за ВИ, организациите чија намена на користење ги исполнува условите може да поднесат барање за пристап до детекторот за текст. Тука спаѓаат истражувачки, академски и слични институции што го проучуваат потеклото на текстот, веродостојноста на откривањето или начинот на кој луѓето ги разбираат резултатите од проверките на потеклото. Секое барање од организација што ги исполнува условите ќе го разгледаме поединечно и, по потреба, ќе испратиме известување или ќе побараме дополнителни информации. Нашиот пристап кон одобрувањето пристап може да се менува со новите сознанија и со усовршувањето на технологијата.
Моментално соработуваме со ограничена група истражувачи, меѓу кои се Џон Тикстун, доцент по компјутерски науки на Универзитетот Корнел, Мартин Вечев, професор по компјутерски науки на ETH Цирих и научен директор на INSAIT, и истражувачи од Институтот за интелигентни технологии Кемпелен (KInIT). Целта е подобро да ги разбереме можностите и ограничувањата на технологијата и да ги искористиме сознанијата за подобрување на водените жигови во текст.
Кој ги исполнува условите за повисоки лимити за проверка и дали проверките се наплаќаат?
Проверките преку API за потекло на содржина во моментов се бесплатни и подлежат на лимити за користење. Програмата за повисоки лимити е наменета за проекти од јавен интерес за потекло на содржината и работни процеси за интегритет на информациите што ги исполнуваат условите, како проверки во редакции, проверка на факти, истражување на потеклото на содржината и регулаторен надзор.
Општите деловни примени се во моментов надвор од опфатот на програмата, како комерцијално спречување измами, автентикација и верификација или препродажба во рамки на пакети услуги за потекло на содржина и анализа на податоци.
Организациите со намена што ги исполнува условите може да поднесат барање за повисоки лимити, но поднесувањето барање не гарантира одобрување. Јавниот API останува достапен со своите стандардни лимити, вклучително и за евалуации од помал обем. За тековните лимити за користење, погледнете ја документацијата за API за потекло на содржина.
Кој ги исполнува условите за пристап до детекторот за текст и дали проверките се наплаќаат?
Проверките со детекторот за текст моментално се бесплатни. Барање може да поднесат истражувачки, академски и слични институции што го проучуваат потеклото на текстот, веродостојноста на откривањето или начинот на кој луѓето ги разбираат резултатите од проверките на потеклото. Другите намени моментално не се опфатени со програмата.
Што значат резултатите од проверката?
Ако се открие сигнал преку openai.com/verify или API на OpenAI за потекло на содржината, тоа значи дека поставената содржина содржи поддржан сигнал за потекло поврзан со OpenAI. Ова укажува на обработка со алатка на OpenAI; самиот сигнал не покажува дали, ниту во колкава мера, содржината е генерирана или изменета со алатките на OpenAI. Алатката не потврдува дека содржината е точна, неизменета, во законска сопственост или претставена во правилен контекст. Исто така, не утврдува кој ја создал содржината или зошто е создадена.
Ако не се открие сигнал, тоа значи дека алатката не нашла сигнали за потекло издадени од OpenAI во поставената датотека. Содржината сепак може да била обработена од OpenAI ако:
Содржината е создадена пред сигналите за потекло да станат достапни.
Содржината потекнува од неподдржан производ, модел, начин на извоз или вид на датотека.
Метаподатоците се отстранети при поставување, преземање, уредување, конвертирање или споделување.
Водениот жиг е ослабен со компресија, отсекување, шум, измени, промена на форматот или други трансформации.
Аудиоснимката е прекратка или е значително изменета.
Како можам да добијам најсигурен резултат од проверката?
Прикачувајте по една поддржана датотека и, кога е можно, користете ја оригиналната извезена датотека. Кај сликите, избегнувајте отсекување или конверзија на датотеката пред проверката. Кај аудиото, исечоците од 10 до 60 секунди обично даваат најдобри резултати. Дури и кога не е откриен сигнал, земете ги предвид изворот и контекстот на датотеката пред да донесете заклучок.
Дали резултатите го прикажуваат мојот промпт или моите лични податоци?
Сигналите за потекло не содржат детали за корисникот, организацијата или промптот.
Што се случува со содржината што ја проверувам преку openai.com/verify или API за потекло на содржината?
Содржината прикачена на openai.com/verify или испратена за проверка преку нашиот API за потекло на содржината се обработува само за да се провери присуството на поддржани сигнали за потекло. Содржината не се чува освен ако тоа не е законски задолжително и не се користи за тренирање на моделите на OpenAI.
Може ли OpenAI да открие содржина генерирана со други алатки за ВИ?
Нашите алатки за потекло на содржината се наменети за откривање поддржани сигнали за потекло поврзани со содржина генерирана од модели на OpenAI или извезена со алатки на OpenAI. Тие не се наменети за откривање содржина генерирана од други модели за ВИ, а може да не откријат ни содржина генерирана од OpenAI ако соодветниот сигнал недостасува, не е поддржан или е ослабен.
Како функционира вградувањето водени жигови
Дали водените жигови го утврдуваат авторството, сопственоста или правната одговорност?
Не. Водениот жиг е доказ дека модел на OpenAI веројатно ја генерирал или обработил содржината. Сам по себе, тој не утврдува кој е автор или сопственик на содржината, дали било задолжително да се објави известување за употребата на ВИ или кој е правно одговорен. Исто така, не покажува дали моделот уредувал содржина прикачена од корисник.
Дали водените жигови покажуваат во колкава мера учествувал модел на OpenAI?
Не. Детекторот пријавува дали нашол воден жиг. Наоѓањето воден жиг е доказ дека модел на OpenAI веројатно ја генерирал или обработил содржината, но не покажува дали моделот генерирал дел од неа или целата содржина, ниту колкав бил човечкиот придонес.
Како функционира вградувањето водени жигови во текст?
Вградувањето воден жиг во текст создава таен образец во изборот на зборови и делови од зборови, наречени „токени“, што моделот го прави додека пишува.
На секој чекор, моделот доделува веројатност за секој можен следен токен. Системот за водени жигови создава неколку приспособени множества од тие веројатности, од кои секое им дава предност на различни избори според таен клуч. Множествата се урамнотежени така што нивните просечни вредности се совпаѓаат со првичните веројатности на моделот. Клучот одредува кое множество ќе се користи, а моделот потоа прави нов случаен избор од тоа множество.
Детектор со истиот клуч и соодветни поставки подоцна може да провери дали текстот го следи тајниот образец почесто отколку што би се очекувало по случајност.
Дали текстуалните водени жигови се применуваат на фактички текст и на текст доставен од корисник?
Вградувањето воден жиг во текст зависи од тоа дали моделот има различни начини да изрази нешто. Има помалку флексибилност кога одговорот мора строго да се држи до фактите или да биде прецизен, како решението на математичка задача, или кога од моделот се бара да го пренесе доставениот текст без измени. Во овие случаи, моделот има помалку простор да ја промени формулацијата без забележлива разлика, па водениот жиг можеби нема да биде откриен.
Дали текстуалните водени жигови се применуваат на кратки одговори и код?
Кратките пасуси обично не содржат доволно текст за сигурно откривање на воден жиг. И во кодот е потешко да се вгради воден жиг, бидејќи има помалку соодветни можности за тоа што следува отколку во обичен текст.
Земајќи ги предвид овие ограничувања, Кодексот на практики за транспарентност на содржината генерирана со ВИ во рамките на Законот за ВИ на ЕУ не бара водени жигови во излезни содржини пократки од 200 токени — околу 150 зборови на англиски — ниту во исечоци од код.
Како се разликува откривањето водени жигови во текст во зависност од јазикот?
Стапките на откривање се разликуваат според јазикот, а водените жигови моментално полесно се откриваат во некои јазици отколку во други. Можеме да ја приспособиме јачината на водениот жиг за да го подобриме откривањето во јазиците во кои сигналот е послаб.
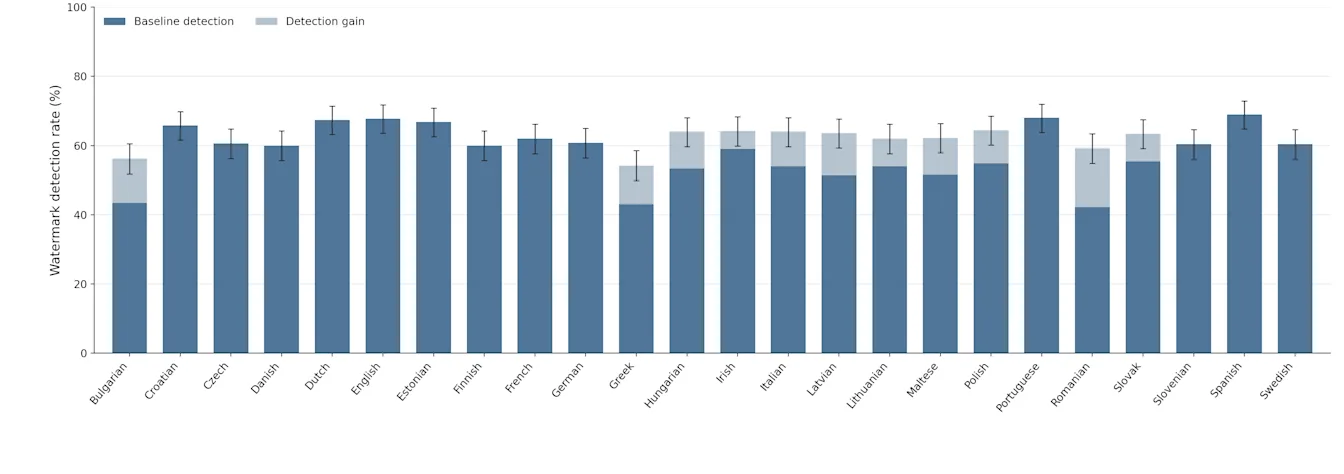
Овој графикон ја прикажува стапката на откривање за сите 24 официјални јазици на ЕУ. Прво генериравме 500 синтетички промптови на англиски на различни теми, а потоа ги преведовме на останатите 23 јазици. При стапка на лажно позитивни резултати од 1 %, шпанскиот има највисока стапка на откривање (69,0 %), а романскиот најниска (42,2 %). Нашиот воден жиг има приспособлив параметар за јачина — „регулатор“ што го засилува или ослабува сигналот на водениот жиг за различни области на примена. Со овој регулатор успеавме да ја зголемиме јачината за јазиците со стапка на откривање под 60 %; светлосините делови од столбовите ги покажуваат постигнатите подобрувања.
Дали текстуалните водени жигови го намалуваат квалитетот на моделот?
Според нашите тестови, не. Во референтните тестови што ги користиме за оценување на Astra, нашиот најнов граничен модел, разликите во перформансите со и без водени жигови се во рамките на случајните варијации што обично ги забележуваме меѓу повторените евалуации. И претходните тестови во ChatGPT не покажаа промена во стапките на негативни оценки или во другите показатели за производот по воведувањето водени жигови.
Дали текстуалните водени жигови ја намалуваат брзината на моделот?
Вградувањето водени жигови во текст има занемарливо влијание врз брзината на нашите модели.
По што се разликуваат водените жигови за текст на OpenAI од алатките на трети страни за откривање содржина генерирана со вештачка интелигенција?
Алатките за детекција на трети страни, како Pangram, обично користат класификатори за да препознаат текст генериран со вештачка интелигенција врз основа на обрасци, како што е изборот на зборови. Со тој пристап се анализира текстот по генерирањето, наместо да се открива вграден сигнал. Законот за вештачка интелигенција на ЕУ изречно бара вградување сигнал во генерираниот текст.
Зошто користите сопствени текстуални водени жигови наместо TextSeal или SynthID?
Развивме сопствен метод за вградување водени жигови во текст, наречен textGrain, за да имаме поголема контрола отколку со SynthID или TextSeal врз рамнотежата меѓу можноста за откривање на водениот жиг и разновидноста на одговорите генерирани од истиот промпт. Во нашите тестови, нашиот пристап правилно препозна сличен или поголем удел од текстуалните примероци со воден жиг во споредба со SynthID за текст. Планираме да го објавиме textGrain како технологија со отворен код за и други да можат да ја надградуваат и да помогнат во подобрувањето на водените жигови во текст.
Дали вградувањето водени жигови во текст додава скриени знаци, дополнителни токени или видливи промени?
Не. Вградувањето водени жигови во текст го менува статистичкиот образец на изборот на зборови; не вметнува скриени знаци ниту додава токени што служат само за водениот жиг. Водениот жиг не е видлив за читателите, а копирањето и лепењето на текстот не внесува скриена содржина.
Насоки за клиентите
Како да вклучам водени жигови во текст како корисник на API?
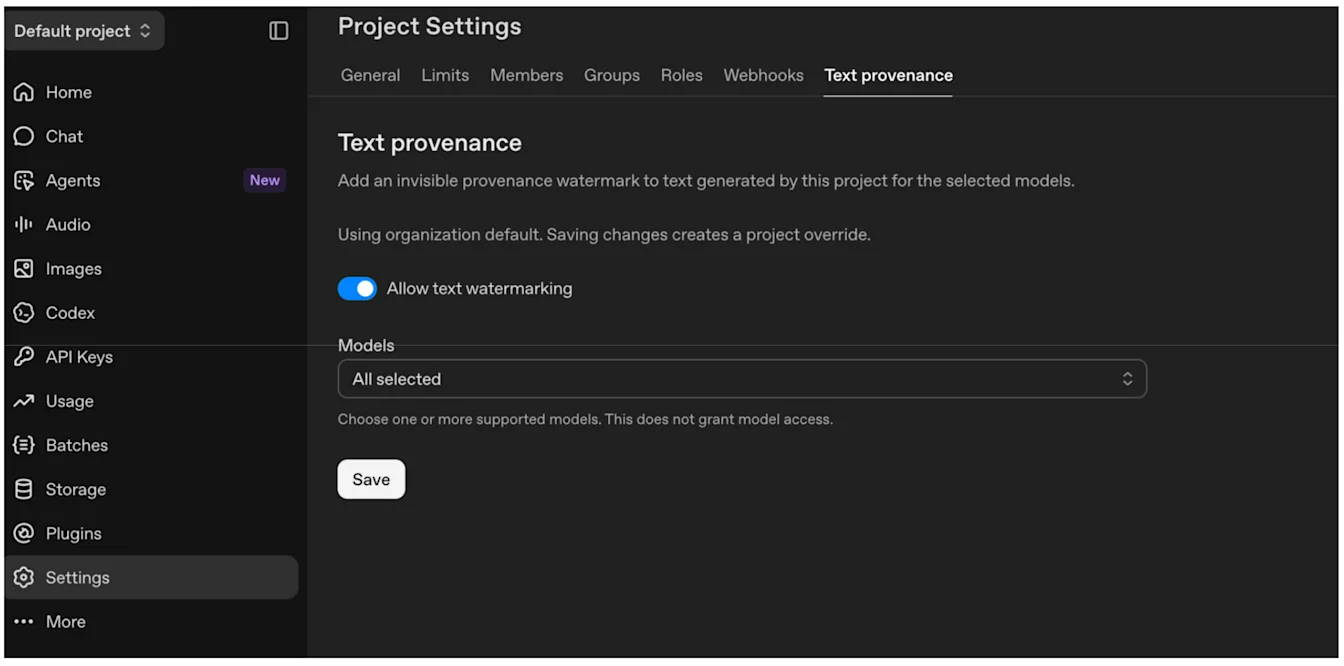
Корисниците на API на OpenAI може да активираат водени жигови во текст за одреден проект преку Поставки или за целата организација преку Поставки на организацијата. Во двата случаи, корисниците може да изберат за кои модели ќе се вградува воден жиг во текстот. Откако ќе вклучите водени жигови во текст за поддржан модел, OpenAI го додава жигот при генерирањето на текстот. Корисниците не треба да додаваат посебна ознака на секој одговор.
Вклучете „Дозволи водени жигови во текст“, изберете ги моделите, па изберете „Зачувај“.
Стандардна поставка за организацијата: одете во Поставки на организацијата > Контроли за податоци.
Изберете „Потекло на текстот“.
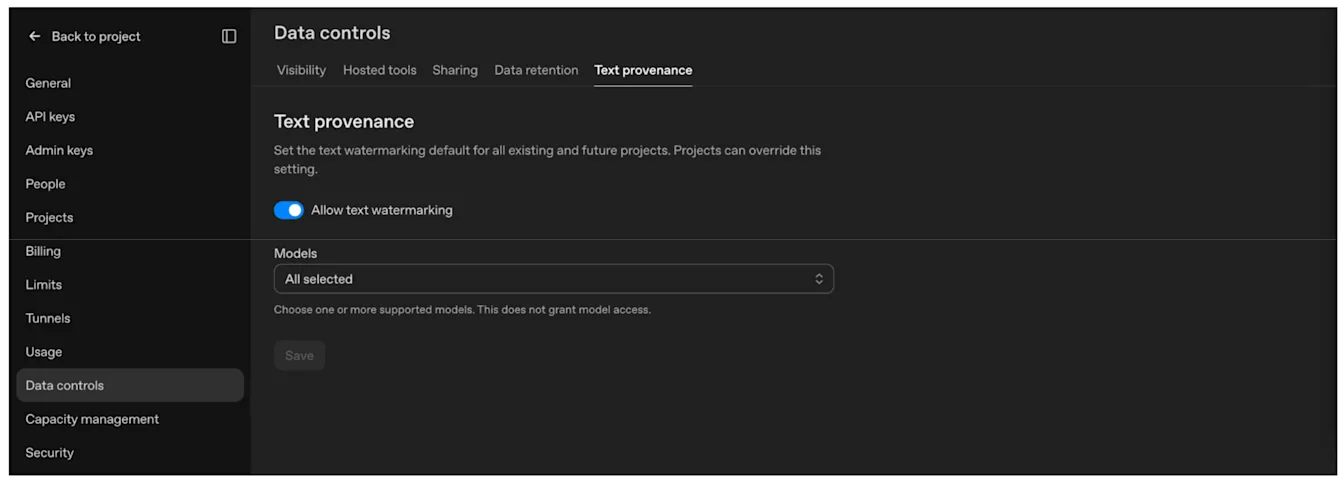
Замена на стандардната поставка за проект: одете во Поставки на проектот > Потекло на текстот.
За кои модели може да активирам водени жигови?
Во Поставки и Поставки на организацијата, корисниците може да го видат списокот со модели за кои моментално е достапно означување со воден жиг. Во наредните недели, поддршката ќе ја прошириме на сите постари модели.
Дали со вклучување на текстуалните водени жигови добивам и пристап до детекторот за текст?
Не. Пристапот до детекторот за текст во моментов е ограничен на одобрени истражувачки и академски организации што работат на подобрување на сигурноста и леснотијата на користење на водените жигови во текст, како и на појасно објаснување на технологијата и нејзините резултати. Ова е во согласност со нашите обврски според Кодексот на практики за транспарентност на содржината генерирана со ВИ во рамките на Законот за ВИ на ЕУ.
Дали сигналите ќе останат во содржината откако ќе ја изменам?
Можно е, но тоа зависи од сигналот и од промените што ќе ги направите.
За сликите и аудиодатотеките во поддржан формат, зачувајте оригинална копија и користете го API за потекло на содржината за да тестирате репрезентативни датотеки по уредувањето, конвертирањето и објавувањето. Кај сликите, отсекувањето, додавањето шум, конвертирањето во JPEG и правењето снимки од екранот може да го отежнат откривањето на сигналите. Може да тестирате текст на овој начин само ако вашата организација има одобрен пристап до детекторот за текст.
Кога форматот на датотеката и работниот процес го дозволуваат тоа, зачувајте ги постојните метаподатоци C2PA и вклучете Content Credentials во датотеките што ги создавате. Размислете и за додавање сопствени ознаки за информациите за потеклото да бидат потрајни или покорисни. За детали за имплементацијата, погледнете ја техничката документација за C2PA.
Кај текстот, водениот жиг е дел од изборот на зборови што го прави моделот. Ако ги задржите истите формулации, се очекува сигналот да остане при повторното користење на текстот, без дополнителна работа за интеграција. Значителното преработување, парафразирање или преведување може да ја намали веродостојноста на детекцијата. Дури ни непроменетиот текст не гарантира дека водениот жиг ќе може да се открие, особено кај кратки пасуси или текст во кој има малку простор за поинаков избор на зборови.
Пристапувам до моделите на OpenAI преку услуга во облак. Дали и тие резултати содржат сигнали за потекло?
Кај моделите на OpenAI достапни преку Azure, опфатот на водените жигови се разликува според моделот и модалитетот. За тековната достапност и опфат, контактирајте со Microsoft. Работиме на проширување на опфатот на сигналите за потекло и на резултатите што се дистрибуираат преку други услуги во облак.
Дали сигналите за потекло ги заменуваат видливите ознаки за ВИ или другите известувања?
Не. Водените жигови и метаподатоците C2PA даваат информации што софтверот може да ги прочита. Тие не ги заменуваат видливите ознаки, банери или други известувања што може да бидат задолжителни.
Дали ви е потребно дополнително известување зависи од тоа како и каде ја користите содржината. OpenAI не може да ве советува за вашите конкретни законски обврски; вашиот правен тим треба да ги процени барањата за вашата употреба.
Имам дополнителни прашања за Актот на ЕУ за ВИ
Испратете прашање за Актот на ЕУ за ВИ и ќе ви одговориме.