
കൂടുതൽ സുരക്ഷിതവും സുതാര്യവുമായ നിർമിതബുദ്ധി പരിസ്ഥിതിയോടുള്ള പ്രതിബദ്ധതയുടെ ഭാഗമായി, ഉള്ളടക്കം ഒരു OpenAI മോഡൽ ഉപയോഗിച്ച് സൃഷ്ടിച്ചതാണോ എന്ന് ആളുകൾക്ക് മനസ്സിലാക്കാൻ സഹായിക്കുന്ന ഉറവിടസൂചനകൾ OpenAI ഉപയോഗിക്കുന്നു.
ഉറവിടസൂചനകൾക്ക് ഉത്ഭവത്തെക്കുറിച്ചുള്ള ഉപകാരപ്രദമായ വിവരങ്ങൾ നൽകാനാകും. എന്നാൽ ഉള്ളടക്കം കൃത്യമാണെന്നോ മാറ്റം വരുത്താത്തതാണെന്നോ നിയമാനുസൃത ഉടമസ്ഥതയിലുള്ളതാണെന്നോ ശരിയായ സന്ദർഭത്തിലാണ് അവതരിപ്പിച്ചിരിക്കുന്നതെന്നോ അവ ഉറപ്പുനൽകുന്നില്ല.
OpenAI-യുടെ ഉത്ഭവ സൂചനകൾ
OpenAI ഏതെല്ലാം ഉറവിടസൂചനകളാണ് ഉപയോഗിക്കുന്നത്?
വ്യത്യസ്ത തരം ഉള്ളടക്കങ്ങൾക്ക് OpenAI വ്യത്യസ്ത ഉറവിടസൂചനകൾ ഉപയോഗിക്കുന്നു.
| ഉള്ളടക്കത്തിന്റെ തരം | ഉറവിടസൂചനകൾ | കുറിപ്പുകൾ |
|---|---|---|
| ചിത്രങ്ങൾ | ഉള്ളടക്ക സാക്ഷ്യപത്രങ്ങളും SynthID വാട്ടർമാർക്കുകളും | ChatGPT, Codex അല്ലെങ്കിൽ OpenAI API ഉപയോഗിച്ച് സൃഷ്ടിക്കുന്ന ചിത്രങ്ങളിൽ രണ്ട് സൂചനകളും ഉൾപ്പെടുന്നു. |
| ഓഡിയോ | SynthID വാട്ടർമാർക്കുകൾ | ChatGPT അല്ലെങ്കിൽ OpenAI API സൃഷ്ടിക്കുന്ന ഓഡിയോയിൽ, കേൾക്കാനാകാത്ത ഒരു വാട്ടർമാർക്ക് ഓഡിയോയിൽത്തന്നെ ഉൾച്ചേർത്തിരിക്കും. |
| ടെക്സ്റ്റ് | textGrain വാട്ടർമാർക്കുകൾ (യൂറോപ്യൻ യൂണിയനിൽ മാത്രം) | യൂറോപ്യൻ യൂണിയനിൽ, നിർമിതബുദ്ധി നിയമം പാലിക്കുന്നതിനായി ChatGPT സൃഷ്ടിക്കുന്ന ടെക്സ്റ്റിൽ മോഡൽ വാക്കുകൾ തിരഞ്ഞെടുക്കാൻ ഉപയോഗിക്കുന്ന ക്രമരാഹിത്യത്തിൽ അദൃശ്യമായ ഒരു മാറ്റം ഉൾപ്പെടുത്തുന്നു. ലോകമെമ്പാടുമുള്ള API ഉപഭോക്താക്കൾക്ക് പ്രോജക്റ്റ് അല്ലെങ്കിൽ സ്ഥാപന ക്രമീകരണങ്ങളിൽനിന്ന് ടെക്സ്റ്റ് ഔട്ട്പുട്ടുകൾക്കായി ടെക്സ്റ്റ് വാട്ടർമാർക്കുകൾ പ്രവർത്തനക്ഷമമാക്കാം. |
| വീഡിയോ | ഉള്ളടക്ക സാക്ഷ്യപത്രങ്ങൾ | Sora നിർത്തലാക്കിയിരിക്കുന്നു. കൂടുതലറിയുക. |
ഉൽപ്പന്നം, മോഡൽ, കയറ്റുമതി രീതി, ഫയൽ തരം, ഉള്ളടക്കം സൃഷ്ടിച്ച സമയം എന്നിവയനുസരിച്ച് പിന്തുണ വ്യത്യാസപ്പെട്ടേക്കാം. gpt-image-1, gpt-image-1.5, sora-2 എന്നിവയുൾപ്പെടെ ഉടൻ പിന്തുണ പിൻവലിക്കാൻ പദ്ധതിയിട്ടിരിക്കുന്ന മോഡലുകൾ ഒഴികെയുള്ളവയുടെ API ഔട്ട്പുട്ടുകൾക്ക് ഈ പിന്തുണ ലഭ്യമാണ്.
ചില ഉള്ളടക്ക തരങ്ങളിൽ ഒന്നിലധികം സൂചനകൾ ഉപയോഗിക്കുന്നത് എന്തുകൊണ്ടാണ്?
സാങ്കേതികമായി സാധ്യമാകുമ്പോൾ, പരസ്പരം പരിമിതികൾ നികത്താൻ കഴിയുന്നവിധം OpenAI മെറ്റാഡാറ്റയും വാട്ടർമാർക്കുകളും ഒരുമിച്ച് ഉപയോഗിക്കുന്നു. മെറ്റാഡാറ്റയിൽ വിശദമായ വിവരങ്ങൾ ഉൾക്കൊള്ളിക്കാനാകും. എന്നാൽ പ്ലാറ്റ്ഫോമുകൾ, തിരുത്തൽ ഉപകരണങ്ങൾ, ഫയൽ പരിവർത്തനങ്ങൾ എന്നിവ അത് നീക്കം ചെയ്തേക്കാം. വാട്ടർമാർക്കുകളിൽ സന്ദർഭവിവരങ്ങൾ കുറവായിരിക്കും. എന്നാൽ സൃഷ്ടിച്ച ഉള്ളടക്കത്തിൽത്തന്നെ ഉൾച്ചേർത്തിരിക്കുന്നതിനാൽ, മെറ്റാഡാറ്റ നീക്കം ചെയ്യുന്ന ചില രൂപാന്തരങ്ങൾക്കുശേഷവും അവ നിലനിന്നേക്കാം.
ഉള്ളടക്കത്തിലെ മാറ്റങ്ങളെ എത്രത്തോളം ചെറുക്കാൻ ഉത്ഭവ സൂചനകൾക്കാകും?
ചിത്രങ്ങൾക്കും ശബ്ദത്തിനുമുള്ള SynthID വാട്ടർമാർക്കുകളും പാഠത്തിനുള്ള textGrain വാട്ടർമാർക്കുകളും സാധാരണ മാറ്റങ്ങളെ ചെറുക്കാനാണ് രൂപകൽപ്പന ചെയ്തിരിക്കുന്നത്. ഉള്ളടക്കത്തിന്റെ തരം അനുസരിച്ച്, ചെറിയ തിരുത്തലുകൾ, പകർത്തി ഒട്ടിക്കൽ, മുറിച്ചൊതുക്കൽ, സ്ക്രീൻഷോട്ടുകൾ എന്നിവ ഇതിൽ ഉൾപ്പെടാം. ചിത്രം വലിയ തോതിൽ മുറിച്ചൊതുക്കുക, ഫയൽ ചുരുക്കുക, കാര്യമായി മാറ്റിപ്പറയുക, വിവർത്തനം ചെയ്യുക തുടങ്ങിയ വിപുലമായ മാറ്റങ്ങൾ വാട്ടർമാർക്ക് കണ്ടെത്താനാകാത്തതാക്കിയേക്കാം. വലിയ മാറ്റങ്ങൾക്കുശേഷം, ഫലത്തെ “OpenAI സൃഷ്ടിച്ചത്” എന്ന് വിശേഷിപ്പിക്കുന്നതിന്റെ പ്രസക്തിയും കുറഞ്ഞേക്കാം.
ഉള്ളടക്കത്തിന്റെ ഉത്ഭവവും ആധികാരികതയും ഉറപ്പാക്കാനുള്ള കൂട്ടായ്മ വികസിപ്പിച്ച ഉള്ളടക്ക സാക്ഷ്യപത്രങ്ങൾ, സ്ക്രീൻഷോട്ട് എടുക്കുകയോ ഫയൽ പരിവർത്തനം ചെയ്യുകയോ പോലുള്ള പതിവ് പ്രവർത്തനങ്ങളിലൂടെ നഷ്ടപ്പെട്ടേക്കാം. അവ നിലനിൽക്കുന്നുണ്ടെങ്കിൽ, വാട്ടർമാർക്ക് മാത്രം നൽകുന്നതിനെക്കാൾ കൂടുതൽ വിശദാംശങ്ങൾ ഫയലിന്റെ ഉത്ഭവത്തെയും ചരിത്രത്തെയും കുറിച്ച് നൽകാനാകും.
ഉള്ളടക്കത്തിലെ മാറ്റങ്ങൾക്കുശേഷവും ഉത്ഭവ വിവരങ്ങൾ നിലനിൽക്കാനുള്ള സാധ്യത വർധിപ്പിക്കാൻ, സാങ്കേതികമായി സാധ്യമാകുന്നിടത്ത് ഞങ്ങൾ രണ്ടു രീതികളും ഉപയോഗിക്കുന്നു.
എന്താണ് ഉള്ളടക്ക സാക്ഷ്യപത്രങ്ങൾ, അവ എന്ത് സാധ്യമാക്കുന്നു?
ഏത് ഉപകരണം എപ്പോൾ സൃഷ്ടിച്ചു എന്നതുപോലുള്ള, ഫയലിന്റെ ഉത്ഭവവും ചരിത്രവും സംബന്ധിച്ച വിവരങ്ങൾ ഉള്ളടക്ക സാക്ഷ്യപത്രങ്ങൾ ഫയലിനൊപ്പം ചേർക്കുന്നു. ഉള്ളടക്കത്തിന്റെ ഉത്ഭവവും ആധികാരികതയും ഉറപ്പാക്കാനുള്ള കൂട്ടായ്മയായ C2PA വികസിപ്പിച്ച ഒരു തുറന്ന മാനദണ്ഡമാണ് അവ ഉപയോഗിക്കുന്നത്. അതിനാലാണ് അവയെ ചിലപ്പോൾ “C2PA മെറ്റാഡാറ്റ” എന്ന് വിളിക്കുന്നത്.
ഉള്ളടക്കം എവിടെനിന്ന് വന്നുവെന്ന് സ്ഥിരീകരിക്കാൻ ഉള്ളടക്ക സാക്ഷ്യപത്രങ്ങൾ ആളുകളെ സഹായിക്കുന്നു. നിർമിതബുദ്ധി സൃഷ്ടിച്ച ഉള്ളടക്കത്തിൽ മാത്രമല്ല ഇവ ഉപയോഗിക്കുന്നത്: ക്യാമറ നിർമാതാക്കളും വാർത്താ സ്ഥാപനങ്ങളും മറ്റുള്ളവരും തങ്ങളുടെ മാധ്യമ ഉള്ളടക്കത്തിന്റെ ഉറവിടവും ചരിത്രവും സാക്ഷ്യപ്പെടുത്താൻ ഈ മാനദണ്ഡം ഉപയോഗിക്കുന്നു. C2PA-യെക്കുറിച്ച് കൂടുതലറിയുക.
എന്താണ് SynthID, അത് എന്ത് സാധ്യമാക്കുന്നു?
സൃഷ്ടിച്ച മാധ്യമ ഉള്ളടക്കത്തിലേക്ക് നേരിട്ട് ഒരു സൂചന ഉൾച്ചേർക്കുന്ന, ഗൂഗിൾ ഡീപ്മൈൻഡ് വികസിപ്പിച്ച അദൃശ്യ വാട്ടർമാർക്കിങ് സാങ്കേതികവിദ്യയാണ് SynthID. മെറ്റാഡാറ്റയിൽനിന്ന് വ്യത്യസ്തമായി, ഈ സൂചന ഉള്ളടക്കത്തിന്റെ ഭാഗം തന്നെയാണ്. ചില തിരുത്തലുകൾക്കോ രൂപാന്തരങ്ങൾക്കോ ശേഷവും അത് നിലനിന്നേക്കാം. C2PA മെറ്റാഡാറ്റയ്ക്കൊപ്പം SynthID അധികമായൊരു ഉത്ഭവ സൂചന നൽകുന്നു. ഉദാഹരണത്തിന്, ഒരു ഫയലിൽനിന്ന് മെറ്റാഡാറ്റ നീക്കിയാലും, ഉൾച്ചേർത്ത വാട്ടർമാർക്ക് ഉള്ളടക്കം പിന്തുണയ്ക്കുന്ന OpenAI ഉപകരണങ്ങൾ ഉപയോഗിച്ച് സൃഷ്ടിച്ചതാണെന്ന സൂചന നൽകിയേക്കാം. SynthID-യെക്കുറിച്ച് കൂടുതലറിയുക.
നിങ്ങൾ എന്തിനാണ് പാഠ ഫലങ്ങളിൽ വാട്ടർമാർക്ക് ചേർക്കുന്നത്?
ഇ.യു. നിർമിതബുദ്ധി നിയമം പാലിക്കുന്നതിനായും നിർമിതബുദ്ധി സൃഷ്ടിക്കുന്ന ഉള്ളടക്കത്തിന്റെ സുതാര്യതയ്ക്കായുള്ള ഇ.യു. പ്രവർത്തനച്ചട്ടപ്രകാരം ഞങ്ങൾ ഏറ്റെടുത്ത പ്രതിബദ്ധതകൾക്ക് അനുസൃതമായും, യൂറോപ്യൻ യൂണിയനിലെ ChatGPT ഉപയോക്താക്കൾക്കായി ഞങ്ങൾ പാഠ വാട്ടർമാർക്കിങ് നടപ്പാക്കുന്നു. OpenAI-യും മറ്റ് നിരവധി പ്രമുഖ നിർമിതബുദ്ധി സേവനദാതാക്കളും ഈ ചട്ടത്തിൽ ഒപ്പുവെച്ചിട്ടുണ്ട്.
എന്താണ് textGrain, അത് എന്ത് സാധ്യമാക്കുന്നു?
OpenAI-യുടെ പാഠ വാട്ടർമാർക്കിങ് സാങ്കേതികവിദ്യയാണ് textGrain. എഴുതുമ്പോൾ സാധ്യമായ വാക്കുകളിൽ നിന്നോ വാക്കുകളുടെ ഭാഗങ്ങളിൽ നിന്നോ മോഡൽ ക്രമരഹിതമായി തിരഞ്ഞെടുക്കുന്ന രീതിയിൽ ഇത് സൂക്ഷ്മമായ മാറ്റം വരുത്തുന്നു. ഒരു പാഠഭാഗത്തിലുടനീളം ഈ തിരഞ്ഞെടുപ്പുകൾ ഒരു ക്രമരൂപം സൃഷ്ടിക്കുന്നു. ചില തിരുത്തലുകൾക്കുശേഷവും തിരിച്ചറിയൽ സംവിധാനത്തിന് അത് കണ്ടെത്താനാകും.
വാട്ടർമാർക്ക് പാഠത്തിലെ വാക്കുകളുടെ ഭാഗം തന്നെയാണ്; വായനക്കാർക്ക് അത് ദൃശ്യമാകില്ല. ഇത് മറഞ്ഞിരിക്കുന്ന അക്ഷരങ്ങളോ അദൃശ്യ ഇടവിടങ്ങളോ അസാധാരണ വിരാമചിഹ്നങ്ങളോ ചേർക്കുന്നില്ല. സൃഷ്ടിച്ച പാഠം അടയാളപ്പെടുത്തണമെന്ന ഇ.യു. നിർമിതബുദ്ധി നിയമത്തിലെ വ്യവസ്ഥ പാലിക്കാൻ പാഠ വാട്ടർമാർക്കിങ് സഹായിക്കുന്നു.
OpenAI-യുടെ പരിശോധനാ ഉപകരണങ്ങൾ
ഉള്ളടക്കം OpenAI ഉപകരണങ്ങൾ ഉപയോഗിച്ച് സൃഷ്ടിച്ചതാണോ എന്ന് എങ്ങനെ പരിശോധിക്കാം?
പിന്തുണയ്ക്കുന്ന ഒരു ചിത്രത്തിലോ ഓഡിയോ ഫയലിലോ OpenAI ഉപകരണങ്ങൾ ഉപയോഗിച്ച് സൃഷ്ടിച്ചതോ കയറ്റുമതി ചെയ്തതോ ആയ ഉള്ളടക്കവുമായി ബന്ധപ്പെട്ട ഉറവിടസൂചനകൾ ഉണ്ടോ എന്ന് പരിശോധിക്കാൻ openai.com/verify സന്ദർശിക്കാം. പിന്തുണയ്ക്കുന്ന ഒരു ഫയൽ അപ്ലോഡ് ചെയ്താൽ, SynthID വാട്ടർമാർക്ക് അല്ലെങ്കിൽ OpenAI-യുമായി ബന്ധപ്പെട്ട വിശ്വസനീയമായ C2PA മാനിഫെസ്റ്റ് പോലുള്ള, പിന്തുണയ്ക്കുന്ന OpenAI ഉറവിടസൂചനകൾ ഉപകരണം തിരയും. പിന്തുണയ്ക്കുന്ന ഒരു OpenAI ഉറവിടസൂചന ഉപകരണം കണ്ടെത്തിയാൽ, ആ ഉള്ളടക്കം ഒരു OpenAI മോഡൽ സൃഷ്ടിച്ചതാകാൻ സാധ്യതയുണ്ടെന്ന് അത് സൂചിപ്പിക്കുന്നു.
ചിത്രങ്ങളിലും ഓഡിയോയിലും OpenAI ഉറവിടസൂചനകൾ പരിശോധിക്കാനും സ്വന്തം ആപ്ലിക്കേഷനുകളിലോ പ്രവർത്തനക്രമങ്ങളിലോ ഈ പരിശോധന ഉൾപ്പെടുത്താനും ഡെവലപ്പർമാർക്കും സ്ഥാപനങ്ങൾക്കും OpenAI-യുടെ ഉള്ളടക്ക ഉറവിട API ഉപയോഗിക്കാം. യോഗ്യമായ ഉപയോഗാവശ്യമുള്ള സ്ഥാപനങ്ങൾക്ക് പരിധികൾ ഉയർത്തുന്നതിനായി അപേക്ഷിക്കാം.
യൂറോപ്യൻ യൂണിയന്റെ നിർമിതബുദ്ധി നിയമപ്രകാരമുള്ള ഞങ്ങളുടെ ബാധ്യതകൾക്ക് അനുസൃതമായി, യോഗ്യമായ ഉപയോഗാവശ്യമുള്ള സ്ഥാപനങ്ങൾക്ക് ടെക്സ്റ്റ് കണ്ടെത്തൽ ഉപകരണം ഉപയോഗിക്കാനുള്ള അനുമതിക്കായി അപേക്ഷിക്കാം. ടെക്സ്റ്റിന്റെ ഉറവിടം, കണ്ടെത്തലിന്റെ വിശ്വാസ്യത, അല്ലെങ്കിൽ ഉറവിടപരിശോധനാ ഫലങ്ങൾ ആളുകൾ എങ്ങനെ മനസ്സിലാക്കുന്നു എന്നിവ പഠിക്കുന്ന വിദ്യാഭ്യാസ, ഗവേഷണ സ്ഥാപനങ്ങൾ ഇതിൽ ഉൾപ്പെടുന്നു. യോഗ്യതയുള്ള സ്ഥാപനങ്ങളുടെ അപേക്ഷകൾ ഞങ്ങൾ ഓരോന്നായി വിലയിരുത്തുകയും ഉചിതമായ രീതിയിൽ പുതിയ വിവരങ്ങൾ അറിയിക്കാനോ കൂടുതൽ വിവരങ്ങൾ ആവശ്യപ്പെടാനോ ബന്ധപ്പെടുകയും ചെയ്യും. കൂടുതൽ അറിവ് നേടുകയും സാങ്കേതികവിദ്യ മെച്ചപ്പെടുത്തുകയും ചെയ്യുന്നതിനനുസരിച്ച് പ്രവേശനാനുമതി നൽകുന്ന ഞങ്ങളുടെ സമീപനം മാറിയേക്കാം.
സാങ്കേതികവിദ്യയുടെ കഴിവുകളും പരിമിതികളും കൂടുതൽ നന്നായി മനസ്സിലാക്കാനും ടെക്സ്റ്റ് വാട്ടർമാർക്കിങ് മെച്ചപ്പെടുത്തുന്നതിനുള്ള അറിവ് നേടാനും ഞങ്ങൾ ഇപ്പോൾ ചെറിയൊരു ഗവേഷകസംഘവുമായി സഹകരിക്കുന്നു. കോർണെൽ സർവകലാശാലയിലെ കമ്പ്യൂട്ടർ സയൻസ് അസിസ്റ്റന്റ് പ്രൊഫസർ ജോൺ തിക്സ്റ്റൺ, ഇ.ടി.എച്ച്. സൂറിക്കിലെ കമ്പ്യൂട്ടർ സയൻസ് പ്രൊഫസറും ഇൻസൈറ്റിന്റെ ശാസ്ത്ര ഡയറക്ടറുമായ മാർട്ടിൻ വെച്ചേവ്, കെംപെലൻ ഇൻസ്റ്റിറ്റ്യൂട്ട് ഓഫ് ഇന്റലിജന്റ് ടെക്നോളജീസിലെ (കിനിറ്റ്) ഗവേഷകർ എന്നിവർ ഈ സംഘത്തിൽ ഉൾപ്പെടുന്നു.
ഉയർന്ന പരിശോധനാ പരിധികൾക്ക് ആർക്കാണ് യോഗ്യതയുള്ളത്, പരിശോധനകൾക്ക് നിരക്കുണ്ടോ?
ഉള്ളടക്ക ഉത്ഭവ എപിഐ പരിശോധനകൾ നിലവിൽ സൗജന്യമാണ്; അവയ്ക്ക് ഉപയോഗപരിധികൾ ബാധകമാണ്. വാർത്താമുറിയിലെ പരിശോധന, വസ്തുതാ പരിശോധന, ഉള്ളടക്ക ഉത്ഭവ ഗവേഷണം, നിയന്ത്രണ മേൽനോട്ടം തുടങ്ങിയ യോഗ്യമായ പൊതുതാൽപ്പര്യ ഉത്ഭവ പദ്ധതികളിലും വിവരങ്ങളുടെ വിശ്വാസ്യത ഉറപ്പാക്കുന്ന പ്രവർത്തനക്രമങ്ങളിലുമാണ് ഉയർന്ന പരിധികൾ നൽകുന്ന പദ്ധതി ശ്രദ്ധ കേന്ദ്രീകരിക്കുന്നത്.
വാണിജ്യ തട്ടിപ്പ് തടയൽ, ആധികാരികത ഉറപ്പാക്കൽ, സ്ഥിരീകരണം, അല്ലെങ്കിൽ ഉത്ഭവ പരിശോധനയും ഡാറ്റാ വിശകലനവും ചേർന്ന സേവനപ്പാക്കേജുകളുടെ ഭാഗമായി പുനർവിൽപ്പന നടത്തൽ തുടങ്ങിയ പൊതുവായ ബിസിനസ് ഉപയോഗങ്ങൾ പദ്ധതിയുടെ പരിധിക്ക് നിലവിൽ പുറത്താണ്.
യോഗ്യമായ ഉപയോഗാവശ്യമുള്ള സ്ഥാപനങ്ങൾക്ക് ഉയർന്ന പരിധികൾക്കായി അപേക്ഷിക്കാം. എന്നാൽ അപേക്ഷ സമർപ്പിക്കുന്നതുകൊണ്ട് അനുമതി ലഭിക്കുമെന്ന് ഉറപ്പില്ല. ചെറിയ വിലയിരുത്തലുകൾ ഉൾപ്പെടെയുള്ള ആവശ്യങ്ങൾക്ക് പൊതുവായ എപിഐ അതിന്റെ സ്ഥിരസ്ഥിതി പരിധികൾക്കുള്ളിൽ തുടർന്നും ലഭ്യമാണ്. നിലവിലെ ഉപയോഗപരിധികൾ അറിയാൻ ഉള്ളടക്ക ഉത്ഭവ എപിഐ രേഖകൾ പരിശോധിക്കുക.
പാഠ തിരിച്ചറിയൽ സംവിധാനം ഉപയോഗിക്കാൻ ആർക്കാണ് യോഗ്യതയുള്ളത്, പരിശോധനകൾക്ക് നിരക്കുണ്ടോ?
പാഠ തിരിച്ചറിയൽ പരിശോധനകൾ നിലവിൽ സൗജന്യമാണ്. പാഠത്തിന്റെ ഉത്ഭവം, തിരിച്ചറിയലിന്റെ വിശ്വാസ്യത, ഉത്ഭവ പരിശോധനാഫലങ്ങൾ ആളുകൾ എങ്ങനെ മനസ്സിലാക്കുന്നു എന്നിവ പഠിക്കുന്ന അക്കാദമിക, ഗവേഷണ സ്ഥാപനങ്ങളുടെ ഉപയോഗാവശ്യങ്ങൾ യോഗ്യമായവയിൽ ഉൾപ്പെടുന്നു.
വാണിജ്യ തട്ടിപ്പ് തടയൽ, ആധികാരികത ഉറപ്പാക്കൽ, സ്ഥിരീകരണം, അല്ലെങ്കിൽ ഉത്ഭവ പരിശോധനയും ഡാറ്റാ വിശകലനവും ചേർന്ന സേവനപ്പാക്കേജുകളുടെ ഭാഗമായി പുനർവിൽപ്പന നടത്തൽ തുടങ്ങിയ പൊതുവായ ബിസിനസ് ഉപയോഗങ്ങൾ പദ്ധതിയുടെ പരിധിക്ക് നിലവിൽ പുറത്താണ്.
വിദ്യാർഥികളുടെ രചനകളിൽ നിർമിതബുദ്ധി ഉപയോഗിച്ചിട്ടുണ്ടോ എന്ന് പരിശോധിക്കുന്നതുപോലുള്ള (ഉദാ. ഉപന്യാസങ്ങളോ പ്രബന്ധങ്ങളോ എഴുതുമ്പോൾ) അക്കാദമിക സത്യസന്ധത ഉറപ്പാക്കാനുള്ള ഉപയോഗങ്ങളും പദ്ധതിയുടെ പരിധിക്ക് നിലവിൽ പുറത്താണ്.
പരിശോധനാ ഫലങ്ങൾ എന്താണ് അർത്ഥമാക്കുന്നത്?
openai.com/verify അല്ലെങ്കിൽ OpenAI-യുടെ ഉള്ളടക്ക ഉറവിട API വഴി ഒരു സൂചന കണ്ടെത്തിയാൽ, അപ്ലോഡ് ചെയ്ത ഉള്ളടക്കത്തിൽ OpenAI-യുമായി ബന്ധപ്പെട്ട, പിന്തുണയ്ക്കുന്ന ഒരു ഉറവിടസൂചന ഉണ്ടെന്നാണ് അർത്ഥം. ഉള്ളടക്കം കൃത്യമാണെന്നോ മാറ്റം വരുത്താത്തതാണെന്നോ നിയമാനുസൃത ഉടമസ്ഥതയിലുള്ളതാണെന്നോ ശരിയായ സന്ദർഭത്തിലാണ് അവതരിപ്പിച്ചിരിക്കുന്നതെന്നോ ഈ ഉപകരണം സ്ഥിരീകരിക്കുന്നില്ല. ഉള്ളടക്കം ആരാണ് സൃഷ്ടിച്ചതെന്നോ എന്തിനാണ് സൃഷ്ടിച്ചതെന്നോ ഇത് തിരിച്ചറിയുന്നുമില്ല.
സൂചനയൊന്നും കണ്ടെത്തിയില്ലെങ്കിൽ, അപ്ലോഡ് ചെയ്ത ഫയലിൽ OpenAI നൽകിയ ഉറവിടസൂചനകൾ ഉപകരണത്തിന് കണ്ടെത്താനായില്ല എന്നാണ് അർത്ഥം. എങ്കിലും, താഴെപ്പറയുന്ന സാഹചര്യങ്ങളിൽ ആ ഉള്ളടക്കം OpenAI സൃഷ്ടിച്ചതോ കയറ്റുമതി ചെയ്തതോ ആയിരിക്കാം:
ഉറവിടസൂചനകൾ ലഭ്യമാകുന്നതിന് മുമ്പാണ് ഉള്ളടക്കം സൃഷ്ടിച്ചത്.
പിന്തുണയ്ക്കാത്ത ഉൽപ്പന്നം, മോഡൽ, കയറ്റുമതി രീതി അല്ലെങ്കിൽ ഫയൽ തരം വഴിയാണ് ഉള്ളടക്കം ലഭിച്ചത്.
അപ്ലോഡ്, ഡൗൺലോഡ്, എഡിറ്റിങ്, പരിവർത്തനം അല്ലെങ്കിൽ പങ്കിടൽ സമയത്ത് മെറ്റാഡാറ്റ നീക്കം ചെയ്യപ്പെട്ടു.
കംപ്രഷൻ, മുറിച്ചൊതുക്കൽ, നോയിസ്, എഡിറ്റിങ്, ഫോർമാറ്റ് മാറ്റം അല്ലെങ്കിൽ മറ്റ് പരിവർത്തനങ്ങൾ മൂലം വാട്ടർമാർക്കിന് കേടുപാടുകൾ സംഭവിച്ചു.
ഓഡിയോ ക്ലിപ്പിന്റെ ദൈർഘ്യം തീരെ കുറവാണ്, അല്ലെങ്കിൽ അതിൽ കാര്യമായ മാറ്റങ്ങൾ വരുത്തിയിട്ടുണ്ട്.
ഏറ്റവും വിശ്വസനീയമായ പരിശോധനാഫലം എങ്ങനെ നേടാം?
പിന്തുണയ്ക്കുന്ന ഫയലുകൾ ഒരേസമയം ഒന്ന് വീതം അപ്ലോഡ് ചെയ്യുക. സാധ്യമാകുമ്പോൾ, ആദ്യം കയറ്റുമതി ചെയ്ത അസൽ ഫയൽ ഉപയോഗിക്കുക. ചിത്രങ്ങൾ പരിശോധിക്കുന്നതിനുമുമ്പ് മുറിച്ചൊതുക്കുകയോ ഫയൽ പരിവർത്തനം ചെയ്യുകയോ ചെയ്യരുത്. ശബ്ദത്തിന്റെ കാര്യത്തിൽ, 10 മുതൽ 60 സെക്കൻഡ് വരെയുള്ള ഭാഗങ്ങളാണ് പൊതുവേ മികച്ച ഫലങ്ങൾ നൽകുന്നത്. സൂചനയൊന്നും കണ്ടെത്തിയില്ലെങ്കിലും, നിഗമനത്തിലെത്തുന്നതിനുമുമ്പ് ഫയലിന്റെ ഉറവിടവും സന്ദർഭവും പരിഗണിക്കുക.
ഫലങ്ങളിൽ എന്റെ പ്രോംപ്റ്റോ വ്യക്തിഗത വിവരങ്ങളോ കാണിക്കുമോ?
ഉത്ഭവ സൂചനകളിൽ ഉപയോക്താവിനെയോ സ്ഥാപനത്തെയോ പ്രോംപ്റ്റിനെയോ കുറിച്ചുള്ള വിശദാംശങ്ങൾ ഉൾപ്പെടുന്നില്ല.
openai.com/verify അല്ലെങ്കിൽ ഉള്ളടക്ക ഉറവിട API ഉപയോഗിച്ച് ഞാൻ പരിശോധിക്കുന്ന ഉള്ളടക്കത്തിന് എന്ത് സംഭവിക്കും?
openai.com/verify-ലേക്ക് അപ്ലോഡ് ചെയ്യുന്നതോ പരിശോധനയ്ക്കായി ഞങ്ങളുടെ ഉള്ളടക്ക ഉറവിട API-യിലേക്ക് സമർപ്പിക്കുന്നതോ ആയ ഉള്ളടക്കം, പിന്തുണയ്ക്കുന്ന ഉറവിടസൂചനകൾ പരിശോധിക്കാൻ മാത്രമാണ് പ്രോസസ് ചെയ്യുന്നത്. നിയമപരമായി ആവശ്യമായില്ലെങ്കിൽ ഉള്ളടക്കം സംഭരിക്കില്ല. OpenAI മോഡലുകളെ പരിശീലിപ്പിക്കാനും അത് ഉപയോഗിക്കില്ല.
മറ്റ് നിർമിതബുദ്ധി ഉപകരണങ്ങൾ സൃഷ്ടിച്ച ഉള്ളടക്കം OpenAI-ക്ക് തിരിച്ചറിയാനാകുമോ?
OpenAI മോഡലുകൾ സൃഷ്ടിച്ചതോ OpenAI ഉപകരണങ്ങൾ കയറ്റുമതി ചെയ്തതോ ആയ ഉള്ളടക്കവുമായി ബന്ധപ്പെട്ട, പിന്തുണയ്ക്കുന്ന ഉത്ഭവ സൂചനകൾ കണ്ടെത്താനാണ് ഞങ്ങളുടെ ഉള്ളടക്ക ഉത്ഭവ ഉപകരണങ്ങൾ രൂപകൽപ്പന ചെയ്തിരിക്കുന്നത്. മറ്റ് നിർമിതബുദ്ധി മോഡലുകൾ സൃഷ്ടിച്ച ഉള്ളടക്കം തിരിച്ചറിയാനല്ല അവ രൂപകൽപ്പന ചെയ്തിരിക്കുന്നത്. ബന്ധപ്പെട്ട സൂചന ഇല്ലാതിരിക്കുകയോ പിന്തുണയ്ക്കാത്തതാകുകയോ നശിച്ചുപോകുകയോ ചെയ്താൽ OpenAI സൃഷ്ടിച്ച ഉള്ളടക്കവും അവ തിരിച്ചറിയാതിരുന്നേക്കാം.
വാട്ടർമാർക്കിങ് പ്രവർത്തിക്കുന്ന വിധം
വാട്ടർമാർക്കുകൾ കർത്തൃത്വം, ഉടമസ്ഥാവകാശം, നിയമപരമായ ഉത്തരവാദിത്തം എന്നിവ നിർണയിക്കുമോ?
ഇല്ല. ഒരു OpenAI മോഡൽ ഉള്ളടക്കം സൃഷ്ടിക്കുകയോ പ്രോസസ് ചെയ്യുകയോ ചെയ്തിരിക്കാമെന്നതിന്റെ തെളിവാണ് വാട്ടർമാർക്ക്. ഉള്ളടക്കം ആരാണ് രചിച്ചതെന്നോ അതിന്റെ ഉടമ ആരാണെന്നോ വെളിപ്പെടുത്തൽ ആവശ്യമായിരുന്നോ എന്നോ നിയമപരമായി ആരാണ് ഉത്തരവാദിയെന്നോ അത് മാത്രം അടിസ്ഥാനമാക്കി നിർണയിക്കാനാവില്ല. ഉപയോക്താവ് അപ്ലോഡ് ചെയ്ത ഉള്ളടക്കം മോഡൽ തിരുത്തുകയായിരുന്നോ എന്നും അത് വ്യക്തമാക്കില്ല.
ഒരു OpenAI മോഡൽ എത്രത്തോളം പങ്കുവഹിച്ചുവെന്ന് വാട്ടർമാർക്കുകൾ സൂചിപ്പിക്കുമോ?
ഇല്ല. വാട്ടർമാർക്ക് കണ്ടെത്തിയോ ഇല്ലയോ എന്നാണ് തിരിച്ചറിയൽ സംവിധാനം അറിയിക്കുന്നത്. ഒരു വാട്ടർമാർക്ക് കണ്ടെത്തുന്നത്, OpenAI മോഡൽ ഉള്ളടക്കം സൃഷ്ടിക്കുകയോ പ്രോസസ് ചെയ്യുകയോ ചെയ്തിരിക്കാമെന്നതിന്റെ തെളിവാണ്. എന്നാൽ ഉള്ളടക്കത്തിന്റെ ഒരു ഭാഗമാണോ മുഴുവനാണോ മോഡൽ സൃഷ്ടിച്ചതെന്നോ മനുഷ്യന്റെ സംഭാവന എത്രത്തോളമുണ്ടെന്നോ അത് വ്യക്തമാക്കില്ല.
പാഠ വാട്ടർമാർക്കിങ് എങ്ങനെയാണ് പ്രവർത്തിക്കുന്നത്?
മോഡൽ എഴുതുമ്പോൾ “ടോക്കണുകൾ” എന്ന് വിളിക്കുന്ന വാക്കുകളും വാക്കുകളുടെ ഭാഗങ്ങളും തിരഞ്ഞെടുക്കുന്നതിൽ പാഠ വാട്ടർമാർക്കിങ് ഒരു രഹസ്യ ക്രമരൂപം സൃഷ്ടിക്കുന്നു.
ഓരോ ഘട്ടത്തിലും, അടുത്തതായി വരാവുന്ന ഓരോ ടോക്കണിനും മോഡൽ ഒരു സാധ്യതാമൂല്യം നൽകുന്നു. ആ സാധ്യതാമൂല്യങ്ങളിൽ മാറ്റം വരുത്തി വാട്ടർമാർക്കിങ് സംവിധാനം നിരവധി കൂട്ടങ്ങൾ സൃഷ്ടിക്കുന്നു. ഓരോ കൂട്ടവും ഒരു രഹസ്യ കീ അനുസരിച്ച് വ്യത്യസ്ത തിരഞ്ഞെടുപ്പുകൾക്ക് മുൻഗണന നൽകുന്നു. എല്ലാ കൂട്ടങ്ങളുടെയും ശരാശരി എടുത്താൽ മോഡലിന്റെ യഥാർഥ സാധ്യതാമൂല്യങ്ങളുമായി ഒത്തുവരുന്നവിധമാണ് അവ സന്തുലിതമാക്കിയിരിക്കുന്നത്. ഏത് കൂട്ടം ഉപയോഗിക്കണമെന്ന് കീ തിരഞ്ഞെടുക്കുന്നു. തുടർന്ന് മോഡൽ ആ കൂട്ടത്തിൽനിന്ന് പുതുതായി ഒരു ക്രമരഹിത തിരഞ്ഞെടുപ്പ് നടത്തുന്നു.
അതേ കീയും അനുയോജ്യമായ ക്രമീകരണങ്ങളുമുള്ള തിരിച്ചറിയൽ സംവിധാനത്തിന്, യാദൃച്ഛികമായി പ്രതീക്ഷിക്കാവുന്നതിനെക്കാൾ കൂടുതൽ തവണ പാഠം ആ രഹസ്യ ക്രമരൂപം പിന്തുടരുന്നുണ്ടോ എന്ന് പിന്നീട് പരിശോധിക്കാം.
വസ്തുതാപരമായ പാഠത്തിലും ഉപയോക്താവ് നൽകിയ പാഠത്തിലും വാട്ടർമാർക്കുകൾ ബാധകമാണോ?
ഒരേ കാര്യം പറയാൻ മോഡലിന് വ്യത്യസ്ത വഴികൾ ഉണ്ടെന്നതിനെ ആശ്രയിച്ചാണ് പാഠ വാട്ടർമാർക്കിങ് പ്രവർത്തിക്കുന്നത്. ഒരു ഗണിതപ്രശ്നത്തിന്റെ ഉത്തരം പോലെ മറുപടി വളരെ വസ്തുതാപരമോ കൃത്യമോ ആയിരിക്കേണ്ടപ്പോഴും, നൽകിയ പാഠം മാറ്റമില്ലാതെ പുനരാവിഷ്കരിക്കാൻ മോഡലിനോട് ആവശ്യപ്പെടുമ്പോഴും ഈ വഴക്കം കുറവായിരിക്കും. ഇത്തരം സന്ദർഭങ്ങളിൽ, പ്രകടമായ വ്യത്യാസം വരുത്താതെ വാക്കുകൾ മാറ്റാൻ മോഡലിന് അധികം അവസരമില്ല. അതിനാൽ വാട്ടർമാർക്ക് കണ്ടെത്താൻ കഴിഞ്ഞേക്കില്ല.
ഹ്രസ്വ ഉത്തരങ്ങളിലും കോഡിലും പാഠ വാട്ടർമാർക്കുകൾ ബാധകമാണോ?
വാട്ടർമാർക്ക് വിശ്വസനീയമായി കണ്ടെത്താൻ വേണ്ടത്ര പാഠം ചെറിയ ഭാഗങ്ങളിൽ സാധാരണയായി ഉണ്ടാകില്ല. സാധാരണ ഗദ്യത്തെ അപേക്ഷിച്ച് അടുത്തതായി വരാവുന്നവയ്ക്കുള്ള സാധ്യതകൾ കുറവായതിനാൽ കോഡിലും വാട്ടർമാർക്ക് ചേർക്കുക പ്രയാസമാണ്.
ഈ പരിമിതികൾ കണക്കിലെടുത്ത്, നിർമിതബുദ്ധി സൃഷ്ടിക്കുന്ന ഉള്ളടക്കത്തിന്റെ സുതാര്യതയ്ക്കായുള്ള ഇ.യു. നിർമിതബുദ്ധി നിയമത്തിന്റെ പ്രവർത്തനച്ചട്ടം, 200 ടോക്കണിൽ താഴെയുള്ള ഫലങ്ങളിൽ—ഇംഗ്ലീഷിൽ ഏകദേശം 150 വാക്കുകൾ—അല്ലെങ്കിൽ കോഡ് ഭാഗങ്ങളിൽ വാട്ടർമാർക്ക് നിർബന്ധമാക്കുന്നില്ല.
പാഠ വാട്ടർമാർക്ക് തിരിച്ചറിയൽ ഭാഷയ്ക്കനുസരിച്ച് എങ്ങനെ വ്യത്യാസപ്പെടുന്നു?
തിരിച്ചറിയൽ നിരക്കുകൾ ഭാഷയ്ക്കനുസരിച്ച് വ്യത്യാസപ്പെടുന്നു. നിലവിൽ ചില ഭാഷകളിൽ മറ്റുള്ളവയെക്കാൾ എളുപ്പത്തിൽ വാട്ടർമാർക്ക് കണ്ടെത്താനാകും. സൂചന ദുർബലമായ ഭാഷകളിൽ തിരിച്ചറിയൽ മെച്ചപ്പെടുത്താൻ വാട്ടർമാർക്കിന്റെ ശക്തി ക്രമീകരിക്കാൻ ഞങ്ങൾക്കാകും.
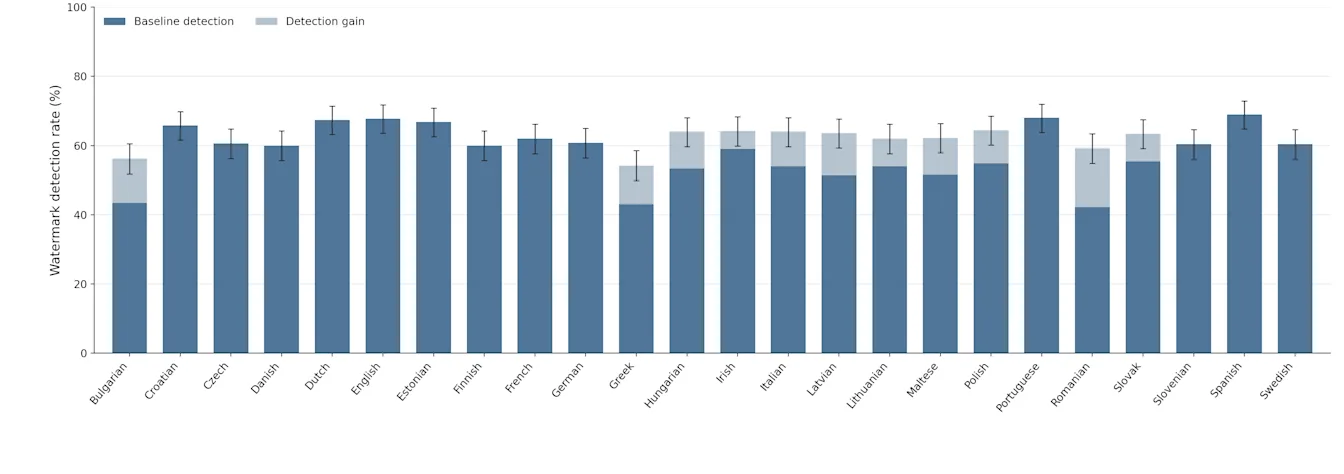
ഈ ചാർട്ട് യൂറോപ്യൻ യൂണിയന്റെ 24 ഔദ്യോഗിക ഭാഷകളിലെയും തിരിച്ചറിയൽ നിരക്ക് വിലയിരുത്തുന്നു. വൈവിധ്യമാർന്ന വിഷയങ്ങൾ ഉൾക്കൊള്ളുന്ന 500 ഇംഗ്ലീഷ് പ്രോംപ്റ്റുകൾ ഞങ്ങൾ ആദ്യം കൃത്രിമമായി സൃഷ്ടിച്ചു. തുടർന്ന് അവ മറ്റ് 23 ഭാഷകളിലേക്ക് വിവർത്തനം ചെയ്തു. ഇല്ലാത്ത വാട്ടർമാർക്ക് ഉണ്ടെന്ന് തെറ്റായി കണ്ടെത്തുന്ന നിരക്ക് 1% ആയി നിശ്ചയിക്കുമ്പോൾ, സ്പാനിഷിലാണ് ഏറ്റവും ഉയർന്ന തിരിച്ചറിയൽ നിരക്ക് (69.0%); റൊമാനിയനിലാണ് ഏറ്റവും കുറവ് (42.2%). ഞങ്ങളുടെ വാട്ടർമാർക്കിന്റെ ശക്തി ക്രമീകരിക്കാവുന്ന ഒരു പരാമീറ്റർ ഉണ്ട്—വ്യത്യസ്ത മേഖലകൾക്കായി വാട്ടർമാർക്ക് സൂചന ശക്തമാക്കാനോ ദുർബലമാക്കാനോ കഴിയുന്ന ഒരു “നിയന്ത്രണച്ചക്രം”. ഈ നിയന്ത്രണം ഉപയോഗിച്ച്, തിരിച്ചറിയൽ നിരക്ക് 60%-ൽ താഴെയുള്ള ഭാഷകളിൽ ശക്തി വർധിപ്പിക്കാൻ ഞങ്ങൾക്ക് കഴിഞ്ഞു; അതിലൂടെ ഉണ്ടായ മെച്ചപ്പെടലാണ് ചാർട്ടിലെ ദണ്ഡുകളുടെ ഇളംനീല ഭാഗങ്ങൾ കാണിക്കുന്നത്.
പാഠ വാട്ടർമാർക്കുകൾ മോഡലിന്റെ ഗുണനിലവാരം കുറയ്ക്കുമോ?
ഞങ്ങളുടെ പരീക്ഷണങ്ങൾ പ്രകാരം, ഇല്ല. ഞങ്ങളുടെ ഏറ്റവും പുതിയ അത്യാധുനിക മോഡലായ Astra-യെ വിലയിരുത്താൻ ഉപയോഗിക്കുന്ന മാനദണ്ഡങ്ങളിലെല്ലാം, വാട്ടർമാർക്കിങ് ഉള്ളപ്പോഴും ഇല്ലാത്തപ്പോഴും പ്രകടനത്തിലുണ്ടാകുന്ന വ്യത്യാസങ്ങൾ, ആവർത്തിച്ചുള്ള വിലയിരുത്തലുകളിൽ സാധാരണ കാണുന്ന യാദൃച്ഛിക വ്യതിയാനങ്ങളുടെ പരിധിക്കുള്ളിലാണ്. ChatGPT-യിൽ മുമ്പ് നടത്തിയ പരീക്ഷണങ്ങളിലും വാട്ടർമാർക്കിങ് അവതരിപ്പിച്ചതിനെത്തുടർന്ന് പ്രതികൂല പ്രതികരണ നിരക്കുകളിലോ ഉൽപ്പന്നത്തിന്റെ മറ്റ് അളവുകോലുകളിലോ മാറ്റമൊന്നും കണ്ടില്ല.
പാഠ വാട്ടർമാർക്കുകൾ മോഡലിന്റെ വേഗം കുറയ്ക്കുമോ?
ഞങ്ങളുടെ മോഡലുകളുടെ വേഗത്തിൽ പാഠ വാട്ടർമാർക്കിങ് ചെലുത്തുന്ന സ്വാധീനം നിസ്സാരമാണ്.
OpenAI-യുടെ ടെക്സ്റ്റ് വാട്ടർമാർക്കുകൾ മൂന്നാംകക്ഷി നിർമിതബുദ്ധി കണ്ടെത്തൽ ഉപകരണങ്ങളിൽനിന്ന് എങ്ങനെ വ്യത്യാസപ്പെട്ടിരിക്കുന്നു?
പാൻഗ്രാം പോലുള്ള മൂന്നാംകക്ഷി കണ്ടെത്തൽ ഉപകരണങ്ങൾ സാധാരണയായി വാക്കുകളുടെ തിരഞ്ഞെടുപ്പ് പോലുള്ള പാറ്റേണുകളിൽനിന്ന് നിർമിതബുദ്ധി സൃഷ്ടിച്ച ടെക്സ്റ്റ് തിരിച്ചറിയാൻ വർഗീകരണ സംവിധാനങ്ങൾ ഉപയോഗിക്കുന്നു. ഉൾച്ചേർത്ത ഒരു സൂചന കണ്ടെത്തുന്നതിനുപകരം, സൃഷ്ടിച്ചുകഴിഞ്ഞ ടെക്സ്റ്റ് വിശകലനം ചെയ്യുകയാണ് ആ സമീപനം. സൃഷ്ടിക്കുന്ന ടെക്സ്റ്റിൽ ഒരു സൂചന ഉൾച്ചേർക്കണമെന്ന് യൂറോപ്യൻ യൂണിയന്റെ നിർമിതബുദ്ധി നിയമം വ്യക്തമായി ആവശ്യപ്പെടുന്നു.
TextSeal അല്ലെങ്കിൽ SynthID ഉപയോഗിക്കുന്നതിനുപകരം സ്വന്തം പാഠ വാട്ടർമാർക്കുകൾ ഉപയോഗിക്കുന്നത് എന്തുകൊണ്ടാണ്?
വാട്ടർമാർക്ക് കണ്ടെത്താനാകുന്നതും ഒരേ പ്രോംപ്റ്റിൽനിന്ന് വൈവിധ്യമാർന്ന മറുപടികൾ സൃഷ്ടിക്കുന്നതും തമ്മിലുള്ള സന്തുലനം നിയന്ത്രിക്കാൻ SynthID അല്ലെങ്കിൽ TextSeal നൽകുന്നതിനെക്കാൾ കൂടുതൽ സ്വാതന്ത്ര്യം ലഭിക്കുന്നതിനാണ് textGrain എന്ന സ്വന്തം പാഠ വാട്ടർമാർക്കിങ് രീതി ഞങ്ങൾ വികസിപ്പിച്ചത്. ഞങ്ങളുടെ പരീക്ഷണങ്ങളിൽ, വാട്ടർമാർക്ക് ചേർത്ത പാഠ സാമ്പിളുകൾ ശരിയായി തിരിച്ചറിഞ്ഞതിന്റെ നിരക്ക്, പാഠത്തിനായുള്ള SynthID-യുടേതിന് തുല്യമോ അതിലും കൂടുതലോ ആയിരുന്നു. മറ്റുള്ളവർക്ക് അതിനെ അടിസ്ഥാനമാക്കി കൂടുതൽ വികസനങ്ങൾ നടത്താനും പാഠ വാട്ടർമാർക്കിങ് മെച്ചപ്പെടുത്താൻ സഹായിക്കാനുമായി textGrain തുറന്ന സോഴ്സ് കോഡുള്ള സാങ്കേതികവിദ്യയായി പുറത്തിറക്കാൻ ഞങ്ങൾ പദ്ധതിയിടുന്നു.
പാഠ വാട്ടർമാർക്കിങ് മറഞ്ഞിരിക്കുന്ന അക്ഷരങ്ങളോ അധിക ടോക്കണുകളോ ദൃശ്യമായ മാറ്റങ്ങളോ ചേർക്കുമോ?
ഇല്ല. പാഠ വാട്ടർമാർക്കിങ് വാക്കുതിരഞ്ഞെടുപ്പിന്റെ സ്ഥിതിവിവരപരമായ ക്രമരൂപം മാറ്റുന്നു; മറഞ്ഞിരിക്കുന്ന അക്ഷരങ്ങളോ വാട്ടർമാർക്കിനുവേണ്ടി മാത്രമുള്ള ടോക്കണുകളോ ചേർക്കുന്നില്ല. വാട്ടർമാർക്ക് വായനക്കാർക്ക് ദൃശ്യമല്ല. പാഠം പകർത്തി ഒട്ടിക്കുമ്പോൾ മറഞ്ഞിരിക്കുന്ന ഉള്ളടക്കം ഒന്നും ചേർക്കപ്പെടുകയുമില്ല.
ഉപഭോക്താക്കൾക്കുള്ള മാർഗനിർദേശങ്ങൾ
ഞാൻ ഒരു API ഉപഭോക്താവാണ്. ടെക്സ്റ്റ് വാട്ടർമാർക്കുകൾ എങ്ങനെ പ്രവർത്തനക്ഷമമാക്കാം?
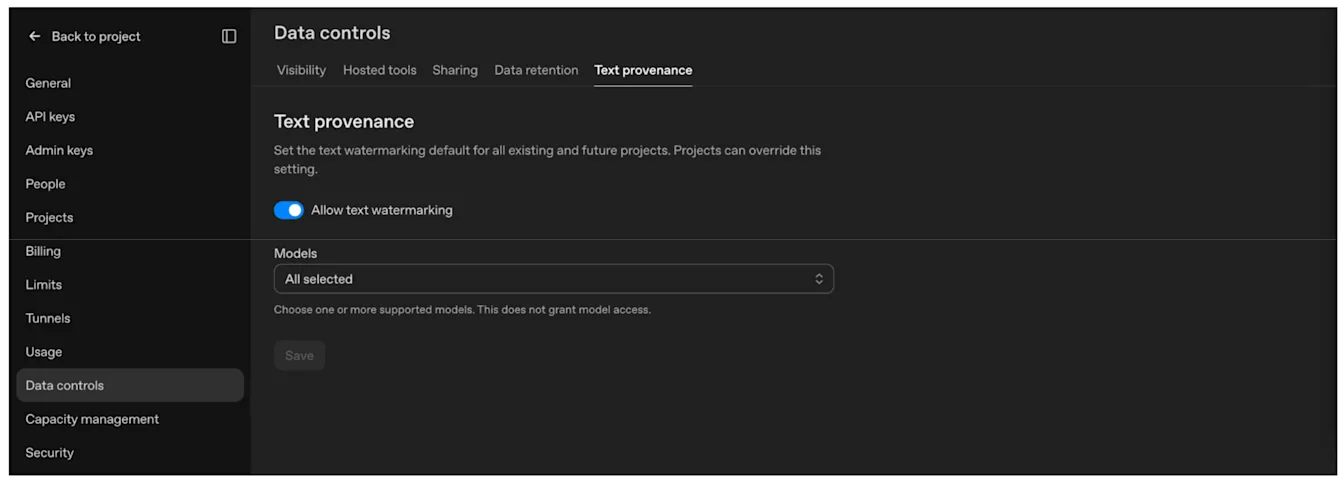
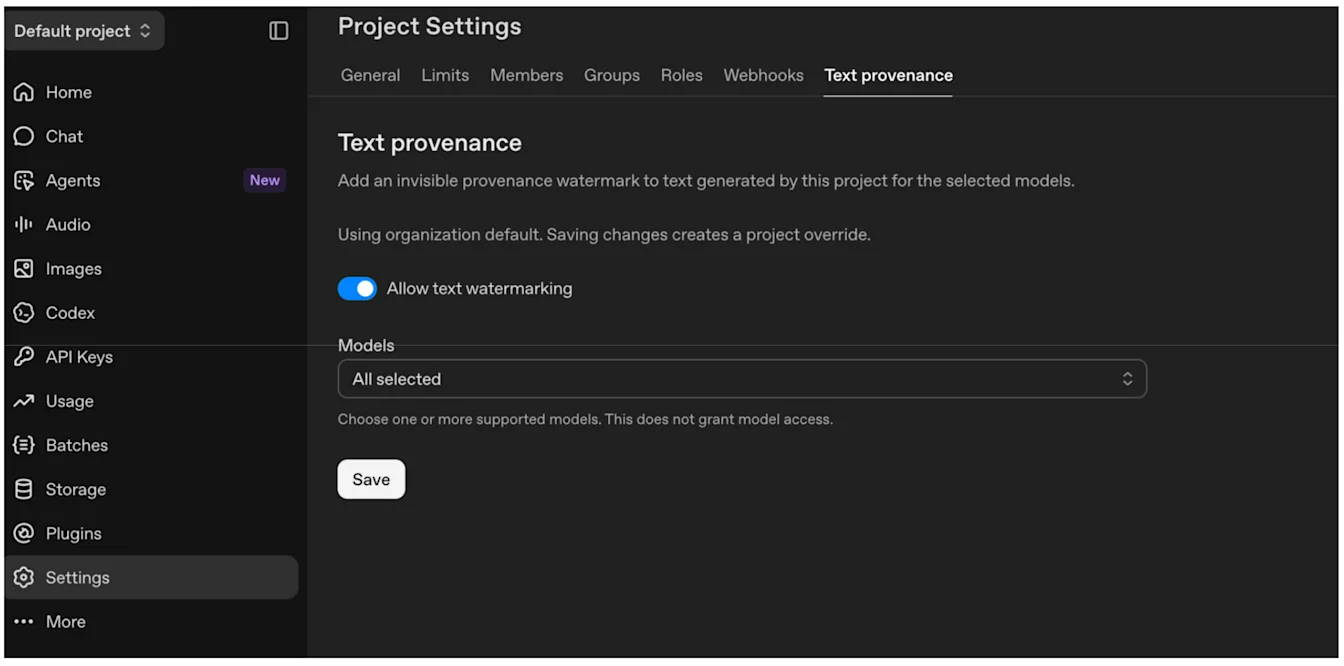
OpenAI API ഉപഭോക്താക്കൾക്ക് ക്രമീകരണങ്ങൾ വഴി ഒരു പ്രത്യേക പ്രോജക്റ്റിനോ സ്ഥാപന ക്രമീകരണങ്ങൾ വഴി സ്ഥാപനം മുഴുവനായോ ടെക്സ്റ്റ് വാട്ടർമാർക്കിങ് സജീവമാക്കാം. രണ്ടു സാഹചര്യങ്ങളിലും, ഏതൊക്കെ മോഡലുകൾക്ക് ടെക്സ്റ്റ് വാട്ടർമാർക്ക് നൽകണമെന്ന് ഉപഭോക്താക്കൾക്ക് തിരഞ്ഞെടുക്കാം. പിന്തുണയ്ക്കുന്ന ഒരു മോഡലിനായി ഇത് പ്രവർത്തനക്ഷമമാക്കിയാൽ, ടെക്സ്റ്റ് സൃഷ്ടിക്കുമ്പോൾ OpenAI വാട്ടർമാർക്ക് ചേർക്കും. ഓരോ മറുപടിക്കും ഉപഭോക്താക്കൾ പ്രത്യേകം അടയാളം ചേർക്കേണ്ടതില്ല.
ടെക്സ്റ്റ് വാട്ടർമാർക്കിങ് അനുവദിക്കുക പ്രവർത്തനക്ഷമമാക്കുക, മോഡലുകൾ തിരഞ്ഞെടുക്കുക, തുടർന്ന് സംരക്ഷിക്കുക തിരഞ്ഞെടുക്കുക.
സ്ഥാപനത്തിന്റെ അടിസ്ഥാന ക്രമീകരണം: സ്ഥാപന ക്രമീകരണങ്ങൾ > ഡാറ്റ നിയന്ത്രണങ്ങൾ എന്നതിലേക്ക് പോകുക.
ടെക്സ്റ്റിന്റെ ഉറവിടം തിരഞ്ഞെടുക്കുക.
പ്രോജക്റ്റിനായി ക്രമീകരണം മാറ്റാൻ: പ്രോജക്റ്റ് ക്രമീകരണങ്ങൾ > ടെക്സ്റ്റിന്റെ ഉറവിടം എന്നതിലേക്ക് പോകുക.
ഏതെല്ലാം മോഡലുകൾക്കായി എനിക്ക് വാട്ടർമാർക്കുകൾ സജീവമാക്കാം?
നിലവിൽ വാട്ടർമാർക്കിങ് ലഭ്യമായ മോഡലുകളുടെ പട്ടിക ഉപഭോക്താക്കൾക്ക് ക്രമീകരണങ്ങൾ, സ്ഥാപന ക്രമീകരണങ്ങൾ എന്നിവയിൽ കാണാം. വരും ആഴ്ചകളിൽ, എല്ലാ പഴയ മോഡലുകളിലേക്കും ഞങ്ങൾ ഈ പിന്തുണ വ്യാപിപ്പിക്കും.
പാഠ വാട്ടർമാർക്കുകൾ പ്രവർത്തനക്ഷമമാക്കുമ്പോൾ പാഠ തിരിച്ചറിയൽ സംവിധാനം ഉപയോഗിക്കാനും അനുമതി ലഭിക്കുമോ?
ഇല്ല. പാഠ വാട്ടർമാർക്കിങ്ങിന്റെ വിശ്വാസ്യതയും ഉപയോഗസൗകര്യവും മെച്ചപ്പെടുത്താനും സാങ്കേതികവിദ്യയും അതിന്റെ ഫലങ്ങളും കൂടുതൽ വ്യക്തമായി വിശദീകരിക്കാനും പ്രവർത്തിക്കുന്ന, അംഗീകൃത ഗവേഷണ-അക്കാദമിക സ്ഥാപനങ്ങൾക്ക് മാത്രമാണ് നിലവിൽ പാഠ തിരിച്ചറിയൽ സംവിധാനം ഉപയോഗിക്കാൻ അനുമതിയുള്ളത്. നിർമിതബുദ്ധി സൃഷ്ടിക്കുന്ന ഉള്ളടക്കത്തിന്റെ സുതാര്യതയ്ക്കായുള്ള ഇ.യു. നിർമിതബുദ്ധി നിയമത്തിന്റെ പ്രവർത്തനച്ചട്ടപ്രകാരം ഞങ്ങൾ ഏറ്റെടുത്ത പ്രതിബദ്ധതകൾക്ക് അനുസൃതമാണിത്.
ഉള്ളടക്കത്തിൽ മാറ്റം വരുത്തിയാലും സൂചനകൾ അതിൽ നിലനിൽക്കുമോ?
നിലനിന്നേക്കാം. എന്നാൽ അത് സൂചനയെയും നിങ്ങൾ വരുത്തുന്ന മാറ്റങ്ങളെയും ആശ്രയിച്ചിരിക്കും.
പിന്തുണയ്ക്കുന്ന ചിത്രങ്ങളുടെയും ഓഡിയോയുടെയും അസൽ പകർപ്പ് സൂക്ഷിക്കുക. എഡിറ്റിങ്, പരിവർത്തനം, പ്രസിദ്ധീകരണം എന്നിവയ്ക്കുശേഷം പ്രതിനിധി സാമ്പിളുകളായ ഫയലുകൾ പരിശോധിക്കാൻ ഉള്ളടക്ക ഉറവിട API ഉപയോഗിക്കുക. ചിത്രങ്ങൾ മുറിച്ചൊതുക്കുക, നോയിസ് ചേർക്കുക, JPEG-ലേക്ക് മാറ്റുക, സ്ക്രീൻഷോട്ടുകൾ എടുക്കുക എന്നിവ സൂചനകൾ കണ്ടെത്തുന്നത് കൂടുതൽ ബുദ്ധിമുട്ടാക്കിയേക്കാം. നിങ്ങളുടെ സ്ഥാപനത്തിന് ടെക്സ്റ്റ് കണ്ടെത്തൽ ഉപകരണം ഉപയോഗിക്കാനുള്ള അംഗീകൃത അനുമതി ഉണ്ടെങ്കിൽ മാത്രമേ ഈ രീതിയിൽ ടെക്സ്റ്റ് പരിശോധിക്കാനാകൂ.
നിങ്ങളുടെ ഫയൽ ഫോർമാറ്റും പ്രവർത്തനക്രമവും പിന്തുണയ്ക്കുന്നിടത്ത്, നിലവിലുള്ള C2PA മെറ്റാഡാറ്റ നിലനിർത്തുകയും നിങ്ങൾ സൃഷ്ടിക്കുന്ന ഫയലുകളിൽ ഉള്ളടക്ക സാക്ഷ്യപത്രങ്ങൾ ഉൾപ്പെടുത്തുകയും ചെയ്യുക. ഉറവിടവിവരങ്ങൾ കൂടുതൽ കാലം നിലനിൽക്കുന്നതിനോ കൂടുതൽ ഉപയോഗപ്രദമാക്കുന്നതിനോ സ്വന്തം അടയാളങ്ങൾ ചേർക്കുന്നതും പരിഗണിക്കാം. നടപ്പാക്കുന്നതിന്റെ വിശദാംശങ്ങൾക്ക് C2PA സാങ്കേതിക രേഖകൾ കാണുക.
ടെക്സ്റ്റിൽ, മോഡൽ വാക്കുകൾ തിരഞ്ഞെടുക്കുന്ന രീതിയുടെ ഭാഗമാണ് വാട്ടർമാർക്ക്. വാക്കുകൾ മാറ്റാതെ ടെക്സ്റ്റ് വീണ്ടും ഉപയോഗിച്ചാൽ, അധിക സംയോജന നടപടികളൊന്നും കൂടാതെ സൂചന നിലനിൽക്കുമെന്നാണ് പ്രതീക്ഷിക്കുന്നത്. വലിയ തോതിലുള്ള പുനരെഴുത്ത്, ആശയം മറ്റു വാക്കുകളിൽ അവതരിപ്പിക്കൽ, വിവർത്തനം എന്നിവ കണ്ടെത്തലിന്റെ വിശ്വാസ്യത കുറച്ചേക്കാം. വാക്കുകൾ മാറ്റിയില്ലെങ്കിൽപ്പോലും, കണ്ടെത്താനാകുന്ന വാട്ടർമാർക്ക് ഉണ്ടാകുമെന്ന് ഉറപ്പില്ല. പ്രത്യേകിച്ച് ചെറിയ ഖണ്ഡികകളിലോ വ്യത്യസ്ത വാക്കുകൾ തിരഞ്ഞെടുക്കാൻ അധികം സാധ്യതയില്ലാത്ത ടെക്സ്റ്റിലോ.
ഞാൻ ഒരു ക്ലൗഡ് സേവനത്തിലൂടെയാണ് OpenAI-യുടെ മോഡലുകൾ ഉപയോഗിക്കുന്നത്. അവയുടെ ഔട്ട്പുട്ടുകളിലും ഉറവിടസൂചനകൾ ഉണ്ടാകുമോ?
ചിത്രം, ഓഡിയോ, ടെക്സ്റ്റ് എന്നിവയുൾപ്പെടെ യോഗ്യമായ എല്ലാ ഔട്ട്പുട്ടുകളിലും വാട്ടർമാർക്കുകൾ അടക്കമുള്ള ഉറവിടസൂചനകൾ ഉൾച്ചേർക്കുന്നുണ്ടെന്ന് ഉറപ്പാക്കാൻ ഞങ്ങളുടെ എല്ലാ ക്ലൗഡ്, വിതരണ സേവനദാതാക്കളുമായും ഞങ്ങൾ പ്രവർത്തിക്കുന്നു. ഔട്ട്പുട്ടും പങ്കാളിയും അനുസരിച്ച് ലഭ്യത വ്യത്യാസപ്പെട്ടേക്കാം.
ദൃശ്യമായ നിർമിതബുദ്ധി ലേബലുകൾക്കോ മറ്റ് വെളിപ്പെടുത്തലുകൾക്കോ പകരമാകുമോ ഉത്ഭവ സൂചനകൾ?
ഇല്ല. വാട്ടർമാർക്കുകളും C2PA മെറ്റാഡാറ്റയും സോഫ്റ്റ്വെയറിന് വായിക്കാനാകുന്ന വിവരങ്ങളാണ് നൽകുന്നത്. അവ നിർബന്ധമായേക്കാവുന്ന ദൃശ്യ ലേബലുകൾക്കോ ബാനറുകൾക്കോ മറ്റ് അറിയിപ്പുകൾക്കോ പകരമല്ല.
അധിക വെളിപ്പെടുത്തൽ വേണമോ എന്നത് നിങ്ങൾ ഉള്ളടക്കം എങ്ങനെ, എവിടെ ഉപയോഗിക്കുന്നു എന്നതിനെ ആശ്രയിച്ചിരിക്കുന്നു. നിങ്ങളുടെ പ്രത്യേക നിയമപരമായ ബാധ്യതകളെക്കുറിച്ച് OpenAI-ക്ക് ഉപദേശം നൽകാനാകില്ല; നിങ്ങളുടെ ഉപയോഗത്തിന് ബാധകമായ ആവശ്യകതകൾ നിങ്ങളുടെ നിയമവിഭാഗം വിലയിരുത്തണം.
യൂറോപ്യൻ യൂണിയന്റെ നിർമിതബുദ്ധി നിയമവുമായി ബന്ധപ്പെട്ട് എനിക്ക് കൂടുതൽ ചോദ്യങ്ങളുണ്ട്
യൂറോപ്യൻ യൂണിയന്റെ നിർമിതബുദ്ധി നിയമത്തെക്കുറിച്ചുള്ള അന്വേഷണം സമർപ്പിക്കുക. ഞങ്ങൾ നിങ്ങളെ ബന്ധപ്പെടാം.