
ပိုမိုလုံခြုံ၍ ပွင့်လင်းမြင်သာသော AI ဝန်းကျင်တစ်ခု ဖော်ဆောင်ရန် ကတိကဝတ်၏ တစ်စိတ်တစ်ပိုင်းအဖြစ် OpenAI သည် အကြောင်းအရာကို OpenAI မော်ဒယ်ဖြင့် ဖန်တီးထားခြင်း ဟုတ်မဟုတ် လူများ နားလည်နိုင်ရန် မူလရင်းမြစ်ညွှန်ပြချက်များကို အသုံးပြုပါသည်။
မူလရင်းမြစ်ညွှန်ပြချက်များသည် မူလရင်းမြစ်အကြောင်း အသုံးဝင်သော အချက်အလက်များ ပေးနိုင်သော်လည်း အကြောင်းအရာ မှန်ကန်ကြောင်း၊ မပြင်ဆင်ထားကြောင်း၊ တရားဝင်ပိုင်ဆိုင်ကြောင်း သို့မဟုတ် မှန်ကန်သော နောက်ခံအခြေအနေဖြင့် တင်ပြထားကြောင်း အာမခံမပေးနိုင်ပါ။
OpenAI ၏ မူလရင်းမြစ်ညွှန်ပြချက်များ
OpenAI က ဘယ်မူလရင်းမြစ်ညွှန်ပြချက်တွေကို အသုံးပြုသလဲ။
OpenAI သည် အကြောင်းအရာအမျိုးအစားအလိုက် မတူညီသော မူလရင်းမြစ်ညွှန်ပြချက်များကို အသုံးပြုပါသည်။
| အကြောင်းအရာအမျိုးအစား | မူလရင်းမြစ်ညွှန်ပြချက်များ | မှတ်ချက်များ |
|---|---|---|
| ရုပ်ပုံများ | အကြောင်းအရာအထောက်အထားများနှင့် SynthID ရေစာများ | ChatGPT၊ Codex သို့မဟုတ် OpenAI API ဖြင့် ဖန်တီးထားသော ရုပ်ပုံများတွင် ညွှန်ပြချက်နှစ်မျိုးလုံး ပါဝင်ပါသည်။ |
| အသံ | SynthID ရေစာများ | ChatGPT သို့မဟုတ် OpenAI API က ဖန်တီးထားသော အသံတွင် နားဖြင့်မကြားနိုင်သော ရေစာကို အသံအတွင်း၌ပင် မြှုပ်နှံထည့်သွင်းထားပါသည်။ |
| စာသား | textGrain ရေစာများ (EU တွင်သာ) | EU တွင် EU AI ဥပဒေကို လိုက်နာရန် ChatGPT ဖန်တီးစာသား၌ မော်ဒယ်၏ စကားလုံးရွေးချယ်မှုတွင် အသုံးပြုသော ကျပန်းဖြစ်မှုကို မမြင်သာစွာ ပြောင်းလဲထားပါသည်။ ကမ္ဘာတစ်ဝန်းရှိ API သုံးစွဲသူများသည် ၎င်းတို့၏ ပရောဂျက် သို့မဟုတ် အဖွဲ့အစည်းဆက်တင်များမှ စာသားရလဒ်များအတွက် စာသားရေစာထည့်သွင်းမှုကို ဖွင့်နိုင်ပါသည်။ |
| ဗီဒီယို | အကြောင်းအရာအထောက်အထားများ | Sora ကို ရပ်ဆိုင်းလိုက်ပါပြီ။ ပိုမိုလေ့လာရန်။ |
ပံ့ပိုးမှုသည် ထုတ်ကုန်၊ မော်ဒယ်၊ ဖိုင်ထုတ်ယူသည့်နည်းလမ်း၊ ဖိုင်အမျိုးအစားနှင့် အကြောင်းအရာ ဖန်တီးသည့်အချိန်အလိုက် ကွာခြားနိုင်ပါသည်။ gpt-image-1၊ gpt-image-1.5 နှင့် sora-2 အပါအဝင် မကြာမီ အသုံးပြုမှုရပ်ဆိုင်းရန် စီစဉ်ထားသော မော်ဒယ်များမှအပ API ရလဒ်များကို ပံ့ပိုးထားပါသည်။
အကြောင်းအရာအမျိုးအစားအချို့တွင် ဘာကြောင့် ညွှန်ပြချက် အမျိုးမျိုး သုံးသလဲ။
နည်းပညာအရ ဖြစ်နိုင်သည့်အခါ OpenAI သည် မက်တာဒေတာနှင့် ရေစာများကို ပေါင်းစပ်အသုံးပြုကာ တစ်ခု၏ ကန့်သတ်ချက်များကို နောက်တစ်ခုက ဖြည့်ဆည်းပေးစေပါသည်။ မက်တာဒေတာတွင် အသေးစိတ်အချက်အလက်များ ပါဝင်နိုင်သော်လည်း ပလက်ဖောင်းများ၊ တည်းဖြတ်ကိရိယာများနှင့် ဖိုင်ပုံစံပြောင်းခြင်းတို့ကြောင့် ၎င်းတို့ ဖယ်ရှားခံရနိုင်ပါသည်။ ရေစာများတွင် နောက်ခံအချက်အလက် ပိုနည်းသော်လည်း ဖန်တီးထားသော အကြောင်းအရာထဲ၌ပင် မြှုပ်နှံထည့်သွင်းထားသောကြောင့် မက်တာဒေတာကို ဖယ်ရှားသွားစေသည့် ပြောင်းလဲမှုအချို့ပြီးနောက်၌ပင် ကျန်ရှိနေနိုင်ပါသည်။
အကြောင်းအရာကို ပြင်ဆင်ပြောင်းလဲသည့်အခါ မူလရင်းမြစ်ညွှန်ပြချက်များက ဘယ်လောက် ခံနိုင်ရည်ရှိသလဲ။
ရုပ်ပုံနှင့် အသံအတွက် SynthID ရေစာများနှင့် စာသားအတွက် textGrain ရေစာများကို ပုံမှန်ပြောင်းလဲမှုများအောက်တွင် ခံနိုင်ရည်ရှိစေရန် ဒီဇိုင်းရေးဆွဲထားပါသည်။ အကြောင်းအရာအမျိုးအစားပေါ် မူတည်၍ ၎င်းတို့တွင် အနည်းငယ်ပြင်ဆင်ခြင်း၊ ကူးယူကူးထည့်ခြင်း၊ ဖြတ်တောက်ခြင်း သို့မဟုတ် စခရင်ရှော့ရိုက်ခြင်းတို့ ပါဝင်နိုင်ပါသည်။ ပုံကို အများအပြား ဖြတ်တောက်ခြင်း၊ ဖိုင်ချုံ့ခြင်း၊ အသုံးအနှုန်း အများအပြား ပြန်ဆိုခြင်း သို့မဟုတ် ဘာသာပြန်ခြင်းကဲ့သို့ ပိုကြီးမားသော ပြောင်းလဲမှုများက ရေစာကို ရှာဖွေမတွေ့ရှိနိုင်အောင် ဖြစ်စေနိုင်ပါသည်။ အများအပြား ပြောင်းလဲပြီးနောက် ရလဒ်ကို “OpenAI က ဖန်တီးထားသည်” ဟု ဖော်ပြခြင်းမှာလည်း အဓိပ္ပာယ်သိပ်မရှိတော့နိုင်ပါ။
အကြောင်းအရာ၏ မူလရင်းမြစ်နှင့် စစ်မှန်မှုဆိုင်ရာ ပူးပေါင်းအဖွဲ့က ဖော်ဆောင်ထားသည့် အကြောင်းအရာအထောက်အထားများသည် စခရင်ရှော့ရိုက်ခြင်း သို့မဟုတ် ဖိုင်ပုံစံပြောင်းခြင်းကဲ့သို့ နေ့စဉ်လုပ်ဆောင်မှုများကြောင့် ပျောက်ဆုံးနိုင်ပါသည်။ ၎င်းတို့ ဆက်လက်ရှိနေပါက ရေစာတစ်ခုတည်းထက် ဖိုင်၏ မူလရင်းမြစ်နှင့် မှတ်တမ်းအကြောင်း ပိုမိုအသေးစိတ် ဖော်ပြပေးနိုင်ပါသည်။
နည်းပညာအရ ဖြစ်နိုင်သည့်အခါ အကြောင်းအရာ ပြောင်းလဲပြီးနောက် မူလရင်းမြစ်ဆိုင်ရာ အချက်အလက် ပိုမိုကျန်ရှိနိုင်စေရန် နည်းလမ်းနှစ်မျိုးလုံးကို ကျွန်ုပ်တို့ အသုံးပြုပါသည်။
အကြောင်းအရာအထောက်အထားများ ဆိုတာ ဘာလဲ၊ ဘာတွေ လုပ်ဆောင်ပေးနိုင်သလဲ။
အကြောင်းအရာအထောက်အထားများသည် ဖိုင်တစ်ခု၏ မူလရင်းမြစ်နှင့် မှတ်တမ်းဆိုင်ရာ အချက်အလက်များကို ပူးတွဲပေးပါသည်။ ဥပမာ မည်သည့်ကိရိယာဖြင့် မည်သည့်အချိန်၌ ဖန်တီးခဲ့သည်ဆိုသော အချက်များဖြစ်ပါသည်။ ၎င်းတို့သည် အကြောင်းအရာ၏ မူလရင်းမြစ်နှင့် စစ်မှန်မှုဆိုင်ရာ ပူးပေါင်းအဖွဲ့ (C2PA) က ဖော်ဆောင်ထားသော အများသုံးစံနှုန်းကို အသုံးပြုသည့်အတွက် တစ်ခါတစ်ရံ “C2PA မက်တာဒေတာ” ဟုလည်း ခေါ်ဆိုကြပါသည်။
အကြောင်းအရာအထောက်အထားများသည် အကြောင်းအရာ မည်သည့်နေရာမှ လာသည်ကို လူများ အတည်ပြုစစ်ဆေးနိုင်ရန် ကူညီပေးပါသည်။ AI ဖန်တီးအကြောင်းအရာအတွက်သာ အသုံးပြုခြင်းမဟုတ်ပါ။ ကင်မရာထုတ်လုပ်သူများ၊ သတင်းအဖွဲ့အစည်းများနှင့် အခြားသူများကလည်း မိမိတို့၏ မီဒီယာဖိုင်များ၏ ရင်းမြစ်နှင့် မှတ်တမ်းကို အတည်ပြုပေးရန် ဤစံနှုန်းကို အသုံးပြုကြပါသည်။ C2PA အကြောင်း ပိုမိုလေ့လာရန်။
SynthID ဆိုတာ ဘာလဲ၊ ဘာတွေ လုပ်ဆောင်ပေးနိုင်သလဲ။
SynthID သည် Google DeepMind က ဖော်ဆောင်ထားသည့် မမြင်နိုင်သော ရေစာထည့်သွင်းနည်းပညာဖြစ်ပြီး ဖန်တီးထားသော မီဒီယာအတွင်း ညွှန်ပြချက်တစ်ခုကို တိုက်ရိုက် မြှုပ်နှံထည့်သွင်းပေးပါသည်။ မက်တာဒေတာနှင့် မတူဘဲ ညွှန်ပြချက်သည် အကြောင်းအရာ၏ တစ်စိတ်တစ်ပိုင်းဖြစ်ပြီး ပြင်ဆင်မှု သို့မဟုတ် ပြောင်းလဲမှုအချို့ပြီးနောက်၌ပင် ကျန်ရှိနေနိုင်ပါသည်။ SynthID သည် C2PA မက်တာဒေတာနှင့်အတူ နောက်ထပ် မူလရင်းမြစ်ညွှန်ပြချက်တစ်ခုကို ပေးပါသည်။ ဥပမာ ဖိုင်တစ်ခုမှ မက်တာဒေတာကို ဖယ်ရှားလိုက်သော်လည်း မြှုပ်နှံထည့်သွင်းထားသော ရေစာက ထိုအကြောင်းအရာကို ပံ့ပိုးထားသော OpenAI ကိရိယာများဖြင့် ဖန်တီးထားကြောင်း ဆက်လက်ညွှန်ပြနိုင်ပါသည်။ SynthID အကြောင်း ပိုမိုလေ့လာရန်။
ဘာကြောင့် စာသားရလဒ်များတွင် ရေစာထည့်သွင်းသလဲ။
EU AI ဥပဒေကို လိုက်နာရန်နှင့် OpenAI အပါအဝင် အဓိက AI ဝန်ဆောင်မှုပေးသူအချို့ လက်မှတ်ရေးထိုးထားသည့် EU ၏ AI ဖန်တီးအကြောင်းအရာ ပွင့်လင်းမြင်သာမှုဆိုင်ရာ ကျင့်ထုံးအောက်ရှိ ကျွန်ုပ်တို့၏ ကတိကဝတ်များနှင့်အညီ EU ရှိ ChatGPT အသုံးပြုသူများအတွက် စာသားရေစာထည့်သွင်းမှုကို အကောင်အထည်ဖော်နေပါသည်။
textGrain ဆိုတာ ဘာလဲ၊ ဘာတွေ လုပ်ဆောင်ပေးနိုင်သလဲ။
textGrain သည် OpenAI ၏ စာသားရေစာထည့်သွင်းသည့် နည်းပညာဖြစ်ပါသည်။ မော်ဒယ်က စာရေးနေစဉ် ဖြစ်နိုင်သော စကားလုံးများ သို့မဟုတ် စကားလုံးအစိတ်အပိုင်းများကို ကျပန်းရွေးချယ်ပုံအား မသိသာစွာ ချိန်ညှိပေးပါသည်။ စာပိုဒ်တစ်ခုအတွင်းရှိ ထိုရွေးချယ်မှုများက ပုံစံတစ်ခုကို ဖြစ်ပေါ်စေပြီး ပြင်ဆင်မှုအချို့ ပြုလုပ်ပြီးနောက်၌ပင် ရှာဖွေရေးကိရိယာက ထိုပုံစံကို ရှာဖွေနိုင်ပါသည်။
ရေစာသည် စာသားအသုံးအနှုန်း၏ တစ်စိတ်တစ်ပိုင်းဖြစ်ပြီး ဖတ်ရှုသူများအနေဖြင့် မြင်နိုင်မည်မဟုတ်ပါ။ ဝှက်ထားသော အက္ခရာများ၊ မမြင်နိုင်သော နေရာလွတ်များ သို့မဟုတ် ပုံမှန်မဟုတ်သော ပုဒ်ဖြတ်ပုဒ်ရပ်များကို ထပ်ထည့်ခြင်းမရှိပါ။ စာသားရေစာထည့်သွင်းခြင်းသည် ဖန်တီးထားသော စာသားကို အမှတ်အသားပြုရမည့် EU AI ဥပဒေပါ သတ်မှတ်ချက်ကို လိုက်နာနိုင်ရန် အထောက်အကူပြုပါသည်။
OpenAI ၏ အတည်ပြုစစ်ဆေးရေးကိရိယာများ
အကြောင်းအရာတစ်ခုကို OpenAI ကိရိယာများဖြင့် ဖန်တီးထားသလားဆိုတာ ဘယ်လိုစစ်ဆေးနိုင်သလဲ။
ပံ့ပိုးထားသော ရုပ်ပုံ သို့မဟုတ် အသံဖိုင်တွင် OpenAI ကိရိယာများဖြင့် ဖန်တီးထားသော သို့မဟုတ် ထုတ်ယူထားသော အကြောင်းအရာနှင့် ဆက်စပ်သည့် မူလရင်းမြစ်ညွှန်ပြချက်များ ပါဝင်ခြင်းရှိမရှိ စစ်ဆေးရန် openai.com/verify သို့ ဝင်ရောက်နိုင်ပါသည်။ ပံ့ပိုးထားသော ဖိုင်တစ်ခုကို အပ်လုဒ်တင်ပြီးနောက် ကိရိယာသည် SynthID ရေစာ သို့မဟုတ် OpenAI နှင့် ဆက်စပ်သော ယုံကြည်စိတ်ချရသည့် C2PA ပရိုဂရမ်အချက်အလက်ဖိုင်ကဲ့သို့ ပံ့ပိုးထားသော OpenAI မူလရင်းမြစ်ညွှန်ပြချက်များကို ရှာဖွေပါမည်။ ကိရိယာက ပံ့ပိုးထားသော OpenAI မူလရင်းမြစ်ညွှန်ပြချက်ကို တွေ့ရှိပါက ထိုအကြောင်းအရာကို OpenAI မော်ဒယ်တစ်ခုက ဖန်တီးထားဖွယ်ရှိကြောင်း ညွှန်ပြပါသည်။
ဆော့ဖ်ဝဲရေးသားသူများနှင့် အဖွဲ့အစည်းများသည် ရုပ်ပုံနှင့် အသံများတွင် OpenAI မူလရင်းမြစ်ညွှန်ပြချက်များ ရှိမရှိ စစ်ဆေးရန်နှင့် မိမိတို့၏ အက်ပ်များ သို့မဟုတ် လုပ်ငန်းစဉ်များတွင် အတည်ပြုစစ်ဆေးခြင်းကို ပေါင်းစပ်ထည့်သွင်းရန် OpenAI ၏ Content Provenance API ကိုလည်း အသုံးပြုနိုင်ပါသည်။ သတ်မှတ်ချက်နှင့် ကိုက်ညီသည့် အသုံးပြုမှုရှိသော အဖွဲ့အစည်းများသည် သုံးစွဲခွင့်ပမာဏ တိုးမြှင့်ရန် လျှောက်ထားနိုင်ပါသည်။
စာသားအတွက်မူ EU AI ဥပဒေအရ ကျွန်ုပ်တို့၏ တာဝန်များနှင့်အညီ သတ်မှတ်ချက်နှင့် ကိုက်ညီသည့် အသုံးပြုမှုရှိသော အဖွဲ့အစည်းများသည် စာသားရှာဖွေရေးကိရိယာကို သုံးစွဲခွင့်ရရန် လျှောက်ထားနိုင်ပါသည်။ ဥပမာအားဖြင့် စာသား၏ မူလရင်းမြစ်၊ ရှာဖွေတွေ့ရှိမှု၏ ယုံကြည်စိတ်ချရမှု သို့မဟုတ် မူလရင်းမြစ်ဆိုင်ရာ ရလဒ်များကို လူတို့ နားလည်ပုံအား လေ့လာနေသော ပညာရေးနှင့် သုတေသနအဖွဲ့အစည်းများ ဖြစ်ပါသည်။ အရည်အချင်းပြည့်မီသော အဖွဲ့အစည်းများ၏ လျှောက်လွှာများကို တစ်ခုချင်းစီ စိစစ်ပြီး သင့်လျော်သလို အခြေအနေအသစ်များကို အသိပေးခြင်း သို့မဟုတ် ထပ်ဆောင်းအချက်အလက် တောင်းခံခြင်းတို့ဖြင့် ဆက်သွယ်ပါမည်။ ပိုမိုလေ့လာသိရှိလာပြီး နည်းပညာကို ပိုမိုကောင်းမွန်အောင် ပြုလုပ်လာသည်နှင့်အမျှ သုံးစွဲခွင့်ပေးသည့် ကျွန်ုပ်တို့၏ နည်းလမ်းမှာ ပြောင်းလဲလာနိုင်ပါသည်။
နည်းပညာ၏ စွမ်းဆောင်နိုင်မှုများနှင့် ကန့်သတ်ချက်များကို ပိုမိုနားလည်ရန်နှင့် စာသားရေစာထည့်သွင်းမှုကို ပိုမိုကောင်းမွန်အောင် ပြုလုပ်ရာတွင် အထောက်အကူဖြစ်စေရန် လက်ရှိ၌ သုတေသီအနည်းစုနှင့် ကျွန်ုပ်တို့ ပူးပေါင်းဆောင်ရွက်နေပါသည်။ ၎င်းတို့တွင် Cornell တက္ကသိုလ်မှ ကွန်ပျူတာသိပ္ပံ လက်ထောက်ပါမောက္ခ John Thickstun၊ ETH Zurich မှ ကွန်ပျူတာသိပ္ပံပါမောက္ခနှင့် INSAIT ၏ သိပ္ပံဆိုင်ရာ ဒါရိုက်တာ Martin Vechev တို့အပြင် Kempelen ဉာဏ်ရည်နည်းပညာသိပ္ပံ (KInIT) မှ သုတေသီများ ပါဝင်ပါသည်။
ဘယ်သူတွေ ပိုများသော အတည်ပြုစစ်ဆေးခွင့်ပမာဏကို ရနိုင်သလဲ၊ စစ်ဆေးမှုများအတွက် ငွေကောက်ခံသလား။
Content Provenance API ဖြင့် စစ်ဆေးမှုများသည် လက်ရှိတွင် အခမဲ့ဖြစ်ပြီး သုံးစွဲမှုပမာဏ ကန့်သတ်ချက်များ ရှိပါသည်။ သုံးစွဲခွင့်ပမာဏ တိုးမြှင့်ပေးသည့် အစီအစဉ်သည် သတ်မှတ်ချက်နှင့် ကိုက်ညီသော အများအကျိုးပြု မူလရင်းမြစ်ဆိုင်ရာ ပရောဂျက်များနှင့် သတင်းအချက်အလက် မှန်ကန်ခိုင်မာမှုဆိုင်ရာ လုပ်ငန်းစဉ်များကို အဓိကထားပါသည်။ ဥပမာ သတင်းခန်းများ၏ အတည်ပြုစစ်ဆေးမှု၊ အချက်အလက်မှန်ကန်မှု စစ်ဆေးခြင်း၊ အကြောင်းအရာမူလရင်းမြစ် သုတေသနနှင့် စည်းမျဉ်းဆိုင်ရာ ကြီးကြပ်မှုတို့ ဖြစ်ပါသည်။
စီးပွားရေးဆိုင်ရာ လိမ်လည်မှုတားဆီးရေး၊ စစ်မှန်မှုစစ်ဆေးရေးနှင့် အတည်ပြုစစ်ဆေးရေး သို့မဟုတ် မူလရင်းမြစ်နှင့် ဒေတာဆန်းစစ်ရေး ဝန်ဆောင်မှုအစုများ၏ အစိတ်အပိုင်းအဖြစ် ပြန်လည်ရောင်းချခြင်းကဲ့သို့ သာမန်စီးပွားရေးအသုံးချမှုများသည် အစီအစဉ်၏ အကျုံးဝင်မှုတွင် လက်ရှိ မပါဝင်ပါ။
သတ်မှတ်ချက်နှင့် ကိုက်ညီသည့် အသုံးပြုမှုရှိသော အဖွဲ့အစည်းများသည် သုံးစွဲခွင့်ပမာဏ တိုးမြှင့်ရန် လျှောက်ထားနိုင်ပါသည်။ သို့သော် လျှောက်လွှာတင်ခြင်းက ခွင့်ပြုချက်ရမည်ဟု အာမခံမပေးပါ။ အများသုံး API ကို မူလသတ်မှတ်ထားသော သုံးစွဲခွင့်ပမာဏအတွင်း ဆက်လက်အသုံးပြုနိုင်ပြီး အသေးစားအကဲဖြတ်မှုများအတွက်လည်း အသုံးပြုနိုင်ပါသည်။ လက်ရှိ သုံးစွဲမှုပမာဏ ကန့်သတ်ချက်များအတွက် Content Provenance API လမ်းညွှန်စာတမ်းကို ကြည့်ပါ။
ဘယ်သူတွေ စာသားရှာဖွေရေးကိရိယာ သုံးစွဲခွင့်ရနိုင်သလဲ၊ စစ်ဆေးမှုများအတွက် ငွေကောက်ခံသလား။
စာသားရှာဖွေရေးကိရိယာဖြင့် စစ်ဆေးမှုများသည် လက်ရှိတွင် အခမဲ့ဖြစ်ပါသည်။ သတ်မှတ်ချက်နှင့် ကိုက်ညီသည့် အသုံးပြုမှုများတွင် စာသား၏ မူလရင်းမြစ်၊ ရှာဖွေတွေ့ရှိမှု၏ ယုံကြည်စိတ်ချရမှု သို့မဟုတ် မူလရင်းမြစ်ဆိုင်ရာ ရလဒ်များကို လူတို့ နားလည်ပုံအား လေ့လာနေသော ပညာရေးနှင့် သုတေသနအဖွဲ့အစည်းများ ပါဝင်ပါသည်။
စီးပွားရေးဆိုင်ရာ လိမ်လည်မှုတားဆီးရေး၊ စစ်မှန်မှုစစ်ဆေးရေးနှင့် အတည်ပြုစစ်ဆေးရေး သို့မဟုတ် မူလရင်းမြစ်နှင့် ဒေတာဆန်းစစ်ရေး ဝန်ဆောင်မှုအစုများ၏ အစိတ်အပိုင်းအဖြစ် ပြန်လည်ရောင်းချခြင်းကဲ့သို့ သာမန်စီးပွားရေးအသုံးချမှုများသည် အစီအစဉ်၏ အကျုံးဝင်မှုတွင် လက်ရှိ မပါဝင်ပါ။
ကျောင်းသားများ၏ လက်ရာတွင် AI အသုံးပြုမှုရှိမရှိ စစ်ဆေးခြင်း (ဥပမာ စာစီစာကုံး သို့မဟုတ် ဘွဲ့ယူစာတမ်းရေးသားရာတွင်) ကဲ့သို့ ပညာရေးဆိုင်ရာ ရိုးသားမှုကို စစ်ဆေးသည့် အသုံးချမှုများသည်လည်း အစီအစဉ်၏ အကျုံးဝင်မှုတွင် လက်ရှိ မပါဝင်ပါ။
အတည်ပြုစစ်ဆေးရလဒ်များက ဘာကိုဆိုလိုသလဲ။
openai.com/verify သို့မဟုတ် OpenAI ၏ Content Provenance API မှတစ်ဆင့် ညွှန်ပြချက်တစ်ခုကို တွေ့ရှိပါက အပ်လုဒ်တင်ထားသော အကြောင်းအရာတွင် OpenAI နှင့် ဆက်စပ်သည့် ပံ့ပိုးထားသော မူလရင်းမြစ်ညွှန်ပြချက် ပါဝင်သည်ဟု ဆိုလိုပါသည်။ ကိရိယာသည် အကြောင်းအရာ မှန်ကန်ကြောင်း၊ မပြင်ဆင်ထားကြောင်း၊ တရားဝင်ပိုင်ဆိုင်ကြောင်း သို့မဟုတ် မှန်ကန်သော နောက်ခံအခြေအနေဖြင့် တင်ပြထားကြောင်း အတည်မပြုပေးပါ။ မည်သူက အကြောင်းအရာကို ဖန်တီးခဲ့သည် သို့မဟုတ် ဘာကြောင့် ဖန်တီးခဲ့သည်ကိုလည်း မဖော်ထုတ်ပေးပါ။
ညွှန်ပြချက် မတွေ့ရှိပါက ကိရိယာသည် အပ်လုဒ်တင်ထားသော ဖိုင်အတွင်း OpenAI ထည့်သွင်းပေးထားသည့် မူလရင်းမြစ်ညွှန်ပြချက်များကို ရှာမတွေ့ခဲ့ဟု ဆိုလိုပါသည်။ အောက်ပါအခြေအနေများတွင် အကြောင်းအရာကို OpenAI က ဖန်တီးထားခြင်း သို့မဟုတ် ထုတ်ယူထားခြင်း ဖြစ်နေနိုင်ပါသေးသည်:
မူလရင်းမြစ်ညွှန်ပြချက်များ မရရှိသေးမီ အကြောင်းအရာကို ဖန်တီးခဲ့ခြင်း။
အကြောင်းအရာသည် ပံ့ပိုးမထားသော ထုတ်ကုန်၊ မော်ဒယ်၊ ဖိုင်ထုတ်ယူသည့်နည်းလမ်း သို့မဟုတ် ဖိုင်အမျိုးအစားမှ လာခြင်း။
အပ်လုဒ်တင်ခြင်း၊ ဒေါင်းလုဒ်ဆွဲခြင်း၊ တည်းဖြတ်ခြင်း၊ ပုံစံပြောင်းခြင်း သို့မဟုတ် မျှဝေခြင်းအတွင်း မက်တာဒေတာ ဖယ်ရှားခံရခြင်း။
ချုံ့ခြင်း၊ ဖြတ်တောက်ခြင်း၊ အနှောင့်အယှက်များ၊ ပြင်ဆင်မှုများ၊ ဖိုင်ပုံစံပြောင်းခြင်း သို့မဟုတ် အခြားပြောင်းလဲမှုများကြောင့် ရေစာ ပျက်ယွင်းသွားခြင်း။
အသံအပိုင်းသည် တိုလွန်းခြင်း သို့မဟုတ် အများအပြား ပြင်ဆင်ထားခြင်း။
ယုံကြည်စိတ်ချရမှု အရှိဆုံး အတည်ပြုစစ်ဆေးရလဒ်ကို ဘယ်လိုရနိုင်သလဲ။
ပံ့ပိုးထားသော ဖိုင်ကို တစ်ကြိမ်လျှင် တစ်ဖိုင်သာ အပ်လုဒ်တင်ပြီး ဖြစ်နိုင်သည့်အခါ မူရင်းထုတ်ယူထားသော ဖိုင်ကို အသုံးပြုပါ။ ရုပ်ပုံများအတွက် မစစ်ဆေးမီ ပုံကို ဖြတ်တောက်ခြင်း သို့မဟုတ် ဖိုင်ပုံစံပြောင်းခြင်းကို ရှောင်ပါ။ အသံအတွက် 10 မှ 60 စက္ကန့်ကြားရှိ အသံအပိုင်းများက ယေဘုယျအားဖြင့် အကောင်းဆုံးရလဒ်များ ပေးပါသည်။ ညွှန်ပြချက် မတွေ့ရှိသော်လည်း ကောက်ချက်မချမီ ဖိုင်၏ ရင်းမြစ်နှင့် နောက်ခံအခြေအနေကို ထည့်သွင်းစဉ်းစားပါ။
ရလဒ်များတွင် ကျွန်ုပ်၏ တုံ့ပြန်ညွှန်ကြားချက် သို့မဟုတ် ကိုယ်ရေးအချက်အလက်များကို ပြသသလား။
မူလရင်းမြစ်ညွှန်ပြချက်များတွင် အသုံးပြုသူ၊ အဖွဲ့အစည်း သို့မဟုတ် တုံ့ပြန်ညွှန်ကြားချက်နှင့် ပတ်သက်သော အသေးစိတ်များ မပါဝင်ပါ။
openai.com/verify သို့မဟုတ် Content Provenance API ဖြင့် ကျွန်ုပ် အတည်ပြုစစ်ဆေးသော အကြောင်းအရာကို ဘယ်လိုကိုင်တွယ်သလဲ။
openai.com/verify သို့ အပ်လုဒ်တင်သော သို့မဟုတ် အတည်ပြုစစ်ဆေးရန် ကျွန်ုပ်တို့၏ Content Provenance API သို့ ပေးပို့သော အကြောင်းအရာကို ပံ့ပိုးထားသော မူလရင်းမြစ်ညွှန်ပြချက်များ ရှိမရှိ စစ်ဆေးရန်အတွက်သာ စီမံဆောင်ရွက်ပါသည်။ ဥပဒေအရ လိုအပ်ခြင်းမရှိပါက အကြောင်းအရာကို သိမ်းဆည်းမထားသလို OpenAI မော်ဒယ်များ လေ့ကျင့်ရန်လည်း အသုံးမပြုပါ။
အခြား AI ကိရိယာများဖြင့် ဖန်တီးထားသော အကြောင်းအရာကို OpenAI က ရှာဖွေသိရှိနိုင်သလား။
ကျွန်ုပ်တို့၏ အကြောင်းအရာမူလရင်းမြစ်ဆိုင်ရာ ကိရိယာများကို OpenAI မော်ဒယ်များက ဖန်တီးထားသော သို့မဟုတ် OpenAI ကိရိယာများမှ ထုတ်ယူထားသော အကြောင်းအရာနှင့် ဆက်စပ်သည့် ပံ့ပိုးထားသော မူလရင်းမြစ်ညွှန်ပြချက်များကို ရှာဖွေသိရှိရန် ဒီဇိုင်းရေးဆွဲထားပါသည်။ အခြား AI မော်ဒယ်များ ဖန်တီးထားသော အကြောင်းအရာကို ရှာဖွေသိရှိရန် ဒီဇိုင်းရေးဆွဲထားခြင်း မဟုတ်ပါ။ သက်ဆိုင်ရာ ညွှန်ပြချက် မရှိခြင်း၊ ပံ့ပိုးမထားခြင်း သို့မဟုတ် ပျက်ယွင်းခြင်း ဖြစ်ပါက OpenAI ဖန်တီးအကြောင်းအရာကိုလည်း ရှာဖွေမသိရှိနိုင်ပါ။
ရေစာထည့်သွင်းမှု အလုပ်လုပ်ပုံ
ရေစာများက ဖန်တီးသူ၊ ပိုင်ဆိုင်မှု သို့မဟုတ် ဥပဒေဆိုင်ရာ တာဝန်ရှိမှုကို သတ်မှတ်ပေးသလား။
မသတ်မှတ်ပေးပါ။ ရေစာသည် OpenAI မော်ဒယ်တစ်ခုက အကြောင်းအရာကို ဖန်တီးထားဖွယ် သို့မဟုတ် စီမံပြင်ဆင်ထားဖွယ်ရှိကြောင်း အထောက်အထားဖြစ်ပါသည်။ ရေစာတစ်ခုတည်းဖြင့် အကြောင်းအရာကို မည်သူဖန်တီးထားသည် သို့မဟုတ် ပိုင်ဆိုင်သည်၊ အသိပေးဖော်ပြရန် လိုအပ်ခဲ့သလား၊ ဥပဒေအရ မည်သူ့တွင် တာဝန်ရှိသည်ဆိုသည်တို့ကို အတည်မပြုနိုင်ပါ။ အသုံးပြုသူ အပ်လုဒ်တင်ထားသော အကြောင်းအရာကို မော်ဒယ်က တည်းဖြတ်နေခဲ့ခြင်း ဟုတ်မဟုတ်ကိုလည်း မဖော်ပြနိုင်ပါ။
ရေစာများက OpenAI မော်ဒယ်တစ်ခု မည်မျှအထိ ပါဝင်ခဲ့သည်ကို ဖော်ပြသလား။
မဖော်ပြပါ။ ရှာဖွေရေးကိရိယာက ရေစာ တွေ့ရှိခြင်းရှိမရှိကိုသာ အစီရင်ခံပါသည်။ ရေစာတစ်ခု တွေ့ရှိခြင်းသည် OpenAI မော်ဒယ်တစ်ခုက အကြောင်းအရာကို ဖန်တီးထားဖွယ် သို့မဟုတ် စီမံပြင်ဆင်ထားဖွယ်ရှိကြောင်း အထောက်အထားဖြစ်သော်လည်း မော်ဒယ်က အချို့ကိုသာ ဖန်တီးခဲ့သလား၊ အားလုံးကို ဖန်တီးခဲ့သလား၊ လူတစ်ဦးက မည်မျှပါဝင်ကူညီခဲ့သလဲဆိုသည်ကို မဖော်ပြပါ။
စာသားရေစာထည့်သွင်းမှုက ဘယ်လိုအလုပ်လုပ်သလဲ။
စာသားရေစာထည့်သွင်းမှုသည် မော်ဒယ်က စာရေးနေစဉ် “တိုကင်” ဟုခေါ်သော စကားလုံးများနှင့် စကားလုံးအစိတ်အပိုင်းများကို ရွေးချယ်ပုံတွင် လျှို့ဝှက်ပုံစံတစ်ခု ဖြစ်ပေါ်စေပါသည်။
အဆင့်တိုင်း၌ မော်ဒယ်သည် နောက်လာနိုင်သည့် တိုကင်တစ်ခုချင်းစီအတွက် ဖြစ်နိုင်ခြေတန်ဖိုးကို သတ်မှတ်ပါသည်။ ရေစာထည့်သွင်းစနစ်သည် ထိုဖြစ်နိုင်ခြေတန်ဖိုးများကို ချိန်ညှိထားသည့် အစုအဝေးများစွာ ဖန်တီးပြီး အစုတစ်ခုစီသည် လျှို့ဝှက်သော့တစ်ခုအလိုက် မတူညီသော ရွေးချယ်မှုများကို ဦးစားပေးပါသည်။ အစုများအားလုံး၏ ပျမ်းမျှကို ယူလိုက်သည့်အခါ မော်ဒယ်၏ မူရင်းဖြစ်နိုင်ခြေတန်ဖိုးများနှင့် ကိုက်ညီစေရန် အစုများကို ချိန်ညှိထားပါသည်။ မည်သည့်အစုကို အသုံးပြုမည်ကို သော့က ရွေးချယ်ပြီးနောက် မော်ဒယ်သည် ထိုအစုမှ ကျပန်းရွေးချယ်မှုအသစ်တစ်ခု ပြုလုပ်ပါသည်။
သော့တူညီပြီး ဆက်တင်များ ကိုက်ညီသော ရှာဖွေရေးကိရိယာသည် နောက်ပိုင်းတွင် စာသားက ထိုလျှို့ဝှက်ပုံစံအတိုင်း လိုက်နေမှုမှာ တိုက်ဆိုင်မှုအရ မျှော်လင့်ရသည့် အကြိမ်ရေထက် ပိုများသလားဆိုသည်ကို စစ်ဆေးနိုင်ပါသည်။
အချက်အလက်အခြေပြု စာသားနှင့် အသုံးပြုသူပေးထားသော စာသားတွင်လည်း စာသားရေစာများ ထည့်သွင်းပါသလား။
စာသားရေစာထည့်သွင်းနိုင်မှုသည် အကြောင်းအရာတစ်ခုကို မော်ဒယ်က နည်းလမ်းအမျိုးမျိုးဖြင့် ပြောဆိုနိုင်မှုအပေါ် မူတည်ပါသည်။ သင်္ချာပုစ္ဆာ၏ အဖြေကဲ့သို့ အချက်အလက် အလွန်မှန်ကန်ရမည့် သို့မဟုတ် တိကျရမည့် အဖြေများတွင်ဖြစ်စေ၊ ပေးထားသော စာသားကို မပြောင်းလဲဘဲ ပြန်ထုတ်ပေးရန် မော်ဒယ်အား တောင်းဆိုသည့်အခါတွင်ဖြစ်စေ ပြောင်းလွယ်ပြင်လွယ်လုပ်နိုင်မှု ပိုနည်းပါသည်။ ဤအခြေအနေများတွင် မော်ဒယ်အနေဖြင့် သိသာသော ကွာခြားမှုမရှိဘဲ အသုံးအနှုန်းများကို ပြောင်းလဲရန် အခွင့်အလမ်းနည်းသောကြောင့် ရေစာကို ရှာဖွေမတွေ့ရှိနိုင်ပါ။
အဖြေတိုများနှင့် ကုဒ်များတွင်လည်း စာသားရေစာများ ထည့်သွင်းပါသလား။
စာပိုဒ်တိုများတွင် ရေစာကို ယုံကြည်စိတ်ချစွာ ရှာဖွေတွေ့ရှိနိုင်ရန် လုံလောက်သော စာသားပမာဏ မပါဝင်တတ်ပါ။ ကုဒ်တွင် နောက်လာနိုင်သည့် အရာအတွက် သင့်လျော်သော ရွေးချယ်စရာများမှာ သာမန်စကားပြေထက် နည်းသောကြောင့် ရေစာထည့်သွင်းရန်လည်း ပိုခက်ခဲပါသည်။
ဤကန့်သတ်ချက်များကို ထည့်သွင်းစဉ်းစားထားသည့်အတွက် EU AI ဥပဒေ၏ AI ဖန်တီးအကြောင်းအရာ ပွင့်လင်းမြင်သာမှုဆိုင်ရာ ကျင့်ထုံးတွင် တိုကင် 200 အောက်ရှိသော ရလဒ်များ—အင်္ဂလိပ်လို စကားလုံး 150 ခန့်—သို့မဟုတ် ကုဒ်အပိုင်းအစများ၌ ရေစာထည့်သွင်းရန် မလိုအပ်ပါ။
စာသားရေစာ ရှာဖွေတွေ့ရှိမှုက ဘာသာစကားအလိုက် ဘယ်လိုကွာခြားသလဲ။
ရှာဖွေတွေ့ရှိမှုနှုန်းသည် ဘာသာစကားအလိုက် ကွာခြားပြီး လက်ရှိတွင် အချို့ဘာသာစကားများ၌ အခြားဘာသာစကားများထက် ရှာဖွေတွေ့ရှိရန် ပိုလွယ်ကူပါသည်။ ညွှန်ပြချက် ပိုအားနည်းသော ဘာသာစကားများတွင် ရှာဖွေတွေ့ရှိမှု ပိုကောင်းစေရန် ရေစာ၏ အားပြင်းမှုကို ချိန်ညှိနိုင်ပါသည်။
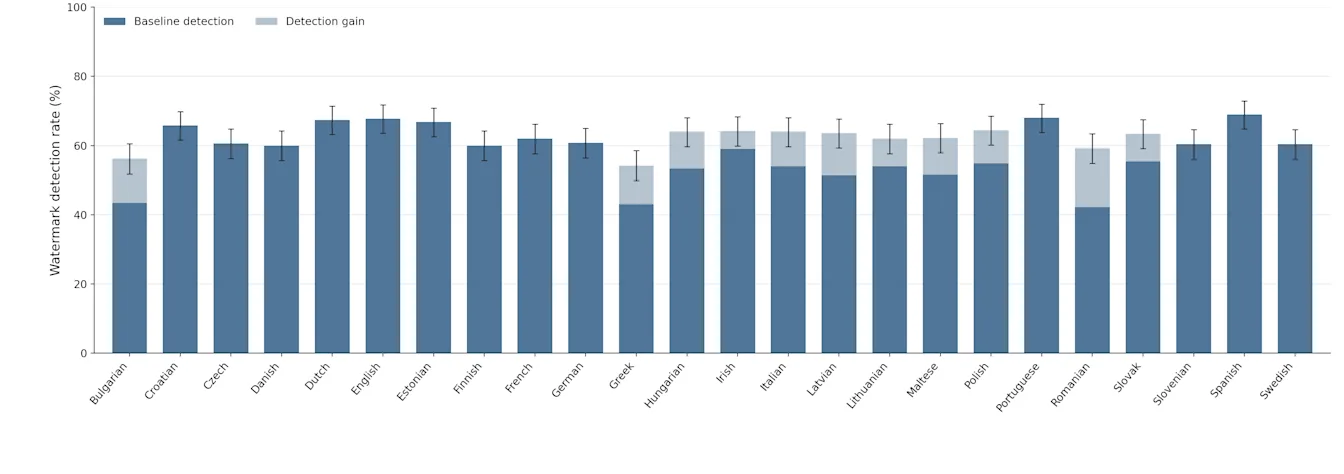
ဤဇယားသည် EU ၏ တရားဝင်ဘာသာစကား 24 မျိုးလုံးအတွက် ရှာဖွေတွေ့ရှိမှုနှုန်းကို အကဲဖြတ်ထားပါသည်။ ပထမဦးစွာ ခေါင်းစဉ်အမျိုးမျိုး ပါဝင်သော အင်္ဂလိပ်ဘာသာ တုံ့ပြန်ညွှန်ကြားချက် 500 ကို စက်ဖြင့် ဖန်တီးပြီး အခြားဘာသာစကား 23 မျိုးသို့ ဘာသာပြန်ခဲ့ပါသည်။ ရေစာမရှိဘဲ ရှိသည်ဟု မှားယွင်းသတ်မှတ်မှုနှုန်း 1% တွင် စပိန်ဘာသာသည် ရှာဖွေတွေ့ရှိမှုနှုန်း အမြင့်ဆုံး (69.0%) ဖြစ်ပြီး ရိုမေးနီးယားဘာသာသည် အနိမ့်ဆုံး (42.2%) ဖြစ်ပါသည်။ ကျွန်ုပ်တို့၏ ရေစာတွင် အားပြင်းမှုကို ချိန်ညှိနိုင်သော ပါရာမီတာတစ်ခု ရှိပါသည်။ ၎င်းသည် နယ်ပယ်အမျိုးမျိုးအတွက် ရေစာညွှန်ပြချက်ကို အားကောင်းစေရန် သို့မဟုတ် အားလျော့စေရန် အသုံးပြုသည့် “ချိန်ညှိခလုတ်” တစ်ခု ဖြစ်ပါသည်။ ဤခလုတ်ကို အသုံးပြု၍ ရှာဖွေတွေ့ရှိမှုနှုန်း 60% အောက်ရှိသော ဘာသာစကားများအတွက် အားပြင်းမှုကို တိုးမြှင့်နိုင်ခဲ့ပါသည်။ တိုင်များ၏ အပြာဖျော့အပိုင်းများက ထိုသို့လုပ်ဆောင်၍ ရရှိလာသော တိုးတက်မှုများကို ပြထားပါသည်။
စာသားရေစာများက မော်ဒယ်အရည်အသွေးကို လျော့ကျစေသလား။
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများအရ မလျော့ကျစေပါ။ ကျွန်ုပ်တို့၏ နောက်ဆုံးပေါ် စွမ်းဆောင်ရည်အမြင့်ဆုံး မော်ဒယ် Astra ကို အကဲဖြတ်ရန် အသုံးပြုသော စံစမ်းသပ်မှုများတစ်လျှောက် ရေစာထည့်သွင်းထားခြင်းနှင့် မထည့်သွင်းထားခြင်းအကြား စွမ်းဆောင်ရည်ကွာခြားမှုသည် အကဲဖြတ်မှုအကြိမ်တိုင်းတွင် ပုံမှန်တွေ့ရသော ကျပန်းအတက်အကျ အတိုင်းအတာအတွင်းသာ ရှိပါသည်။ ယခင် ChatGPT စမ်းသပ်မှုများတွင်လည်း ရေစာထည့်သွင်းလိုက်ခြင်းကြောင့် မနှစ်သက်ကြောင်း အမှတ်ပေးမှုနှုန်း သို့မဟုတ် အခြားထုတ်ကုန်တိုင်းတာချက်များ ပြောင်းလဲမှုမရှိကြောင်း တွေ့ရှိခဲ့ပါသည်။
စာသားရေစာများက မော်ဒယ်အမြန်နှုန်းကို လျော့ကျစေသလား။
စာသားရေစာထည့်သွင်းမှုက ကျွန်ုပ်တို့၏ မော်ဒယ်များ၏ အမြန်နှုန်းအပေါ် သက်ရောက်မှုမှာ အလွန်နည်းပါသည်။
OpenAI ၏ စာသားရေစာများက အခြားအဖွဲ့များ၏ AI ရှာဖွေသိရှိရေးကိရိယာများနှင့် ဘယ်လိုကွာခြားသလဲ။
Pangram ကဲ့သို့ အခြားအဖွဲ့များ၏ ရှာဖွေသိရှိရေးကိရိယာများသည် ပုံမှန်အားဖြင့် စကားလုံးရွေးချယ်ပုံကဲ့သို့ ပုံစံများမှ AI ဖန်တီးစာသားကို ခွဲခြားသိရှိရန် အမျိုးအစားခွဲစနစ်များကို အသုံးပြုကြပါသည်။ ထိုနည်းလမ်းသည် မြှုပ်နှံထည့်သွင်းထားသော ညွှန်ပြချက်ကို ရှာဖွေခြင်းမဟုတ်ဘဲ စာသားကို ဖန်တီးပြီးနောက် ဆန်းစစ်ခြင်းဖြစ်ပါသည်။ EU AI ဥပဒေတွင် ဖန်တီးထားသော စာသား၌ ညွှန်ပြချက်တစ်ခု မြှုပ်နှံထည့်သွင်းရန် အတိအလင်း သတ်မှတ်ထားပါသည်။
TextSeal သို့မဟုတ် SynthID အစား ဘာကြောင့် ကိုယ်ပိုင်စာသားရေစာများကို အသုံးပြုသလဲ။
ရေစာကို ရှာဖွေတွေ့ရှိနိုင်မှုနှင့် တုံ့ပြန်ညွှန်ကြားချက်တစ်ခုတည်းမှ ဖန်တီးသော အဖြေများ၏ မတူကွဲပြားမှုတို့အကြား ဟန်ချက်ညီမှုကို SynthID သို့မဟုတ် TextSeal ထက် ပိုမိုထိန်းချုပ်နိုင်ရန် textGrain ဟုခေါ်သော ကိုယ်ပိုင်စာသားရေစာထည့်သွင်းနည်းကို ကျွန်ုပ်တို့ ဖော်ဆောင်ခဲ့ပါသည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများတွင် ကျွန်ုပ်တို့နည်းလမ်းက ရေစာပါသော စာသားနမူနာများကို မှန်ကန်စွာ ခွဲခြားနိုင်သည့် အချိုးအစားမှာ စာသားအတွက် SynthID နှင့် တူညီသော သို့မဟုတ် ပိုများသော အဆင့်တွင် ရှိခဲ့ပါသည်။ အခြားသူများက ဆက်လက်ဖော်ဆောင်နိုင်ရန်နှင့် စာသားရေစာထည့်သွင်းမှု ပိုမိုကောင်းမွန်အောင် ကူညီနိုင်ရန် textGrain ကို ရင်းမြစ်ကုဒ်ဖွင့် နည်းပညာအဖြစ် ထုတ်ပြန်ဖို့ စီစဉ်ထားပါသည်။
စာသားရေစာထည့်သွင်းမှုက ဝှက်ထားသော အက္ခရာများ၊ အပိုတိုကင်များ သို့မဟုတ် မြင်သာသော ပြောင်းလဲမှုများကို ထည့်ပေးသလား။
မထည့်ပေးပါ။ စာသားရေစာထည့်သွင်းမှုသည် စကားလုံးရွေးချယ်မှုများ၏ စာရင်းအင်းဆိုင်ရာ ပုံစံကို ပြောင်းလဲပေးခြင်းဖြစ်ပြီး ဝှက်ထားသော အက္ခရာများ သို့မဟုတ် ရေစာအတွက်သာ သုံးသော တိုကင်များကို ထည့်သွင်းခြင်း မရှိပါ။ ရေစာကို ဖတ်ရှုသူများက မြင်နိုင်မည်မဟုတ်ဘဲ စာသားကို ကူးယူကူးထည့်ခြင်းကလည်း ဝှက်ထားသော အရာများကို ထပ်ထည့်ပေးမည် မဟုတ်ပါ။
သုံးစွဲသူများအတွက် လမ်းညွှန်ချက်
ကျွန်ုပ်က API သုံးစွဲသူပါ၊ စာသားရေစာများကို ဘယ်လိုဖွင့်ရမလဲ။
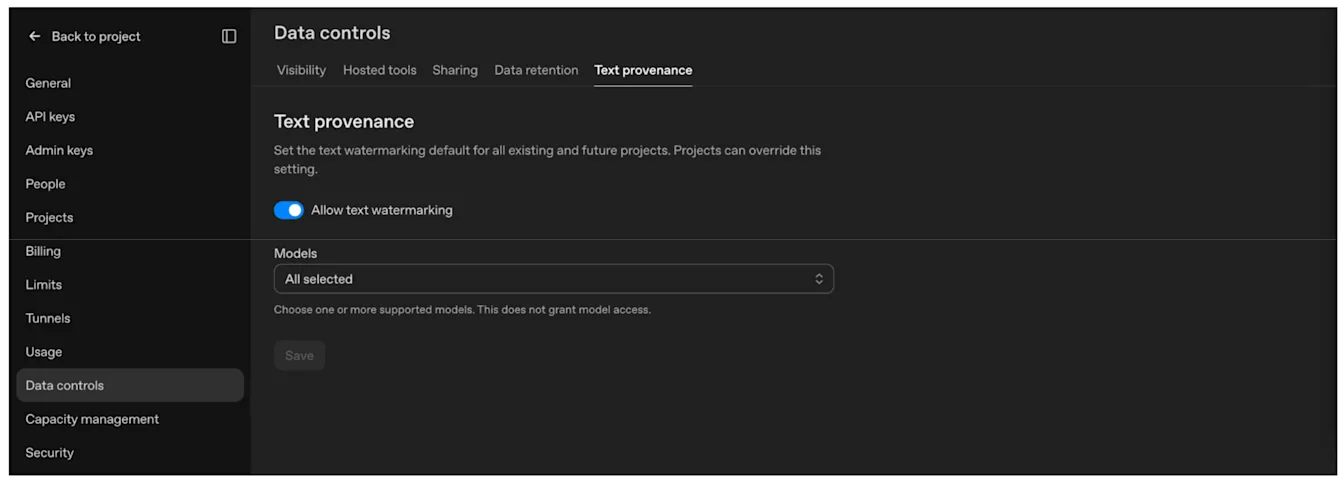
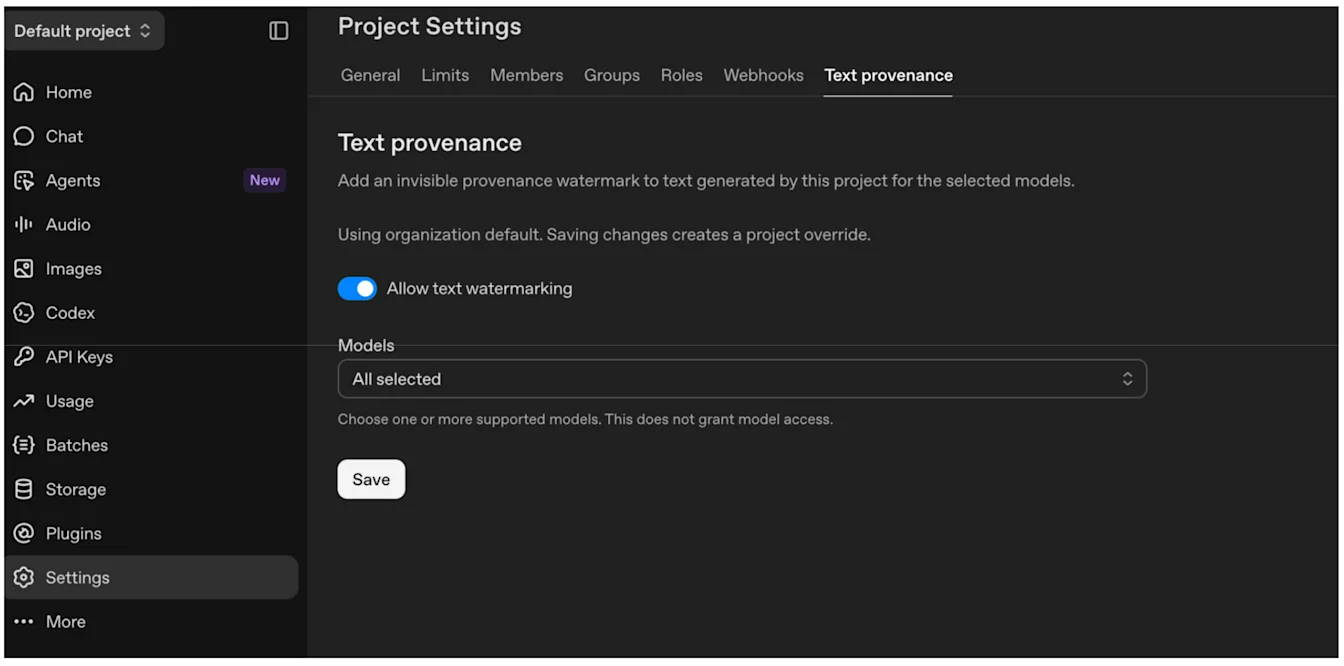
OpenAI API သုံးစွဲသူများသည် သီးခြားပရောဂျက်တစ်ခုအတွက် ဆက်တင်များမှဖြစ်စေ၊ အဖွဲ့အစည်းတစ်ခုလုံးအတွက် အဖွဲ့အစည်းဆက်တင်များမှဖြစ်စေ စာသားရေစာထည့်သွင်းမှုကို ဖွင့်နိုင်ပါသည်။ အခြေအနေနှစ်မျိုးလုံးတွင် မည်သည့်မော်ဒယ် သို့မဟုတ် မော်ဒယ်များ၌ စာသားရေစာထည့်သွင်းမည်ကို သုံးစွဲသူများ ရွေးချယ်နိုင်ပါသည်။ ပံ့ပိုးထားသော မော်ဒယ်တစ်ခုအတွက် ဖွင့်ပြီးသည်နှင့် OpenAI က စာသားဖန်တီးနေစဉ် ရေစာကို ထည့်သွင်းပေးပါသည်။ သုံးစွဲသူများအနေဖြင့် အဖြေတစ်ခုချင်းစီတွင် သီးခြားအမှတ်အသား ထည့်သွင်းရန် မလိုအပ်ပါ။
စာသားရေစာထည့်သွင်းမှုကို ခွင့်ပြုရန် ကို ဖွင့်ပါ၊ မော်ဒယ်များကို ရွေးပါ၊ ထို့နောက် သိမ်းဆည်းရန် ကို ရွေးပါ။
အဖွဲ့အစည်း၏ မူလသတ်မှတ်ချက်: အဖွဲ့အစည်းဆက်တင်များ → ဒေတာထိန်းချုပ်မှုများ → စာသားမူလရင်းမြစ်။
ပရောဂျက်အလိုက် အစားထိုးသတ်မှတ်ချက်: ပရောဂျက်ဆက်တင်များ → စာသားမူလရင်းမြစ်။
ဘယ်မော်ဒယ်တွေအတွက် ရေစာများကို ဖွင့်နိုင်သလဲ။
သုံးစွဲသူများသည် ဆက်တင်များနှင့် အဖွဲ့အစည်းဆက်တင်များမှ လက်ရှိ ရေစာထည့်သွင်းနိုင်သော မော်ဒယ်စာရင်းကို ကြည့်နိုင်ပါသည်။ လာမည့် ရက်သတ္တပတ်များအတွင်း မော်ဒယ်အဟောင်းအားလုံးအထိ ပံ့ပိုးမှု တိုးချဲ့သွားပါမည်။
စာသားရေစာများကို ဖွင့်ထားလျှင် စာသားရှာဖွေရေးကိရိယာကိုလည်း သုံးစွဲခွင့်ရသလား။
မရပါ။ လက်ရှိတွင် စာသားရေစာထည့်သွင်းမှု၏ ယုံကြည်စိတ်ချရမှု၊ အသုံးပြုရလွယ်ကူမှုနှင့် နည်းပညာအပါအဝင် ၎င်း၏ ရလဒ်များကို ရှင်းလင်းစွာ ရှင်းပြနိုင်မှုတို့ ပိုမိုကောင်းမွန်လာစေရန် လုပ်ဆောင်နေသည့် ခွင့်ပြုချက်ရ သုတေသနနှင့် ပညာရေးအဖွဲ့အစည်းများကိုသာ စာသားရှာဖွေရေးကိရိယာ သုံးစွဲခွင့်ပေးထားပါသည်။ ဤသည်မှာ EU AI ဥပဒေ၏ AI ဖန်တီးအကြောင်းအရာ ပွင့်လင်းမြင်သာမှုဆိုင်ရာ ကျင့်ထုံးအရ ကျွန်ုပ်တို့၏ ကတိကဝတ်များနှင့် ကိုက်ညီပါသည်။
အကြောင်းအရာကို ပြောင်းလဲပြီးနောက် ညွှန်ပြချက်များ ဆက်လက်ပါဝင်နေမည်လား။
ဆက်လက်ပါဝင်နေနိုင်သော်လည်း ညွှန်ပြချက်နှင့် သင်ပြုလုပ်သည့် ပြောင်းလဲမှုများပေါ်တွင် မူတည်ပါသည်။
ပံ့ပိုးထားသော ရုပ်ပုံနှင့် အသံများအတွက် မူရင်းမိတ္တူတစ်ခုကို သိမ်းထားပြီး ပြင်ဆင်ခြင်း၊ ပုံစံပြောင်းခြင်းနှင့် ထုတ်ဝေခြင်းတို့ ပြုလုပ်ပြီးနောက် ကိုယ်စားပြုဖိုင်များကို Content Provenance API ဖြင့် စမ်းသပ်ပါ။ ရုပ်ပုံများတွင် ဖြတ်တောက်ခြင်း၊ အနှောင့်အယှက်အစက်အပြောက်များ ထည့်ခြင်း၊ JPEG သို့ ပြောင်းခြင်းနှင့် စခရင်ရှော့ရိုက်ခြင်းတို့က ညွှန်ပြချက်များကို ရှာဖွေတွေ့ရှိရန် ပိုခက်ခဲစေနိုင်ပါသည်။ သင့်အဖွဲ့အစည်းတွင် စာသားရှာဖွေရေးကိရိယာ သုံးစွဲခွင့် အတည်ပြုချက်ရထားမှသာ စာသားကို ဤနည်းဖြင့် စမ်းသပ်နိုင်ပါသည်။
သင့်ဖိုင်ပုံစံနှင့် လုပ်ငန်းစဉ်က ပံ့ပိုးပါက ရှိပြီးသား C2PA မက်တာဒေတာကို ထိန်းသိမ်းထားပြီး သင်ထုတ်လုပ်သော ဖိုင်များတွင် အကြောင်းအရာအထောက်အထားများ ထည့်သွင်းပါ။ မူလရင်းမြစ်ဆိုင်ရာ အချက်အလက် ပိုမိုတည်မြဲစေရန် သို့မဟုတ် ပိုမိုအသုံးဝင်စေရန် သင့်ကိုယ်ပိုင်အမှတ်အသားများ ထည့်သွင်းဖို့လည်း စဉ်းစားနိုင်ပါသည်။ အကောင်အထည်ဖော်ပုံ အသေးစိတ်အတွက် C2PA နည်းပညာဆိုင်ရာ စာတမ်းများကို ကြည့်ပါ။
စာသားတွင် ရေစာသည် မော်ဒယ်၏ စကားလုံးရွေးချယ်မှုများ၏ တစ်စိတ်တစ်ပိုင်း ဖြစ်ပါသည်။ အသုံးအနှုန်းများကို မပြောင်းဘဲ ထိန်းသိမ်းထားပါက စာသားကို ပြန်လည်အသုံးပြုသည့်အခါ ထပ်ဆောင်းချိတ်ဆက်ပေါင်းစည်းမှု လုပ်ဆောင်စရာမလိုဘဲ ညွှန်ပြချက် ဆက်လက်ကျန်ရှိမည်ဟု မျှော်လင့်ရပါသည်။ အများအပြား ပြန်ရေးခြင်း၊ အဓိပ္ပာယ်တူ စကားလုံးများဖြင့် ပြန်ဆိုခြင်း သို့မဟုတ် ဘာသာပြန်ခြင်းတို့က ရှာဖွေတွေ့ရှိမှု၏ ယုံကြည်စိတ်ချရမှုကို လျော့နည်းစေနိုင်ပါသည်။ အသုံးအနှုန်းများ မပြောင်းလဲသော်လည်း ရှာဖွေတွေ့ရှိနိုင်သော ရေစာတစ်ခု ရှိနေမည်ဟု အာမခံမရပါ။ အထူးသဖြင့် စာပိုဒ်တိုများ သို့မဟုတ် ကွဲပြားသည့် စကားလုံးများ ရွေးချယ်သုံးစွဲရန် အခွင့်အလမ်းနည်းသော စာသားများတွင် ဖြစ်ပါသည်။
ကျွန်ုပ်သည် Cloud ဝန်ဆောင်မှုမှတစ်ဆင့် OpenAI ၏ မော်ဒယ်များကို အသုံးပြုပါသည်။ ထိုရလဒ်များတွင်လည်း မူလရင်းမြစ်ညွှန်ပြချက်များ ပါဝင်ပါသလား။
ရုပ်ပုံ၊ အသံနှင့် စာသားအပါအဝင် သတ်မှတ်ချက်နှင့် ကိုက်ညီသည့် ရလဒ်အားလုံးတွင် ရေစာများအပါအဝင် မူလရင်းမြစ်ညွှန်ပြချက်များ ထည့်သွင်းထားနိုင်ရန် ကျွန်ုပ်တို့၏ Cloud နှင့် ဖြန့်ဖြူးဝန်ဆောင်မှုပေးသူ အားလုံးနှင့် ပူးပေါင်းဆောင်ရွက်နေပါသည်။ ရရှိနိုင်မှုမှာ ရလဒ်အမျိုးအစားနှင့် မိတ်ဖက်အလိုက် ကွာခြားနိုင်ပါသည်။
မူလရင်းမြစ်ညွှန်ပြချက်များက မြင်သာသော AI အညွှန်းများ သို့မဟုတ် အခြားအသိပေးဖော်ပြချက်များကို အစားထိုးသလား။
အစားမထိုးပါ။ ရေစာများနှင့် C2PA မက်တာဒေတာသည် ဆော့ဖ်ဝဲက ဖတ်နိုင်သော အချက်အလက်များကို ပေးပါသည်။ ၎င်းတို့သည် လိုအပ်နိုင်သည့် မြင်သာသော အညွှန်းများ၊ ဘန်နာများ သို့မဟုတ် အခြားအသိပေးချက်များကို အစားမထိုးပါ။
ထပ်ဆောင်းအသိပေးဖော်ပြချက် လိုအပ်ခြင်းရှိမရှိမှာ အကြောင်းအရာကို မည်သို့နှင့် မည်သည့်နေရာတွင် အသုံးပြုသည်ဆိုသည့်အပေါ် မူတည်ပါသည်။ သင်၏ သီးခြားဥပဒေဆိုင်ရာ တာဝန်များအကြောင်း OpenAI က အကြံမပေးနိုင်ပါ။ သင်၏ အသုံးပြုမှုအတွက် လိုအပ်ချက်များကို သင့်ဥပဒေအဖွဲ့က အကဲဖြတ်သင့်ပါသည်။
EU AI ဥပဒေနှင့် ပတ်သက်၍ နောက်ထပ်မေးခွန်းများ ရှိပါသည်
EU AI ဥပဒေဆိုင်ရာ မေးမြန်းချက် ပေးပို့ပါ။ ကျွန်ုပ်တို့ ပြန်လည်ဆက်သွယ်ပါမည်။