
Som del av arbeidet for et tryggere og mer åpent KI-økosystem bruker OpenAI opprinnelsessignaler for å hjelpe folk med å forstå om innhold er generert med en OpenAI-modell.
Opprinnelsessignaler kan gi nyttig informasjon om opphavet, men de garanterer ikke at innholdet er korrekt, uredigert, lovlig eid eller presentert i riktig kontekst.
OpenAIs opprinnelsessignaler
Hvilke opprinnelsessignaler bruker OpenAI?
OpenAI bruker ulike opprinnelsessignaler for ulike innholdstyper.
| Innholdstype | Opprinnelsessignaler | Merknader |
|---|---|---|
| Bilder | Content Credentials og SynthID-vannmerker | Bilder generert med ChatGPT, Codex eller OpenAI API inneholder begge signalene. |
| Lyd | SynthID-vannmerker | Lyd generert av ChatGPT eller OpenAI API inneholder et uhørbart vannmerke innebygd i selve lyden. |
| Tekst | textGrain-vannmerker (kun EU) | I EU inneholder ChatGPT-generert tekst en usynlig endring i tilfeldigheten som brukes i modellens ordvalg, for å overholde EUs KI-forordning. API-kunder over hele verden kan slå på vannmerking av generert tekst i prosjekt- eller organisasjonsinnstillingene. |
| Video | Content Credentials | Sora er avviklet. Les mer. |
Dekningen kan variere etter produkt, modell, eksportmåte, filtype og når innholdet ble opprettet. Innhold generert via API-et er omfattet, med unntak av modeller som snart skal fases ut, inkludert gpt-image-1, gpt-image-1.5 og sora-2.
Hvorfor brukes flere signaler for noen innholdstyper?
Når det er teknisk mulig, kombinerer OpenAI metadata og vannmerker slik at de kan kompensere for hverandres begrensninger. Metadata kan inneholde detaljert informasjon, men plattformer, redigeringsverktøy og filkonverteringer kan fjerne dem. Vannmerker gir mindre kontekst, men fordi de er innebygd i selve det genererte innholdet, kan de bli bevart gjennom enkelte endringer som fjerner metadata.
Hvor godt tåler opprinnelsessignaler endringer i innholdet?
SynthID-vannmerker for bilder og lyd og textGrain-vannmerker for tekst er laget for å tåle vanlige endringer. Avhengig av innholdstypen kan dette omfatte mindre redigeringer, kopiering og innliming, beskjæring eller skjermbilder. Mer omfattende endringer – som kraftig beskjæring av bilder, filkomprimering, omfattende omformulering eller oversettelse – kan gjøre at et vannmerke ikke lenger kan oppdages. Etter omfattende endringer kan det også være mindre meningsfullt å beskrive resultatet som «generert av OpenAI».
Content Credentials, som er utviklet av Coalition for Content Provenance and Authenticity, kan gå tapt ved vanlige handlinger som å ta et skjermbilde eller konvertere en fil. Når de er bevart, kan de gi flere detaljer om en fils opprinnelse og historikk enn et vannmerke alene.
Der det er teknisk mulig, bruker vi begge metodene for å øke sannsynligheten for at opprinnelsesinformasjonen bevares når innholdet endres.
Hva er Content Credentials, og hva gjør de mulig?
Content Credentials legger ved informasjon om en fils opprinnelse og historikk, for eksempel hvilket verktøy som opprettet den, og når. De bruker en åpen standard utviklet av Coalition for Content Provenance and Authenticity (C2PA), og kalles derfor noen ganger «C2PA-metadata».
Content Credentials hjelper folk med å verifisere hvor innhold kommer fra. De brukes til mer enn KI-generert innhold: Kameraprodusenter, nyhetsorganisasjoner og andre bruker også standarden til å bekrefte kilden og historikken til medieinnholdet sitt. Les mer om C2PA.
Hva er SynthID, og hva gjør teknologien mulig?
SynthID er en teknologi for usynlig vannmerking utviklet av Google DeepMind, som bygger et signal direkte inn i generert medieinnhold. I motsetning til metadata er signalet en del av selve innholdet og kan bli bevart gjennom enkelte redigeringer eller endringer. SynthID gir et ekstra opprinnelsessignal i tillegg til C2PA-metadata. Hvis metadata for eksempel fjernes fra en fil, kan et innebygd vannmerke fortsatt gi et signal om at innholdet er generert med støttede OpenAI-verktøy. Les mer om SynthID.
Hvorfor vannmerker dere generert tekst?
Vi innfører vannmerking av tekst for ChatGPT-brukere i EU for å overholde EUs KI-forordning og oppfylle våre forpliktelser under EUs retningslinjer for åpenhet om KI-generert innhold, som OpenAI har undertegnet sammen med flere andre store KI-leverandører.
Hva er textGrain, og hva gjør teknologien mulig?
textGrain er OpenAIs teknologi for vannmerking av tekst. Den gjør små justeringer i hvordan modellen velger tilfeldig mellom mulige ord eller orddeler mens den skriver. Gjennom en tekst danner disse valgene et mønster som en detektor kan se etter, også etter enkelte redigeringer.
Vannmerket er en del av selve ordlyden og er ikke synlig for leserne. Det legger ikke til skjulte tegn, usynlige mellomrom eller uvanlig tegnsetting. Vannmerking av tekst bidrar til å oppfylle kravet i EUs KI-forordning om å merke generert tekst.
OpenAIs verifiseringsverktøy
Hvordan kan jeg sjekke om innhold er generert med OpenAI-verktøy?
Du kan gå til openai.com/verify for å sjekke om en bilde- eller lydfil som støttes, inneholder opprinnelsessignaler knyttet til innhold generert eller eksportert av OpenAI-verktøy. Når du har lastet opp en fil som støttes, vil verktøyet se etter støttede opprinnelsessignaler fra OpenAI, for eksempel et SynthID-vannmerke eller et pålitelig C2PA-manifest knyttet til OpenAI. Hvis verktøyet finner et støttet opprinnelsessignal fra OpenAI, tyder det på at innholdet sannsynligvis er generert av en OpenAI-modell.
Utviklere og organisasjoner kan også bruke OpenAIs Content Provenance API til å sjekke bilder og lyd for opprinnelsessignaler fra OpenAI og integrere verifisering i egne applikasjoner eller arbeidsflyter. Organisasjoner med et bruksområde som oppfyller kriteriene, kan søke om høyere bruksgrenser.
I tråd med våre forpliktelser under EUs KI-forordning kan organisasjoner med et bruksområde som oppfyller kriteriene, søke om tilgang til tekstdetektoren. Dette gjelder for eksempel akademiske institusjoner og forskningsorganisasjoner som undersøker teksters opprinnelse, deteksjonens pålitelighet eller hvordan folk forstår resultater fra opprinnelseskontroller. Vi vurderer søknader fra kvalifiserte organisasjoner enkeltvis og følger opp ved behov med oppdateringer eller forespørsler om mer informasjon. Tilgangsordningen kan endre seg etter hvert som vi lærer mer og forbedrer teknologien.
Vi samarbeider for tiden med en begrenset gruppe forskere, blant andre John Thickstun, assisterende professor i informatikk ved Cornell University, Martin Vechev, professor i informatikk ved ETH Zürich og vitenskapelig direktør ved INSAIT, og forskere ved Kempelen Institute of Intelligent Technologies (KInIT). Målet er å forstå teknologiens muligheter og begrensninger bedre og bruke denne innsikten til å forbedre vannmerking av tekst.
Hvem kvalifiserer for høyere verifiseringsgrenser, og koster kontrollene noe?
Kontroller med Content Provenance API er for tiden gratis og underlagt bruksgrenser. Programmet for høyere bruksgrenser retter seg mot kvalifiserte prosjekter for opprinnelseskontroll i offentlighetens interesse og arbeidsflyter som ivaretar informasjonsintegritet, som redaksjonell verifisering, faktasjekking, forskning på innholdets opprinnelse og myndighetstilsyn.
Generelle kommersielle bruksområder faller foreløpig utenfor programmet. Dette gjelder for eksempel kommersiell svindelforebygging, autentisering og verifisering, eller videresalg som del av tjenestepakker for opprinnelseskontroll og dataanalyse.
Organisasjoner med et bruksområde som oppfyller kriteriene, kan søke om høyere bruksgrenser, men en innsendt søknad garanterer ikke godkjenning. Det offentlige API-et er fortsatt tilgjengelig med standardgrensene, også for mindre evalueringer. Se dokumentasjonen for Content Provenance API for gjeldende bruksgrenser.
Hvem kvalifiserer for tilgang til tekstdetektoren, og koster kontrollene noe?
Kontroller med tekstdetektoren er for tiden gratis. Bruksområder som oppfyller kriteriene, omfatter akademiske institusjoner og forskningsorganisasjoner som undersøker teksters opprinnelse, deteksjonens pålitelighet eller hvordan folk forstår resultater fra opprinnelseskontroller.
Generelle kommersielle bruksområder faller foreløpig utenfor programmet. Dette gjelder for eksempel kommersiell svindelforebygging, autentisering og verifisering, eller videresalg som del av tjenestepakker for opprinnelseskontroll og dataanalyse.
Bruk knyttet til akademisk integritet, som å kontrollere studentarbeid for KI-bruk (for eksempel i essays eller avhandlinger), faller også foreløpig utenfor programmet.
Hva betyr verifiseringsresultatene?
Hvis et signal oppdages via openai.com/verify eller OpenAIs Content Provenance API, betyr det at det opplastede innholdet inneholder et støttet opprinnelsessignal knyttet til OpenAI. Verktøyet bekrefter ikke at innholdet er korrekt, uredigert, lovlig eid eller presentert i riktig kontekst. Det identifiserer heller ikke hvem som opprettet innholdet, eller hvorfor det ble opprettet.
Hvis ingen signaler oppdages, betyr det at verktøyet ikke fant opprinnelsessignaler fra OpenAI i den opplastede filen. Innholdet kan likevel ha blitt generert eller eksportert av OpenAI hvis:
Innholdet ble opprettet før opprinnelsessignaler var tilgjengelige.
Innholdet kom fra et produkt, en modell, en eksportmåte eller en filtype som ikke støttes.
Metadata ble fjernet under opplasting, nedlasting, redigering, konvertering eller deling.
Et vannmerke ble svekket av komprimering, beskjæring, støy, redigering, formatkonvertering eller andre endringer.
Et lydklipp er for kort eller har blitt vesentlig endret.
Hvordan får jeg et mest mulig pålitelig verifiseringsresultat?
Last opp én fil som støttes, om gangen, og bruk den opprinnelige eksporterte filen når det er mulig. For bilder bør du unngå å beskjære eller konvertere filen før du sjekker den. For lyd gir klipp på mellom 10 og 60 sekunder vanligvis best resultater. Selv når ingen signaler oppdages, bør du vurdere filens kilde og kontekst før du trekker en konklusjon.
Viser resultatene prompten min eller personopplysningene mine?
Opprinnelsessignaler inneholder ikke detaljer om brukeren, organisasjonen eller prompten.
Hva skjer med innhold jeg verifiserer med openai.com/verify eller Content Provenance API?
Innhold som lastes opp til openai.com/verify eller sendes til vårt Content Provenance API for verifisering, behandles bare for å sjekke om det inneholder støttede opprinnelsessignaler. Innholdet lagres ikke med mindre det er lovpålagt, og brukes ikke til å trene OpenAI-modeller.
Kan OpenAI oppdage innhold generert med andre KI-verktøy?
Verktøyene våre for opprinnelseskontroll er laget for å oppdage støttede opprinnelsessignaler knyttet til innhold generert av OpenAI-modeller eller eksportert av OpenAI-verktøy. De er ikke laget for å oppdage innhold generert av andre KI-modeller. Det kan også hende at de ikke oppdager OpenAI-generert innhold hvis det relevante signalet mangler, ikke støttes eller er svekket.
Slik fungerer vannmerking
Fastslår vannmerker opphav, eierskap eller juridisk ansvar?
Nei. Et vannmerke er et tegn på at en OpenAI-modell sannsynligvis har generert eller behandlet innholdet. I seg selv fastslår det ikke hvem som har skapt eller eier innholdet, om det var pålagt å opplyse om KI-bruk, eller hvem som er juridisk ansvarlig. Det forteller heller ikke om modellen redigerte innhold som en bruker hadde lastet opp.
Viser vannmerker i hvilken grad en OpenAI-modell ble brukt?
Nei. Detektoren rapporterer om den fant et vannmerke. Et slikt funn er et tegn på at en OpenAI-modell sannsynligvis har generert eller behandlet innholdet, men det viser ikke om modellen genererte noe av eller hele innholdet, eller hvor mye et menneske bidro med.
Hvordan fungerer vannmerking av tekst?
Vannmerking av tekst skaper et hemmelig mønster i modellens valg av ord og orddeler, kalt «token», mens den skriver.
Ved hvert trinn tilordner modellen en sannsynlighet til hvert mulig neste token. Vannmerkingssystemet lager flere justerte sett med disse sannsynlighetene, der hvert sett favoriserer ulike valg i henhold til en hemmelig nøkkel. Settene er balansert slik at gjennomsnittet av dem samsvarer med modellens opprinnelige sannsynligheter. Nøkkelen avgjør hvilket sett som brukes, og modellen gjør deretter et nytt tilfeldig valg fra dette settet.
En detektor med samme nøkkel og tilsvarende innstillinger kan senere sjekke om teksten følger det hemmelige mønsteret oftere enn man ville forvente ved tilfeldighet.
Gjelder tekstvannmerker også faktatekst og tekst fra brukeren?
Vannmerking av tekst avhenger av at modellen kan uttrykke noe på ulike måter. Det er mindre fleksibilitet når et svar må være svært faktabasert eller presist, som svaret på en matematikkoppgave, eller når modellen blir bedt om å gjengi en oppgitt tekst uten endringer. I slike tilfeller har modellen mindre rom for å endre ordlyden uten at det blir merkbart, så vannmerket blir kanskje ikke oppdaget.
Gjelder tekstvannmerker også korte svar og kode?
Korte tekstutdrag inneholder vanligvis ikke nok tekst til at vannmerker kan oppdages pålitelig. Kode er også vanskeligere å vannmerke, fordi det er færre plausible valg for hva som kommer videre enn i vanlig prosa.
For å ta høyde for disse begrensningene krever ikke retningslinjene for åpenhet om KI-generert innhold under EUs KI-forordning vannmerker i svar som er kortere enn 200 token – omtrent 150 ord på engelsk – eller i kodesnutter.
Hvordan varierer deteksjonen av tekstvannmerker mellom språk?
Deteksjonsraten varierer mellom språk, og det er for tiden lettere å oppdage vannmerker på noen språk enn på andre. Vi kan justere styrken på vannmerket for å forbedre deteksjonen på språk der signalet er svakere.
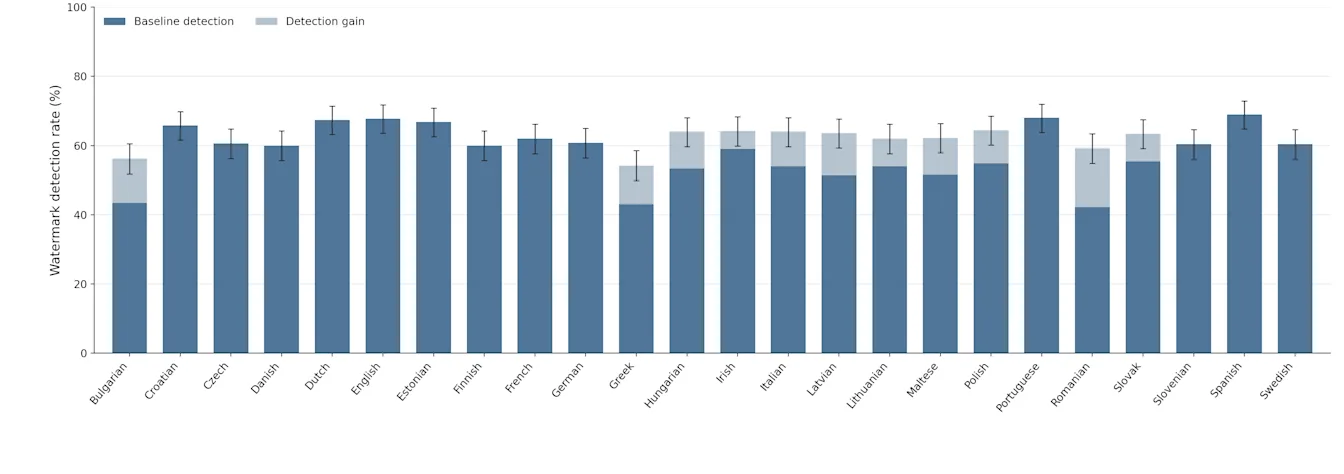
Dette diagrammet viser deteksjonsraten for alle de 24 offisielle EU-språkene. Vi genererte først 500 syntetiske prompter på engelsk om ulike temaer, og oversatte dem deretter til de andre 23 språkene. Ved en falsk positiv-rate på 1 % har spansk høyest deteksjonsrate (69,0 %), mens rumensk har lavest (42,2 %). Vannmerket vårt har en justerbar styrkeparameter – en «bryter» som styrker eller svekker vannmerkesignalet for ulike bruksområder. Med denne bryteren kunne vi øke styrken for språk med en deteksjonsrate under 60 %. De lyseblå delene av søylene viser forbedringene dette ga.
Reduserer tekstvannmerker modellkvaliteten?
Testene våre viser at de ikke gjør det. I referansetestene vi bruker til å evaluere Astra, vår nyeste banebrytende modell, ligger ytelsesforskjellene med og uten vannmerking innenfor den normale variasjonen vi ser mellom evalueringskjøringer. Tidligere tester i ChatGPT viste heller ingen endring i andelen tommel ned-vurderinger eller andre produktmålinger da vannmerking ble innført.
Gjør tekstvannmerker modellen tregere?
Vannmerking av tekst har ubetydelig innvirkning på hastigheten til modellene våre.
Hvordan skiller OpenAIs tekstvannmerker seg fra tredjepartsverktøy for KI-deteksjon?
Tredjepartsverktøy for deteksjon, som Pangram, bruker vanligvis klassifikatorer til å identifisere KI-generert tekst ut fra mønstre som ordvalg. Denne metoden analyserer teksten etter at den er generert, i stedet for å oppdage et innebygd signal. EUs KI-forordning krever uttrykkelig at et signal bygges inn i generert tekst.
Hvorfor bruker dere egne tekstvannmerker i stedet for TextSeal eller SynthID?
Vi utviklet vår egen metode for vannmerking av tekst, kalt textGrain, for å få bedre kontroll enn med SynthID eller TextSeal over balansen mellom hvor lett vannmerket kan oppdages, og variasjonen i svarene som genereres fra samme prompt. I testene våre identifiserte metoden vår en like stor eller større andel av de vannmerkede tekstprøvene korrekt sammenlignet med SynthID for tekst. Vi planlegger å utgi textGrain med åpen kildekode, slik at andre kan bygge videre på teknologien og bidra til å forbedre vannmerking av tekst.
Legger vannmerking av tekst til skjulte tegn, ekstra token eller synlige endringer?
Nei. Vannmerking av tekst endrer det statistiske mønsteret i ordvalgene. Den setter ikke inn skjulte tegn eller legger til token som bare brukes til vannmerking. Vannmerket er ikke synlig for leserne, og kopiering og innliming av teksten tilfører ikke skjult innhold.
Veiledning for kunder
Jeg er API-kunde. Hvordan slår jeg på tekstvannmerker?
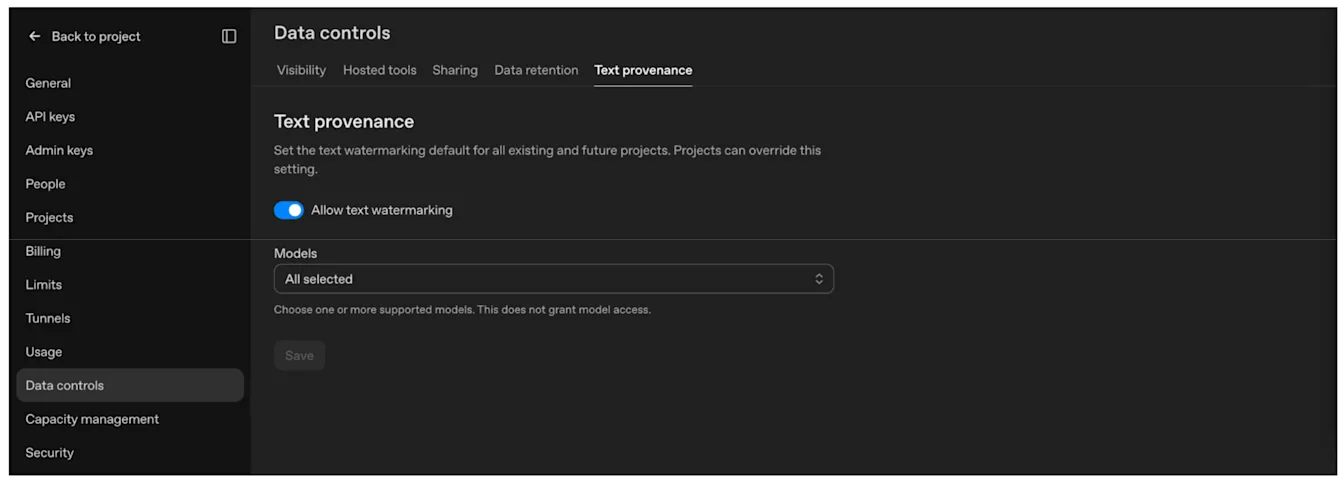
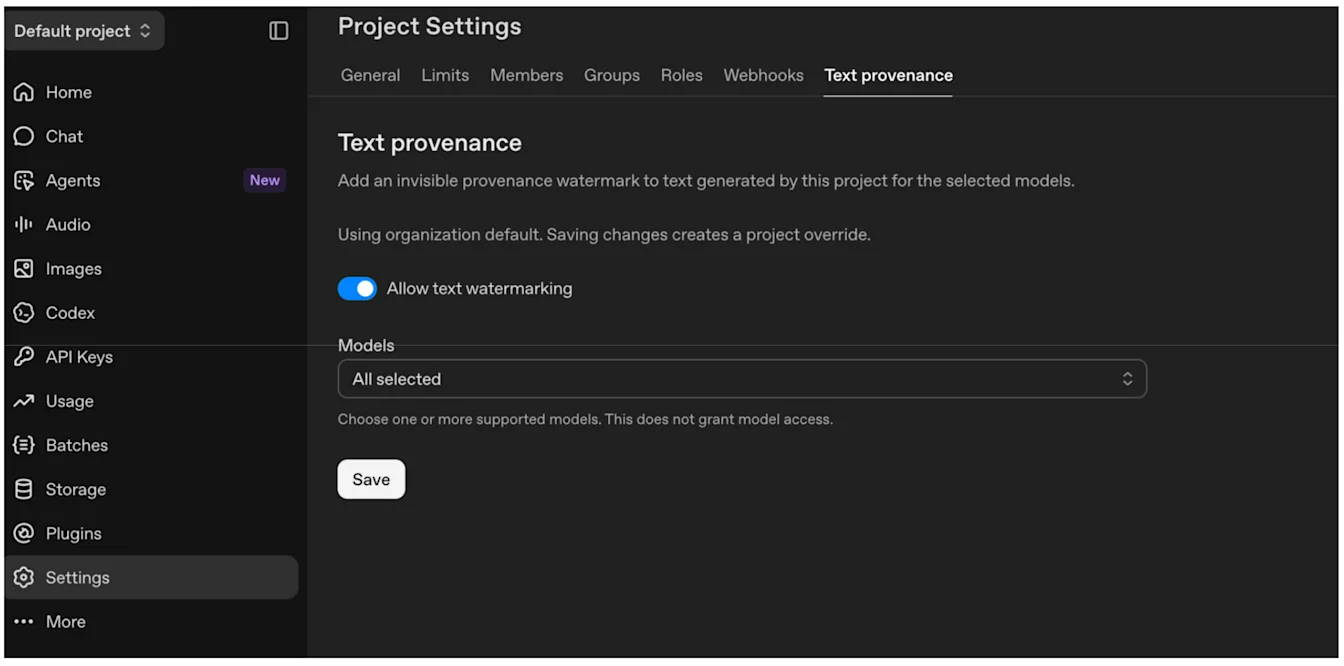
Kunder av OpenAI API kan aktivere vannmerking av tekst for et bestemt prosjekt under Innstillinger, eller for hele organisasjonen under Organisasjonsinnstillinger. I begge tilfeller kan kundene velge hvilke modeller som skal bruke tekstvannmerker. Når funksjonen er aktivert for en modell som støttes, legger OpenAI til vannmerket under tekstgenereringen. Kundene trenger ikke å legge til en egen merking i hvert svar.
Slå på Tillat vannmerking av tekst, velg modellene dine og velg deretter Lagre.
Standard for organisasjonen: Organisasjonsinnstillinger → Datakontroller → Tekstens opprinnelse.
Overstyring for prosjektet: Prosjektinnstillinger → Tekstens opprinnelse.
Hvilke modeller kan jeg aktivere vannmerker for?
Under Innstillinger og Organisasjonsinnstillinger kan kunder se listen over modeller som for tiden støtter vannmerking. I løpet av de kommende ukene vil vi utvide støtten til alle eldre modeller.
Får jeg også tilgang til tekstdetektoren når jeg aktiverer tekstvannmerker?
Nei. Tilgang til tekstdetektoren er for tiden begrenset til godkjente forskningsorganisasjoner og akademiske institusjoner som arbeider med å gjøre vannmerking av tekst mer pålitelig og brukervennlig, og med å gjøre teknologien og resultatene lettere å forklare. Dette er i tråd med våre forpliktelser under retningslinjene for åpenhet om KI-generert innhold under EUs KI-forordning.
Vil signalene fortsatt følge innholdet etter at jeg har endret det?
Det kan de gjøre, men det avhenger av signalet og endringene du gjør.
For bilder og lyd som støttes, bør du beholde en originalkopi og bruke Content Provenance API til å teste representative filer etter redigering, konvertering og publisering. For bilder kan beskjæring, tilføying av støy, konvertering til JPEG og skjermbilder gjøre signalene vanskeligere å oppdage. Du kan bare teste tekst på denne måten hvis organisasjonen din har godkjent tilgang til tekstdetektoren.
Når filformatet og arbeidsflyten støtter det, bør du bevare eksisterende C2PA-metadata og inkludere Content Credentials i filene du lager. Du kan også vurdere å legge til egen merking for å gjøre opprinnelsesinformasjonen mer robust eller nyttig. Se den tekniske dokumentasjonen for C2PA for detaljer om implementering.
I tekst er vannmerket en del av modellens ordvalg. Hvis du beholder ordlyden, forventes signalet å bli bevart når du gjenbruker teksten, uten ytterligere integrasjonsarbeid. Omfattende omskriving, omformulering eller oversettelse kan gjøre deteksjonen mindre pålitelig. Selv uendret ordlyd garanterer ikke at et vannmerke kan oppdages, særlig i korte tekstutdrag eller tekster med lite rom for variasjon i ordvalget.
Jeg bruker OpenAIs modeller gjennom en skytjeneste. Inneholder resultatene derfra også opprinnelsessignaler?
Vi samarbeider med alle våre sky- og distribusjonsleverandører for å sikre at opprinnelsessignaler, inkludert vannmerker, bygges inn i alt generert innhold som egner seg for det, inkludert bilder, lyd og tekst. Tilgjengeligheten kan variere etter innhold og partner.
Erstatter opprinnelsessignaler synlig KI-merking eller andre opplysninger om KI-bruk?
Nei. Vannmerker og C2PA-metadata gir informasjon som programvare kan lese. De erstatter ikke synlige etiketter, bannere eller andre merknader som kan være påkrevd.
Om du må gi ytterligere opplysninger, avhenger av hvordan og hvor du bruker innholdet. OpenAI kan ikke gi deg råd om dine konkrete juridiske forpliktelser. Dine juridiske rådgivere bør vurdere hvilke krav som gjelder for din bruk.
Jeg har flere spørsmål om EUs KI-forordning
Send inn en henvendelse om EUs KI-forordning, så tar vi kontakt med deg.