
OpenAI zet zich in voor een veiliger en transparanter AI-ecosysteem. Daarom gebruiken we herkomstsignalen om mensen te helpen vaststellen of content met een OpenAI-model is gegenereerd.
Herkomstsignalen kunnen nuttige informatie over de oorsprong bieden. Ze garanderen echter niet dat de content juist of onbewerkt is, dat iemand er rechtmatig eigenaar van is of dat de content in de juiste context wordt gepresenteerd.
Herkomstsignalen van OpenAI
Welke herkomstsignalen gebruikt OpenAI?
OpenAI gebruikt verschillende herkomstsignalen voor verschillende soorten content.
| Soort content | Herkomstsignalen | Opmerkingen |
|---|---|---|
| Afbeeldingen | Content Credentials en SynthID-watermerken | Afbeeldingen die met ChatGPT, Codex of de OpenAI API zijn gegenereerd, bevatten beide signalen. |
| Audio | SynthID-watermerken | Audio die door ChatGPT of de OpenAI API is gegenereerd, bevat een onhoorbaar watermerk dat in de audio zelf is ingebed. |
| Tekst | textGrain-watermerken (alleen EU) | Om te voldoen aan de EU AI-verordening wordt bij tekst die ChatGPT in de EU genereert een onzichtbare wijziging aangebracht in het toevalsproces waarmee het model woorden kiest. API-klanten wereldwijd kunnen via hun project- of organisatie-instellingen tekstwatermerken inschakelen voor tekstuitvoer. |
| Video | Content Credentials | Sora is stopgezet. Meer informatie. |
De ondersteuning kan verschillen per product, model, exportmethode en bestandstype, en kan afhangen van het moment waarop de content is gemaakt. API-uitvoer wordt ondersteund, behalve bij modellen die binnenkort worden uitgefaseerd, waaronder gpt-image-1, gpt-image-1.5 en sora-2.
Waarom worden voor sommige soorten content meerdere signalen gebruikt?
Waar dat technisch haalbaar is, combineert OpenAI metadata en watermerken, zodat ze elkaars beperkingen kunnen opvangen. Metadata kunnen gedetailleerde informatie bevatten, maar kunnen door platforms, bewerkingstools en bestandsconversies worden verwijderd. Watermerken bevatten minder context, maar zijn ingebed in de gegenereerde content zelf. Daardoor kunnen ze behouden blijven bij sommige bewerkingen waarbij metadata verloren gaan.
Hoe goed zijn herkomstsignalen bestand tegen wijzigingen in de content?
SynthID-watermerken voor afbeeldingen en audio en textGrain-watermerken voor tekst zijn ontworpen om bestand te zijn tegen veelvoorkomende wijzigingen. Afhankelijk van het soort content gaat het bijvoorbeeld om lichte bewerkingen, kopiëren en plakken, bijsnijden of screenshots maken. Ingrijpendere wijzigingen — zoals sterk bijsnijden van afbeeldingen, bestandscompressie, uitvoerig parafraseren of vertalen — kunnen ervoor zorgen dat een watermerk niet meer detecteerbaar is. Na ingrijpende wijzigingen kan het ook minder zinvol zijn om het resultaat te omschrijven als "door OpenAI gegenereerd".
Content Credentials, ontwikkeld door de Coalition for Content Provenance and Authenticity, kunnen verloren gaan door alledaagse handelingen, zoals een screenshot maken of een bestand converteren. Als ze behouden blijven, kunnen ze meer details over de oorsprong en geschiedenis van een bestand geven dan alleen een watermerk.
Waar dat technisch mogelijk is, gebruiken we beide methoden om de kans te vergroten dat herkomstinformatie behouden blijft bij wijzigingen in de content.
Wat zijn Content Credentials en wat kun je ermee?
Content Credentials voegen informatie toe over de oorsprong en geschiedenis van een bestand, bijvoorbeeld met welke tool het is gemaakt en wanneer. Ze maken gebruik van een open standaard die is ontwikkeld door de Coalition for Content Provenance and Authenticity (C2PA). Daarom worden ze ook wel "C2PA-metadata" genoemd.
Content Credentials helpen mensen te controleren waar content vandaan komt. Ze worden niet alleen voor AI-gegenereerde content gebruikt: ook camerafabrikanten, nieuwsorganisaties en anderen gebruiken de standaard om de bron en geschiedenis van hun media te certificeren. Meer informatie over C2PA.
Wat is SynthID en wat kun je ermee?
SynthID is een door Google DeepMind ontwikkelde technologie voor onzichtbare watermerken die een signaal rechtstreeks in gegenereerde media inbedt. Anders dan metadata maakt het signaal deel uit van de content zelf en kan het na bepaalde bewerkingen of aanpassingen behouden blijven. SynthID biedt een aanvullend herkomstsignaal naast C2PA-metadata. Als metadata bijvoorbeeld uit een bestand worden verwijderd, kan een ingebed watermerk nog steeds aangeven dat de content met ondersteunde tools van OpenAI is gegenereerd. Meer informatie over SynthID.
Waarom voorzien jullie tekstuitvoer van watermerken?
We voeren tekstwatermerken in voor ChatGPT-gebruikers in de EU om te voldoen aan de EU AI-verordening. Dit is ook in lijn met onze toezeggingen onder de EU-gedragscode voor transparantie van AI-gegenereerde content, die OpenAI samen met verschillende andere grote AI-aanbieders heeft ondertekend.
Wat is textGrain en wat kun je ermee?
textGrain is de technologie van OpenAI voor het aanbrengen van tekstwatermerken. De technologie past op subtiele wijze aan hoe het model tijdens het schrijven willekeurig kiest uit mogelijke woorden of woorddelen. Deze keuzes vormen over een passage heen een patroon dat een detector kan opsporen, ook na bepaalde bewerkingen.
Het watermerk zit in de formulering zelf en is niet zichtbaar voor lezers. Er worden geen verborgen tekens, onzichtbare spaties of ongebruikelijke leestekens toegevoegd. Tekstwatermerken helpen te voldoen aan de verplichting uit de EU AI-verordening om gegenereerde tekst te markeren.
Verificatietools van OpenAI
Hoe kan ik controleren of content met tools van OpenAI is gegenereerd?
Ga naar openai.com/verify om te controleren of een ondersteund afbeeldings- of audiobestand herkomstsignalen bevat die horen bij content die met tools van OpenAI is gegenereerd of geëxporteerd. Nadat je een ondersteund bestand hebt geüpload, zoekt de tool naar ondersteunde herkomstsignalen van OpenAI, zoals een SynthID-watermerk of een vertrouwd C2PA-manifest dat aan OpenAI is gekoppeld. Als de tool een ondersteund herkomstsignaal van OpenAI vindt, wijst dit erop dat de content waarschijnlijk door een OpenAI-model is gegenereerd.
Ontwikkelaars en organisaties kunnen ook de Content Provenance API van OpenAI gebruiken om afbeeldingen en audio op herkomstsignalen van OpenAI te controleren en verificatie in hun eigen toepassingen of workflows te integreren. Organisaties met een toepassing die aan de voorwaarden voldoet, kunnen hogere limieten aanvragen.
In lijn met onze verplichtingen onder de EU AI-verordening kunnen organisaties met een toepassing die aan de voorwaarden voldoet toegang tot de tekstdetector aanvragen. Dit zijn bijvoorbeeld academische instellingen en onderzoeksorganisaties die onderzoek doen naar tekstherkomst, de betrouwbaarheid van detectie of hoe mensen de resultaten van herkomstcontroles begrijpen. We beoordelen aanvragen van organisaties die aan de voorwaarden voldoen afzonderlijk en nemen waar nodig contact op met een update of een verzoek om aanvullende informatie. Ons toegangsbeleid kan veranderen naarmate we meer leren en de technologie verbeteren.
We werken momenteel samen met een beperkte groep onderzoekers, waaronder John Thickstun, universitair docent informatica aan Cornell University, Martin Vechev, hoogleraar informatica aan ETH Zürich en wetenschappelijk directeur van INSAIT, en onderzoekers van het Kempelen Institute of Intelligent Technologies (KInIT). Zo willen we de mogelijkheden en beperkingen van de technologie beter begrijpen en inzichten opdoen om tekstwatermerken te verbeteren.
Wie komt in aanmerking voor hogere verificatielimieten en zijn er kosten verbonden aan controles?
Controles via de Content Provenance API zijn momenteel gratis en er gelden gebruikslimieten. Het programma voor hogere limieten richt zich op projecten die aan de voorwaarden voldoen en die het algemeen belang dienen door herkomstcontrole of het bewaken van informatie-integriteit. Voorbeelden zijn verificatie door nieuwsredacties, factchecking, onderzoek naar de herkomst van content en toezicht door regelgevende instanties.
Algemene zakelijke toepassingen vallen momenteel buiten de reikwijdte van het programma. Dit geldt bijvoorbeeld voor commerciële fraudepreventie, authenticatie en verificatie, of doorverkoop als onderdeel van dienstenpakketten voor herkomstcontrole en data-analyse.
Organisaties met een toepassing die aan de voorwaarden voldoet, kunnen hogere limieten aanvragen, maar het indienen van een aanvraag garandeert geen goedkeuring. De openbare API blijft beschikbaar met de standaardlimieten, ook voor kleinschalige evaluaties. Raadpleeg de documentatie van de Content Provenance API voor de actuele gebruikslimieten.
Wie komt in aanmerking voor toegang tot de tekstdetector en zijn er kosten verbonden aan controles?
Controles met de tekstdetector zijn momenteel gratis. In aanmerking komen onder meer toepassingen van academische instellingen en onderzoeksorganisaties die onderzoek doen naar tekstherkomst, de betrouwbaarheid van detectie of hoe mensen de resultaten van herkomstcontroles begrijpen.
Algemene zakelijke toepassingen vallen momenteel buiten de reikwijdte van het programma. Dit geldt bijvoorbeeld voor commerciële fraudepreventie, authenticatie en verificatie, of doorverkoop als onderdeel van dienstenpakketten voor herkomstcontrole en data-analyse.
Toepassingen voor academische integriteit, zoals het controleren van studentenwerk op AI-gebruik (bijvoorbeeld bij het schrijven van essays of scripties), vallen ook momenteel buiten de reikwijdte van het programma.
Wat betekenen de verificatieresultaten?
Als via openai.com/verify of de Content Provenance API van OpenAI een signaal wordt gedetecteerd, betekent dit dat de geüploade content een ondersteund herkomstsignaal bevat dat aan OpenAI is gekoppeld. De tool bevestigt niet dat de content juist of onbewerkt is, dat iemand er rechtmatig eigenaar van is of dat de content in de juiste context wordt gepresenteerd. De tool stelt ook niet vast wie de content heeft gemaakt of waarom die is gemaakt.
Als er geen signaal wordt gedetecteerd, betekent dit dat de tool geen door OpenAI aangebrachte herkomstsignalen in het geüploade bestand heeft gevonden. De content kan nog steeds door OpenAI zijn gegenereerd of geëxporteerd als:
De content is gemaakt voordat herkomstsignalen beschikbaar waren.
De content afkomstig is van een niet-ondersteund product, model, exportmethode of bestandstype.
Metadata zijn verwijderd tijdens het uploaden, downloaden, bewerken, converteren of delen.
Een watermerk is verzwakt door compressie, bijsnijden, ruis, bewerkingen, conversie naar een andere bestandsindeling of andere aanpassingen.
Een audiofragment te kort is of ingrijpend is gewijzigd.
Hoe krijg ik het meest betrouwbare verificatieresultaat?
Upload één ondersteund bestand tegelijk en gebruik waar mogelijk het oorspronkelijke geëxporteerde bestand. Snijd afbeeldingen niet bij en converteer ze niet voordat je ze controleert. Bij audio leveren fragmenten van 10 tot 60 seconden over het algemeen de beste resultaten op. Houd ook als er geen signaal wordt gedetecteerd rekening met de bron en context van het bestand voordat je een conclusie trekt.
Tonen de resultaten mijn prompt of persoonsgegevens?
Herkomstsignalen bevatten geen gegevens over de gebruiker, de organisatie of de prompt.
Wat gebeurt er met content die ik verifieer via openai.com/verify of de Content Provenance API?
Content die je uploadt naar openai.com/verify of ter verificatie naar onze Content Provenance API stuurt, wordt uitsluitend verwerkt om te controleren op ondersteunde herkomstsignalen. De content wordt niet opgeslagen, tenzij dit wettelijk verplicht is, en wordt niet gebruikt om OpenAI-modellen te trainen.
Kan OpenAI content detecteren die met andere AI-tools is gegenereerd?
Onze tools voor herkomstcontrole zijn ontworpen om ondersteunde herkomstsignalen te detecteren die horen bij content die door OpenAI-modellen is gegenereerd of met tools van OpenAI is geëxporteerd. Ze zijn niet ontworpen om content te detecteren die door andere AI-modellen is gegenereerd. Ook door OpenAI gegenereerde content wordt mogelijk niet gedetecteerd als het betreffende signaal ontbreekt, niet wordt ondersteund of is verzwakt.
Hoe watermerken werken
Stellen watermerken auteurschap, eigendom of juridische verantwoordelijkheid vast?
Nee. Een watermerk is een aanwijzing dat een OpenAI-model de content waarschijnlijk heeft gegenereerd of verwerkt. Op zichzelf stelt het niet vast wie de auteur of eigenaar van de content is, of er een meldingsplicht gold of wie juridisch verantwoordelijk is. Het laat ook niet zien of het model content heeft bewerkt die een gebruiker heeft geüpload.
Geven watermerken aan in welke mate een OpenAI-model betrokken was?
Nee. De detector meldt of er een watermerk is gevonden. Een gevonden watermerk is een aanwijzing dat een OpenAI-model de content waarschijnlijk heeft gegenereerd of verwerkt. Het laat echter niet zien of het model een deel of alles heeft gegenereerd, of hoeveel een persoon heeft bijgedragen.
Hoe werken tekstwatermerken?
Bij het aanbrengen van een tekstwatermerk wordt tijdens het schrijven een geheim patroon gecreëerd in de keuzes die het model maakt voor woorden en woorddelen, ook wel "tokens" genoemd.
Bij elke stap kent het model een waarschijnlijkheid toe aan elk mogelijk volgend token. Het watermerksysteem maakt verschillende aangepaste kansverdelingen, die elk op basis van een geheime sleutel andere keuzes bevoordelen. Deze verdelingen zijn zo op elkaar afgestemd dat hun gemiddelde overeenkomt met de oorspronkelijke kansverdeling van het model. De sleutel bepaalt welke verdeling wordt gebruikt, waarna het model op basis daarvan een nieuwe willekeurige keuze maakt.
Een detector met dezelfde sleutel en bijpassende instellingen kan later controleren of de tekst het geheime patroon vaker volgt dan op basis van toeval te verwachten is.
Worden tekstwatermerken ook toegepast op feitelijke tekst en door gebruikers aangeleverde tekst?
Tekstwatermerken werken alleen als het model iets op verschillende manieren kan verwoorden. Er is minder ruimte voor variatie als een antwoord heel feitelijk of precies moet zijn, zoals het antwoord op een wiskundevraagstuk, of als het model wordt gevraagd aangeleverde tekst ongewijzigd over te nemen. In deze gevallen heeft het model minder ruimte om de formulering aan te passen zonder een merkbaar verschil te veroorzaken. Daardoor wordt het watermerk mogelijk niet gedetecteerd.
Worden tekstwatermerken ook toegepast op korte antwoorden en code?
Korte passages bevatten meestal niet genoeg tekst om een watermerk betrouwbaar te detecteren. Ook code is moeilijker van een watermerk te voorzien, omdat er minder plausibele mogelijkheden zijn voor wat volgt dan in gewone tekst.
Vanwege deze beperkingen stelt de gedragscode voor transparantie van AI-gegenereerde content in het kader van de EU AI-verordening geen watermerken verplicht voor uitvoer van minder dan 200 tokens — ongeveer 150 woorden in het Engels — of voor codefragmenten.
Hoe verschilt de detectie van tekstwatermerken per taal?
De detectiepercentages verschillen per taal. In sommige talen zijn watermerken momenteel gemakkelijker te detecteren dan in andere. We kunnen de sterkte van het watermerk aanpassen om de detectie te verbeteren in talen waarin het signaal zwakker is.
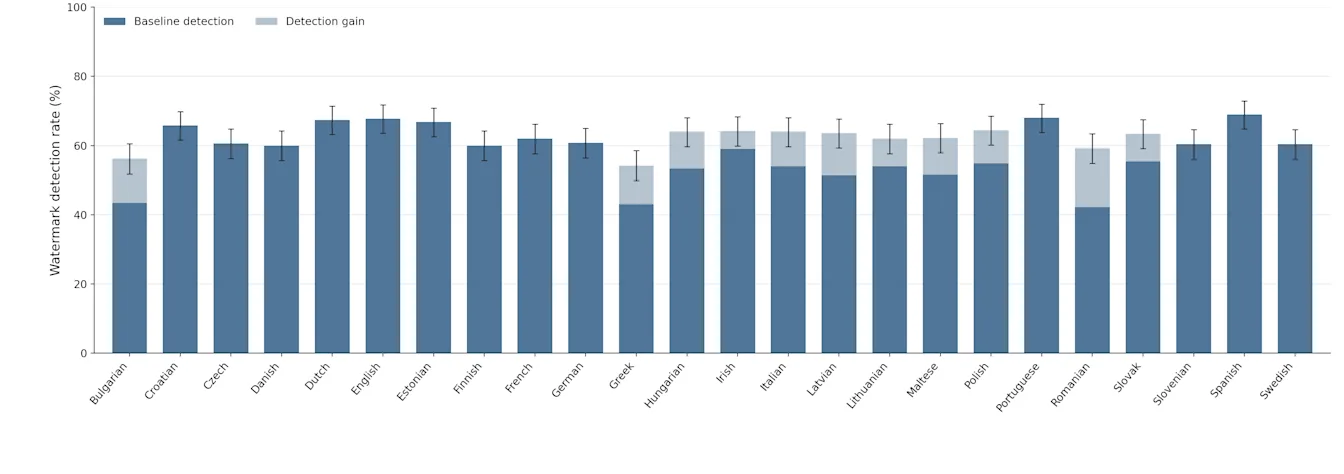
Deze grafiek toont het detectiepercentage voor alle 24 officiële EU-talen. We genereerden eerst 500 synthetische Engelstalige prompts over uiteenlopende onderwerpen en vertaalden die vervolgens naar de andere 23 talen. Bij een foutpositief percentage van 1% heeft het Spaans het hoogste detectiepercentage (69,0%) en het Roemeens het laagste (42,2%). Ons watermerk heeft een instelbare sterkteparameter: een "knop" waarmee het watermerksignaal voor verschillende domeinen sterker of zwakker kan worden gemaakt. Met deze knop konden we de sterkte verhogen voor talen met een detectiepercentage onder de 60%. De lichtblauwe delen van de balken laten de resulterende verbetering zien.
Verminderen tekstwatermerken de kwaliteit van het model?
Uit onze tests blijkt van niet. Bij de benchmarks waarmee we Astra, ons nieuwste grensverleggende model, beoordelen, vallen de prestatieverschillen met en zonder watermerken binnen de gebruikelijke meetruis tussen evaluatierondes. Ook eerdere tests in ChatGPT lieten na de invoering van watermerken geen verandering zien in het percentage duimpjes omlaag of andere productstatistieken.
Maken tekstwatermerken het model trager?
Tekstwatermerken hebben een verwaarloosbare invloed op de snelheid van onze modellen.
Hoe verschillen de tekstwatermerken van OpenAI van AI-detectietools van derden?
Detectietools van derden, zoals Pangram, gebruiken doorgaans classificatiemodellen om AI-gegenereerde tekst te herkennen aan patronen, zoals woordkeuze. Bij die aanpak wordt de tekst na het genereren geanalyseerd, in plaats van dat een ingebed signaal wordt gedetecteerd. De EU AI-verordening vereist specifiek dat er een signaal in gegenereerde tekst wordt ingebed.
Waarom gebruiken jullie eigen tekstwatermerken in plaats van TextSeal of SynthID?
We hebben een eigen methode voor tekstwatermerken ontwikkeld, textGrain. Die geeft ons meer controle dan SynthID of TextSeal over de balans tussen de detecteerbaarheid van het watermerk en de variatie in antwoorden die op dezelfde prompt worden gegenereerd. In onze tests herkende onze methode een even groot of groter aandeel van de tekstvoorbeelden met een watermerk correct dan SynthID voor tekst. We zijn van plan textGrain als opensourcetechnologie uit te brengen, zodat anderen erop kunnen voortbouwen en kunnen helpen tekstwatermerken te verbeteren.
Voegen tekstwatermerken verborgen tekens, extra tokens of zichtbare wijzigingen toe?
Nee. Tekstwatermerken veranderen het statistische patroon van woordkeuzes. Er worden geen verborgen tekens of tokens toegevoegd die uitsluitend voor het watermerk dienen. Het watermerk is niet zichtbaar voor lezers en bij het kopiëren en plakken van de tekst wordt geen verborgen materiaal toegevoegd.
Richtlijnen voor klanten
Ik ben API-klant. Hoe schakel ik tekstwatermerken in?
Klanten van de OpenAI API kunnen tekstwatermerken inschakelen voor een specifiek project via Instellingen, of voor hun hele organisatie via Organisatie-instellingen. In beide gevallen kunnen klanten selecteren voor welke modellen tekstwatermerken worden ingeschakeld. Zodra dit voor een ondersteund model is ingeschakeld, voegt OpenAI het watermerk toe tijdens het genereren van tekst. Klanten hoeven niet aan elk antwoord een aparte markering toe te voegen.
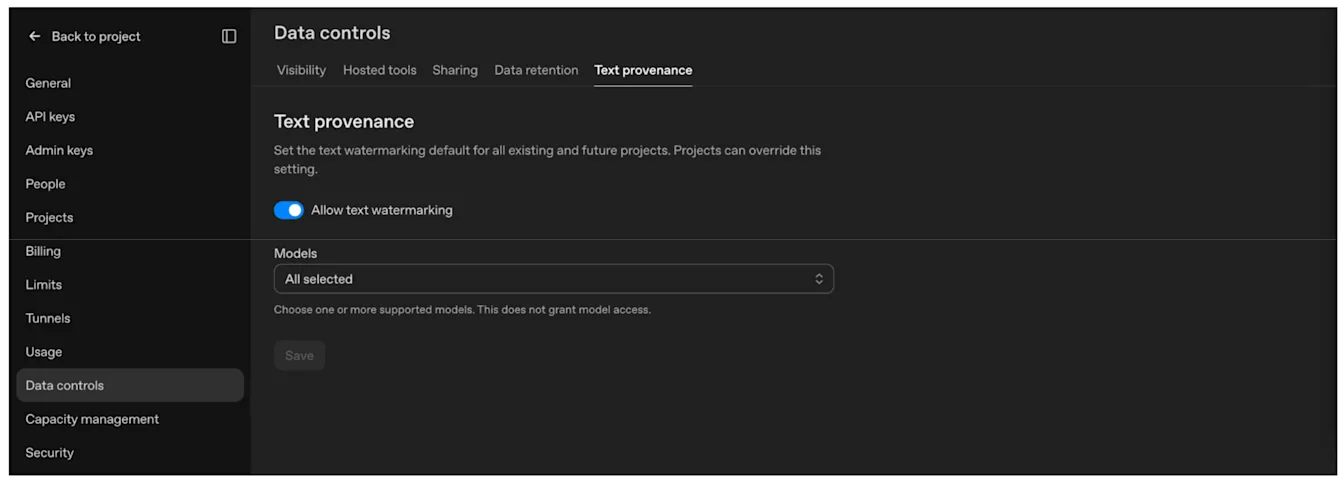
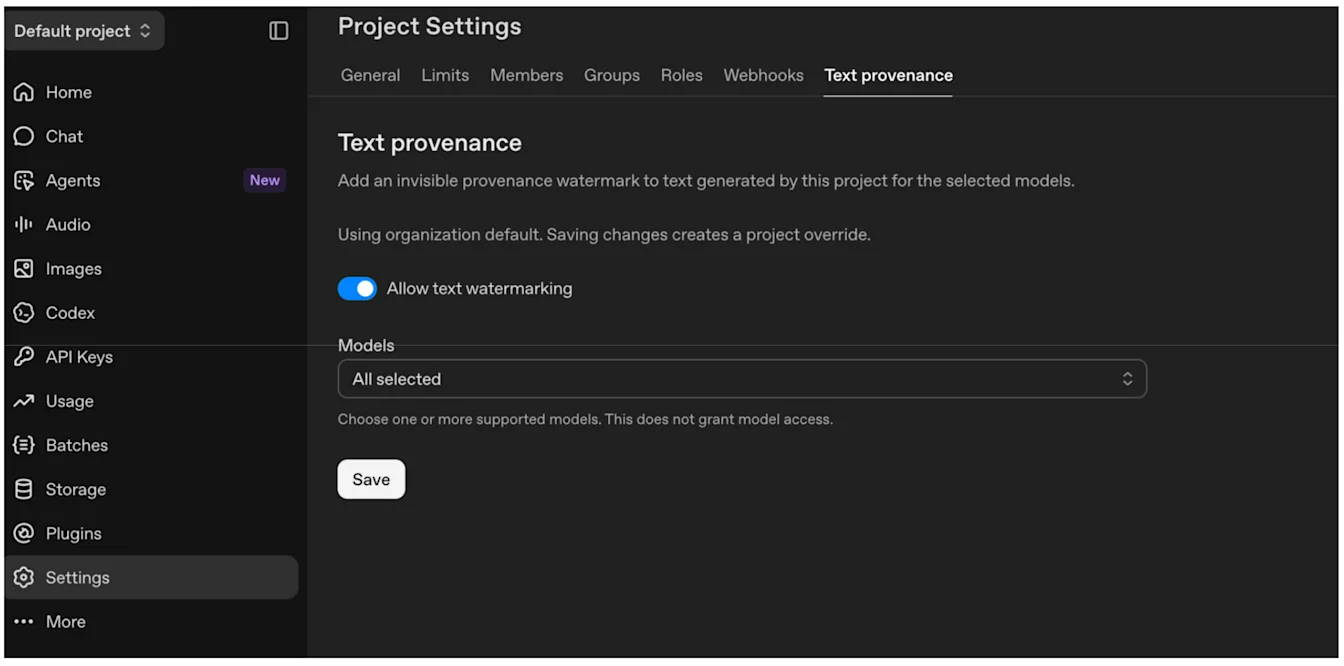
Schakel Tekstwatermerken toestaan in, selecteer je modellen en kies vervolgens Opslaan.
Standaard voor de organisatie: Organisatie-instellingen → Gegevensbeheer → Tekstherkomst.
Afwijkende projectinstelling: Projectinstellingen → Tekstherkomst.
Voor welke modellen kan ik watermerken inschakelen?
Via Instellingen en Organisatie-instellingen kunnen klanten zien voor welke modellen watermerken momenteel beschikbaar zijn. De komende weken breiden we de ondersteuning uit naar alle oudere modellen.
Krijg ik door tekstwatermerken in te schakelen ook toegang tot de tekstdetector?
Nee. Toegang tot de tekstdetector is momenteel beperkt tot goedgekeurde onderzoeksorganisaties en academische instellingen. Zij werken aan het verbeteren van de betrouwbaarheid en gebruiksvriendelijkheid van tekstwatermerken en aan een duidelijkere uitleg van de technologie en de resultaten ervan. Dit is in lijn met onze toezeggingen onder de gedragscode voor transparantie van AI-gegenereerde content in het kader van de EU AI-verordening.
Blijven signalen aan content gekoppeld nadat ik die heb aangepast?
Dat kan, maar het hangt af van het signaal en de wijzigingen die je aanbrengt.
Bewaar bij ondersteunde afbeeldingen en audio een origineel exemplaar en gebruik de Content Provenance API om representatieve bestanden te testen na bewerking, conversie en publicatie. Bij afbeeldingen kunnen bijsnijden, ruis toevoegen, converteren naar JPEG en screenshots maken het moeilijker maken om signalen te detecteren. Je kunt tekst alleen op deze manier testen als je organisatie goedgekeurde toegang tot de tekstdetector heeft.
Behoud bestaande C2PA-metadata en neem Content Credentials op in de bestanden die je maakt, voor zover je bestandsindeling en workflow dit ondersteunen. Je kunt ook overwegen eigen markeringen toe te voegen, zodat herkomstinformatie beter behouden blijft of bruikbaarder wordt. Raadpleeg de technische documentatie van C2PA voor implementatiedetails.
Bij tekst maakt het watermerk deel uit van de woordkeuzes van het model. Als je de formulering behoudt, blijft het signaal naar verwachting aanwezig wanneer je de tekst hergebruikt, zonder dat extra integratiewerk nodig is. Ingrijpend herschrijven, parafraseren of vertalen kan de detectie minder betrouwbaar maken. Zelfs een ongewijzigde formulering garandeert niet dat een watermerk detecteerbaar is, vooral bij korte passages of tekst met weinig ruimte voor andere woordkeuzes.
Ik gebruik de modellen van OpenAI via een clouddienst. Bevat die uitvoer ook herkomstsignalen?
We werken met al onze cloud- en distributiepartners samen om herkomstsignalen, waaronder watermerken, in te bedden in alle uitvoer die daarvoor in aanmerking komt, waaronder afbeeldingen, audio en tekst. De beschikbaarheid kan per uitvoer en per partner verschillen.
Vervangen herkomstsignalen zichtbare AI-labels of andere vermeldingen?
Nee. Watermerken en C2PA-metadata bieden informatie die software kan lezen. Ze vervangen geen zichtbare labels, banners of andere kennisgevingen die mogelijk verplicht zijn.
Of je een aanvullende vermelding nodig hebt, hangt af van hoe en waar je de content gebruikt. OpenAI kan je niet adviseren over je specifieke wettelijke verplichtingen. Je juridische team moet beoordelen welke vereisten gelden voor jouw gebruik.
Ik heb meer vragen over de EU AI-verordening
Stel een vraag over de EU AI-verordening en we nemen contact met je op.