
ਵਧੇਰੇ ਸੁਰੱਖਿਅਤ ਅਤੇ ਪਾਰਦਰਸ਼ੀ ਏਆਈ ਵਾਤਾਵਰਨ ਲਈ ਆਪਣੀ ਵਚਨਬੱਧਤਾ ਦੇ ਹਿੱਸੇ ਵਜੋਂ, OpenAI ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਵਰਤਦਾ ਹੈ ਤਾਂ ਜੋ ਲੋਕ ਸਮਝ ਸਕਣ ਕਿ ਸਮੱਗਰੀ OpenAI ਦੇ ਕਿਸੇ ਮਾਡਲ ਨਾਲ ਬਣਾਈ ਗਈ ਸੀ ਜਾਂ ਨਹੀਂ.
ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਸਮੱਗਰੀ ਦੇ ਸਰੋਤ ਬਾਰੇ ਲਾਭਦਾਇਕ ਜਾਣਕਾਰੀ ਦੇ ਸਕਦੇ ਹਨ, ਪਰ ਇਹ ਗਾਰੰਟੀ ਨਹੀਂ ਦਿੰਦੇ ਕਿ ਸਮੱਗਰੀ ਸਹੀ ਹੈ, ਬਿਨਾਂ ਸੋਧ ਵਾਲੀ ਹੈ, ਕਾਨੂੰਨੀ ਮਾਲਕੀ ਹੇਠ ਹੈ ਜਾਂ ਸਹੀ ਸੰਦਰਭ ਵਿੱਚ ਪੇਸ਼ ਕੀਤੀ ਗਈ ਹੈ.
OpenAI ਦੇ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ
OpenAI ਕਿਹੜੇ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਵਰਤਦਾ ਹੈ?
OpenAI ਸਮੱਗਰੀ ਦੀਆਂ ਵੱਖ-ਵੱਖ ਕਿਸਮਾਂ ਲਈ ਵੱਖ-ਵੱਖ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਵਰਤਦਾ ਹੈ.
| ਸਮੱਗਰੀ ਦੀ ਕਿਸਮ | ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ | ਟਿੱਪਣੀਆਂ |
|---|---|---|
| ਤਸਵੀਰਾਂ | ਸਮੱਗਰੀ ਪ੍ਰਮਾਣ-ਪੱਤਰ ਅਤੇ SynthID ਵਾਟਰਮਾਰਕ | ChatGPT, Codex ਜਾਂ OpenAI API ਨਾਲ ਬਣਾਈਆਂ ਤਸਵੀਰਾਂ ਵਿੱਚ ਦੋਵੇਂ ਸੰਕੇਤ ਸ਼ਾਮਲ ਹੁੰਦੇ ਹਨ. |
| ਆਡੀਓ | SynthID ਵਾਟਰਮਾਰਕ | ChatGPT ਜਾਂ OpenAI API ਦੁਆਰਾ ਬਣਾਏ ਆਡੀਓ ਵਿੱਚ ਇੱਕ ਅਜਿਹਾ ਵਾਟਰਮਾਰਕ ਹੁੰਦਾ ਹੈ ਜੋ ਸੁਣਾਈ ਨਹੀਂ ਦਿੰਦਾ ਅਤੇ ਆਡੀਓ ਦਾ ਹੀ ਹਿੱਸਾ ਹੁੰਦਾ ਹੈ. |
| ਲਿਖਤ | textGrain ਵਾਟਰਮਾਰਕ (ਸਿਰਫ਼ ਯੂਰਪੀ ਸੰਘ ਵਿੱਚ) | ਯੂਰਪੀ ਸੰਘ ਵਿੱਚ, ਏਆਈ ਕਾਨੂੰਨ ਦੀ ਪਾਲਣਾ ਲਈ ChatGPT ਦੁਆਰਾ ਬਣਾਈ ਲਿਖਤ ਵਿੱਚ ਮਾਡਲ ਦੀ ਸ਼ਬਦ-ਚੋਣ ਲਈ ਵਰਤੀ ਜਾਂਦੀ ਬੇਤਰਤੀਬੀ ਵਿੱਚ ਇੱਕ ਅਦਿੱਖ ਤਬਦੀਲੀ ਕੀਤੀ ਜਾਂਦੀ ਹੈ. ਦੁਨੀਆ ਭਰ ਦੇ API ਗਾਹਕ ਆਪਣੇ ਪ੍ਰੋਜੈਕਟ ਜਾਂ ਸੰਸਥਾ ਦੀਆਂ ਸੈਟਿੰਗਾਂ ਰਾਹੀਂ ਲਿਖਤ ਦੇ ਨਤੀਜਿਆਂ ਲਈ ਵਾਟਰਮਾਰਕ ਚਾਲੂ ਕਰ ਸਕਦੇ ਹਨ. |
| ਵੀਡੀਓ | ਸਮੱਗਰੀ ਪ੍ਰਮਾਣ-ਪੱਤਰ | Sora ਬੰਦ ਕਰ ਦਿੱਤਾ ਗਿਆ ਹੈ. ਹੋਰ ਜਾਣੋ. |
ਇਹ ਸਹੂਲਤ ਉਤਪਾਦ, ਮਾਡਲ, ਨਿਰਯਾਤ ਦੇ ਤਰੀਕੇ, ਫ਼ਾਈਲ ਦੀ ਕਿਸਮ ਅਤੇ ਸਮੱਗਰੀ ਬਣਾਏ ਜਾਣ ਦੇ ਸਮੇਂ ਮੁਤਾਬਕ ਵੱਖਰੀ ਹੋ ਸਕਦੀ ਹੈ. ਇਹ ਸਹੂਲਤ API ਦੇ ਨਤੀਜਿਆਂ ਲਈ ਉਪਲਬਧ ਹੈ, ਸਿਵਾਏ ਉਨ੍ਹਾਂ ਮਾਡਲਾਂ ਦੇ ਜਿਨ੍ਹਾਂ ਦਾ ਸਮਰਥਨ ਜਲਦੀ ਖ਼ਤਮ ਕਰਨ ਦੀ ਯੋਜਨਾ ਹੈ, ਜਿਨ੍ਹਾਂ ਵਿੱਚ gpt-image-1, gpt-image-1.5 ਅਤੇ sora-2 ਸ਼ਾਮਲ ਹਨ.
ਸਮੱਗਰੀ ਦੀਆਂ ਕੁਝ ਕਿਸਮਾਂ ਲਈ ਕਈ ਸੰਕੇਤ ਕਿਉਂ ਵਰਤੇ ਜਾਂਦੇ ਹਨ?
ਜਦੋਂ ਤਕਨੀਕੀ ਤੌਰ 'ਤੇ ਸੰਭਵ ਹੋਵੇ, OpenAI ਮੈਟਾਡਾਟਾ ਅਤੇ ਵਾਟਰਮਾਰਕ ਇਕੱਠੇ ਵਰਤਦਾ ਹੈ ਤਾਂ ਜੋ ਹਰ ਇੱਕ ਦੂਜੇ ਦੀਆਂ ਸੀਮਾਵਾਂ ਦੀ ਭਰਪਾਈ ਕਰ ਸਕੇ. ਮੈਟਾਡਾਟਾ ਵਿੱਚ ਵਿਸਤ੍ਰਿਤ ਜਾਣਕਾਰੀ ਹੋ ਸਕਦੀ ਹੈ, ਪਰ ਪਲੇਟਫ਼ਾਰਮ, ਸੋਧ ਦੇ ਸਾਧਨ ਅਤੇ ਫ਼ਾਈਲ ਫ਼ਾਰਮੈਟ ਬਦਲਣ ਦੀਆਂ ਪ੍ਰਕਿਰਿਆਵਾਂ ਇਸ ਨੂੰ ਹਟਾ ਸਕਦੀਆਂ ਹਨ. ਵਾਟਰਮਾਰਕ ਘੱਟ ਸੰਦਰਭ ਦਿੰਦੇ ਹਨ, ਪਰ ਕਿਉਂਕਿ ਉਹ ਬਣਾਈ ਗਈ ਸਮੱਗਰੀ ਦਾ ਹੀ ਹਿੱਸਾ ਹੁੰਦੇ ਹਨ, ਇਸ ਲਈ ਉਹ ਕੁਝ ਅਜਿਹੀਆਂ ਤਬਦੀਲੀਆਂ ਤੋਂ ਬਾਅਦ ਵੀ ਬਚੇ ਰਹਿ ਸਕਦੇ ਹਨ ਜੋ ਮੈਟਾਡਾਟਾ ਹਟਾ ਦਿੰਦੀਆਂ ਹਨ.
ਸਮੱਗਰੀ ਵਿੱਚ ਸੋਧਾਂ ਹੋਣ 'ਤੇ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਕਿੰਨੇ ਟਿਕਾਊ ਹੁੰਦੇ ਹਨ?
ਤਸਵੀਰਾਂ ਅਤੇ ਆਡੀਓ ਲਈ SynthID ਵਾਟਰਮਾਰਕ ਅਤੇ ਲਿਖਤ ਲਈ textGrain ਵਾਟਰਮਾਰਕ ਆਮ ਤਬਦੀਲੀਆਂ ਤੋਂ ਬਾਅਦ ਵੀ ਬਣੇ ਰਹਿਣ ਲਈ ਤਿਆਰ ਕੀਤੇ ਗਏ ਹਨ. ਸਮੱਗਰੀ ਦੀ ਕਿਸਮ ਮੁਤਾਬਕ, ਇਨ੍ਹਾਂ ਤਬਦੀਲੀਆਂ ਵਿੱਚ ਮਾਮੂਲੀ ਸੋਧਾਂ, ਕਾਪੀ ਕਰਕੇ ਚਿਪਕਾਉਣਾ, ਕੱਟਣਾ ਜਾਂ ਸਕ੍ਰੀਨਸ਼ਾਟ ਲੈਣਾ ਸ਼ਾਮਲ ਹੋ ਸਕਦੇ ਹਨ. ਵਧੇਰੇ ਵੱਡੀਆਂ ਤਬਦੀਲੀਆਂ—ਜਿਵੇਂ ਤਸਵੀਰ ਦਾ ਬਹੁਤ ਸਾਰਾ ਹਿੱਸਾ ਕੱਟਣਾ, ਫ਼ਾਈਲ ਸੰਕੁਚਿਤ ਕਰਨਾ, ਲਿਖਤ ਨੂੰ ਕਾਫ਼ੀ ਵੱਖਰੇ ਸ਼ਬਦਾਂ ਵਿੱਚ ਲਿਖਣਾ ਜਾਂ ਅਨੁਵਾਦ ਕਰਨਾ—ਵਾਟਰਮਾਰਕ ਨੂੰ ਪਛਾਣਨਾ ਅਸੰਭਵ ਬਣਾ ਸਕਦੀਆਂ ਹਨ. ਵੱਡੀਆਂ ਤਬਦੀਲੀਆਂ ਤੋਂ ਬਾਅਦ, ਨਤੀਜੇ ਨੂੰ “OpenAI ਦੁਆਰਾ ਬਣਾਇਆ” ਕਹਿਣਾ ਵੀ ਸ਼ਾਇਦ ਘੱਟ ਅਰਥਪੂਰਨ ਹੋਵੇ.
ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਅਤੇ ਪ੍ਰਮਾਣਿਕਤਾ ਲਈ ਗੱਠਜੋੜ ਦੁਆਰਾ ਵਿਕਸਿਤ ਸਮੱਗਰੀ ਪ੍ਰਮਾਣ-ਪੱਤਰ ਰੋਜ਼ਾਨਾ ਦੇ ਕੰਮਾਂ ਦੌਰਾਨ ਗੁੰਮ ਹੋ ਸਕਦੇ ਹਨ, ਜਿਵੇਂ ਸਕ੍ਰੀਨਸ਼ਾਟ ਲੈਣਾ ਜਾਂ ਫ਼ਾਈਲ ਦਾ ਫ਼ਾਰਮੈਟ ਬਦਲਣਾ. ਜਦੋਂ ਇਹ ਉਪਲਬਧ ਰਹਿੰਦੇ ਹਨ, ਤਾਂ ਇਹ ਇਕੱਲੇ ਵਾਟਰਮਾਰਕ ਦੇ ਮੁਕਾਬਲੇ ਫ਼ਾਈਲ ਦੇ ਮੂਲ ਅਤੇ ਇਤਿਹਾਸ ਬਾਰੇ ਵਧੇਰੇ ਵੇਰਵੇ ਦੇ ਸਕਦੇ ਹਨ.
ਜਿੱਥੇ ਤਕਨੀਕੀ ਤੌਰ 'ਤੇ ਸੰਭਵ ਹੋਵੇ, ਅਸੀਂ ਦੋਵੇਂ ਤਰੀਕੇ ਵਰਤਦੇ ਹਾਂ ਤਾਂ ਜੋ ਸਮੱਗਰੀ ਵਿੱਚ ਤਬਦੀਲੀਆਂ ਤੋਂ ਬਾਅਦ ਮੂਲ ਸੰਬੰਧੀ ਜਾਣਕਾਰੀ ਦੇ ਬਚੇ ਰਹਿਣ ਦੀ ਸੰਭਾਵਨਾ ਵਧੇ.
ਸਮੱਗਰੀ ਪ੍ਰਮਾਣ-ਪੱਤਰ ਕੀ ਹਨ ਅਤੇ ਇਨ੍ਹਾਂ ਨਾਲ ਕੀ ਕੀਤਾ ਜਾ ਸਕਦਾ ਹੈ?
ਸਮੱਗਰੀ ਪ੍ਰਮਾਣ-ਪੱਤਰ ਕਿਸੇ ਫ਼ਾਈਲ ਦੇ ਮੂਲ ਅਤੇ ਇਤਿਹਾਸ ਬਾਰੇ ਜਾਣਕਾਰੀ ਉਸ ਨਾਲ ਜੋੜਦੇ ਹਨ, ਜਿਵੇਂ ਕਿ ਉਹ ਕਿਸ ਸਾਧਨ ਨਾਲ ਅਤੇ ਕਦੋਂ ਬਣਾਈ ਗਈ ਸੀ. ਇਹ ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਅਤੇ ਪ੍ਰਮਾਣਿਕਤਾ ਲਈ ਗੱਠਜੋੜ (C2PA) ਦੁਆਰਾ ਵਿਕਸਿਤ ਖੁੱਲ੍ਹੇ ਮਿਆਰ ਦੀ ਵਰਤੋਂ ਕਰਦੇ ਹਨ, ਇਸੇ ਲਈ ਇਨ੍ਹਾਂ ਨੂੰ ਕਈ ਵਾਰ “C2PA ਮੈਟਾਡਾਟਾ” ਕਿਹਾ ਜਾਂਦਾ ਹੈ.
ਸਮੱਗਰੀ ਪ੍ਰਮਾਣ-ਪੱਤਰ ਲੋਕਾਂ ਨੂੰ ਇਹ ਤਸਦੀਕ ਕਰਨ ਵਿੱਚ ਮਦਦ ਕਰਦੇ ਹਨ ਕਿ ਸਮੱਗਰੀ ਕਿੱਥੋਂ ਆਈ ਹੈ. ਇਨ੍ਹਾਂ ਦੀ ਵਰਤੋਂ ਸਿਰਫ਼ ਏਆਈ ਦੁਆਰਾ ਬਣਾਈ ਸਮੱਗਰੀ ਤੱਕ ਸੀਮਤ ਨਹੀਂ ਹੈ: ਕੈਮਰਾ ਨਿਰਮਾਤਾ, ਖ਼ਬਰੀ ਸੰਸਥਾਵਾਂ ਅਤੇ ਹੋਰ ਵੀ ਆਪਣੇ ਮੀਡੀਆ ਦੇ ਸਰੋਤ ਅਤੇ ਇਤਿਹਾਸ ਨੂੰ ਪ੍ਰਮਾਣਿਤ ਕਰਨ ਲਈ ਇਸ ਮਿਆਰ ਦੀ ਵਰਤੋਂ ਕਰਦੇ ਹਨ. C2PA ਬਾਰੇ ਹੋਰ ਜਾਣੋ.
SynthID ਕੀ ਹੈ ਅਤੇ ਇਸ ਨਾਲ ਕੀ ਕੀਤਾ ਜਾ ਸਕਦਾ ਹੈ?
SynthID ਗੂਗਲ ਡੀਪਮਾਈਂਡ ਦੁਆਰਾ ਵਿਕਸਿਤ ਅਦਿੱਖ ਵਾਟਰਮਾਰਕ ਤਕਨਾਲੋਜੀ ਹੈ ਜੋ ਬਣਾਏ ਗਏ ਮੀਡੀਆ ਵਿੱਚ ਸਿੱਧਾ ਇੱਕ ਸੰਕੇਤ ਜੋੜਦੀ ਹੈ. ਮੈਟਾਡਾਟਾ ਤੋਂ ਉਲਟ, ਇਹ ਸੰਕੇਤ ਸਮੱਗਰੀ ਦਾ ਹੀ ਹਿੱਸਾ ਹੁੰਦਾ ਹੈ ਅਤੇ ਕੁਝ ਸੋਧਾਂ ਜਾਂ ਤਬਦੀਲੀਆਂ ਤੋਂ ਬਾਅਦ ਵੀ ਬਣਿਆ ਰਹਿ ਸਕਦਾ ਹੈ. SynthID, C2PA ਮੈਟਾਡਾਟਾ ਦੇ ਨਾਲ-ਨਾਲ ਮੂਲ ਸੰਬੰਧੀ ਇੱਕ ਵਾਧੂ ਸੰਕੇਤ ਦਿੰਦਾ ਹੈ. ਮਿਸਾਲ ਵਜੋਂ, ਜੇ ਕਿਸੇ ਫ਼ਾਈਲ ਵਿੱਚੋਂ ਮੈਟਾਡਾਟਾ ਹਟਾ ਦਿੱਤਾ ਜਾਵੇ, ਤਾਂ ਵੀ ਉਸ ਵਿੱਚ ਜੋੜਿਆ ਵਾਟਰਮਾਰਕ ਇਹ ਸੰਕੇਤ ਦੇ ਸਕਦਾ ਹੈ ਕਿ ਸਮੱਗਰੀ OpenAI ਦੇ ਸਮਰਥਿਤ ਸਾਧਨਾਂ ਨਾਲ ਬਣਾਈ ਗਈ ਸੀ. SynthID ਬਾਰੇ ਹੋਰ ਜਾਣੋ.
ਤੁਸੀਂ ਲਿਖਤ ਦੇ ਨਤੀਜਿਆਂ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਕਿਉਂ ਜੋੜ ਰਹੇ ਹੋ?
ਅਸੀਂ ਯੂਰਪੀ ਸੰਘ ਦੇ ਏਆਈ ਕਾਨੂੰਨ ਦੀ ਪਾਲਣਾ ਕਰਨ ਲਈ ਯੂਰਪੀ ਸੰਘ ਵਿੱਚ ChatGPT ਵਰਤੋਂਕਾਰਾਂ ਲਈ ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਵਿਵਸਥਾ ਲਾਗੂ ਕਰ ਰਹੇ ਹਾਂ. ਇਹ ਏਆਈ ਦੁਆਰਾ ਬਣਾਈ ਸਮੱਗਰੀ ਦੀ ਪਾਰਦਰਸ਼ਤਾ ਬਾਰੇ ਯੂਰਪੀ ਸੰਘ ਦੀ ਅਮਲ ਸੰਹਿਤਾ ਤਹਿਤ ਸਾਡੀਆਂ ਵਚਨਬੱਧਤਾਵਾਂ ਦੇ ਅਨੁਕੂਲ ਵੀ ਹੈ, ਜਿਸ 'ਤੇ OpenAI ਅਤੇ ਕਈ ਹੋਰ ਪ੍ਰਮੁੱਖ ਏਆਈ ਪ੍ਰਦਾਤਾਵਾਂ ਨੇ ਦਸਤਖ਼ਤ ਕੀਤੇ ਹਨ.
textGrain ਕੀ ਹੈ ਅਤੇ ਇਸ ਨਾਲ ਕੀ ਕੀਤਾ ਜਾ ਸਕਦਾ ਹੈ?
textGrain ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਲਈ OpenAI ਦੀ ਤਕਨਾਲੋਜੀ ਹੈ. ਇਹ ਮਾਡਲ ਦੇ ਲਿਖਣ ਵੇਲੇ ਸੰਭਾਵੀ ਸ਼ਬਦਾਂ ਜਾਂ ਸ਼ਬਦਾਂ ਦੇ ਹਿੱਸਿਆਂ ਵਿੱਚੋਂ ਬੇਤਰਤੀਬ ਢੰਗ ਨਾਲ ਚੋਣ ਕਰਨ ਦੇ ਤਰੀਕੇ ਵਿੱਚ ਸੂਖਮ ਤਬਦੀਲੀ ਕਰਦੀ ਹੈ. ਪੂਰੇ ਅੰਸ਼ ਵਿੱਚ ਇਹ ਚੋਣਾਂ ਇੱਕ ਅਜਿਹਾ ਨਮੂਨਾ ਬਣਾਉਂਦੀਆਂ ਹਨ ਜਿਸ ਨੂੰ ਪਛਾਣ ਸਾਧਨ ਕੁਝ ਸੋਧਾਂ ਤੋਂ ਬਾਅਦ ਵੀ ਲੱਭ ਸਕਦਾ ਹੈ.
ਵਾਟਰਮਾਰਕ ਸ਼ਬਦਾਵਲੀ ਦਾ ਹੀ ਹਿੱਸਾ ਹੁੰਦਾ ਹੈ ਅਤੇ ਪਾਠਕਾਂ ਨੂੰ ਦਿਖਾਈ ਨਹੀਂ ਦਿੰਦਾ. ਇਹ ਲੁਕਵੇਂ ਅੱਖਰ, ਅਦਿੱਖ ਖਾਲੀ ਥਾਵਾਂ ਜਾਂ ਅਸਾਧਾਰਨ ਵਿਸ਼ਰਾਮ ਚਿੰਨ੍ਹ ਨਹੀਂ ਜੋੜਦਾ. ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨਾ, ਬਣਾਈ ਗਈ ਲਿਖਤ ਨੂੰ ਚਿੰਨ੍ਹਿਤ ਕਰਨ ਦੀ ਯੂਰਪੀ ਸੰਘ ਦੇ ਏਆਈ ਕਾਨੂੰਨ ਦੀ ਲੋੜ ਪੂਰੀ ਕਰਨ ਵਿੱਚ ਮਦਦ ਕਰਦਾ ਹੈ.
OpenAI ਦੇ ਤਸਦੀਕ ਸਾਧਨ
ਮੈਂ ਕਿਵੇਂ ਜਾਂਚ ਸਕਦਾ ਹਾਂ ਕਿ ਸਮੱਗਰੀ OpenAI ਦੇ ਸਾਧਨਾਂ ਨਾਲ ਬਣਾਈ ਗਈ ਸੀ?
ਤੁਸੀਂ openai.com/verify 'ਤੇ ਜਾ ਕੇ ਜਾਂਚ ਸਕਦੇ ਹੋ ਕਿ ਕਿਸੇ ਸਮਰਥਿਤ ਤਸਵੀਰ ਜਾਂ ਆਡੀਓ ਫ਼ਾਈਲ ਵਿੱਚ OpenAI ਦੇ ਸਾਧਨਾਂ ਦੁਆਰਾ ਬਣਾਈ ਜਾਂ ਨਿਰਯਾਤ ਕੀਤੀ ਸਮੱਗਰੀ ਨਾਲ ਜੁੜੇ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਹਨ ਜਾਂ ਨਹੀਂ. ਤੁਹਾਡੇ ਵੱਲੋਂ ਸਮਰਥਿਤ ਫ਼ਾਈਲ ਅੱਪਲੋਡ ਕਰਨ ਤੋਂ ਬਾਅਦ, ਇਹ ਸਾਧਨ OpenAI ਦੇ ਸਮਰਥਿਤ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਲੱਭੇਗਾ, ਜਿਵੇਂ ਕਿ SynthID ਵਾਟਰਮਾਰਕ ਜਾਂ OpenAI ਨਾਲ ਜੁੜਿਆ ਭਰੋਸੇਯੋਗ C2PA ਮੈਨੀਫੈਸਟ. ਜੇ ਸਾਧਨ ਨੂੰ OpenAI ਦਾ ਕੋਈ ਸਮਰਥਿਤ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਮਿਲਦਾ ਹੈ, ਤਾਂ ਇਹ ਦਰਸਾਉਂਦਾ ਹੈ ਕਿ ਸਮੱਗਰੀ ਸੰਭਾਵਤ ਤੌਰ 'ਤੇ OpenAI ਦੇ ਕਿਸੇ ਮਾਡਲ ਨੇ ਬਣਾਈ ਸੀ.
ਡਿਵੈਲਪਰ ਅਤੇ ਸੰਸਥਾਵਾਂ ਤਸਵੀਰਾਂ ਅਤੇ ਆਡੀਓ ਵਿੱਚ OpenAI ਦੇ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤਾਂ ਦੀ ਜਾਂਚ ਕਰਨ ਅਤੇ ਆਪਣੀਆਂ ਐਪਲੀਕੇਸ਼ਨਾਂ ਜਾਂ ਕਾਰਜ-ਪ੍ਰਵਾਹਾਂ ਵਿੱਚ ਤਸਦੀਕ ਜੋੜਨ ਲਈ OpenAI ਦੀ ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਵਾਲੀ API ਵੀ ਵਰਤ ਸਕਦੇ ਹਨ. ਯੋਗ ਵਰਤੋਂ-ਉਦੇਸ਼ ਵਾਲੀਆਂ ਸੰਸਥਾਵਾਂ ਵਧੀਆਂ ਹੱਦਾਂ ਲਈ ਅਰਜ਼ੀ ਦੇ ਸਕਦੀਆਂ ਹਨ.
ਲਿਖਤ ਦੇ ਮਾਮਲੇ ਵਿੱਚ, ਯੂਰਪੀ ਸੰਘ ਦੇ ਏਆਈ ਕਾਨੂੰਨ ਤਹਿਤ ਸਾਡੀਆਂ ਜ਼ਿੰਮੇਵਾਰੀਆਂ ਮੁਤਾਬਕ, ਯੋਗ ਵਰਤੋਂ-ਉਦੇਸ਼ ਵਾਲੀਆਂ ਸੰਸਥਾਵਾਂ ਲਿਖਤ ਪਛਾਣ ਸਾਧਨ ਤੱਕ ਪਹੁੰਚ ਲਈ ਅਰਜ਼ੀ ਦੇ ਸਕਦੀਆਂ ਹਨ. ਇਨ੍ਹਾਂ ਵਿੱਚ ਲਿਖਤ ਦੇ ਮੂਲ, ਪਛਾਣ ਦੀ ਭਰੋਸੇਯੋਗਤਾ ਜਾਂ ਲੋਕ ਮੂਲ ਸੰਬੰਧੀ ਨਤੀਜਿਆਂ ਨੂੰ ਕਿਵੇਂ ਸਮਝਦੇ ਹਨ, ਇਸ ਦਾ ਅਧਿਐਨ ਕਰਨ ਵਾਲੀਆਂ ਅਕਾਦਮਿਕ ਅਤੇ ਖੋਜ ਸੰਸਥਾਵਾਂ ਸ਼ਾਮਲ ਹਨ. ਅਸੀਂ ਯੋਗ ਸੰਸਥਾਵਾਂ ਦੀਆਂ ਅਰਜ਼ੀਆਂ ਦੀ ਵੱਖੋ-ਵੱਖਰੇ ਤੌਰ 'ਤੇ ਸਮੀਖਿਆ ਕਰਾਂਗੇ ਅਤੇ ਲੋੜ ਮੁਤਾਬਕ ਤਾਜ਼ਾ ਜਾਣਕਾਰੀ ਦੇਣ ਜਾਂ ਵਾਧੂ ਜਾਣਕਾਰੀ ਮੰਗਣ ਲਈ ਸੰਪਰਕ ਕਰਾਂਗੇ. ਜਿਵੇਂ-ਜਿਵੇਂ ਅਸੀਂ ਹੋਰ ਸਿੱਖਦੇ ਹਾਂ ਅਤੇ ਤਕਨਾਲੋਜੀ ਸੁਧਾਰਦੇ ਹਾਂ, ਪਹੁੰਚ ਦੇਣ ਦਾ ਸਾਡਾ ਤਰੀਕਾ ਬਦਲ ਸਕਦਾ ਹੈ.
ਇਸ ਵੇਲੇ ਅਸੀਂ ਖੋਜਕਰਤਾਵਾਂ ਦੇ ਇੱਕ ਸੀਮਤ ਸਮੂਹ ਨਾਲ ਸਾਂਝੇਦਾਰੀ ਕਰ ਰਹੇ ਹਾਂ ਤਾਂ ਜੋ ਤਕਨਾਲੋਜੀ ਦੀਆਂ ਸਮਰੱਥਾਵਾਂ ਅਤੇ ਸੀਮਾਵਾਂ ਨੂੰ ਬਿਹਤਰ ਸਮਝ ਸਕੀਏ ਅਤੇ ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਤਕਨੀਕ ਸੁਧਾਰ ਸਕੀਏ. ਇਸ ਸਮੂਹ ਵਿੱਚ ਕਾਰਨੇਲ ਯੂਨੀਵਰਸਿਟੀ ਦੇ ਕੰਪਿਊਟਰ ਵਿਗਿਆਨ ਦੇ ਸਹਾਇਕ ਪ੍ਰੋਫੈਸਰ ਜੌਨ ਥਿਕਸਟਨ, ਈਟੀਐੱਚ ਜ਼ਿਊਰਿਖ ਦੇ ਕੰਪਿਊਟਰ ਵਿਗਿਆਨ ਦੇ ਪ੍ਰੋਫੈਸਰ ਅਤੇ INSAIT ਦੇ ਵਿਗਿਆਨਕ ਨਿਰਦੇਸ਼ਕ ਮਾਰਟਿਨ ਵੇਚੇਵ, ਅਤੇ ਕੇਮਪੇਲਨ ਇੰਸਟੀਚਿਊਟ ਆਫ਼ ਇੰਟੈਲੀਜੈਂਟ ਟੈਕਨਾਲੋਜੀਜ਼ (KInIT) ਦੇ ਖੋਜਕਰਤਾ ਸ਼ਾਮਲ ਹਨ.
ਤਸਦੀਕ ਦੀਆਂ ਵਧੀਆਂ ਹੱਦਾਂ ਲਈ ਕੌਣ ਯੋਗ ਹੈ, ਅਤੇ ਕੀ ਜਾਂਚਾਂ ਲਈ ਫ਼ੀਸ ਲੱਗਦੀ ਹੈ?
ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਵਾਲੀ API ਨਾਲ ਜਾਂਚਾਂ ਫ਼ਿਲਹਾਲ ਮੁਫ਼ਤ ਹਨ ਅਤੇ ਵਰਤੋਂ ਦੀਆਂ ਹੱਦਾਂ ਦੇ ਅਧੀਨ ਹਨ. ਵਧੀਆਂ ਹੱਦਾਂ ਵਾਲਾ ਪ੍ਰੋਗਰਾਮ ਲੋਕ-ਹਿੱਤ ਵਿੱਚ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਕਰਨ ਵਾਲੇ ਯੋਗ ਪ੍ਰੋਜੈਕਟਾਂ ਅਤੇ ਜਾਣਕਾਰੀ ਦੀ ਭਰੋਸੇਯੋਗਤਾ ਨਾਲ ਜੁੜੇ ਕਾਰਜ-ਪ੍ਰਵਾਹਾਂ 'ਤੇ ਕੇਂਦਰਿਤ ਹੈ, ਜਿਵੇਂ ਖ਼ਬਰਘਰਾਂ ਵਿੱਚ ਤਸਦੀਕ, ਤੱਥਾਂ ਦੀ ਜਾਂਚ, ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਬਾਰੇ ਖੋਜ ਅਤੇ ਨਿਯਾਮਕ ਨਿਗਰਾਨੀ.
ਆਮ ਕਾਰੋਬਾਰੀ ਵਰਤੋਂਆਂ ਪ੍ਰੋਗਰਾਮ ਦੇ ਦਾਇਰੇ ਤੋਂ ਫ਼ਿਲਹਾਲ ਬਾਹਰ ਹਨ, ਜਿਵੇਂ ਕਿ ਵਪਾਰਕ ਧੋਖਾਧੜੀ ਦੀ ਰੋਕਥਾਮ, ਪ੍ਰਮਾਣਿਕਤਾ ਦੀ ਜਾਂਚ ਅਤੇ ਤਸਦੀਕ, ਜਾਂ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਅਤੇ ਡਾਟਾ ਵਿਸ਼ਲੇਸ਼ਣ ਸੇਵਾਵਾਂ ਦੇ ਪੈਕੇਜ ਦੇ ਹਿੱਸੇ ਵਜੋਂ ਮੁੜ ਵੇਚਣਾ.
ਯੋਗ ਵਰਤੋਂ-ਉਦੇਸ਼ ਵਾਲੀਆਂ ਸੰਸਥਾਵਾਂ ਵਧੀਆਂ ਹੱਦਾਂ ਲਈ ਅਰਜ਼ੀ ਦੇ ਸਕਦੀਆਂ ਹਨ, ਪਰ ਅਰਜ਼ੀ ਦੇਣ ਨਾਲ ਮਨਜ਼ੂਰੀ ਦੀ ਗਾਰੰਟੀ ਨਹੀਂ ਮਿਲਦੀ. ਜਨਤਕ API ਆਪਣੀਆਂ ਮੂਲ ਹੱਦਾਂ ਦੇ ਅਧੀਨ ਉਪਲਬਧ ਰਹਿੰਦੀ ਹੈ, ਜਿਸ ਵਿੱਚ ਛੋਟੇ ਮੁਲਾਂਕਣਾਂ ਲਈ ਵਰਤੋਂ ਵੀ ਸ਼ਾਮਲ ਹੈ. ਵਰਤੋਂ ਦੀਆਂ ਮੌਜੂਦਾ ਹੱਦਾਂ ਲਈ ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਵਾਲੀ API ਦੇ ਦਸਤਾਵੇਜ਼ ਵੇਖੋ.
ਲਿਖਤ ਪਛਾਣ ਸਾਧਨ ਤੱਕ ਪਹੁੰਚ ਲਈ ਕੌਣ ਯੋਗ ਹੈ, ਅਤੇ ਕੀ ਜਾਂਚਾਂ ਲਈ ਫ਼ੀਸ ਲੱਗਦੀ ਹੈ?
ਲਿਖਤ ਪਛਾਣ ਸਾਧਨ ਨਾਲ ਜਾਂਚਾਂ ਫ਼ਿਲਹਾਲ ਮੁਫ਼ਤ ਹਨ. ਯੋਗ ਵਰਤੋਂ-ਉਦੇਸ਼ਾਂ ਵਿੱਚ ਅਕਾਦਮਿਕ ਅਤੇ ਖੋਜ ਸੰਸਥਾਵਾਂ ਵੱਲੋਂ ਲਿਖਤ ਦੇ ਮੂਲ, ਪਛਾਣ ਦੀ ਭਰੋਸੇਯੋਗਤਾ ਜਾਂ ਲੋਕ ਮੂਲ ਸੰਬੰਧੀ ਨਤੀਜਿਆਂ ਨੂੰ ਕਿਵੇਂ ਸਮਝਦੇ ਹਨ, ਇਸ ਦਾ ਅਧਿਐਨ ਕਰਨਾ ਸ਼ਾਮਲ ਹੈ.
ਆਮ ਕਾਰੋਬਾਰੀ ਵਰਤੋਂਆਂ ਪ੍ਰੋਗਰਾਮ ਦੇ ਦਾਇਰੇ ਤੋਂ ਫ਼ਿਲਹਾਲ ਬਾਹਰ ਹਨ, ਜਿਵੇਂ ਕਿ ਵਪਾਰਕ ਧੋਖਾਧੜੀ ਦੀ ਰੋਕਥਾਮ, ਪ੍ਰਮਾਣਿਕਤਾ ਦੀ ਜਾਂਚ ਅਤੇ ਤਸਦੀਕ, ਜਾਂ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਅਤੇ ਡਾਟਾ ਵਿਸ਼ਲੇਸ਼ਣ ਸੇਵਾਵਾਂ ਦੇ ਪੈਕੇਜ ਦੇ ਹਿੱਸੇ ਵਜੋਂ ਮੁੜ ਵੇਚਣਾ.
ਅਕਾਦਮਿਕ ਇਮਾਨਦਾਰੀ ਨਾਲ ਜੁੜੀਆਂ ਵਰਤੋਂਆਂ ਵੀ ਪ੍ਰੋਗਰਾਮ ਦੇ ਦਾਇਰੇ ਤੋਂ ਫ਼ਿਲਹਾਲ ਬਾਹਰ ਹਨ, ਜਿਵੇਂ ਵਿਦਿਆਰਥੀਆਂ ਦੇ ਕੰਮ ਵਿੱਚ ਏਆਈ ਦੀ ਵਰਤੋਂ ਦੀ ਜਾਂਚ ਕਰਨਾ (ਮਿਸਾਲ ਵਜੋਂ ਲੇਖ ਜਾਂ ਖੋਜ-ਪ੍ਰਬੰਧ ਲਿਖਣ ਵਿੱਚ).
ਤਸਦੀਕ ਦੇ ਨਤੀਜਿਆਂ ਦਾ ਕੀ ਅਰਥ ਹੈ?
ਜੇ openai.com/verify ਜਾਂ OpenAI ਦੀ ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਵਾਲੀ API ਰਾਹੀਂ ਕੋਈ ਸੰਕੇਤ ਮਿਲਦਾ ਹੈ, ਤਾਂ ਇਸ ਦਾ ਅਰਥ ਹੈ ਕਿ ਅੱਪਲੋਡ ਕੀਤੀ ਸਮੱਗਰੀ ਵਿੱਚ OpenAI ਨਾਲ ਜੁੜਿਆ ਕੋਈ ਸਮਰਥਿਤ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਹੈ. ਇਹ ਸਾਧਨ ਇਸ ਗੱਲ ਦੀ ਪੁਸ਼ਟੀ ਨਹੀਂ ਕਰਦਾ ਕਿ ਸਮੱਗਰੀ ਸਹੀ ਹੈ, ਬਿਨਾਂ ਸੋਧ ਵਾਲੀ ਹੈ, ਕਾਨੂੰਨੀ ਮਾਲਕੀ ਹੇਠ ਹੈ ਜਾਂ ਸਹੀ ਸੰਦਰਭ ਵਿੱਚ ਪੇਸ਼ ਕੀਤੀ ਗਈ ਹੈ. ਇਹ ਇਹ ਵੀ ਨਹੀਂ ਦੱਸਦਾ ਕਿ ਸਮੱਗਰੀ ਕਿਸ ਨੇ ਬਣਾਈ ਸੀ ਜਾਂ ਕਿਉਂ ਬਣਾਈ ਸੀ.
ਜੇ ਕੋਈ ਸੰਕੇਤ ਨਹੀਂ ਮਿਲਦਾ, ਤਾਂ ਇਸ ਦਾ ਅਰਥ ਹੈ ਕਿ ਸਾਧਨ ਨੂੰ ਅੱਪਲੋਡ ਕੀਤੀ ਫ਼ਾਈਲ ਵਿੱਚ OpenAI ਦੁਆਰਾ ਜਾਰੀ ਕੀਤੇ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਨਹੀਂ ਮਿਲੇ. ਫਿਰ ਵੀ ਸਮੱਗਰੀ OpenAI ਦੁਆਰਾ ਬਣਾਈ ਜਾਂ ਨਿਰਯਾਤ ਕੀਤੀ ਹੋ ਸਕਦੀ ਹੈ, ਜੇ:
ਸਮੱਗਰੀ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਉਪਲਬਧ ਹੋਣ ਤੋਂ ਪਹਿਲਾਂ ਬਣਾਈ ਗਈ ਸੀ.
ਸਮੱਗਰੀ ਕਿਸੇ ਅਸਮਰਥਿਤ ਉਤਪਾਦ, ਮਾਡਲ, ਨਿਰਯਾਤ ਦੇ ਤਰੀਕੇ ਜਾਂ ਫ਼ਾਈਲ ਦੀ ਕਿਸਮ ਤੋਂ ਆਈ ਸੀ.
ਅੱਪਲੋਡ, ਡਾਊਨਲੋਡ, ਸੋਧ, ਫ਼ਾਰਮੈਟ ਬਦਲਣ ਜਾਂ ਸਾਂਝਾ ਕਰਨ ਦੌਰਾਨ ਮੈਟਾਡਾਟਾ ਹਟਾ ਦਿੱਤਾ ਗਿਆ ਸੀ.
ਸੰਕੁਚਨ, ਕੱਟਣ, ਸ਼ੋਰ, ਸੋਧਾਂ, ਫ਼ਾਰਮੈਟ ਬਦਲਣ ਜਾਂ ਹੋਰ ਤਬਦੀਲੀਆਂ ਕਾਰਨ ਵਾਟਰਮਾਰਕ ਖ਼ਰਾਬ ਹੋ ਗਿਆ ਸੀ.
ਆਡੀਓ ਕਲਿੱਪ ਬਹੁਤ ਛੋਟੀ ਹੈ ਜਾਂ ਇਸ ਵਿੱਚ ਕਾਫ਼ੀ ਤਬਦੀਲੀ ਕੀਤੀ ਗਈ ਹੈ.
ਮੈਂ ਤਸਦੀਕ ਦਾ ਸਭ ਤੋਂ ਭਰੋਸੇਯੋਗ ਨਤੀਜਾ ਕਿਵੇਂ ਪ੍ਰਾਪਤ ਕਰ ਸਕਦਾ ਹਾਂ?
ਇੱਕ ਵਾਰ ਵਿੱਚ ਇੱਕ ਸਮਰਥਿਤ ਫ਼ਾਈਲ ਅੱਪਲੋਡ ਕਰੋ ਅਤੇ ਜਿੱਥੇ ਸੰਭਵ ਹੋਵੇ, ਅਸਲ ਨਿਰਯਾਤ ਕੀਤੀ ਫ਼ਾਈਲ ਵਰਤੋ. ਤਸਵੀਰ ਦੀ ਜਾਂਚ ਤੋਂ ਪਹਿਲਾਂ ਉਸ ਨੂੰ ਕੱਟਣ ਜਾਂ ਫ਼ਾਈਲ ਦਾ ਫ਼ਾਰਮੈਟ ਬਦਲਣ ਤੋਂ ਬਚੋ. ਆਡੀਓ ਲਈ, 10 ਤੋਂ 60 ਸਕਿੰਟ ਦੀਆਂ ਕਲਿੱਪਾਂ ਆਮ ਤੌਰ 'ਤੇ ਸਭ ਤੋਂ ਵਧੀਆ ਨਤੀਜੇ ਦਿੰਦੀਆਂ ਹਨ. ਭਾਵੇਂ ਕੋਈ ਸੰਕੇਤ ਨਾ ਮਿਲੇ, ਫਿਰ ਵੀ ਸਿੱਟਾ ਕੱਢਣ ਤੋਂ ਪਹਿਲਾਂ ਫ਼ਾਈਲ ਦੇ ਸਰੋਤ ਅਤੇ ਸੰਦਰਭ ਨੂੰ ਧਿਆਨ ਵਿੱਚ ਰੱਖੋ.
ਕੀ ਨਤੀਜੇ ਮੇਰਾ ਪ੍ਰੌੰਪਟ ਜਾਂ ਨਿੱਜੀ ਜਾਣਕਾਰੀ ਦਿਖਾਉਂਦੇ ਹਨ?
ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤਾਂ ਵਿੱਚ ਵਰਤੋਂਕਾਰ, ਸੰਸਥਾ ਜਾਂ ਪ੍ਰੌੰਪਟ ਬਾਰੇ ਵੇਰਵੇ ਸ਼ਾਮਲ ਨਹੀਂ ਹੁੰਦੇ.
ਜਿਸ ਸਮੱਗਰੀ ਦੀ ਮੈਂ openai.com/verify ਜਾਂ ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਵਾਲੀ API ਰਾਹੀਂ ਤਸਦੀਕ ਕਰਦਾ ਹਾਂ, ਉਸ ਦਾ ਕੀ ਹੁੰਦਾ ਹੈ?
openai.com/verify 'ਤੇ ਅੱਪਲੋਡ ਕੀਤੀ ਜਾਂ ਤਸਦੀਕ ਲਈ ਸਾਡੀ ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਵਾਲੀ API ਨੂੰ ਭੇਜੀ ਸਮੱਗਰੀ ਨੂੰ ਸਿਰਫ਼ ਸਮਰਥਿਤ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤਾਂ ਦੀ ਜਾਂਚ ਲਈ ਹੀ ਪ੍ਰਕਿਰਿਆਬੱਧ ਕੀਤਾ ਜਾਂਦਾ ਹੈ. ਕਾਨੂੰਨੀ ਤੌਰ 'ਤੇ ਲਾਜ਼ਮੀ ਹੋਣ ਤੋਂ ਬਿਨਾਂ ਸਮੱਗਰੀ ਸੰਭਾਲੀ ਨਹੀਂ ਜਾਂਦੀ ਅਤੇ OpenAI ਦੇ ਮਾਡਲਾਂ ਨੂੰ ਸਿਖਲਾਈ ਦੇਣ ਲਈ ਨਹੀਂ ਵਰਤੀ ਜਾਂਦੀ.
ਕੀ OpenAI ਹੋਰ ਏਆਈ ਸਾਧਨਾਂ ਨਾਲ ਬਣਾਈ ਸਮੱਗਰੀ ਨੂੰ ਪਛਾਣ ਸਕਦਾ ਹੈ?
ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਲਈ ਸਾਡੇ ਸਾਧਨ, OpenAI ਦੇ ਮਾਡਲਾਂ ਦੁਆਰਾ ਬਣਾਈ ਜਾਂ OpenAI ਦੇ ਸਾਧਨਾਂ ਦੁਆਰਾ ਨਿਰਯਾਤ ਕੀਤੀ ਸਮੱਗਰੀ ਨਾਲ ਜੁੜੇ ਸਮਰਥਿਤ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤਾਂ ਨੂੰ ਪਛਾਣਨ ਲਈ ਬਣਾਏ ਗਏ ਹਨ. ਇਹ ਹੋਰ ਏਆਈ ਮਾਡਲਾਂ ਦੁਆਰਾ ਬਣਾਈ ਸਮੱਗਰੀ ਨੂੰ ਪਛਾਣਨ ਲਈ ਨਹੀਂ ਬਣਾਏ ਗਏ. ਜੇ ਸੰਬੰਧਿਤ ਸੰਕੇਤ ਗੁੰਮ ਹੋਵੇ, ਸਮਰਥਿਤ ਨਾ ਹੋਵੇ ਜਾਂ ਖ਼ਰਾਬ ਹੋ ਗਿਆ ਹੋਵੇ, ਤਾਂ ਇਹ OpenAI ਦੁਆਰਾ ਬਣਾਈ ਸਮੱਗਰੀ ਨੂੰ ਵੀ ਸ਼ਾਇਦ ਨਾ ਪਛਾਣ ਸਕਣ.
ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਤਕਨੀਕ ਕਿਵੇਂ ਕੰਮ ਕਰਦੀ ਹੈ
ਕੀ ਵਾਟਰਮਾਰਕ ਲੇਖਕ, ਮਾਲਕੀ ਜਾਂ ਕਾਨੂੰਨੀ ਜ਼ਿੰਮੇਵਾਰੀ ਤੈਅ ਕਰਦੇ ਹਨ?
ਨਹੀਂ. ਵਾਟਰਮਾਰਕ ਇਸ ਗੱਲ ਦਾ ਸਬੂਤ ਹੈ ਕਿ ਸੰਭਾਵਤ ਤੌਰ 'ਤੇ OpenAI ਦੇ ਕਿਸੇ ਮਾਡਲ ਨੇ ਸਮੱਗਰੀ ਬਣਾਈ ਜਾਂ ਪ੍ਰਕਿਰਿਆਬੱਧ ਕੀਤੀ ਸੀ. ਇਕੱਲਾ ਵਾਟਰਮਾਰਕ ਇਹ ਸਥਾਪਿਤ ਨਹੀਂ ਕਰਦਾ ਕਿ ਸਮੱਗਰੀ ਕਿਸ ਨੇ ਲਿਖੀ ਜਾਂ ਇਸ ਦਾ ਮਾਲਕ ਕੌਣ ਹੈ, ਕੀ ਖੁਲਾਸਾ ਕਰਨਾ ਲਾਜ਼ਮੀ ਸੀ ਜਾਂ ਕਾਨੂੰਨੀ ਤੌਰ 'ਤੇ ਕੌਣ ਜ਼ਿੰਮੇਵਾਰ ਹੈ. ਇਹ ਇਹ ਵੀ ਨਹੀਂ ਦੱਸਦਾ ਕਿ ਮਾਡਲ ਕਿਸੇ ਵਰਤੋਂਕਾਰ ਵੱਲੋਂ ਅੱਪਲੋਡ ਕੀਤੀ ਸਮੱਗਰੀ ਨੂੰ ਸੋਧ ਰਿਹਾ ਸੀ ਜਾਂ ਨਹੀਂ.
ਕੀ ਵਾਟਰਮਾਰਕ ਦੱਸਦੇ ਹਨ ਕਿ OpenAI ਦੇ ਮਾਡਲ ਦੀ ਭੂਮਿਕਾ ਕਿੰਨੀ ਸੀ?
ਨਹੀਂ. ਪਛਾਣ ਸਾਧਨ ਇਹ ਦੱਸਦਾ ਹੈ ਕਿ ਉਸ ਨੂੰ ਵਾਟਰਮਾਰਕ ਮਿਲਿਆ ਹੈ ਜਾਂ ਨਹੀਂ. ਵਾਟਰਮਾਰਕ ਮਿਲਣਾ ਇਸ ਗੱਲ ਦਾ ਸਬੂਤ ਹੈ ਕਿ ਸੰਭਾਵਤ ਤੌਰ 'ਤੇ OpenAI ਦੇ ਕਿਸੇ ਮਾਡਲ ਨੇ ਸਮੱਗਰੀ ਬਣਾਈ ਜਾਂ ਪ੍ਰਕਿਰਿਆਬੱਧ ਕੀਤੀ ਸੀ, ਪਰ ਇਹ ਨਹੀਂ ਦੱਸਦਾ ਕਿ ਮਾਡਲ ਨੇ ਇਸ ਦਾ ਕੁਝ ਹਿੱਸਾ ਬਣਾਇਆ ਸੀ ਜਾਂ ਪੂਰੀ ਸਮੱਗਰੀ, ਜਾਂ ਕਿਸੇ ਵਿਅਕਤੀ ਦਾ ਯੋਗਦਾਨ ਕਿੰਨਾ ਸੀ.
ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਤਕਨੀਕ ਕਿਵੇਂ ਕੰਮ ਕਰਦੀ ਹੈ?
ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਤਕਨੀਕ ਮਾਡਲ ਦੇ ਲਿਖਣ ਵੇਲੇ ਉਸ ਦੀ ਸ਼ਬਦਾਂ ਅਤੇ ਸ਼ਬਦਾਂ ਦੇ ਹਿੱਸਿਆਂ ਦੀ ਚੋਣ ਵਿੱਚ ਇੱਕ ਗੁਪਤ ਨਮੂਨਾ ਬਣਾਉਂਦੀ ਹੈ. ਇਨ੍ਹਾਂ ਸ਼ਬਦਾਂ ਅਤੇ ਹਿੱਸਿਆਂ ਨੂੰ “ਟੋਕਨ” ਕਿਹਾ ਜਾਂਦਾ ਹੈ.
ਹਰ ਪੜਾਅ 'ਤੇ ਮਾਡਲ ਅੱਗੇ ਆ ਸਕਣ ਵਾਲੇ ਹਰੇਕ ਟੋਕਨ ਲਈ ਇੱਕ ਸੰਭਾਵਨਾ ਨਿਰਧਾਰਤ ਕਰਦਾ ਹੈ. ਵਾਟਰਮਾਰਕ ਪ੍ਰਣਾਲੀ ਉਨ੍ਹਾਂ ਸੰਭਾਵਨਾਵਾਂ ਦੇ ਕਈ ਬਦਲੇ ਹੋਏ ਸਮੂਹ ਬਣਾਉਂਦੀ ਹੈ, ਜਿਨ੍ਹਾਂ ਵਿੱਚੋਂ ਹਰ ਇੱਕ ਗੁਪਤ ਕੁੰਜੀ ਅਨੁਸਾਰ ਵੱਖ-ਵੱਖ ਚੋਣਾਂ ਨੂੰ ਤਰਜੀਹ ਦਿੰਦਾ ਹੈ. ਇਨ੍ਹਾਂ ਸਮੂਹਾਂ ਨੂੰ ਇਸ ਤਰ੍ਹਾਂ ਸੰਤੁਲਿਤ ਕੀਤਾ ਜਾਂਦਾ ਹੈ ਕਿ ਇਕੱਠੇ ਔਸਤ ਕੱਢਣ 'ਤੇ ਇਹ ਮਾਡਲ ਦੀਆਂ ਮੂਲ ਸੰਭਾਵਨਾਵਾਂ ਨਾਲ ਮੇਲ ਖਾਂਦੇ ਹਨ. ਕੁੰਜੀ ਤੈਅ ਕਰਦੀ ਹੈ ਕਿ ਕਿਹੜਾ ਸਮੂਹ ਵਰਤਣਾ ਹੈ, ਅਤੇ ਫਿਰ ਮਾਡਲ ਉਸ ਸਮੂਹ ਵਿੱਚੋਂ ਇੱਕ ਨਵੀਂ ਬੇਤਰਤੀਬ ਚੋਣ ਕਰਦਾ ਹੈ.
ਉਸੇ ਕੁੰਜੀ ਅਤੇ ਮੇਲ ਖਾਂਦੀਆਂ ਸੈਟਿੰਗਾਂ ਵਾਲਾ ਪਛਾਣ ਸਾਧਨ ਬਾਅਦ ਵਿੱਚ ਜਾਂਚ ਸਕਦਾ ਹੈ ਕਿ ਲਿਖਤ ਵਿੱਚ ਗੁਪਤ ਨਮੂਨਾ ਸਿਰਫ਼ ਸੰਜੋਗ ਨਾਲ ਉਮੀਦ ਕੀਤੀ ਜਾ ਸਕਣ ਵਾਲੀ ਦਰ ਤੋਂ ਵੱਧ ਵਾਰ ਮਿਲਦਾ ਹੈ ਜਾਂ ਨਹੀਂ.
ਕੀ ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕ ਤੱਥ-ਆਧਾਰਿਤ ਲਿਖਤ ਅਤੇ ਵਰਤੋਂਕਾਰ ਵੱਲੋਂ ਦਿੱਤੀ ਲਿਖਤ 'ਤੇ ਵੀ ਲਾਗੂ ਹੁੰਦੇ ਹਨ?
ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨਾ ਇਸ ਗੱਲ 'ਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ ਕਿ ਮਾਡਲ ਕੋਲ ਕੋਈ ਗੱਲ ਕਹਿਣ ਦੇ ਵੱਖ-ਵੱਖ ਤਰੀਕੇ ਹੋਣ. ਜਦੋਂ ਜਵਾਬ ਬਹੁਤ ਤੱਥਪੂਰਨ ਜਾਂ ਸਟੀਕ ਹੋਣਾ ਲਾਜ਼ਮੀ ਹੋਵੇ, ਜਿਵੇਂ ਕਿਸੇ ਗਣਿਤ ਦੇ ਸਵਾਲ ਦਾ ਜਵਾਬ, ਜਾਂ ਜਦੋਂ ਮਾਡਲ ਨੂੰ ਦਿੱਤੀ ਗਈ ਲਿਖਤ ਬਿਨਾਂ ਬਦਲੇ ਦੁਹਰਾਉਣ ਲਈ ਕਿਹਾ ਜਾਵੇ, ਤਾਂ ਇਹ ਲਚਕ ਘੱਟ ਹੁੰਦੀ ਹੈ. ਅਜਿਹੇ ਮਾਮਲਿਆਂ ਵਿੱਚ ਮਾਡਲ ਕੋਲ ਧਿਆਨ ਵਿੱਚ ਆਉਣ ਵਾਲਾ ਫ਼ਰਕ ਪਾਏ ਬਿਨਾਂ ਸ਼ਬਦਾਵਲੀ ਬਦਲਣ ਦੀ ਗੁੰਜਾਇਸ਼ ਘੱਟ ਹੁੰਦੀ ਹੈ, ਇਸ ਲਈ ਹੋ ਸਕਦਾ ਹੈ ਕਿ ਵਾਟਰਮਾਰਕ ਪਛਾਣਿਆ ਨਾ ਜਾਵੇ.
ਕੀ ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕ ਛੋਟੇ ਜਵਾਬਾਂ ਅਤੇ ਕੋਡ 'ਤੇ ਵੀ ਲਾਗੂ ਹੁੰਦੇ ਹਨ?
ਛੋਟੇ ਅੰਸ਼ਾਂ ਵਿੱਚ ਆਮ ਤੌਰ 'ਤੇ ਇੰਨੀ ਲਿਖਤ ਨਹੀਂ ਹੁੰਦੀ ਕਿ ਵਾਟਰਮਾਰਕ ਨੂੰ ਭਰੋਸੇਯੋਗ ਢੰਗ ਨਾਲ ਪਛਾਣਿਆ ਜਾ ਸਕੇ. ਕੋਡ ਵਿੱਚ ਵੀ ਵਾਟਰਮਾਰਕ ਜੋੜਨਾ ਵਧੇਰੇ ਮੁਸ਼ਕਲ ਹੁੰਦਾ ਹੈ, ਕਿਉਂਕਿ ਆਮ ਵਾਰਤਕ ਦੇ ਮੁਕਾਬਲੇ ਇਸ ਵਿੱਚ ਅੱਗੇ ਆਉਣ ਵਾਲੀ ਚੀਜ਼ ਲਈ ਢੁਕਵੇਂ ਵਿਕਲਪ ਘੱਟ ਹੁੰਦੇ ਹਨ.
ਇਨ੍ਹਾਂ ਸੀਮਾਵਾਂ ਨੂੰ ਧਿਆਨ ਵਿੱਚ ਰੱਖਦਿਆਂ, ਯੂਰਪੀ ਸੰਘ ਦੇ ਏਆਈ ਕਾਨੂੰਨ ਤਹਿਤ ਏਆਈ ਦੁਆਰਾ ਬਣਾਈ ਸਮੱਗਰੀ ਦੀ ਪਾਰਦਰਸ਼ਤਾ ਬਾਰੇ ਅਮਲ ਸੰਹਿਤਾ ਵਿੱਚ 200 ਟੋਕਨਾਂ ਤੋਂ ਛੋਟੇ ਨਤੀਜਿਆਂ—ਅੰਗਰੇਜ਼ੀ ਵਿੱਚ ਲਗਭਗ 150 ਸ਼ਬਦ—ਜਾਂ ਕੋਡ ਦੇ ਛੋਟੇ ਅੰਸ਼ਾਂ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਲਾਜ਼ਮੀ ਨਹੀਂ ਹਨ.
ਭਾਸ਼ਾ ਮੁਤਾਬਕ ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕਾਂ ਦੀ ਪਛਾਣ ਕਿਵੇਂ ਬਦਲਦੀ ਹੈ?
ਪਛਾਣ ਦੀ ਦਰ ਭਾਸ਼ਾ ਮੁਤਾਬਕ ਵੱਖਰੀ ਹੁੰਦੀ ਹੈ, ਅਤੇ ਫ਼ਿਲਹਾਲ ਕੁਝ ਭਾਸ਼ਾਵਾਂ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਪਛਾਣਨਾ ਹੋਰਨਾਂ ਨਾਲੋਂ ਸੌਖਾ ਹੈ. ਜਿਨ੍ਹਾਂ ਭਾਸ਼ਾਵਾਂ ਵਿੱਚ ਸੰਕੇਤ ਕਮਜ਼ੋਰ ਹੈ, ਉਨ੍ਹਾਂ ਵਿੱਚ ਪਛਾਣ ਸੁਧਾਰਨ ਲਈ ਅਸੀਂ ਵਾਟਰਮਾਰਕ ਦੀ ਤੀਬਰਤਾ ਬਦਲ ਸਕਦੇ ਹਾਂ.
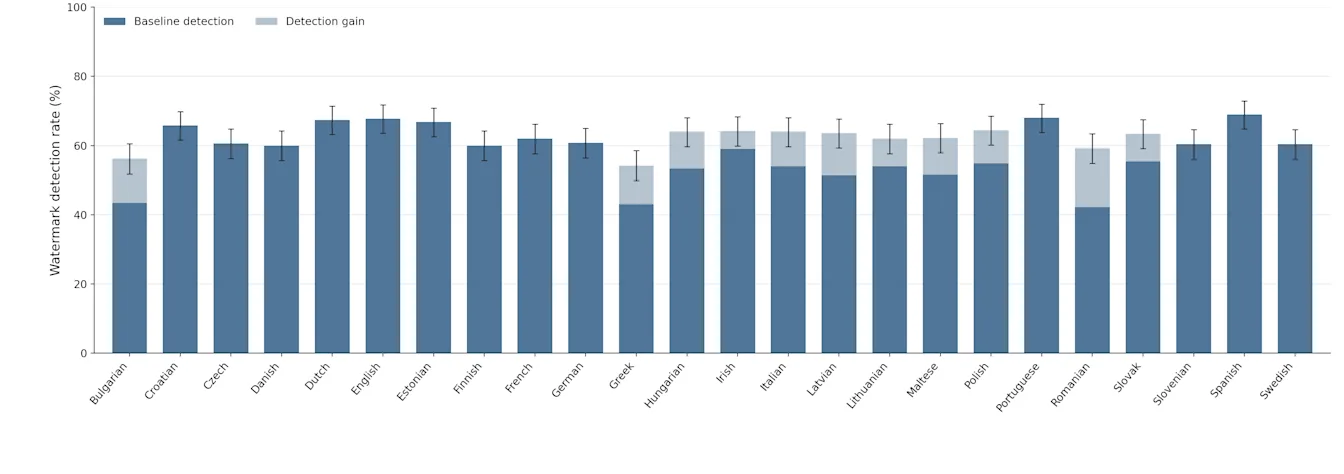
ਇਹ ਚਾਰਟ ਯੂਰਪੀ ਸੰਘ ਦੀਆਂ ਸਾਰੀਆਂ 24 ਅਧਿਕਾਰਤ ਭਾਸ਼ਾਵਾਂ ਵਿੱਚ ਪਛਾਣ ਦੀ ਦਰ ਦਾ ਮੁਲਾਂਕਣ ਕਰਦਾ ਹੈ. ਅਸੀਂ ਪਹਿਲਾਂ ਵੱਖ-ਵੱਖ ਵਿਸ਼ਿਆਂ 'ਤੇ ਅੰਗਰੇਜ਼ੀ ਵਿੱਚ 500 ਕ੍ਰਿਤ੍ਰਿਮ ਪ੍ਰੌੰਪਟ ਬਣਾਏ, ਫਿਰ ਉਨ੍ਹਾਂ ਦਾ ਬਾਕੀ 23 ਭਾਸ਼ਾਵਾਂ ਵਿੱਚ ਅਨੁਵਾਦ ਕੀਤਾ. ਗ਼ਲਤ ਸਕਾਰਾਤਮਕ ਨਤੀਜਿਆਂ ਦੀ 1% ਦਰ 'ਤੇ, ਸਪੇਨੀ ਵਿੱਚ ਪਛਾਣ ਦੀ ਦਰ ਸਭ ਤੋਂ ਵੱਧ (69.0%) ਹੈ, ਜਦਕਿ ਰੋਮਾਨੀਆਈ ਵਿੱਚ ਸਭ ਤੋਂ ਘੱਟ (42.2%) ਹੈ. ਸਾਡੇ ਵਾਟਰਮਾਰਕ ਵਿੱਚ ਤੀਬਰਤਾ ਬਦਲਣ ਲਈ ਇੱਕ ਮਾਪਦੰਡ ਹੈ—ਇੱਕ “ਘੁੰਡੀ” ਜੋ ਵੱਖ-ਵੱਖ ਖੇਤਰਾਂ ਲਈ ਵਾਟਰਮਾਰਕ ਦੇ ਸੰਕੇਤ ਨੂੰ ਮਜ਼ਬੂਤ ਜਾਂ ਕਮਜ਼ੋਰ ਕਰਦੀ ਹੈ. ਇਸ ਘੁੰਡੀ ਦੀ ਵਰਤੋਂ ਕਰਕੇ ਅਸੀਂ ਉਨ੍ਹਾਂ ਭਾਸ਼ਾਵਾਂ ਲਈ ਤੀਬਰਤਾ ਵਧਾ ਸਕੇ ਜਿਨ੍ਹਾਂ ਵਿੱਚ ਪਛਾਣ ਦੀ ਦਰ 60% ਤੋਂ ਘੱਟ ਸੀ; ਪੱਟੀਆਂ ਦੇ ਹਲਕੇ ਨੀਲੇ ਹਿੱਸੇ ਇਸ ਨਾਲ ਹੋਇਆ ਸੁਧਾਰ ਦਿਖਾਉਂਦੇ ਹਨ.
ਕੀ ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕ ਮਾਡਲ ਦੀ ਗੁਣਵੱਤਾ ਘਟਾਉਂਦੇ ਹਨ?
ਸਾਡੀ ਜਾਂਚ ਮੁਤਾਬਕ, ਨਹੀਂ. ਸਾਡੇ ਸਭ ਤੋਂ ਨਵੇਂ ਅਤਿ-ਆਧੁਨਿਕ ਮਾਡਲ Astra ਦਾ ਮੁਲਾਂਕਣ ਕਰਨ ਲਈ ਵਰਤੇ ਜਾਂਦੇ ਮਿਆਰੀ ਟੈਸਟਾਂ ਵਿੱਚ, ਵਾਟਰਮਾਰਕ ਦੇ ਨਾਲ ਅਤੇ ਬਿਨਾਂ ਕਾਰਗੁਜ਼ਾਰੀ ਦਾ ਫ਼ਰਕ ਉਸ ਆਮ ਉਤਾਰ-ਚੜ੍ਹਾਅ ਦੀ ਹੱਦ ਵਿੱਚ ਰਹਿੰਦਾ ਹੈ ਜੋ ਅਸੀਂ ਵੱਖ-ਵੱਖ ਮੁਲਾਂਕਣਾਂ ਦੌਰਾਨ ਵੇਖਦੇ ਹਾਂ. ChatGPT ਵਿੱਚ ਪਹਿਲਾਂ ਕੀਤੇ ਟੈਸਟਾਂ ਨੇ ਵੀ ਦਿਖਾਇਆ ਕਿ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਨਾਲ ਨਾਪਸੰਦ ਦਰਸਾਉਣ ਦੀ ਦਰ ਜਾਂ ਉਤਪਾਦ ਦੇ ਹੋਰ ਮਾਪਦੰਡਾਂ ਵਿੱਚ ਕੋਈ ਤਬਦੀਲੀ ਨਹੀਂ ਆਈ.
ਕੀ ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕ ਮਾਡਲ ਦੀ ਰਫ਼ਤਾਰ ਘਟਾਉਂਦੇ ਹਨ?
ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦਾ ਸਾਡੇ ਮਾਡਲਾਂ ਦੀ ਰਫ਼ਤਾਰ 'ਤੇ ਨਾਂਮਾਤਰ ਅਸਰ ਪੈਂਦਾ ਹੈ.
OpenAI ਦੇ ਲਿਖਤ ਵਾਟਰਮਾਰਕ ਤੀਜੀਆਂ ਧਿਰਾਂ ਦੇ ਏਆਈ ਪਛਾਣ ਸਾਧਨਾਂ ਤੋਂ ਕਿਵੇਂ ਵੱਖਰੇ ਹਨ?
Pangram ਵਰਗੇ ਤੀਜੀਆਂ ਧਿਰਾਂ ਦੇ ਪਛਾਣ ਸਾਧਨ ਆਮ ਤੌਰ 'ਤੇ ਸ਼ਬਦ-ਚੋਣ ਵਰਗੇ ਨਮੂਨਿਆਂ ਤੋਂ ਏਆਈ ਦੁਆਰਾ ਬਣਾਈ ਲਿਖਤ ਦੀ ਪਛਾਣ ਕਰਨ ਲਈ ਵਰਗੀਕਰਨ ਪ੍ਰਣਾਲੀਆਂ ਵਰਤਦੇ ਹਨ. ਇਹ ਤਰੀਕਾ ਲਿਖਤ ਵਿੱਚ ਜੋੜੇ ਸੰਕੇਤ ਨੂੰ ਪਛਾਣਨ ਦੀ ਬਜਾਏ, ਲਿਖਤ ਬਣਨ ਤੋਂ ਬਾਅਦ ਉਸ ਦਾ ਵਿਸ਼ਲੇਸ਼ਣ ਕਰਦਾ ਹੈ. ਯੂਰਪੀ ਸੰਘ ਦਾ ਏਆਈ ਕਾਨੂੰਨ ਖ਼ਾਸ ਤੌਰ 'ਤੇ ਬਣਾਈ ਗਈ ਲਿਖਤ ਦੇ ਅੰਦਰ ਸੰਕੇਤ ਜੋੜਨਾ ਲਾਜ਼ਮੀ ਕਰਦਾ ਹੈ.
ਤੁਸੀਂ TextSeal ਜਾਂ SynthID ਦੀ ਬਜਾਏ ਲਿਖਤ ਲਈ ਆਪਣੇ ਵਾਟਰਮਾਰਕ ਕਿਉਂ ਵਰਤ ਰਹੇ ਹੋ?
ਅਸੀਂ ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਲਈ textGrain ਨਾਮ ਦਾ ਆਪਣਾ ਤਰੀਕਾ ਵਿਕਸਿਤ ਕੀਤਾ ਹੈ. ਇਸ ਨਾਲ ਸਾਨੂੰ SynthID ਜਾਂ TextSeal ਦੇ ਮੁਕਾਬਲੇ ਵਾਟਰਮਾਰਕ ਦੀ ਪਛਾਣਯੋਗਤਾ ਅਤੇ ਇੱਕੋ ਪ੍ਰੌੰਪਟ ਤੋਂ ਬਣਨ ਵਾਲੇ ਜਵਾਬਾਂ ਦੀ ਵਿਭਿੰਨਤਾ ਵਿਚਕਾਰ ਸੰਤੁਲਨ 'ਤੇ ਵਧੇਰੇ ਨਿਯੰਤਰਣ ਮਿਲਦਾ ਹੈ. ਸਾਡੇ ਟੈਸਟਾਂ ਵਿੱਚ ਸਾਡੇ ਤਰੀਕੇ ਨੇ ਲਿਖਤ ਲਈ ਵਰਤੇ ਜਾਣ ਵਾਲੇ SynthID ਦੇ ਮੁਕਾਬਲੇ ਵਾਟਰਮਾਰਕ ਵਾਲੇ ਲਿਖਤ ਨਮੂਨਿਆਂ ਦੇ ਬਰਾਬਰ ਜਾਂ ਵੱਧ ਹਿੱਸੇ ਦੀ ਸਹੀ ਪਛਾਣ ਕੀਤੀ. ਅਸੀਂ textGrain ਨੂੰ ਖੁੱਲ੍ਹੇ ਸਰੋਤ ਵਾਲੀ ਤਕਨਾਲੋਜੀ ਵਜੋਂ ਜਾਰੀ ਕਰਨ ਦੀ ਯੋਜਨਾ ਬਣਾ ਰਹੇ ਹਾਂ ਤਾਂ ਜੋ ਹੋਰ ਲੋਕ ਇਸ ਦੇ ਆਧਾਰ 'ਤੇ ਨਵੀਆਂ ਤਕਨੀਕਾਂ ਬਣਾ ਸਕਣ ਅਤੇ ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਤਕਨੀਕ ਸੁਧਾਰਨ ਵਿੱਚ ਮਦਦ ਕਰ ਸਕਣ.
ਕੀ ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਨਾਲ ਲੁਕਵੇਂ ਅੱਖਰ, ਵਾਧੂ ਟੋਕਨ ਜਾਂ ਦਿਸਣ ਵਾਲੀਆਂ ਤਬਦੀਲੀਆਂ ਸ਼ਾਮਲ ਹੁੰਦੀਆਂ ਹਨ?
ਨਹੀਂ. ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਨਾਲ ਸ਼ਬਦ-ਚੋਣ ਦਾ ਅੰਕੜਾਤਮਕ ਨਮੂਨਾ ਬਦਲਦਾ ਹੈ; ਇਸ ਨਾਲ ਲੁਕਵੇਂ ਅੱਖਰ ਜਾਂ ਸਿਰਫ਼ ਵਾਟਰਮਾਰਕ ਲਈ ਟੋਕਨ ਨਹੀਂ ਜੋੜੇ ਜਾਂਦੇ. ਵਾਟਰਮਾਰਕ ਪਾਠਕਾਂ ਨੂੰ ਦਿਖਾਈ ਨਹੀਂ ਦਿੰਦਾ, ਅਤੇ ਲਿਖਤ ਨੂੰ ਕਾਪੀ ਕਰਕੇ ਚਿਪਕਾਉਣ ਨਾਲ ਕੋਈ ਲੁਕਵੀਂ ਸਮੱਗਰੀ ਸ਼ਾਮਲ ਨਹੀਂ ਹੁੰਦੀ.
ਗਾਹਕਾਂ ਲਈ ਮਾਰਗਦਰਸ਼ਨ
ਮੈਂ API ਗਾਹਕ ਹਾਂ, ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕ ਕਿਵੇਂ ਚਾਲੂ ਕਰਾਂ?
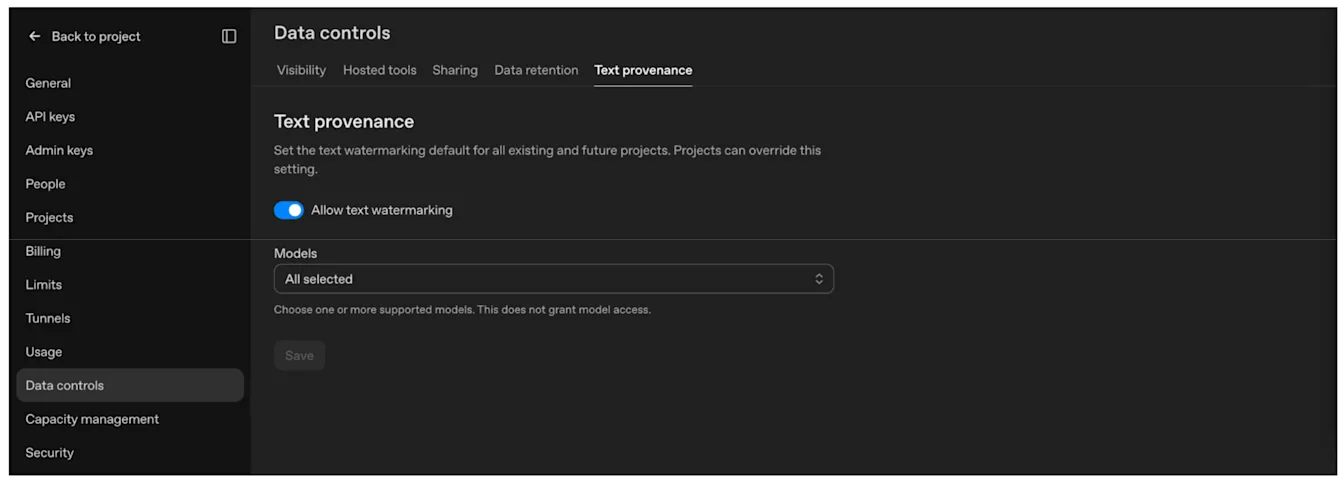
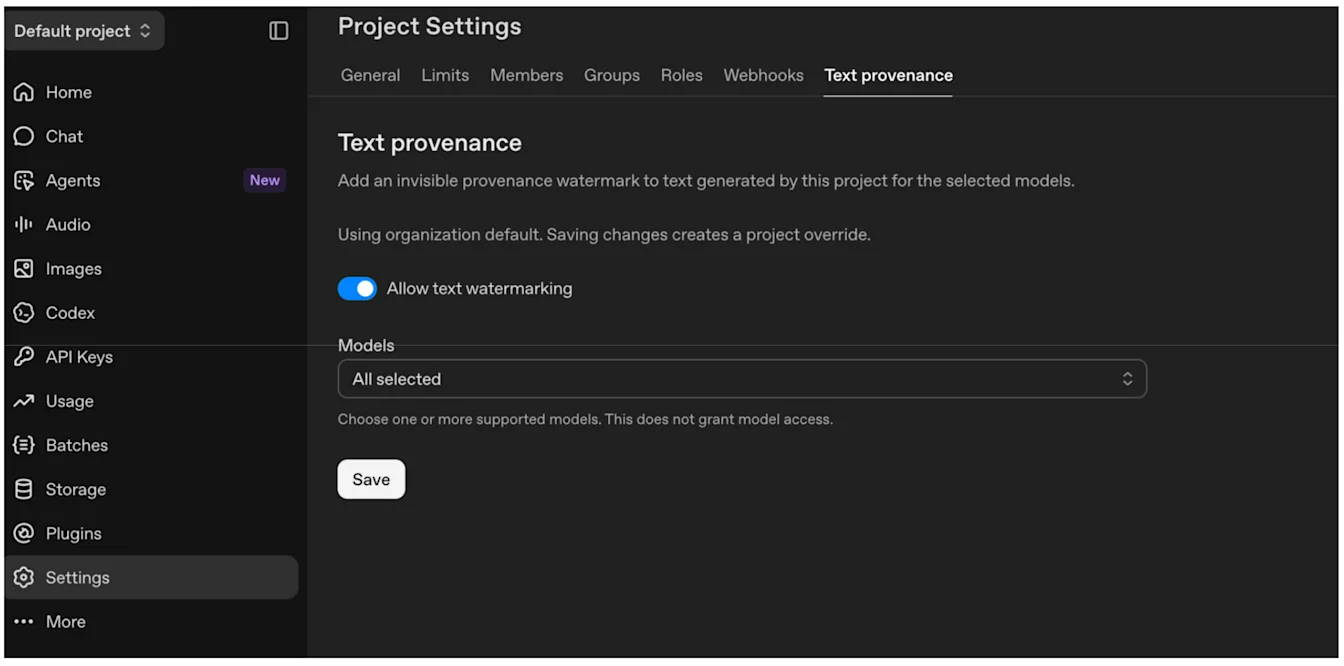
OpenAI API ਦੇ ਗਾਹਕ ਕਿਸੇ ਖ਼ਾਸ ਪ੍ਰੋਜੈਕਟ ਲਈ ਸੈਟਿੰਗਾਂ ਰਾਹੀਂ, ਜਾਂ ਆਪਣੀ ਪੂਰੀ ਸੰਸਥਾ ਲਈ ਸੰਸਥਾ ਦੀਆਂ ਸੈਟਿੰਗਾਂ ਰਾਹੀਂ ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨਾ ਚਾਲੂ ਕਰ ਸਕਦੇ ਹਨ. ਦੋਵਾਂ ਮਾਮਲਿਆਂ ਵਿੱਚ ਗਾਹਕ ਚੁਣ ਸਕਦੇ ਹਨ ਕਿ ਕਿਹੜੇ ਮਾਡਲਾਂ ਦੀ ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਿਆ ਜਾਵੇ. ਕਿਸੇ ਸਮਰਥਿਤ ਮਾਡਲ ਲਈ ਇਹ ਸਹੂਲਤ ਚਾਲੂ ਹੋਣ 'ਤੇ, OpenAI ਲਿਖਤ ਬਣਾਉਣ ਦੌਰਾਨ ਵਾਟਰਮਾਰਕ ਜੋੜਦਾ ਹੈ. ਗਾਹਕਾਂ ਨੂੰ ਹਰੇਕ ਜਵਾਬ ਵਿੱਚ ਵੱਖਰਾ ਚਿੰਨ੍ਹ ਜੋੜਨ ਦੀ ਲੋੜ ਨਹੀਂ ਹੁੰਦੀ.
ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਇਜਾਜ਼ਤ ਦਿਓ ਚਾਲੂ ਕਰੋ, ਆਪਣੇ ਮਾਡਲ ਚੁਣੋ ਅਤੇ ਫਿਰ ਸੰਭਾਲੋ ਚੁਣੋ.
ਸੰਸਥਾ ਦੀ ਮੂਲ ਸੈਟਿੰਗ: ਸੰਸਥਾ ਦੀਆਂ ਸੈਟਿੰਗਾਂ → ਡਾਟਾ ਨਿਯੰਤਰਣ → ਲਿਖਤ ਦਾ ਮੂਲ.
ਪ੍ਰੋਜੈਕਟ ਲਈ ਵੱਖਰੀ ਸੈਟਿੰਗ: ਪ੍ਰੋਜੈਕਟ ਸੈਟਿੰਗਾਂ → ਲਿਖਤ ਦਾ ਮੂਲ.
ਮੈਂ ਕਿਹੜੇ ਮਾਡਲਾਂ ਲਈ ਵਾਟਰਮਾਰਕ ਚਾਲੂ ਕਰ ਸਕਦਾ ਹਾਂ?
ਗਾਹਕ ਸੈਟਿੰਗਾਂ ਅਤੇ ਸੰਸਥਾ ਦੀਆਂ ਸੈਟਿੰਗਾਂ ਵਿੱਚ ਉਨ੍ਹਾਂ ਮਾਡਲਾਂ ਦੀ ਸੂਚੀ ਵੇਖ ਸਕਦੇ ਹਨ ਜਿਨ੍ਹਾਂ ਲਈ ਫ਼ਿਲਹਾਲ ਵਾਟਰਮਾਰਕ ਜੋੜਨ ਦੀ ਸਹੂਲਤ ਉਪਲਬਧ ਹੈ. ਆਉਣ ਵਾਲੇ ਹਫ਼ਤਿਆਂ ਵਿੱਚ ਅਸੀਂ ਇਹ ਸਹੂਲਤ ਸਾਰੇ ਪੁਰਾਣੇ ਮਾਡਲਾਂ ਤੱਕ ਵਧਾਵਾਂਗੇ.
ਕੀ ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕ ਚਾਲੂ ਕਰਨ ਨਾਲ ਮੈਨੂੰ ਲਿਖਤ ਪਛਾਣ ਸਾਧਨ ਤੱਕ ਪਹੁੰਚ ਵੀ ਮਿਲਦੀ ਹੈ?
ਨਹੀਂ. ਲਿਖਤ ਪਛਾਣ ਸਾਧਨ ਤੱਕ ਪਹੁੰਚ ਫ਼ਿਲਹਾਲ ਮਨਜ਼ੂਰਸ਼ੁਦਾ ਖੋਜ ਅਤੇ ਅਕਾਦਮਿਕ ਸੰਸਥਾਵਾਂ ਤੱਕ ਸੀਮਤ ਹੈ. ਇਹ ਸੰਸਥਾਵਾਂ ਲਿਖਤ ਦੇ ਵਾਟਰਮਾਰਕਾਂ ਦੀ ਭਰੋਸੇਯੋਗਤਾ, ਵਰਤੋਂ ਦੀ ਸੌਖ ਅਤੇ ਤਕਨਾਲੋਜੀ ਤੇ ਇਸ ਦੇ ਨਤੀਜਿਆਂ ਨੂੰ ਸਪੱਸ਼ਟ ਢੰਗ ਨਾਲ ਸਮਝਾਉਣ ਦੀ ਸਮਰੱਥਾ ਸੁਧਾਰਨ ਲਈ ਕੰਮ ਕਰ ਰਹੀਆਂ ਹਨ. ਇਹ ਯੂਰਪੀ ਸੰਘ ਦੇ ਏਆਈ ਕਾਨੂੰਨ ਤਹਿਤ ਏਆਈ ਦੁਆਰਾ ਬਣਾਈ ਸਮੱਗਰੀ ਦੀ ਪਾਰਦਰਸ਼ਤਾ ਬਾਰੇ ਅਮਲ ਸੰਹਿਤਾ ਵਿੱਚ ਸਾਡੀਆਂ ਵਚਨਬੱਧਤਾਵਾਂ ਦੇ ਅਨੁਕੂਲ ਹੈ.
ਕੀ ਮੇਰੇ ਵੱਲੋਂ ਸਮੱਗਰੀ ਬਦਲਣ ਤੋਂ ਬਾਅਦ ਵੀ ਸੰਕੇਤ ਉਸ ਨਾਲ ਜੁੜੇ ਰਹਿਣਗੇ?
ਰਹਿ ਸਕਦੇ ਹਨ, ਪਰ ਇਹ ਸੰਕੇਤ ਅਤੇ ਤੁਹਾਡੇ ਵੱਲੋਂ ਕੀਤੀਆਂ ਤਬਦੀਲੀਆਂ 'ਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ.
ਸਮਰਥਿਤ ਤਸਵੀਰਾਂ ਅਤੇ ਆਡੀਓ ਦੀ ਇੱਕ ਅਸਲ ਕਾਪੀ ਰੱਖੋ ਅਤੇ ਸੋਧਣ, ਫ਼ਾਰਮੈਟ ਬਦਲਣ ਅਤੇ ਪ੍ਰਕਾਸ਼ਿਤ ਕਰਨ ਤੋਂ ਬਾਅਦ ਨਮੂਨੇ ਵਜੋਂ ਚੁਣੀਆਂ ਫ਼ਾਈਲਾਂ ਦੀ ਜਾਂਚ ਲਈ ਸਮੱਗਰੀ ਦੇ ਮੂਲ ਦੀ ਪੁਸ਼ਟੀ ਵਾਲੀ API ਵਰਤੋ. ਤਸਵੀਰਾਂ ਨੂੰ ਕੱਟਣ, ਉਨ੍ਹਾਂ ਵਿੱਚ ਦ੍ਰਿਸ਼ੀ ਸ਼ੋਰ ਜੋੜਨ, JPEG ਵਿੱਚ ਬਦਲਣ ਅਤੇ ਸਕ੍ਰੀਨਸ਼ਾਟ ਲੈਣ ਨਾਲ ਸੰਕੇਤਾਂ ਨੂੰ ਪਛਾਣਨਾ ਹੋਰ ਮੁਸ਼ਕਲ ਹੋ ਸਕਦਾ ਹੈ. ਤੁਸੀਂ ਲਿਖਤ ਦੀ ਇਸ ਤਰ੍ਹਾਂ ਜਾਂਚ ਤਾਂ ਹੀ ਕਰ ਸਕਦੇ ਹੋ ਜੇ ਤੁਹਾਡੀ ਸੰਸਥਾ ਨੂੰ ਲਿਖਤ ਪਛਾਣ ਸਾਧਨ ਤੱਕ ਪਹੁੰਚ ਦੀ ਮਨਜ਼ੂਰੀ ਮਿਲੀ ਹੋਵੇ.
ਜਿੱਥੇ ਤੁਹਾਡਾ ਫ਼ਾਈਲ ਫ਼ਾਰਮੈਟ ਅਤੇ ਕਾਰਜ-ਪ੍ਰਵਾਹ ਇਸ ਦੀ ਇਜਾਜ਼ਤ ਦਿੰਦੇ ਹੋਣ, ਮੌਜੂਦਾ C2PA ਮੈਟਾਡਾਟਾ ਸੰਭਾਲ ਕੇ ਰੱਖੋ ਅਤੇ ਆਪਣੀਆਂ ਬਣਾਈਆਂ ਫ਼ਾਈਲਾਂ ਵਿੱਚ ਸਮੱਗਰੀ ਪ੍ਰਮਾਣ-ਪੱਤਰ ਸ਼ਾਮਲ ਕਰੋ. ਮੂਲ ਸੰਬੰਧੀ ਜਾਣਕਾਰੀ ਨੂੰ ਵਧੇਰੇ ਟਿਕਾਊ ਜਾਂ ਲਾਭਦਾਇਕ ਬਣਾਉਣ ਲਈ ਤੁਸੀਂ ਆਪਣੇ ਚਿੰਨ੍ਹ ਜੋੜਨ ਬਾਰੇ ਵੀ ਵਿਚਾਰ ਕਰ ਸਕਦੇ ਹੋ. ਲਾਗੂ ਕਰਨ ਦੇ ਵੇਰਵਿਆਂ ਲਈ C2PA ਦੇ ਤਕਨੀਕੀ ਦਸਤਾਵੇਜ਼ ਵੇਖੋ.
ਲਿਖਤ ਵਿੱਚ ਵਾਟਰਮਾਰਕ ਮਾਡਲ ਦੀ ਸ਼ਬਦ-ਚੋਣ ਦਾ ਹਿੱਸਾ ਹੁੰਦਾ ਹੈ. ਜੇ ਤੁਸੀਂ ਸ਼ਬਦਾਵਲੀ ਜਿਉਂ ਦੀ ਤਿਉਂ ਰੱਖਦੇ ਹੋ, ਤਾਂ ਲਿਖਤ ਦੀ ਮੁੜ ਵਰਤੋਂ ਵੇਲੇ ਬਿਨਾਂ ਕਿਸੇ ਵਾਧੂ ਏਕੀਕਰਨ ਦੇ ਕੰਮ ਤੋਂ ਸੰਕੇਤ ਬਣਿਆ ਰਹਿਣ ਦੀ ਉਮੀਦ ਹੁੰਦੀ ਹੈ. ਵੱਡੇ ਪੱਧਰ 'ਤੇ ਮੁੜ ਲਿਖਣ, ਵੱਖਰੇ ਸ਼ਬਦਾਂ ਵਿੱਚ ਲਿਖਣ ਜਾਂ ਅਨੁਵਾਦ ਕਰਨ ਨਾਲ ਪਛਾਣ ਦੀ ਭਰੋਸੇਯੋਗਤਾ ਘਟ ਸਕਦੀ ਹੈ. ਸ਼ਬਦਾਵਲੀ ਨਾ ਬਦਲਣ 'ਤੇ ਵੀ ਇਹ ਗਾਰੰਟੀ ਨਹੀਂ ਹੁੰਦੀ ਕਿ ਵਾਟਰਮਾਰਕ ਪਛਾਣਿਆ ਜਾ ਸਕੇਗਾ, ਖ਼ਾਸ ਕਰਕੇ ਛੋਟੇ ਅੰਸ਼ਾਂ ਜਾਂ ਅਜਿਹੀ ਲਿਖਤ ਵਿੱਚ ਜਿੱਥੇ ਵੱਖਰੇ ਸ਼ਬਦ ਚੁਣਨ ਦੀ ਗੁੰਜਾਇਸ਼ ਘੱਟ ਹੋਵੇ.
ਮੈਂ ਇੱਕ ਕਲਾਊਡ ਸੇਵਾ ਰਾਹੀਂ OpenAI ਦੇ ਮਾਡਲਾਂ ਦੀ ਵਰਤੋਂ ਕਰਦਾ ਹਾਂ. ਕੀ ਉਨ੍ਹਾਂ ਦੇ ਨਤੀਜਿਆਂ ਵਿੱਚ ਵੀ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਹੁੰਦੇ ਹਨ?
ਅਸੀਂ ਆਪਣੇ ਸਾਰੇ ਕਲਾਊਡ ਅਤੇ ਵੰਡ ਪ੍ਰਦਾਤਾਵਾਂ ਨਾਲ ਕੰਮ ਕਰ ਰਹੇ ਹਾਂ ਤਾਂ ਜੋ ਤਸਵੀਰਾਂ, ਆਡੀਓ ਅਤੇ ਲਿਖਤ ਸਮੇਤ ਸਾਰੇ ਯੋਗ ਨਤੀਜਿਆਂ ਵਿੱਚ ਵਾਟਰਮਾਰਕਾਂ ਸਣੇ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਜੋੜੇ ਜਾਣ. ਉਪਲਬਧਤਾ ਨਤੀਜੇ ਅਤੇ ਭਾਈਵਾਲ ਮੁਤਾਬਕ ਵੱਖਰੀ ਹੋ ਸਕਦੀ ਹੈ.
ਕੀ ਮੂਲ ਸੰਬੰਧੀ ਸੰਕੇਤ ਦਿਸਣ ਵਾਲੇ ਏਆਈ ਲੇਬਲਾਂ ਜਾਂ ਹੋਰ ਖੁਲਾਸਿਆਂ ਦੀ ਥਾਂ ਲੈਂਦੇ ਹਨ?
ਨਹੀਂ. ਵਾਟਰਮਾਰਕ ਅਤੇ C2PA ਮੈਟਾਡਾਟਾ ਅਜਿਹੀ ਜਾਣਕਾਰੀ ਦਿੰਦੇ ਹਨ ਜਿਸ ਨੂੰ ਸਾਫ਼ਟਵੇਅਰ ਪੜ੍ਹ ਸਕਦਾ ਹੈ. ਇਹ ਦਿਸਣ ਵਾਲੇ ਲੇਬਲਾਂ, ਬੈਨਰਾਂ ਜਾਂ ਹੋਰ ਸੂਚਨਾਵਾਂ ਦੀ ਥਾਂ ਨਹੀਂ ਲੈਂਦੇ, ਜੋ ਲਾਜ਼ਮੀ ਹੋ ਸਕਦੀਆਂ ਹਨ.
ਕੀ ਤੁਹਾਨੂੰ ਵਾਧੂ ਖੁਲਾਸਾ ਕਰਨ ਦੀ ਲੋੜ ਹੈ, ਇਹ ਇਸ ਗੱਲ 'ਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ ਕਿ ਤੁਸੀਂ ਸਮੱਗਰੀ ਕਿਵੇਂ ਅਤੇ ਕਿੱਥੇ ਵਰਤਦੇ ਹੋ. OpenAI ਤੁਹਾਡੀਆਂ ਖ਼ਾਸ ਕਾਨੂੰਨੀ ਜ਼ਿੰਮੇਵਾਰੀਆਂ ਬਾਰੇ ਸਲਾਹ ਨਹੀਂ ਦੇ ਸਕਦਾ; ਤੁਹਾਡੀ ਕਾਨੂੰਨੀ ਟੀਮ ਨੂੰ ਤੁਹਾਡੀ ਵਰਤੋਂ ਲਈ ਲਾਗੂ ਲੋੜਾਂ ਦਾ ਮੁਲਾਂਕਣ ਕਰਨਾ ਚਾਹੀਦਾ ਹੈ.
ਯੂਰਪੀ ਸੰਘ ਦੇ ਏਆਈ ਕਾਨੂੰਨ ਬਾਰੇ ਮੇਰੇ ਹੋਰ ਸਵਾਲ ਹਨ
ਕਿਰਪਾ ਕਰਕੇ ਯੂਰਪੀ ਸੰਘ ਦੇ ਏਆਈ ਕਾਨੂੰਨ ਬਾਰੇ ਪੁੱਛਗਿੱਛ ਭੇਜੋ ਅਤੇ ਅਸੀਂ ਤੁਹਾਨੂੰ ਜਵਾਬ ਦੇਵਾਂਗੇ.