
W ramach działań na rzecz bezpieczniejszego i bardziej przejrzystego ekosystemu AI OpenAI stosuje sygnały pochodzenia, które pomagają ustalić, czy treści zostały wygenerowane przez model OpenAI.
Sygnały pochodzenia mogą dostarczać przydatnych informacji o źródle treści, ale nie gwarantują ich poprawności, braku modyfikacji, zgodności praw do nich z prawem ani przedstawienia ich we właściwym kontekście.
Sygnały pochodzenia OpenAI
Jakich sygnałów pochodzenia używa OpenAI?
OpenAI stosuje różne sygnały pochodzenia w zależności od rodzaju treści.
| Rodzaj treści | Sygnały pochodzenia | Uwagi |
|---|---|---|
| Obrazy | Content Credentials i znaki wodne SynthID | Obrazy wygenerowane za pomocą ChatGPT, Codex lub API OpenAI zawierają oba sygnały. |
| Dźwięk | Znaki wodne SynthID | Dźwięk wygenerowany przez ChatGPT lub API OpenAI zawiera niesłyszalny znak wodny osadzony w samym dźwięku. |
| Tekst | Znaki wodne textGrain (tylko w UE) | W UE tekst generowany przez ChatGPT powstaje z zastosowaniem niewidocznej zmiany w mechanizmie losowego doboru słów przez model, aby spełnić wymogi unijnego aktu w sprawie AI. Klienci API na całym świecie mogą włączyć znaki wodne w generowanych tekstach w ustawieniach projektu lub organizacji. |
| Wideo | Content Credentials | Sora została wycofana. Dowiedz się więcej. |
Zakres stosowania sygnałów może zależeć od produktu, modelu, sposobu eksportu, typu pliku i daty utworzenia treści. Sygnały są stosowane w treściach generowanych przez API, z wyjątkiem modeli, które mają zostać wkrótce wycofane, w tym gpt-image-1, gpt-image-1.5 i sora-2.
Dlaczego w niektórych rodzajach treści stosuje się kilka sygnałów?
Gdy jest to technicznie możliwe, OpenAI łączy metadane ze znakami wodnymi, aby obie metody wzajemnie uzupełniały swoje ograniczenia. Metadane mogą zawierać szczegółowe informacje, ale platformy, narzędzia do edycji i konwersja plików mogą je usuwać. Znaki wodne dostarczają mniej kontekstu, ale ponieważ są osadzone w samej wygenerowanej treści, mogą przetrwać niektóre przekształcenia usuwające metadane.
Na ile sygnały pochodzenia są odporne na modyfikacje treści?
Znaki wodne SynthID w obrazach i dźwięku oraz znaki wodne textGrain w tekście są zaprojektowane tak, aby wytrzymywać typowe zmiany. W zależności od rodzaju treści mogą to być drobne poprawki, kopiowanie i wklejanie, kadrowanie lub robienie zrzutów ekranu. Bardziej rozległe zmiany — takie jak znaczne przycięcie obrazu, kompresja pliku, daleko idąca parafraza lub tłumaczenie — mogą sprawić, że znak wodny stanie się niewykrywalny. Po rozległych zmianach określanie wyniku jako „wygenerowanego przez OpenAI” może też być mniej miarodajne.
Content Credentials, opracowane przez Coalition for Content Provenance and Authenticity, mogą zostać utracone podczas zwykłych czynności, takich jak zrobienie zrzutu ekranu czy konwersja pliku. Jeśli pozostają dostępne, mogą dostarczyć więcej szczegółów o pochodzeniu i historii pliku niż sam znak wodny.
Tam, gdzie jest to technicznie możliwe, stosujemy obie metody, aby zwiększyć szansę na zachowanie informacji o pochodzeniu po zmianach w treści.
Czym są Content Credentials i do czego służą?
Content Credentials dołączają do pliku informacje o jego pochodzeniu i historii, na przykład o tym, jakie narzędzie go utworzyło i kiedy. Korzystają z otwartego standardu opracowanego przez Coalition for Content Provenance and Authenticity (C2PA), dlatego bywają nazywane „metadanymi C2PA”.
Content Credentials pomagają weryfikować pochodzenie treści. Nie służą wyłącznie do oznaczania treści generowanych przez AI: producenci aparatów, redakcje i inne podmioty również korzystają z tego standardu, aby poświadczać źródło i historię swoich materiałów. Dowiedz się więcej o C2PA.
Czym jest SynthID i do czego służy?
SynthID to opracowana przez Google DeepMind technologia niewidocznych znaków wodnych, która osadza sygnał bezpośrednio w generowanych materiałach. W przeciwieństwie do metadanych sygnał jest częścią samej treści i może się zachować po niektórych modyfikacjach lub przekształceniach. SynthID dostarcza dodatkowy sygnał pochodzenia, uzupełniający metadane C2PA. Na przykład po usunięciu metadanych z pliku osadzony znak wodny może nadal wskazywać, że treść została wygenerowana za pomocą obsługiwanych narzędzi OpenAI. Dowiedz się więcej o SynthID.
Dlaczego oznaczacie generowane teksty znakami wodnymi?
Wprowadzamy znaki wodne w tekstach dla użytkowników ChatGPT w UE, aby spełnić wymogi unijnego aktu w sprawie AI oraz wywiązać się z naszych zobowiązań wynikających z unijnego kodeksu postępowania dotyczącego przejrzystości treści generowanych przez AI, który OpenAI podpisało wraz z kilkoma innymi czołowymi dostawcami AI.
Czym jest textGrain i do czego służy?
textGrain to technologia OpenAI służąca do oznaczania tekstu znakami wodnymi. Subtelnie modyfikuje sposób, w jaki model podczas pisania losowo wybiera spośród możliwych słów lub ich fragmentów. W obrębie fragmentu tekstu wybory te tworzą wzorzec, którego detektor może szukać nawet po wprowadzeniu pewnych zmian.
Znak wodny jest zawarty w samym doborze słów i pozostaje niewidoczny dla czytelników. Nie dodaje ukrytych znaków, niewidocznych spacji ani nietypowej interpunkcji. Znaki wodne w tekście pomagają spełnić wymóg oznaczania generowanych tekstów wynikający z unijnego aktu w sprawie AI.
Narzędzia weryfikacyjne OpenAI
Jak sprawdzić, czy treść została wygenerowana za pomocą narzędzi OpenAI?
Na stronie openai.com/verify możesz sprawdzić, czy obsługiwany plik obrazu lub dźwięku zawiera sygnały pochodzenia związane z treściami wygenerowanymi lub wyeksportowanymi przez narzędzia OpenAI. Po przesłaniu obsługiwanego pliku narzędzie poszuka obsługiwanych sygnałów pochodzenia OpenAI, takich jak znak wodny SynthID lub zaufany manifest C2PA powiązany z OpenAI. Jeśli narzędzie znajdzie obsługiwany sygnał pochodzenia OpenAI, oznacza to, że treść została prawdopodobnie wygenerowana przez model OpenAI.
Deweloperzy i organizacje mogą też korzystać z Content Provenance API OpenAI, aby sprawdzać obrazy i dźwięk pod kątem sygnałów pochodzenia OpenAI oraz włączać weryfikację do własnych aplikacji lub procesów. Organizacje, których zastosowanie spełnia kryteria, mogą złożyć wniosek o zwiększenie limitów.
W przypadku tekstu, zgodnie z naszymi obowiązkami wynikającymi z unijnego aktu w sprawie AI, organizacje, których zastosowanie spełnia kryteria — na przykład instytucje akademickie i badawcze zajmujące się pochodzeniem tekstu, niezawodnością wykrywania lub tym, jak ludzie rozumieją wyniki weryfikacji pochodzenia — mogą złożyć wniosek o dostęp do detektora tekstu. Wnioski uprawnionych organizacji będziemy rozpatrywać indywidualnie i w razie potrzeby kontaktować się z nimi, przekazując aktualne informacje lub prosząc o dodatkowe dane. Nasze zasady dostępu mogą się zmieniać w miarę zdobywania wiedzy i doskonalenia technologii.
Obecnie współpracujemy z niewielką grupą badaczy, w tym z Johnem Thickstunem, adiunktem informatyki na Uniwersytecie Cornella, Martinem Vechevem, profesorem informatyki w ETH Zurich i dyrektorem naukowym INSAIT, oraz badaczami z Instytutu Inteligentnych Technologii im. Kempelena (KInIT). Współpraca ta ma pomóc lepiej zrozumieć możliwości i ograniczenia technologii oraz wskazać kierunki ulepszania znaków wodnych w tekście.
Kto może uzyskać wyższe limity weryfikacji i czy za sprawdzanie pobierane są opłaty?
Weryfikacja za pomocą Content Provenance API jest obecnie bezpłatna i podlega limitom użycia. Program wyższych limitów jest przeznaczony dla projektów dotyczących pochodzenia treści, które spełniają kryteria i służą interesowi publicznemu. Rutynowe komercyjne kontrole pod kątem oszustw nie są obecnie objęte programem. Organizacje, których zastosowanie spełnia kryteria, mogą złożyć wniosek o zwiększenie limitów, ale jego złożenie nie gwarantuje akceptacji. Publiczny interfejs API pozostaje dostępny z domyślnymi limitami, również do ocen na mniejszą skalę. Aktualne limity użycia znajdziesz w dokumentacji Content Provenance API.
Co oznaczają wyniki weryfikacji?
Wykrycie sygnału przez openai.com/verify lub Content Provenance API OpenAI oznacza, że przesłana treść zawiera obsługiwany sygnał pochodzenia powiązany z OpenAI. Narzędzie nie potwierdza poprawności treści, braku modyfikacji, zgodności praw do nich z prawem ani przedstawienia ich we właściwym kontekście. Nie wskazuje też, kto stworzył treść ani w jakim celu.
Brak wykrytego sygnału oznacza, że narzędzie nie znalazło w przesłanym pliku sygnałów pochodzenia nadanych przez OpenAI. Treść mimo to mogła zostać wygenerowana lub wyeksportowana przez OpenAI, jeśli:
Powstała, zanim sygnały pochodzenia stały się dostępne.
Pochodzi z nieobsługiwanego produktu, modelu, sposobu eksportu lub typu pliku.
Metadane zostały usunięte podczas przesyłania, pobierania, edycji, konwersji lub udostępniania.
Znak wodny został osłabiony przez kompresję, kadrowanie, szum, edycję, konwersję formatu lub inne przekształcenia.
Klip audio jest zbyt krótki lub został znacznie zmodyfikowany.
Jak uzyskać najbardziej wiarygodny wynik weryfikacji?
Przesyłaj po jednym obsługiwanym pliku i w miarę możliwości używaj oryginalnego wyeksportowanego pliku. W przypadku obrazów unikaj kadrowania lub konwersji pliku przed sprawdzeniem. W przypadku dźwięku najlepsze wyniki dają zazwyczaj klipy o długości od 10 do 60 sekund. Nawet jeśli nie wykryto sygnału, przed wyciągnięciem wniosków weź pod uwagę źródło pliku i jego kontekst.
Czy wyniki ujawniają moje polecenie lub dane osobowe?
Sygnały pochodzenia nie zawierają szczegółów dotyczących użytkownika, organizacji ani polecenia.
Co dzieje się z treściami, które weryfikuję za pomocą openai.com/verify lub Content Provenance API?
Treści przesłane do openai.com/verify lub do naszego Content Provenance API w celu weryfikacji są przetwarzane wyłącznie po to, by sprawdzić obecność obsługiwanych sygnałów pochodzenia. Treści nie są przechowywane, chyba że wymaga tego prawo, i nie są wykorzystywane do trenowania modeli OpenAI.
Czy OpenAI potrafi wykrywać treści wygenerowane przez inne narzędzia AI?
Nasze narzędzia do weryfikacji pochodzenia treści służą do wykrywania obsługiwanych sygnałów pochodzenia związanych z treściami wygenerowanymi przez modele OpenAI lub wyeksportowanymi przez narzędzia OpenAI. Nie służą do wykrywania treści wygenerowanych przez inne modele AI. Mogą też nie wykryć treści wygenerowanych przez OpenAI, jeśli odpowiedniego sygnału brakuje, nie jest on obsługiwany lub został osłabiony.
Jak działają znaki wodne
Czy znaki wodne rozstrzygają o autorstwie, własności lub odpowiedzialności prawnej?
Nie. Znak wodny wskazuje, że model OpenAI prawdopodobnie wygenerował lub przetworzył treść. Sam w sobie nie pozwala ustalić, kto jest autorem lub właścicielem treści, czy wymagane było ujawnienie użycia AI ani kto ponosi odpowiedzialność prawną. Nie informuje też, czy model edytował treść przesłaną przez użytkownika.
Czy znaki wodne wskazują, w jakim stopniu wykorzystano model OpenAI?
Nie. Detektor informuje, czy znalazł znak wodny. Znalezienie znaku wodnego wskazuje, że model OpenAI prawdopodobnie wygenerował lub przetworzył treść, ale nie pokazuje, czy wygenerował ją w części, czy w całości, ani jak duży był wkład człowieka.
Jak działa oznaczanie tekstu znakami wodnymi?
Oznaczanie tekstu znakiem wodnym polega na tworzeniu tajnego wzorca w dokonywanych przez model podczas pisania wyborach słów i ich fragmentów, zwanych „tokenami”.
Na każdym kroku model przypisuje prawdopodobieństwo każdemu możliwemu kolejnemu tokenowi. System oznaczania znakami wodnymi tworzy kilka zmodyfikowanych zestawów tych prawdopodobieństw, z których każdy faworyzuje inne wybory zgodnie z tajnym kluczem. Zestawy są zrównoważone tak, by po uśrednieniu odpowiadały pierwotnym prawdopodobieństwom modelu. Klucz określa, którego zestawu użyć, a model dokonuje następnie nowego losowego wyboru z tego zestawu.
Detektor z tym samym kluczem i zgodnymi ustawieniami może później sprawdzić, czy tekst odpowiada tajnemu wzorcowi częściej, niż wynikałoby to z przypadku.
Czy znaki wodne działają w tekstach opartych na faktach i tekstach dostarczonych przez użytkownika?
Oznaczanie tekstu znakiem wodnym wymaga, by model miał różne możliwości wyrażenia danej myśli. Swoboda ta jest mniejsza, gdy odpowiedź musi ściśle trzymać się faktów lub być precyzyjna — na przykład w zadaniu matematycznym — albo gdy model ma odtworzyć dostarczony tekst bez zmian. W takich przypadkach model ma mniejsze możliwości zmiany sformułowań bez zauważalnego wpływu na tekst, dlatego znak wodny może nie zostać wykryty.
Czy znaki wodne działają w krótkich odpowiedziach i kodzie?
Krótkie fragmenty zwykle nie zawierają wystarczająco dużo tekstu, by wiarygodnie wykryć znak wodny. Kod również trudniej oznaczyć znakiem wodnym, ponieważ liczba sensownych możliwości kontynuacji jest mniejsza niż w zwykłym tekście.
Ze względu na te ograniczenia kodeks postępowania dotyczący przejrzystości treści generowanych przez AI, związany z unijnym aktem w sprawie AI, nie wymaga znaków wodnych w wynikach krótszych niż 200 tokenów — około 150 słów w języku angielskim — ani we fragmentach kodu.
Jak wykrywanie znaków wodnych w tekście różni się w zależności od języka?
Skuteczność wykrywania zależy od języka. Obecnie w niektórych językach znaki wodne wykrywa się łatwiej niż w innych. Możemy dostosować siłę znaku wodnego, aby poprawić wykrywalność w językach, w których sygnał jest słabszy.
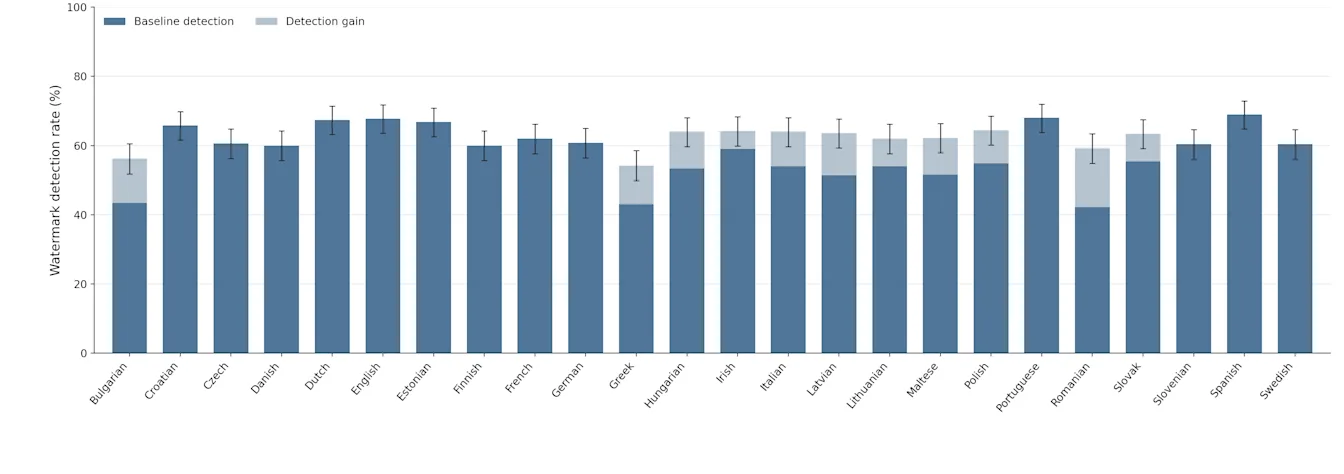
Ten wykres przedstawia skuteczność wykrywania we wszystkich 24 językach urzędowych UE. Najpierw wygenerowaliśmy 500 syntetycznych poleceń w języku angielskim na różne tematy, a następnie przetłumaczyliśmy je na pozostałe 23 języki. Przy odsetku wyników fałszywie dodatnich wynoszącym 1% najwyższą skuteczność wykrywania osiąga język hiszpański (69,0%), a najniższą — rumuński (42,2%). Nasz znak wodny ma regulowany parametr siły — „pokrętło”, które wzmacnia lub osłabia jego sygnał dla różnych obszarów zastosowań. Dzięki temu regulatorowi zwiększyliśmy siłę sygnału dla języków o skuteczności wykrywania poniżej 60%. Jasnoniebieskie części słupków pokazują uzyskaną poprawę.
Czy znaki wodne w tekście obniżają jakość modelu?
Nasze testy wskazują, że nie. W testach porównawczych, których używamy do oceny Astry, naszego najnowszego pionierskiego modelu, różnice w wynikach z oznaczaniem znakami wodnymi i bez niego mieszczą się w granicach wahań, które zwykle obserwujemy między kolejnymi ocenami. Wcześniejsze testy w ChatGPT również nie wykazały, by wprowadzenie znaków wodnych zmieniło odsetek ocen z kciukiem w dół lub inne wskaźniki produktu.
Czy znaki wodne w tekście spowalniają model?
Oznaczanie tekstu znakami wodnymi ma znikomy wpływ na szybkość naszych modeli.
Czym znaki wodne OpenAI w tekście różnią się od narzędzi innych firm do wykrywania treści AI?
Narzędzia wykrywające innych firm, takie jak Pangram, zazwyczaj korzystają z klasyfikatorów, aby rozpoznawać tekst wygenerowany przez AI na podstawie wzorców, takich jak dobór słów. Takie podejście polega na analizie tekstu po wygenerowaniu, a nie na wykrywaniu osadzonego sygnału. Unijny akt w sprawie AI wyraźnie wymaga osadzania sygnału w generowanym tekście.
Dlaczego używacie własnych znaków wodnych w tekście zamiast TextSeal lub SynthID?
Opracowaliśmy własną metodę oznaczania tekstu znakami wodnymi, textGrain, aby mieć większą niż w przypadku SynthID lub TextSeal kontrolę nad równowagą między wykrywalnością znaku wodnego a różnorodnością odpowiedzi generowanych na to samo polecenie. W naszych testach metoda ta poprawnie rozpoznawała podobny lub większy odsetek próbek tekstu ze znakiem wodnym niż SynthID dla tekstu. Planujemy udostępnić textGrain jako technologię open source, aby inni mogli ją rozwijać i pomagać w doskonaleniu znaków wodnych w tekście.
Czy oznaczanie tekstu znakiem wodnym dodaje ukryte znaki, dodatkowe tokeny lub widoczne zmiany?
Nie. Oznaczanie tekstu znakiem wodnym zmienia statystyczny wzorzec doboru słów. Nie wstawia ukrytych znaków ani nie dodaje tokenów służących wyłącznie do oznaczania. Znak wodny jest niewidoczny dla czytelników, a kopiowanie i wklejanie tekstu nie wprowadza ukrytych elementów.
Wskazówki dla klientów
Korzystam z API. Jak włączyć znaki wodne w tekście?
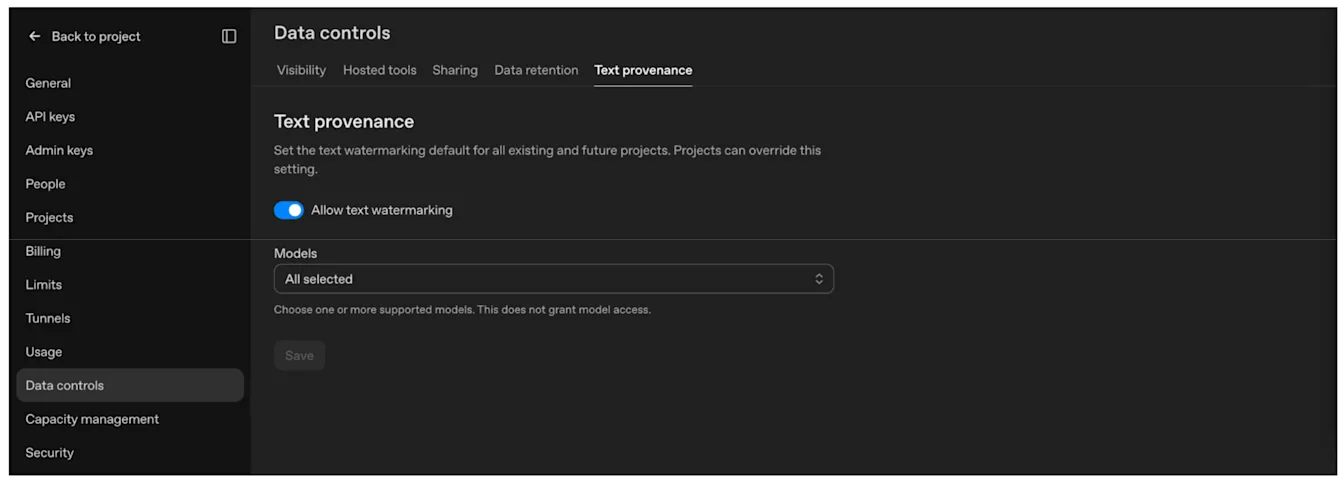
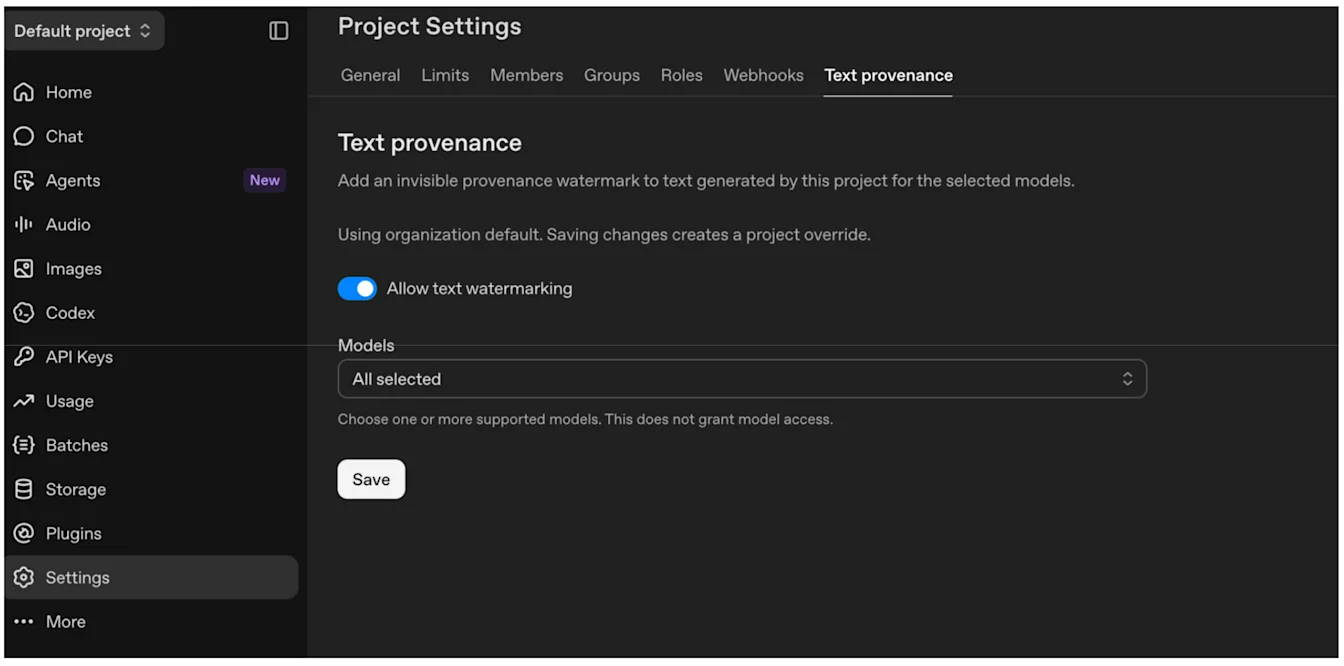
Klienci API OpenAI mogą włączyć oznaczanie tekstu znakami wodnymi dla konkretnego projektu w Ustawieniach lub dla całej organizacji w Ustawieniach organizacji. W obu przypadkach klienci mogą wybrać modele, których teksty będą oznaczane znakiem wodnym. Po włączeniu tej funkcji dla obsługiwanego modelu OpenAI dodaje znak wodny podczas generowania tekstu. Klienci nie muszą dodawać osobnego oznaczenia do każdej odpowiedzi.
Włącz opcję Zezwalaj na znaki wodne w tekście, wybierz modele, a następnie wybierz Zapisz.
Ustawienie domyślne organizacji: Ustawienia organizacji → Kontrola danych → Pochodzenie tekstu.
Ustawienie nadrzędne projektu: Ustawienia projektu → Pochodzenie tekstu.
Dla których modeli mogę włączyć znaki wodne?
W Ustawieniach i Ustawieniach organizacji klienci mogą sprawdzić listę modeli, dla których oznaczanie znakami wodnymi jest obecnie dostępne. W nadchodzących tygodniach rozszerzymy obsługę na wszystkie starsze modele.
Czy włączenie znaków wodnych w tekście daje też dostęp do detektora tekstu?
Nie. Dostęp do detektora tekstu jest obecnie ograniczony do zatwierdzonych instytucji badawczych i akademickich, które pracują nad zwiększeniem niezawodności znaków wodnych w tekście, ułatwieniem ich stosowania oraz jaśniejszym wyjaśnianiem tej technologii i jej wyników. Jest to zgodne z naszymi zobowiązaniami wynikającymi z kodeksu postępowania dotyczącego przejrzystości treści generowanych przez AI, związanego z unijnym aktem w sprawie AI.
Czy sygnały pozostaną w treści po jej przekształceniu?
Mogą pozostać, ale zależy to od sygnału i wprowadzonych zmian.
W przypadku obsługiwanych obrazów i nagrań dźwiękowych zachowaj oryginalną kopię i użyj Content Provenance API, aby przetestować reprezentatywne pliki po edycji, konwersji i publikacji. W przypadku obrazów kadrowanie, dodawanie szumu, konwersja do JPEG i robienie zrzutów ekranu mogą utrudnić wykrywanie sygnałów. Możesz testować tekst w ten sposób tylko wtedy, gdy Twoja organizacja uzyskała zgodę na dostęp do detektora tekstu.
Jeśli format pliku i proces pracy na to pozwalają, zachowuj istniejące metadane C2PA i dołączaj Content Credentials do tworzonych plików. Możesz też rozważyć dodawanie własnych oznaczeń, aby informacje o pochodzeniu były trwalsze lub bardziej użyteczne. Szczegóły wdrożenia znajdziesz w dokumentacji technicznej C2PA.
W przypadku tekstu znak wodny jest zawarty w doborze słów przez model. Jeśli zachowasz brzmienie tekstu, sygnał powinien pozostać przy jego ponownym użyciu, bez dodatkowych prac integracyjnych. Znaczne przeredagowanie, parafraza lub tłumaczenie mogą zmniejszyć wiarygodność wykrywania. Nawet niezmienione brzmienie nie gwarantuje wykrywalności znaku wodnego, zwłaszcza w krótkich fragmentach lub tekstach o niewielkiej swobodzie doboru słów.
Korzystam z modeli OpenAI za pośrednictwem usługi chmurowej. Czy generowane w ten sposób treści również zawierają sygnały pochodzenia?
Współpracujemy ze wszystkimi naszymi dostawcami usług chmurowych i partnerami dystrybucyjnymi, aby zapewnić osadzanie sygnałów pochodzenia, w tym znaków wodnych, we wszystkich kwalifikujących się treściach wyjściowych, w tym obrazach, dźwięku i tekście. Dostępność może zależeć od rodzaju treści i partnera.
Czy sygnały pochodzenia zastępują widoczne oznaczenia AI lub inne informacje o jej użyciu?
Nie. Znaki wodne i metadane C2PA dostarczają informacji, które może odczytać oprogramowanie. Nie zastępują widocznych etykiet, banerów ani innych powiadomień, które mogą być wymagane.
To, czy potrzebujesz dodatkowej informacji o użyciu AI, zależy od tego, jak i gdzie wykorzystujesz treść. OpenAI nie może doradzać w zakresie Twoich konkretnych obowiązków prawnych. Wymogi dotyczące Twojego zastosowania powinien ocenić Twój zespół prawny.
Mam więcej pytań dotyczących unijnego aktu w sprawie AI
Prosimy przesłać zapytanie dotyczące unijnego aktu w sprawie AI, a skontaktujemy się z Tobą.