
W ramach działań na rzecz bezpieczniejszego i bardziej przejrzystego ekosystemu AI OpenAI stosuje sygnały pochodzenia, aby pomagać ludziom ustalić, czy treści zostały wygenerowane przez model OpenAI.
Sygnały pochodzenia mogą dostarczać przydatnych informacji o źródle treści, ale nie gwarantują ich zgodności z faktami, braku modyfikacji, legalności ich posiadania ani przedstawienia we właściwym kontekście.
Sygnały pochodzenia OpenAI
Jakich sygnałów pochodzenia używa OpenAI?
OpenAI używa różnych sygnałów pochodzenia dla różnych typów treści.
| Typ treści | Sygnały pochodzenia | Uwagi |
|---|---|---|
| Obrazy | Content Credentials i znaki wodne SynthID | Obrazy wygenerowane za pomocą ChatGPT, Codex lub API OpenAI zawierają oba sygnały. |
| Dźwięk | Znaki wodne SynthID | Nagrania dźwiękowe wygenerowane przez ChatGPT lub API OpenAI zawierają niesłyszalny znak wodny osadzony w samym dźwięku. |
| Tekst | Znaki wodne textGrain (tylko w UE) | W UE tekst generowany przez ChatGPT zawiera niewidoczną zmianę w mechanizmie losowości używanym przez model do doboru słów, aby spełnić wymogi unijnego aktu w sprawie AI. Klienci API na całym świecie mogą włączyć znaki wodne dla generowanych tekstów w ustawieniach projektu lub organizacji. |
| Wideo | Content Credentials | Usługa Sora została wycofana. Dowiedz się więcej. |
Zakres obsługi może się różnić w zależności od produktu, modelu, sposobu eksportu, typu pliku i czasu utworzenia treści. Obsługa obejmuje wyniki API z wyjątkiem modeli, które mają wkrótce zostać wycofane, w tym gpt-image-1, gpt-image-1.5 i sora-2.
Dlaczego w niektórych typach treści stosuje się wiele sygnałów?
Gdy jest to technicznie możliwe, OpenAI łączy metadane ze znakami wodnymi, aby wzajemnie uzupełniały swoje ograniczenia. Metadane mogą zawierać szczegółowe informacje, ale platformy, narzędzia do edycji i konwersja plików mogą je usuwać. Znaki wodne zawierają mniej informacji kontekstowych, ale ponieważ są osadzone w samej wygenerowanej treści, mogą przetrwać niektóre przekształcenia, które usuwają metadane.
Jak odporne są sygnały pochodzenia na modyfikacje treści?
Znaki wodne SynthID dla obrazów i dźwięku oraz textGrain dla tekstu zaprojektowano tak, by były odporne na typowe zmiany. W zależności od typu treści mogą to być drobne poprawki, kopiowanie i wklejanie, kadrowanie lub robienie zrzutów ekranu. Bardziej rozległe zmiany — takie jak mocne przycięcie obrazu, kompresja pliku, znaczne przeformułowanie tekstu lub tłumaczenie — mogą sprawić, że znak wodny stanie się niewykrywalny. Po rozległych zmianach określanie treści jako „wygenerowanej przez OpenAI” może też być mniej adekwatne.
Content Credentials, opracowane przez Coalition for Content Provenance and Authenticity, mogą zostać utracone podczas codziennych czynności, takich jak robienie zrzutu ekranu czy konwersja pliku. Jeśli zostaną zachowane, mogą dostarczyć więcej szczegółów o pochodzeniu i historii pliku niż sam znak wodny.
Gdy jest to technicznie możliwe, stosujemy obie metody, aby zwiększyć szanse na zachowanie informacji o pochodzeniu po zmianach treści.
Czym są Content Credentials i co umożliwiają?
Content Credentials dołączają do pliku informacje o jego pochodzeniu i historii, na przykład o tym, za pomocą jakiego narzędzia i kiedy powstał. Korzystają z otwartego standardu opracowanego przez Coalition for Content Provenance and Authenticity (C2PA), dlatego bywają nazywane „metadanymi C2PA”.
Content Credentials pomagają zweryfikować, skąd pochodzi treść. Nie ograniczają się do treści generowanych przez AI: producenci aparatów, redakcje i inne podmioty również korzystają z tego standardu, aby poświadczać źródło i historię swoich materiałów. Dowiedz się więcej o C2PA.
Czym jest SynthID i co umożliwia?
SynthID to opracowana przez Google DeepMind technologia niewidocznych znaków wodnych, która osadza sygnał bezpośrednio w generowanych materiałach. W przeciwieństwie do metadanych sygnał jest częścią samej treści i może przetrwać niektóre zmiany lub przekształcenia. SynthID zapewnia dodatkowy sygnał pochodzenia obok metadanych C2PA. Na przykład po usunięciu metadanych z pliku osadzony znak wodny nadal może wskazywać, że treść została wygenerowana za pomocą obsługiwanych narzędzi OpenAI. Dowiedz się więcej o SynthID.
Dlaczego oznaczacie generowany tekst znakami wodnymi?
Wprowadzamy znaki wodne w tekście dla użytkowników ChatGPT w UE, aby spełnić wymogi unijnego aktu w sprawie AI oraz nasze zobowiązania wynikające z unijnego kodeksu praktyk w zakresie przejrzystości treści generowanych przez AI, który OpenAI podpisało wraz z kilkoma innymi dużymi dostawcami AI.
Czym jest textGrain i co umożliwia?
textGrain to opracowana przez OpenAI technologia oznaczania tekstu znakami wodnymi. Subtelnie modyfikuje sposób, w jaki model losowo wybiera spośród możliwych słów lub ich fragmentów podczas pisania. W obrębie fragmentu tekstu wybory te tworzą wzorzec, którego detektor może szukać nawet po wprowadzeniu pewnych zmian.
Znak wodny jest zawarty w samym doborze słów i pozostaje niewidoczny dla czytelników. Nie dodaje ukrytych znaków, niewidocznych spacji ani nietypowej interpunkcji. Oznaczanie tekstu znakami wodnymi pomaga spełnić wymóg oznaczania generowanego tekstu przewidziany w unijnym akcie w sprawie AI.
Narzędzia weryfikacyjne OpenAI
Jak sprawdzić, czy treści wygenerowano za pomocą narzędzi OpenAI?
Na stronie openai.com/verify możesz sprawdzić, czy obsługiwany plik obrazu lub dźwięku zawiera sygnały pochodzenia powiązane z treściami wygenerowanymi lub wyeksportowanymi za pomocą narzędzi OpenAI. Po przesłaniu obsługiwanego pliku narzędzie poszuka obsługiwanych sygnałów pochodzenia OpenAI, takich jak znak wodny SynthID lub zaufany manifest C2PA powiązany z OpenAI. Jeśli narzędzie znajdzie obsługiwany sygnał pochodzenia OpenAI, oznacza to, że treści zostały prawdopodobnie wygenerowane przez model OpenAI.
Deweloperzy i organizacje mogą też korzystać z API OpenAI do weryfikacji pochodzenia treści, aby sprawdzać obrazy i nagrania dźwiękowe pod kątem sygnałów pochodzenia OpenAI oraz włączyć weryfikację do własnych aplikacji lub procesów. Organizacje, których zastosowanie spełnia kryteria, mogą złożyć wniosek o zwiększenie limitów.
W przypadku tekstu, zgodnie z naszymi obowiązkami wynikającymi z unijnego aktu w sprawie AI, organizacje, których zastosowanie spełnia kryteria — np. instytucje akademickie i badawcze zajmujące się pochodzeniem tekstu, wiarygodnością wykrywania lub sposobem interpretowania wyników weryfikacji pochodzenia przez ludzi — mogą złożyć wniosek o dostęp do detektora tekstu. Wnioski od organizacji spełniających kryteria będziemy rozpatrywać indywidualnie i w razie potrzeby przekażemy aktualne informacje lub poprosimy o dodatkowe dane. Nasze podejście do udzielania dostępu może się zmieniać w miarę zdobywania wiedzy i udoskonalania technologii.
Obecnie współpracujemy z niewielką grupą badaczy, w tym z Johnem Thickstunem, adiunktem informatyki na Uniwersytecie Cornella, Martinem Vechevem, profesorem informatyki na ETH w Zurychu i dyrektorem naukowym INSAIT, oraz badaczami z Instytutu Inteligentnych Technologii im. Kempelena (KInIT), aby lepiej poznać możliwości i ograniczenia tej technologii oraz wykorzystać tę wiedzę do udoskonalenia znakowania tekstu znakami wodnymi.
Kto może uzyskać wyższe limity weryfikacji i czy sprawdzanie jest płatne?
Sprawdzanie za pomocą interfejsu Content Provenance API jest obecnie bezpłatne i podlega limitom użycia. Program wyższych limitów jest skierowany do kwalifikujących się projektów weryfikacji pochodzenia służących interesowi publicznemu oraz procesów zapewniania rzetelności informacji, takich jak weryfikacja redakcyjna, sprawdzanie faktów, badania nad pochodzeniem treści i nadzór regulacyjny.
Ogólne zastosowania biznesowe obecnie nie są objęte programem. Dotyczy to na przykład komercyjnego zapobiegania oszustwom, uwierzytelniania i weryfikacji, a także odsprzedaży w ramach pakietów usług weryfikacji pochodzenia i analizy danych.
Organizacje, których zastosowanie spełnia kryteria programu, mogą złożyć wniosek o zwiększenie limitów, ale samo złożenie wniosku nie gwarantuje jego zatwierdzenia. Publiczny interfejs API pozostaje dostępny z domyślnymi limitami, również do ocen na mniejszą skalę. Aktualne limity użycia znajdziesz w dokumentacji interfejsu Content Provenance API.
Kto może uzyskać dostęp do detektora tekstu i czy sprawdzanie jest płatne?
Sprawdzanie za pomocą detektora tekstu jest obecnie bezpłatne. Kwalifikujące się zastosowania obejmują badania prowadzone przez instytucje akademickie i badawcze nad pochodzeniem tekstu, wiarygodnością wykrywania lub sposobem, w jaki ludzie rozumieją wyniki weryfikacji pochodzenia.
Ogólne zastosowania biznesowe obecnie nie są objęte programem. Dotyczy to na przykład komercyjnego zapobiegania oszustwom, uwierzytelniania i weryfikacji, a także odsprzedaży w ramach pakietów usług weryfikacji pochodzenia i analizy danych.
Zastosowania służące zapewnieniu rzetelności akademickiej, takie jak sprawdzanie prac studentów pod kątem użycia AI (np. przy pisaniu esejów lub prac dyplomowych), również obecnie nie są objęte programem.
Co oznaczają wyniki weryfikacji?
Jeśli openai.com/verify lub API OpenAI do weryfikacji pochodzenia treści wykryje sygnał, oznacza to, że przesłane treści zawierają obsługiwany sygnał pochodzenia powiązany z OpenAI. Narzędzie nie potwierdza zgodności treści z faktami, braku modyfikacji, legalności ich posiadania ani przedstawienia we właściwym kontekście. Nie wskazuje też, kto stworzył treści ani dlaczego powstały.
Jeśli nie wykryto sygnału, oznacza to, że narzędzie nie znalazło w przesłanym pliku sygnałów pochodzenia nadanych przez OpenAI. Treści nadal mogły zostać wygenerowane lub wyeksportowane za pomocą narzędzi OpenAI, jeśli:
Treści powstały, zanim sygnały pochodzenia stały się dostępne.
Treści pochodziły z nieobsługiwanego produktu, modelu lub typu pliku albo zostały wyeksportowane w nieobsługiwany sposób.
Metadane zostały usunięte podczas przesyłania, pobierania, edycji, konwersji lub udostępniania.
Znak wodny został osłabiony przez kompresję, kadrowanie, szum, edycję, konwersję formatu lub inne przekształcenia.
Nagranie dźwiękowe jest zbyt krótkie lub zostało znacznie zmodyfikowane.
Jak uzyskać najbardziej wiarygodny wynik weryfikacji?
Przesyłaj po jednym obsługiwanym pliku i w miarę możliwości korzystaj z oryginalnego wyeksportowanego pliku. W przypadku obrazów unikaj kadrowania i konwersji pliku przed sprawdzeniem. W przypadku audio najlepsze wyniki dają zwykle nagrania trwające od 10 do 60 sekund. Nawet jeśli nie zostanie wykryty żaden sygnał, przed wyciągnięciem wniosków weź pod uwagę źródło i kontekst pliku.
Czy wyniki ujawniają moje polecenie lub dane osobowe?
Sygnały pochodzenia nie zawierają szczegółowych informacji o użytkowniku, organizacji ani poleceniu.
Co dzieje się z treściami, które weryfikuję za pomocą openai.com/verify lub API do weryfikacji pochodzenia treści?
Treści przesłane na openai.com/verify lub do naszego API do weryfikacji pochodzenia treści są przetwarzane wyłącznie w celu sprawdzenia obecności obsługiwanych sygnałów pochodzenia. Treści nie są przechowywane, chyba że wymagają tego przepisy prawa, i nie są używane do trenowania modeli OpenAI.
Czy OpenAI może wykrywać treści wygenerowane za pomocą innych narzędzi AI?
Nasze narzędzia do weryfikacji pochodzenia treści służą do wykrywania obsługiwanych sygnałów pochodzenia związanych z treściami wygenerowanymi przez modele OpenAI lub wyeksportowanymi za pomocą narzędzi OpenAI. Nie służą do wykrywania treści wygenerowanych przez inne modele AI. Mogą też nie wykryć treści wygenerowanych przez OpenAI, jeśli odpowiedniego sygnału brakuje, nie jest on obsługiwany lub został osłabiony.
Jak działa oznaczanie znakami wodnymi
Czy znaki wodne rozstrzygają o autorstwie, własności lub odpowiedzialności prawnej?
Nie. Znak wodny wskazuje, że model OpenAI prawdopodobnie wygenerował lub przetworzył daną treść. Sam w sobie nie ustala, kto jest autorem treści lub ma do niej prawa, czy wymagane było ujawnienie użycia AI ani kto ponosi odpowiedzialność prawną. Nie wskazuje też, czy model edytował treść przesłaną przez użytkownika.
Czy znaki wodne wskazują zakres udziału modelu OpenAI w powstaniu treści?
Nie. Detektor informuje, czy znalazł znak wodny. Jego znalezienie wskazuje, że model OpenAI prawdopodobnie wygenerował lub przetworzył treść, ale nie pokazuje, czy wygenerował ją częściowo czy w całości ani jaki był wkład człowieka.
Jak działa oznaczanie tekstu znakami wodnymi?
Oznaczanie tekstu znakiem wodnym polega na tworzeniu tajnego wzorca w doborze słów i ich fragmentów, zwanych „tokenami”, podczas pisania przez model.
Na każdym kroku model przypisuje prawdopodobieństwo każdemu możliwemu kolejnemu tokenowi. System znakowania tworzy kilka zmodyfikowanych zestawów tych prawdopodobieństw, z których każdy faworyzuje inne wybory zgodnie z tajnym kluczem. Zestawy są zrównoważone tak, by po uśrednieniu odpowiadały pierwotnym prawdopodobieństwom modelu. Klucz określa, którego zestawu użyć, a następnie model dokonuje nowego losowego wyboru na podstawie tego zestawu.
Detektor z tym samym kluczem i zgodnymi ustawieniami może później sprawdzić, czy tekst odpowiada tajnemu wzorcowi częściej, niż wynikałoby to z przypadku.
Czy znaki wodne w tekście stosuje się do treści faktograficznych i tekstu dostarczonego przez użytkownika?
Oznaczanie tekstu znakiem wodnym wymaga, by model mógł wyrazić tę samą treść na różne sposoby. Swoboda jest mniejsza, gdy odpowiedź musi ściśle trzymać się faktów lub być bardzo precyzyjna — jak rozwiązanie zadania matematycznego — albo gdy model ma odtworzyć dostarczony tekst bez zmian. W takich przypadkach model ma mniejsze możliwości zmiany sformułowań bez wprowadzenia zauważalnej różnicy, dlatego znak wodny może nie zostać wykryty.
Czy znaki wodne w tekście stosuje się do krótkich odpowiedzi i kodu?
Krótkie fragmenty zwykle nie zawierają wystarczająco dużo tekstu, by można było wiarygodnie wykryć znak wodny. Kod również trudniej oznaczyć znakiem wodnym, ponieważ jest w nim mniej możliwych kontynuacji niż w zwykłym tekście.
Ze względu na te ograniczenia kodeks praktyk w zakresie przejrzystości treści generowanych przez AI, opracowany na potrzeby unijnego aktu w sprawie AI, nie wymaga znaków wodnych w odpowiedziach krótszych niż 200 tokenów — czyli około 150 słów w języku angielskim — ani we fragmentach kodu.
Jak wykrywanie znaków wodnych w tekście różni się w zależności od języka?
Skuteczność wykrywania zależy od języka — obecnie w niektórych językach znaki wodne są łatwiejsze do wykrycia niż w innych. Możemy dostosować siłę znaku wodnego, aby poprawić wykrywanie w językach, w których sygnał jest słabszy.
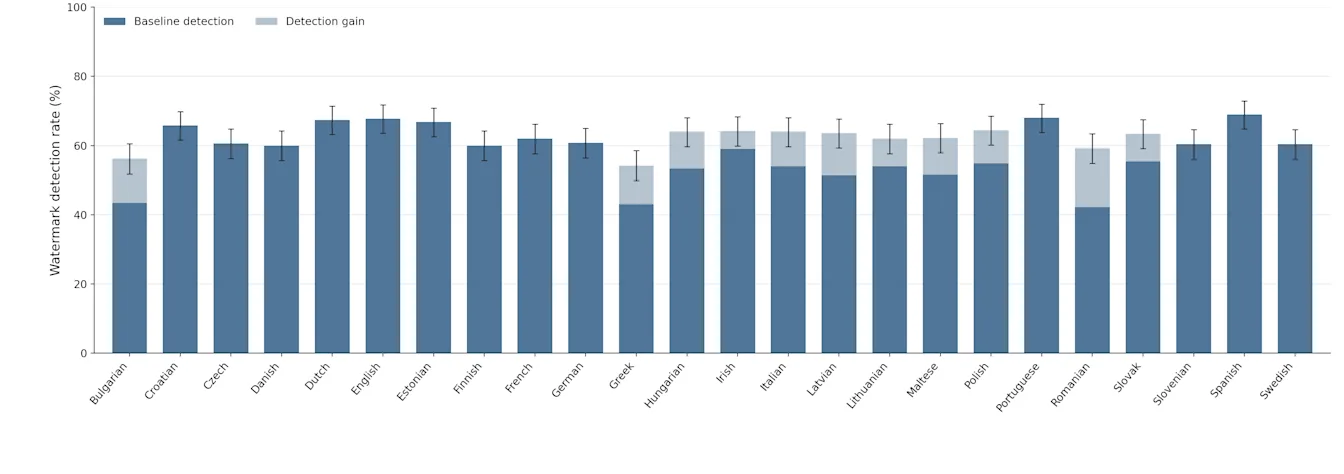
Ten wykres przedstawia skuteczność wykrywania we wszystkich 24 językach urzędowych UE. Najpierw wygenerowaliśmy 500 syntetycznych poleceń w języku angielskim obejmujących różnorodne tematy, a następnie przetłumaczyliśmy je na pozostałe 23 języki. Przy odsetku wyników fałszywie dodatnich wynoszącym 1% najwyższą skuteczność wykrywania ma język hiszpański (69,0%), a najniższą — rumuński (42,2%). Nasz znak wodny ma regulowany parametr siły — „pokrętło”, które wzmacnia lub osłabia sygnał znaku wodnego w różnych obszarach zastosowań. Dzięki temu parametrowi mogliśmy zwiększyć siłę sygnału w językach ze skutecznością wykrywania poniżej 60%; jasnoniebieskie części słupków pokazują uzyskaną poprawę.
Czy znaki wodne w tekście obniżają jakość modelu?
Nasze testy wskazują, że nie. W testach porównawczych, których używamy do oceny Astra, naszego najnowszego pionierskiego modelu, różnice w wynikach z włączonym i wyłączonym znakowaniem mieszczą się w granicach szumu, który zwykle obserwujemy między kolejnymi ocenami. Wcześniejsze testy w ChatGPT również nie wykazały zmian w odsetku ocen negatywnych ani innych wskaźnikach produktu po wprowadzeniu znaków wodnych.
Czy znaki wodne w tekście spowalniają model?
Oznaczanie tekstu znakami wodnymi ma znikomy wpływ na szybkość naszych modeli.
Czym znaki wodne OpenAI w tekście różnią się od narzędzi innych firm do wykrywania treści AI?
Narzędzia do wykrywania treści AI oferowane przez inne firmy, takie jak Pangram, zwykle używają klasyfikatorów do rozpoznawania tekstu wygenerowanego przez AI na podstawie wzorców, takich jak dobór słów. To podejście polega na analizie tekstu po jego wygenerowaniu, a nie na wykrywaniu osadzonego sygnału. Unijny akt w sprawie AI wyraźnie wymaga osadzania sygnału w generowanym tekście.
Dlaczego stosujecie własne znaki wodne w tekście zamiast TextSeal lub SynthID?
Opracowaliśmy własną metodę oznaczania tekstu znakami wodnymi, textGrain, aby mieć większą niż w przypadku SynthID lub TextSeal kontrolę nad równowagą między wykrywalnością znaku wodnego a różnorodnością odpowiedzi generowanych na to samo polecenie. W naszych testach ta metoda prawidłowo identyfikowała podobny lub większy odsetek próbek tekstu ze znakiem wodnym niż SynthID dla tekstu. Planujemy udostępnić textGrain jako technologię open source, aby inni mogli na niej bazować i pomagać w udoskonalaniu znaków wodnych w tekście.
Czy oznaczanie tekstu znakami wodnymi dodaje ukryte znaki, dodatkowe tokeny lub widoczne zmiany?
Nie. Oznaczanie tekstu znakiem wodnym zmienia statystyczny wzorzec doboru słów; nie wstawia ukrytych znaków ani nie dodaje tokenów służących wyłącznie do znakowania. Znak wodny jest niewidoczny dla czytelników, a kopiowanie i wklejanie tekstu nie wprowadza żadnych ukrytych elementów.
Wskazówki dla klientów
Korzystam z API — jak włączyć znaki wodne w tekście?
Klienci API OpenAI mogą włączyć znakowanie tekstu znakami wodnymi dla konkretnego projektu w Ustawieniach lub dla całej organizacji w Ustawieniach organizacji. W obu przypadkach klienci mogą wybrać modele, których tekst będzie oznaczany znakiem wodnym. Po włączeniu tej funkcji dla obsługiwanego modelu OpenAI dodaje znak wodny podczas generowania tekstu. Klienci nie muszą dodawać osobnego oznaczenia do każdej odpowiedzi.
Włącz opcję Zezwalaj na znaki wodne w tekście, wybierz modele, a następnie wybierz Zapisz.
Ustawienie domyślne organizacji: Przejdź do Ustawienia organizacji > Zarządzanie danymi.
Wybierz Pochodzenie tekstu.
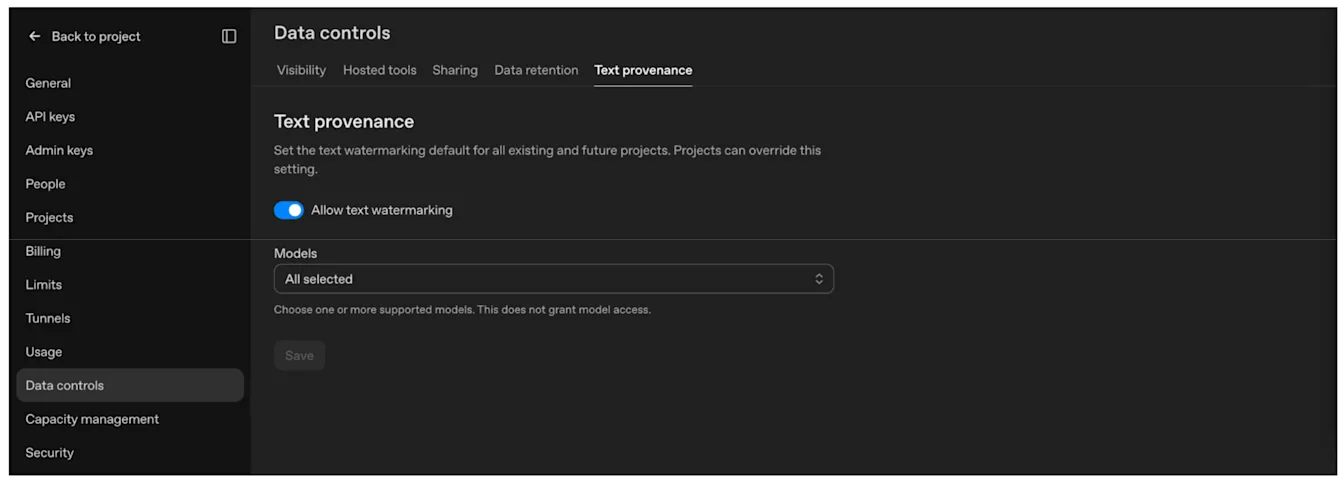
Nadpisanie ustawienia dla projektu: Przejdź do Ustawienia projektu > Pochodzenie tekstu.
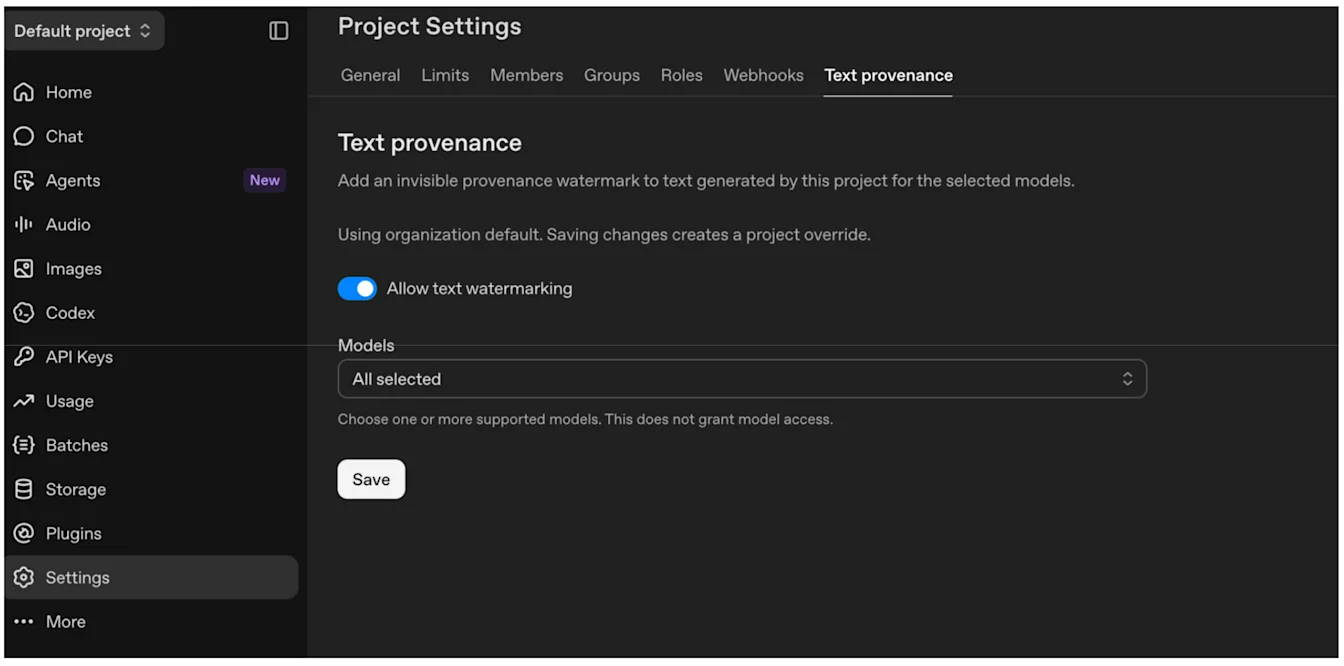
Dla których modeli mogę włączyć znaki wodne?
W Ustawieniach i Ustawieniach organizacji klienci mogą sprawdzić listę modeli, dla których obecnie dostępne jest znakowanie znakami wodnymi. W nadchodzących tygodniach rozszerzymy obsługę na wszystkie starsze modele.
Czy włączenie znaków wodnych w tekście daje też dostęp do detektora tekstu?
Nie. Dostęp do detektora tekstu mają obecnie tylko zatwierdzone instytucje badawcze i akademickie, które pracują nad zwiększeniem niezawodności i łatwości użycia znaków wodnych w tekście oraz nad jasnym wyjaśnianiem tej technologii i jej wyników. Jest to zgodne z naszymi zobowiązaniami wynikającymi z kodeksu praktyk w zakresie przejrzystości treści generowanych przez AI, opracowanego na potrzeby unijnego aktu w sprawie AI.
Czy sygnały pozostaną w treściach po ich przekształceniu?
Mogą pozostać, ale zależy to od sygnału i wprowadzonych zmian.
W przypadku obsługiwanych obrazów i nagrań dźwiękowych zachowaj oryginalną kopię i użyj API do weryfikacji pochodzenia treści, aby przetestować reprezentatywne pliki po edycji, konwersji i publikacji. W przypadku obrazów kadrowanie, dodawanie szumu, konwersja do formatu JPEG i wykonywanie zrzutów ekranu mogą utrudnić wykrywanie sygnałów. Tekst możesz testować w ten sposób tylko wtedy, gdy Twoja organizacja uzyskała dostęp do detektora tekstu.
Jeśli pozwalają na to format pliku i stosowany proces, zachowaj istniejące metadane C2PA i dołączaj Content Credentials do tworzonych plików. Możesz też rozważyć dodanie własnych oznaczeń, aby informacje o pochodzeniu były trwalsze lub bardziej użyteczne. Szczegóły wdrożenia znajdziesz w dokumentacji technicznej C2PA.
W przypadku tekstu znak wodny jest zakodowany w doborze słów przez model. Jeśli zachowasz brzmienie tekstu, sygnał powinien pozostać przy jego ponownym wykorzystaniu, bez dodatkowych prac integracyjnych. Znaczne przeredagowanie, parafrazowanie lub tłumaczenie tekstu może zmniejszyć wiarygodność wykrywania. Nawet niezmienione brzmienie nie gwarantuje wykrywalności znaku wodnego, zwłaszcza w krótkich fragmentach lub tekstach, które pozostawiają niewielką swobodę doboru słów.
Korzystam z modeli OpenAI za pośrednictwem usługi w chmurze. Czy te wyniki również zawierają sygnały pochodzenia?
Współpracujemy ze wszystkimi naszymi dostawcami usług chmurowych i partnerami dystrybucyjnymi, aby sygnały pochodzenia, w tym znaki wodne, były osadzane we wszystkich kwalifikujących się wynikach, w tym obrazach, nagraniach dźwiękowych i tekstach. Dostępność może się różnić w zależności od wyniku i partnera.
Czy sygnały pochodzenia zastępują widoczne oznaczenia AI lub inne informacje o jej użyciu?
Nie. Znaki wodne i metadane C2PA dostarczają informacji, które może odczytać oprogramowanie. Nie zastępują widocznych etykiet, banerów ani innych powiadomień, które mogą być wymagane.
To, czy potrzebujesz dodatkowej informacji o użyciu AI, zależy od tego, jak i gdzie wykorzystujesz treść. OpenAI nie może doradzać w kwestii Twoich konkretnych obowiązków prawnych; ocenę wymagań dotyczących danego zastosowania należy powierzyć zespołowi prawnemu.
Mam więcej pytań dotyczących unijnego aktu w sprawie AI
Prześlij zapytanie dotyczące unijnego aktu w sprawie AI, a skontaktujemy się z Tobą.