
Ca parte a angajamentului său față de un ecosistem IA mai sigur și mai transparent, OpenAI folosește semnale de proveniență pentru a ajuta oamenii să înțeleagă dacă un conținut a fost generat cu un model OpenAI.
Semnalele de proveniență pot oferi informații utile despre origine, dar nu garantează că un conținut este corect, needitat, deținut în mod legal sau prezentat în contextul corect.
Semnalele de proveniență OpenAI
Ce semnale de proveniență folosește OpenAI?
OpenAI folosește semnale de proveniență diferite pentru diverse tipuri de conținut.
| Tip de conținut | Semnale de proveniență | Note |
|---|---|---|
| Imagini | Content Credentials și filigrane SynthID | Imaginile generate cu ChatGPT, Codex sau API-ul OpenAI includ ambele semnale. |
| Audio | Filigrane SynthID | Conținutul audio generat de ChatGPT sau de API-ul OpenAI include un filigran inaudibil încorporat în conținutul audio propriu-zis. |
| Text | Filigrane textGrain (doar în UE) | În UE, textul generat de ChatGPT include o modificare invizibilă a mecanismului aleatoriu folosit de model pentru alegerea cuvintelor, pentru a respecta Regulamentul UE privind IA. Clienții API din întreaga lume pot activa filigranele pentru textul generat din setările proiectului sau ale organizației. |
| Video | Content Credentials | Sora nu mai este disponibil. Află mai multe. |
Disponibilitatea semnalelor poate varia în funcție de produs, model, metoda de export, tipul de fișier și momentul creării conținutului. Semnalele sunt incluse în conținutul generat prin API, cu excepția modelelor care urmează să fie retrase în curând, inclusiv gpt-image-1, gpt-image-1.5 și sora-2.
De ce se folosesc mai multe semnale pentru unele tipuri de conținut?
Atunci când este posibil din punct de vedere tehnic, OpenAI combină metadatele și filigranele, astfel încât fiecare metodă să poată compensa limitările celeilalte. Metadatele pot conține informații detaliate, dar platformele, instrumentele de editare și conversiile de fișiere le pot elimina. Filigranele oferă mai puțin context, dar, fiind încorporate în conținutul generat propriu-zis, pot rezista unor transformări care elimină metadatele.
Cât de bine rezistă semnalele de proveniență la modificarea conținutului?
Filigranele SynthID pentru imagini și conținut audio și filigranele textGrain pentru text sunt concepute să reziste la modificări obișnuite. În funcție de tipul de conținut, acestea pot include editări minore, copiere și lipire, decupare sau capturi de ecran. Modificările mai ample — cum ar fi decuparea substanțială a imaginilor, comprimarea fișierelor, parafrazarea substanțială sau traducerea — pot face un filigran nedetectabil. După modificări ample, descrierea rezultatului drept „generat de OpenAI” poate fi, de asemenea, mai puțin relevantă.
Content Credentials, dezvoltate de Coaliția pentru Proveniența și Autenticitatea Conținutului, se pot pierde prin acțiuni uzuale, cum ar fi realizarea unei capturi de ecran sau conversia unui fișier. Când rămân disponibile, acestea pot oferi mai multe detalii despre originea și istoricul unui fișier decât un filigran singur.
Atunci când este posibil din punct de vedere tehnic, folosim ambele metode pentru a crește șansele ca informațiile despre proveniență să se păstreze după modificarea conținutului.
Ce sunt Content Credentials și ce permit?
Content Credentials atașează informații despre originea și istoricul unui fișier, cum ar fi instrumentul cu care a fost creat și momentul creării. Acestea folosesc un standard deschis dezvoltat de Coaliția pentru Proveniența și Autenticitatea Conținutului (C2PA), motiv pentru care sunt uneori numite „metadate C2PA”.
Content Credentials ajută oamenii să verifice de unde provine conținutul. Utilizarea lor nu se limitează la conținutul generat de IA: producătorii de camere foto, organizațiile de presă și alții folosesc, de asemenea, standardul pentru a certifica sursa și istoricul materialelor lor media. Află mai multe despre C2PA.
Ce este SynthID și ce permite?
SynthID este o tehnologie de aplicare a filigranelor invizibile, dezvoltată de Google DeepMind, care încorporează un semnal direct în conținutul media generat. Spre deosebire de metadate, semnalul face parte din conținutul propriu-zis și poate persista după unele editări sau transformări. SynthID oferă un semnal suplimentar de proveniență, alături de metadatele C2PA. De exemplu, dacă metadatele sunt eliminate dintr-un fișier, un filigran încorporat poate indica în continuare că acel conținut a fost generat cu instrumente OpenAI compatibile. Află mai multe despre SynthID.
De ce aplicați filigrane în textele generate?
Implementăm aplicarea filigranelor în text pentru utilizatorii ChatGPT din UE, pentru a respecta Regulamentul UE privind IA și în conformitate cu angajamentele noastre în cadrul Codului de bune practici al UE privind transparența conținutului generat de IA, pe care OpenAI l-a semnat alături de alți furnizori majori de IA.
Ce este textGrain și ce permite?
textGrain este tehnologia OpenAI de aplicare a filigranelor în text. Aceasta ajustează subtil modul în care modelul alege aleatoriu între posibile cuvinte sau fragmente de cuvinte în timpul scrierii. La nivelul unui pasaj, aceste alegeri creează un tipar pe care un detector îl poate căuta, chiar și după unele modificări.
Filigranul face parte din formularea propriu-zisă și nu este vizibil pentru cititori. Nu adaugă caractere ascunse, spații invizibile sau semne de punctuație neobișnuite. Aplicarea filigranelor în text contribuie la respectarea cerinței din Regulamentul UE privind IA de a marca textul generat.
Instrumentele de verificare OpenAI
Cum pot verifica dacă un conținut a fost generat cu instrumentele OpenAI?
Poți accesa openai.com/verify pentru a verifica dacă o imagine sau un fișier audio compatibil conține semnale de proveniență asociate conținutului generat sau exportat de instrumentele OpenAI. După ce încarci un fișier compatibil, instrumentul va căuta semnale de proveniență OpenAI acceptate, precum un filigran SynthID sau un manifest C2PA de încredere asociat cu OpenAI. Dacă instrumentul găsește un semnal de proveniență OpenAI acceptat, acesta indică faptul că acel conținut a fost probabil generat de un model OpenAI.
Dezvoltatorii și organizațiile pot folosi și API-ul OpenAI pentru proveniența conținutului pentru a căuta semnale de proveniență OpenAI în imagini și fișiere audio și pentru a integra verificarea în propriile aplicații sau fluxuri de lucru. Organizațiile cu un caz de utilizare eligibil pot solicita limite mai mari.
În cazul textului, în conformitate cu obligațiile noastre în temeiul Regulamentului UE privind IA, organizațiile cu un caz de utilizare eligibil, precum organizațiile academice și de cercetare care studiază proveniența textului, fiabilitatea detectării sau modul în care oamenii înțeleg rezultatele verificării provenienței, pot solicita acces la detectorul de text. Vom analiza individual cererile organizațiilor eligibile și vom reveni, după caz, cu noutăți sau solicitări de informații suplimentare. Abordarea noastră privind accesul poate evolua pe măsură ce aflăm mai multe și îmbunătățim tehnologia.
În prezent, colaborăm cu un grup restrâns de cercetători, printre care John Thickstun, profesor asistent de informatică la Universitatea Cornell, Martin Vechev, profesor de informatică la ETH Zurich și director științific al INSAIT, și cercetători de la Institutul Kempelen pentru Tehnologii Inteligente (KInIT), pentru a înțelege mai bine capacitățile și limitările tehnologiei și a orienta îmbunătățirile aduse filigranelor pentru text.
Cine este eligibil pentru limite de verificare mai mari și sunt verificările contra cost?
Verificările prin API-ul pentru proveniența conținutului sunt gratuite în prezent și sunt supuse unor limite de utilizare. Programul pentru limite mai mari vizează proiecte eligibile de interes public privind proveniența și fluxuri de lucru pentru integritatea informațiilor, cum ar fi verificările în redacții, verificarea faptelor, cercetarea provenienței conținutului și supravegherea de către autoritățile de reglementare.
Utilizările comerciale generale nu sunt incluse în prezent în program, de exemplu prevenirea fraudei, autentificarea și verificarea în scopuri comerciale sau revânzarea ca parte a unor pachete de servicii de verificare a provenienței și de analiză a datelor.
Organizațiile cu un caz de utilizare eligibil pot solicita limite mai mari, dar trimiterea unei cereri nu garantează aprobarea. API-ul public rămâne disponibil în limitele sale implicite, inclusiv pentru evaluări la scară mai mică. Consultă documentația API-ului pentru proveniența conținutului pentru limitele de utilizare actuale.
Cine este eligibil pentru acces la detectorul de text și sunt verificările contra cost?
Verificările cu detectorul de text sunt gratuite în prezent. Cazurile de utilizare eligibile includ organizațiile academice și de cercetare care studiază proveniența textului, fiabilitatea detectării sau modul în care oamenii înțeleg rezultatele verificării provenienței.
Utilizările comerciale generale nu sunt incluse în prezent în program, de exemplu prevenirea fraudei, autentificarea și verificarea în scopuri comerciale sau revânzarea ca parte a unor pachete de servicii de verificare a provenienței și de analiză a datelor.
Nici utilizările legate de integritatea academică, precum verificarea lucrărilor studenților pentru a detecta folosirea IA (de exemplu, la redactarea eseurilor sau a tezelor), nu sunt incluse în prezent în program.
Ce înseamnă rezultatele verificării?
Dacă este detectat un semnal prin openai.com/verify sau prin API-ul OpenAI pentru proveniența conținutului, înseamnă că acel conținut încărcat conține un semnal de proveniență acceptat, asociat cu OpenAI. Instrumentul nu confirmă că acel conținut este corect, needitat, deținut în mod legal sau prezentat în contextul corect. De asemenea, nu identifică cine a creat conținutul sau de ce a fost creat.
Dacă nu este detectat niciun semnal, înseamnă că instrumentul nu a găsit semnale de proveniență emise de OpenAI în fișierul încărcat. Conținutul ar putea totuși să fi fost generat sau exportat de OpenAI dacă:
Conținutul a fost creat înainte ca semnalele de proveniență să fie disponibile.
Conținutul provine dintr-un produs, model, metodă de export sau tip de fișier neacceptat.
Metadatele au fost eliminate în timpul încărcării, descărcării, editării, conversiei sau distribuirii.
Un filigran a fost degradat prin compresie, decupare, zgomot, editări, conversia formatului sau alte transformări.
Un clip audio este prea scurt sau a fost modificat semnificativ.
Cum pot obține un rezultat al verificării cât mai fiabil?
Încarcă pe rând câte un fișier acceptat și, când este posibil, folosește fișierul original exportat. În cazul imaginilor, evită decuparea sau conversia fișierului înainte de verificare. În cazul conținutului audio, fragmentele cu o durată între 10 și 60 de secunde oferă, în general, cele mai bune rezultate. Chiar dacă nu este detectat niciun semnal, ia în considerare sursa și contextul fișierului înainte de a trage o concluzie.
Rezultatele afișează solicitarea mea sau informații personale?
Semnalele de proveniență nu includ detalii despre utilizator, organizație sau solicitare.
Ce se întâmplă cu conținutul pe care îl verific folosind openai.com/verify sau API-ul pentru proveniența conținutului?
Conținutul încărcat pe openai.com/verify sau trimis spre verificare prin API-ul nostru pentru proveniența conținutului este prelucrat exclusiv pentru a căuta semnale de proveniență acceptate. Conținutul nu este stocat decât dacă legea impune acest lucru și nu este folosit pentru antrenarea modelelor OpenAI.
Poate OpenAI să detecteze conținut generat cu alte instrumente IA?
Instrumentele noastre pentru proveniența conținutului sunt concepute să detecteze semnale de proveniență compatibile, asociate conținutului generat de modele OpenAI sau exportat de instrumente OpenAI. Acestea nu sunt concepute să detecteze conținut generat de alte modele IA și este posibil să nu detecteze nici conținutul generat de OpenAI dacă semnalul relevant lipsește, nu este compatibil sau este degradat.
Cum funcționează aplicarea filigranelor
Filigranele stabilesc cine este autorul, cine deține drepturile de proprietate sau cui îi revine răspunderea juridică?
Nu. Un filigran este un indiciu că un model OpenAI a generat sau a procesat probabil conținutul. În sine, acesta nu stabilește cine a creat conținutul sau cine deține drepturile asupra lui, dacă era obligatorie o informare ori cui îi revine răspunderea juridică. De asemenea, nu îți spune dacă modelul edita conținut încărcat de un utilizator.
Filigranele indică în ce măsură a fost implicat un model OpenAI?
Nu. Detectorul raportează dacă a găsit un filigran. Găsirea unui filigran este un indiciu că un model OpenAI a generat sau a procesat probabil conținutul, dar nu arată dacă modelul l-a generat parțial sau integral ori cât a contribuit o persoană.
Cum funcționează aplicarea filigranelor în text?
Aplicarea filigranelor în text creează un tipar secret în alegerile de cuvinte și fragmente de cuvinte, numite „tokenuri”, pe care le face modelul în timpul scrierii.
La fiecare pas, modelul atribuie o probabilitate fiecărui token care ar putea urma. Sistemul de aplicare a filigranelor creează mai multe seturi ajustate ale acestor probabilități, fiecare favorizând opțiuni diferite în funcție de o cheie secretă. Seturile sunt echilibrate astfel încât media lor să corespundă probabilităților inițiale ale modelului. Cheia selectează setul de utilizat, iar modelul face apoi o nouă alegere aleatorie din acel set.
Un detector cu aceeași cheie și cu setări corespunzătoare poate verifica ulterior dacă textul urmează tiparul secret mai des decât ar fi de așteptat din întâmplare.
Filigranele text se aplică și textelor factuale și celor furnizate de utilizatori?
Aplicarea filigranelor în text depinde de posibilitatea modelului de a exprima același lucru în moduri diferite. Flexibilitatea este mai mică atunci când un răspuns trebuie să fie strict factual sau foarte precis, cum ar fi răspunsul la o problemă de matematică, ori când i se cere modelului să reproducă textul furnizat fără să îl modifice. În aceste cazuri, modelul are mai puține posibilități de a schimba formularea fără o diferență sesizabilă, așa că filigranul poate să nu fie detectat.
Filigranele text se aplică și răspunsurilor scurte și codului?
Pasajele scurte nu conțin, de obicei, suficient text pentru detectarea fiabilă a filigranului. Filigranele sunt mai greu de aplicat și în cod, deoarece există mai puține opțiuni plauzibile pentru ceea ce urmează decât într-un text obișnuit.
Pentru a ține cont de aceste limitări, Codul de bune practici privind transparența conținutului generat de IA, aferent Regulamentului UE privind IA, nu impune filigrane în rezultatele mai scurte de 200 de tokenuri — aproximativ 150 de cuvinte în engleză — sau în fragmentele de cod.
Cum variază detectarea filigranelor text în funcție de limbă?
Ratele de detectare variază în funcție de limbă, iar în prezent filigranele sunt mai ușor de detectat în unele limbi decât în altele. Putem ajusta intensitatea filigranului pentru a îmbunătăți detectarea în limbile în care semnalul este mai slab.
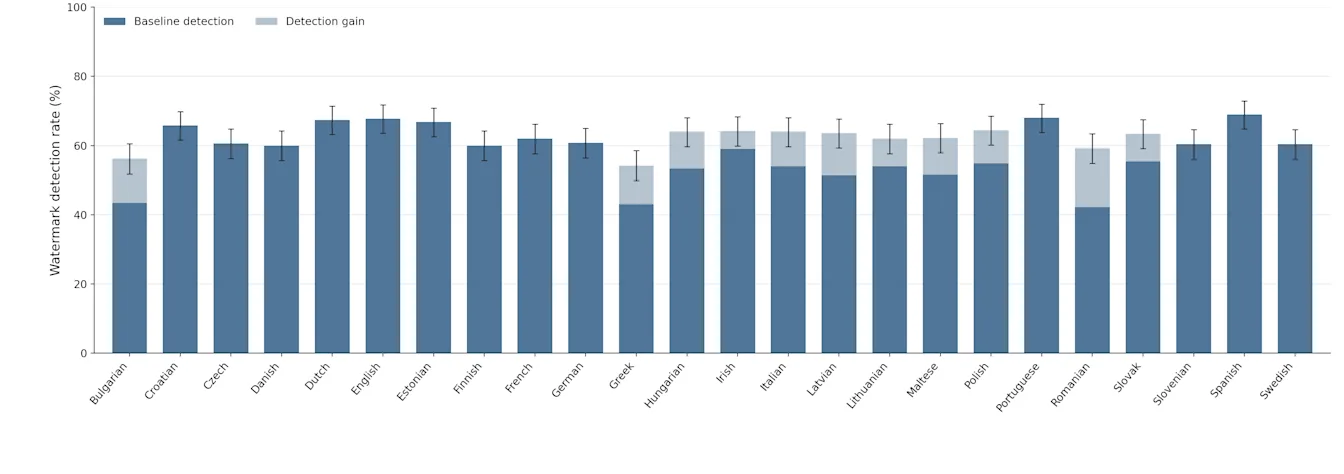
Acest grafic evaluează rata de detectare în toate cele 24 de limbi oficiale ale UE. Mai întâi, am generat 500 de solicitări sintetice în engleză, pe teme diverse, apoi le-am tradus în celelalte 23 de limbi. La o rată de rezultate fals pozitive de 1%, spaniola are cea mai mare rată de detectare (69,0%), iar româna, cea mai mică (42,2%). Filigranul nostru are un parametru de intensitate reglabil — un „buton de reglaj” care amplifică sau atenuează semnalul filigranului pentru diferite domenii. Cu ajutorul acestui reglaj, am putut crește intensitatea pentru limbile cu rate de detectare sub 60%; porțiunile albastru-deschis ale barelor arată îmbunătățirile obținute.
Filigranele text reduc calitatea modelului?
Conform testelor noastre, nu. În testele de referință pe care le folosim pentru a evalua Astra, cel mai recent model de vârf al nostru, diferențele de performanță cu și fără filigrane se încadrează în variațiile aleatorii pe care le observăm de obicei de la o rundă de evaluare la alta. Testele anterioare în ChatGPT nu au arătat nici ele modificări ale ratei de evaluări negative sau ale altor indicatori ai produsului ca urmare a introducerii filigranelor.
Filigranele text reduc viteza modelului?
Aplicarea filigranelor în text are un impact neglijabil asupra vitezei modelelor noastre.
Prin ce diferă filigranele OpenAI pentru text de instrumentele terțe de detectare a conținutului generat de IA?
Instrumentele terțe de detectare, precum Pangram, folosesc de obicei clasificatori pentru a identifica textul generat de IA pe baza unor tipare, cum ar fi alegerea cuvintelor. Această abordare analizează textul după generare, în loc să detecteze un semnal încorporat. Regulamentul UE privind IA impune în mod explicit încorporarea unui semnal în textul generat.
De ce folosiți propriile filigrane text în loc de TextSeal sau SynthID?
Am dezvoltat propria metodă de aplicare a filigranelor în text, numită textGrain, pentru a avea mai mult control decât ne oferă SynthID sau TextSeal asupra echilibrului dintre detectabilitatea filigranului și varietatea răspunsurilor generate la aceeași solicitare. În testele noastre, metoda noastră a identificat corect o proporție similară sau mai mare de mostre de text cu filigran decât SynthID pentru text. Intenționăm să lansăm textGrain ca tehnologie cu sursă deschisă, astfel încât și alții să poată dezvolta soluții pe baza ei și să contribuie la îmbunătățirea aplicării filigranelor în text.
Aplicarea filigranelor în text adaugă caractere ascunse, tokenuri suplimentare sau modificări vizibile?
Nu. Aplicarea filigranelor în text schimbă tiparul statistic al alegerilor de cuvinte; nu inserează caractere ascunse și nu adaugă tokenuri folosite exclusiv pentru filigran. Filigranul nu este vizibil pentru cititori, iar copierea și lipirea textului nu introduc conținut ascuns.
Îndrumări pentru clienți
Sunt client API. Cum activez filigranele pentru text?
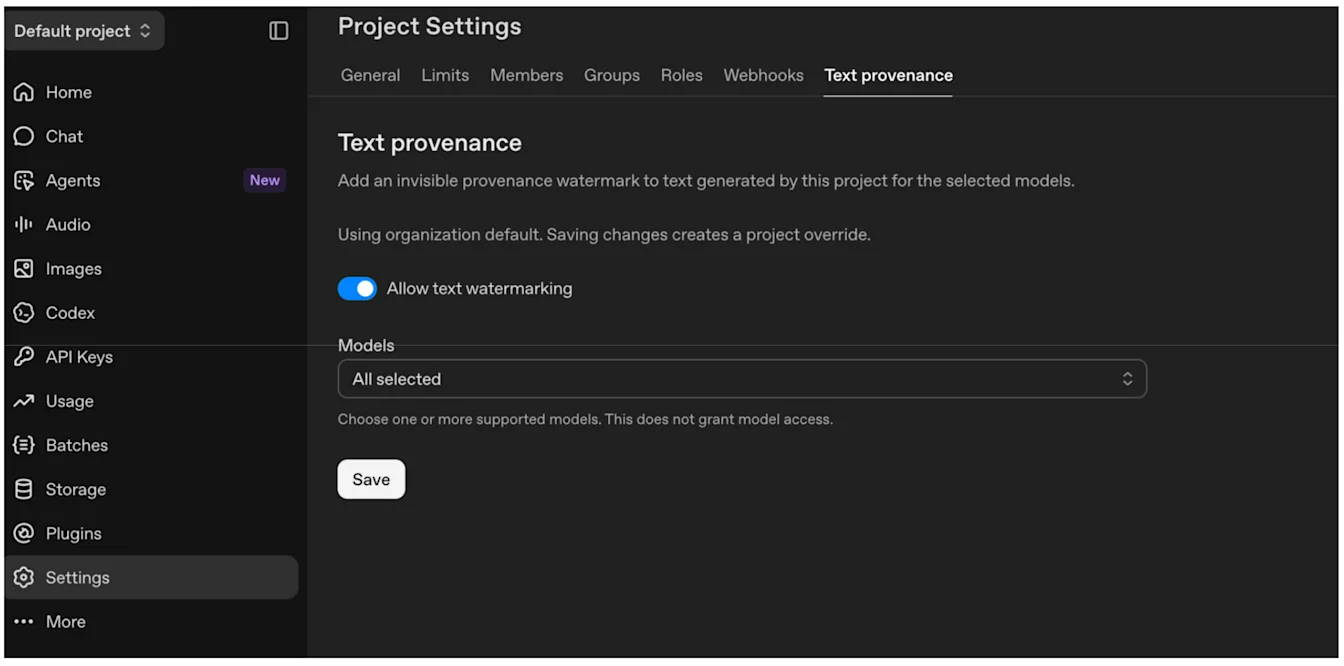
Clienții API-ului OpenAI pot activa filigranele pentru text la nivelul unui anumit proiect din Setări sau la nivelul întregii organizații din Setările organizației. În fiecare caz, clienții pot selecta modelele pentru care se adaugă un filigran în text. Odată activată opțiunea pentru un model compatibil, OpenAI adaugă filigranul în timpul generării textului. Clienții nu trebuie să adauge un marcaj separat la fiecare răspuns.
Activează Permite adăugarea de filigrane în text, selectează modelele, apoi selectează Salvează.
Setare implicită pentru organizație: Accesează Setările organizației > Opțiuni de control al datelor.
Selectează Proveniența textului.
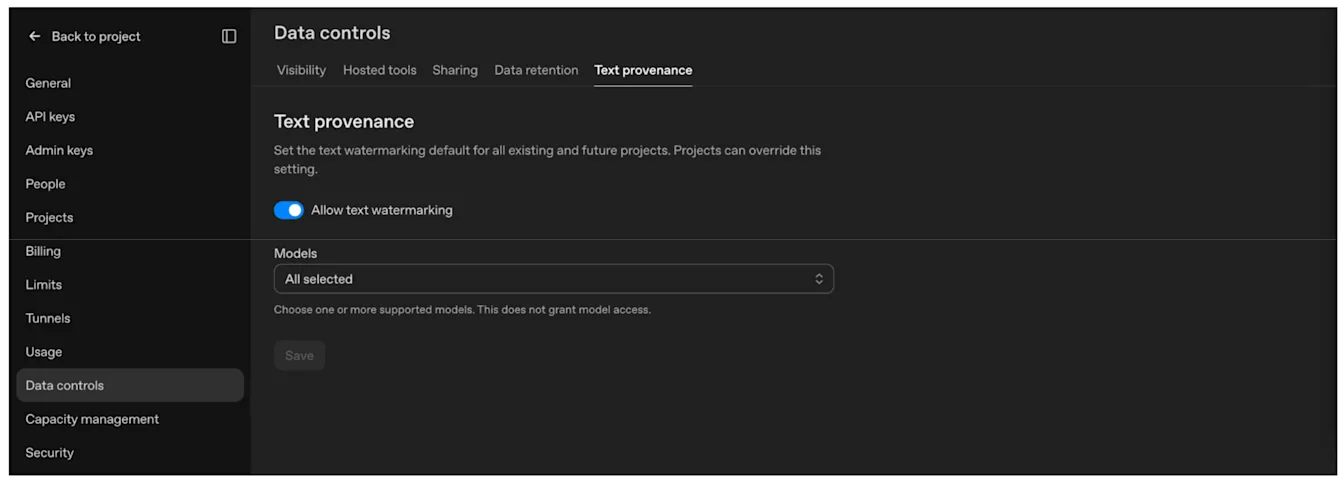
Înlocuirea setării la nivel de proiect: Accesează Setările proiectului > Proveniența textului.
Pentru ce modele pot activa filigranele?
În Setări și Setările organizației, clienții pot vedea lista modelelor pentru care sunt disponibile în prezent filigrane. În următoarele săptămâni, vom extinde disponibilitatea la toate modelele mai vechi.
Activarea filigranelor text îmi oferă și acces la detectorul de text?
Nu. Accesul la detectorul de text este limitat în prezent la organizațiile de cercetare și academice aprobate, care lucrează la îmbunătățirea fiabilității filigranelor text, a ușurinței de utilizare și a clarității cu care pot fi explicate tehnologia și rezultatele sale. Acest lucru este în concordanță cu angajamentele noastre în cadrul Codului de bune practici privind transparența conținutului generat de IA, aferent Regulamentului UE privind IA.
Semnalele vor rămâne atașate conținutului după ce îl transform?
Este posibil, dar depinde de semnal și de modificările pe care le faci.
Pentru imaginile și fișierele audio compatibile, păstrează o copie originală și folosește API-ul pentru proveniența conținutului pentru a testa fișiere reprezentative după editare, conversie și publicare. În cazul imaginilor, decuparea, adăugarea de zgomot, conversia în JPEG și realizarea de capturi de ecran pot îngreuna detectarea semnalelor. Poți testa textul în acest mod doar dacă organizația ta are acces aprobat la detectorul de text.
Dacă formatul fișierului și fluxul de lucru permit acest lucru, păstrează metadatele C2PA existente și include Content Credentials în fișierele pe care le produci. Poți lua în considerare și adăugarea propriilor marcaje pentru ca informațiile despre proveniență să se păstreze mai bine sau să fie mai utile. Consultă documentația tehnică C2PA pentru detalii despre implementare.
În cazul textului, filigranul este integrat în modul în care modelul alege cuvintele. Dacă păstrezi formularea, este de așteptat ca semnalul să rămână atunci când reutilizezi textul, fără eforturi suplimentare de integrare. Rescrierea substanțială, parafrazarea sau traducerea pot reduce fiabilitatea detectării. Nici păstrarea neschimbată a formulării nu garantează că filigranul poate fi detectat, mai ales în pasaje scurte sau în texte care permit puține alternative în alegerea cuvintelor.
Accesez modelele OpenAI printr-un serviciu cloud. Conținutul generat astfel conține și el semnale de proveniență?
Colaborăm cu toți furnizorii noștri de servicii cloud și de distribuție pentru a ne asigura că semnalele de proveniență, inclusiv filigranele, sunt încorporate în tot conținutul generat eligibil, inclusiv în imagini, conținut audio și text. Disponibilitatea poate varia în funcție de conținutul generat și de partener.
Semnalele de proveniență înlocuiesc etichetele vizibile privind IA sau alte informări?
Nu. Filigranele și metadatele C2PA oferă informații care pot fi citite de software. Acestea nu înlocuiesc etichetele vizibile, bannerele sau alte notificări care pot fi obligatorii.
Necesitatea unei informări suplimentare depinde de modul și de locul în care folosești conținutul. OpenAI nu îți poate oferi consultanță privind obligațiile tale legale specifice; echipa ta juridică ar trebui să evalueze cerințele aplicabile modului în care folosești conținutul.
Am mai multe întrebări despre Regulamentul UE privind IA
Trimite o solicitare de informații despre Regulamentul UE privind IA și îți vom răspunde.