
V rámci záväzku budovať bezpečnejší a transparentnejší ekosystém AI používa OpenAI signály pôvodu, ktoré ľuďom pomáhajú zistiť, či bol obsah vygenerovaný modelom OpenAI.
Signály pôvodu môžu poskytnúť užitočné informácie o pôvode, no nezaručujú, že obsah je presný, neupravený, zákonne vlastnený alebo prezentovaný v správnom kontexte.
Signály pôvodu OpenAI
Aké signály pôvodu používa OpenAI?
OpenAI používa pre rôzne typy obsahu rôzne signály pôvodu.
| Typ obsahu | Signály pôvodu | Poznámky |
|---|---|---|
| Obrázky | Content Credentials a vodoznaky SynthID | Obrázky vygenerované pomocou ChatGPT, Codex alebo API OpenAI obsahujú oba signály. |
| Zvuk | Vodoznaky SynthID | Zvuk vygenerovaný pomocou ChatGPT alebo API OpenAI obsahuje nepočuteľný vodoznak vložený priamo do zvuku. |
| Text | Vodoznaky textGrain (iba v EÚ) | V EÚ obsahuje text vygenerovaný pomocou ChatGPT neviditeľnú úpravu náhodnosti, ktorú model využíva pri výbere slov, aby spĺňal požiadavky aktu EÚ o umelej inteligencii. Zákazníci API na celom svete si môžu v nastaveniach projektu alebo organizácie zapnúť vodoznaky pre textové výstupy. |
| Video | Content Credentials | Prevádzka služby Sora bola ukončená. Ďalšie informácie. |
Rozsah podpory sa môže líšiť podľa produktu, modelu, spôsobu exportu, typu súboru a času vytvorenia obsahu. Podpora zahŕňa výstupy API s výnimkou modelov, ktorých podpora sa má čoskoro ukončiť, vrátane gpt-image-1, gpt-image-1.5 a sora-2.
Prečo niektoré typy obsahu využívajú viacero signálov?
Ak je to technicky možné, OpenAI kombinuje metadáta a vodoznaky, aby navzájom kompenzovali svoje obmedzenia. Metadáta môžu obsahovať podrobné informácie, no platformy, nástroje na úpravu a konverzie súborov ich môžu odstrániť. Vodoznaky poskytujú menej kontextu, ale keďže sú vložené priamo do generovaného obsahu, môžu sa zachovať aj po niektorých úpravách, ktoré odstránia metadáta.
Nakoľko sú signály pôvodu odolné voči úpravám obsahu?
Vodoznaky SynthID pre obrázky a zvuk a vodoznaky textGrain pre text sú navrhnuté tak, aby odolali bežným zmenám. V závislosti od typu obsahu môže ísť o menšie úpravy, kopírovanie a vkladanie, orezanie alebo vytváranie snímok obrazovky. Rozsiahlejšie zmeny – napríklad výrazné orezanie obrázka, kompresia súboru, zásadné parafrázovanie alebo preklad – môžu spôsobiť, že vodoznak už nebude možné detegovať. Po rozsiahlych zmenách môže byť aj označenie výsledku ako „vygenerovaného pomocou OpenAI“ menej výstižné.
Content Credentials, ktoré vyvinula Koalícia pre pôvod a autenticitu obsahu, sa môžu stratiť pri bežných činnostiach, napríklad pri vytvorení snímky obrazovky alebo konverzii súboru. Ak sa zachovajú, môžu poskytnúť viac podrobností o pôvode a histórii súboru než samotný vodoznak.
Tam, kde je to technicky možné, používame obe metódy, aby sa zvýšila pravdepodobnosť zachovania informácií o pôvode aj po zmenách obsahu.
Čo sú Content Credentials a čo umožňujú?
Content Credentials pripájajú k súboru informácie o jeho pôvode a histórii, napríklad ktorý nástroj ho vytvoril a kedy. Využívajú otvorený štandard, ktorý vyvinula Koalícia pre pôvod a autenticitu obsahu (C2PA), preto sa niekedy nazývajú aj „metadáta C2PA“.
Content Credentials pomáhajú ľuďom overiť, odkiaľ obsah pochádza. Nepoužívajú sa len pri obsahu generovanom AI: výrobcovia fotoaparátov, spravodajské organizácie a ďalšie subjekty používajú tento štandard aj na potvrdenie zdroja a histórie svojich médií. Viac informácií o C2PA.
Čo je SynthID a čo umožňuje?
SynthID je technológia neviditeľného označovania vodoznakom vyvinutá spoločnosťou Google DeepMind, ktorá vkladá signál priamo do generovaných médií. Na rozdiel od metadát je signál súčasťou samotného obsahu a môže sa zachovať aj po niektorých úpravách alebo transformáciách. SynthID poskytuje popri metadátach C2PA ďalší signál pôvodu. Ak sa napríklad zo súboru odstránia metadáta, vložený vodoznak môže naďalej signalizovať, že obsah bol vygenerovaný pomocou podporovaných nástrojov OpenAI. Viac informácií o SynthID.
Prečo označujete textové výstupy vodoznakom?
Pre používateľov ChatGPT v EÚ zavádzame označovanie textu vodoznakom, aby sme splnili požiadavky aktu EÚ o umelej inteligencii a naše záväzky podľa Kódexu postupov EÚ v oblasti transparentnosti obsahu generovaného AI, ktorý spoločnosť OpenAI podpísala spolu s niekoľkými ďalšími významnými poskytovateľmi AI.
Čo je textGrain a čo umožňuje?
textGrain je technológia spoločnosti OpenAI na označovanie textu vodoznakom. Jemne upravuje spôsob, akým model pri písaní náhodne vyberá z možných slov alebo častí slov. Tieto voľby vytvárajú v pasáži vzor, ktorý môže detektor vyhľadať aj po určitých úpravách.
Vodoznak je súčasťou samotného znenia a čitatelia ho nevidia. Nepridáva skryté znaky, neviditeľné medzery ani nezvyčajnú interpunkciu. Označovanie textu vodoznakom pomáha plniť požiadavku aktu EÚ o umelej inteligencii na označovanie generovaného textu.
Overovacie nástroje OpenAI
Ako môžem overiť, či bol obsah vygenerovaný nástrojmi OpenAI?
Na stránke openai.com/verify môžete overiť, či podporovaný obrazový alebo zvukový súbor obsahuje signály pôvodu spojené s obsahom vygenerovaným alebo exportovaným nástrojmi OpenAI. Po nahratí podporovaného súboru v ňom nástroj vyhľadá podporované signály pôvodu OpenAI, napríklad vodoznak SynthID alebo dôveryhodný manifest C2PA spojený s OpenAI. Ak nástroj nájde podporovaný signál pôvodu OpenAI, znamená to, že obsah pravdepodobne vygeneroval model OpenAI.
Vývojári a organizácie môžu tiež používať Content Provenance API od OpenAI na vyhľadávanie signálov pôvodu OpenAI v obrázkoch a zvuku a začleniť overovanie do vlastných aplikácií alebo pracovných postupov. Organizácie, ktorých prípad použitia spĺňa podmienky, môžu požiadať o zvýšenie limitov.
V súlade s našimi povinnosťami podľa aktu EÚ o umelej inteligencii môžu organizácie, ktorých prípad použitia spĺňa podmienky, požiadať o prístup k detektoru textu. Patria sem napríklad akademické a výskumné organizácie skúmajúce pôvod textu, spoľahlivosť detekcie alebo to, ako ľudia chápu výsledky overovania pôvodu. Žiadosti oprávnených organizácií posúdime individuálne a podľa potreby ich budeme kontaktovať s novými informáciami alebo so žiadosťou o doplnenie údajov. Náš prístup k udeľovaniu prístupu sa môže meniť s pribúdajúcimi poznatkami a zdokonaľovaním technológie.
V súčasnosti spolupracujeme s obmedzeným okruhom výskumníkov vrátane Johna Thickstuna, odborného asistenta informatiky na Cornellovej univerzite, Martina Vecheva, profesora informatiky na ETH v Zürichu a vedeckého riaditeľa INSAIT, a výskumníkov z Kempelenovho inštitútu inteligentných technológií (KInIT), aby sme lepšie pochopili možnosti a obmedzenia tejto technológie a získali podklady na zlepšovanie vodoznakov v texte.
Kto má nárok na vyššie limity overovania a sú kontroly spoplatnené?
Kontroly cez rozhranie Content Provenance API sú v súčasnosti bezplatné a podliehajú limitom používania. Program vyšších limitov sa zameriava na projekty overovania pôvodu vo verejnom záujme a pracovné postupy na zabezpečenie integrity informácií, ktoré spĺňajú podmienky, napríklad overovanie v redakciách, overovanie faktov, výskum pôvodu obsahu a regulačný dohľad.
Bežné komerčné využitie je v súčasnosti mimo rozsahu programu. Patrí sem napríklad komerčná prevencia podvodov, autentifikácia a overovanie alebo ďalší predaj v rámci balíkov služieb na overovanie pôvodu a analýzu údajov.
Organizácie so spôsobom použitia, ktorý spĺňa podmienky, môžu požiadať o zvýšenie limitov, no podanie žiadosti nezaručuje schválenie. Verejné API je naďalej dostupné s predvolenými limitmi, a to aj na testovanie v menšom rozsahu. Aktuálne limity používania nájdete v dokumentácii rozhrania Content Provenance API.
Kto má nárok na prístup k detektoru textu a sú kontroly spoplatnené?
Kontroly pomocou detektora textu sú v súčasnosti bezplatné. Medzi spôsoby použitia, ktoré spĺňajú podmienky, patrí činnosť akademických a výskumných organizácií skúmajúcich pôvod textu, spoľahlivosť detekcie alebo to, ako ľudia chápu výsledky overovania pôvodu.
Bežné komerčné využitie je v súčasnosti mimo rozsahu programu. Patrí sem napríklad komerčná prevencia podvodov, autentifikácia a overovanie alebo ďalší predaj v rámci balíkov služieb na overovanie pôvodu a analýzu údajov.
Aj využitie na zabezpečenie akademickej integrity, napríklad kontrola študentských prác z hľadiska použitia AI (napr. pri písaní esejí alebo záverečných prác), je v súčasnosti mimo rozsahu programu.
Čo znamenajú výsledky overenia?
Ak sa prostredníctvom openai.com/verify alebo Content Provenance API od OpenAI zistí signál, znamená to, že nahratý obsah obsahuje podporovaný signál pôvodu spojený s OpenAI. Nástroj nepotvrdzuje, že obsah je presný, neupravený, zákonne vlastnený alebo prezentovaný v správnom kontexte. Neurčuje ani to, kto obsah vytvoril alebo prečo vznikol.
Ak sa nezistí žiadny signál, znamená to, že nástroj v nahratom súbore nenašiel signály pôvodu vydané spoločnosťou OpenAI. Obsah však aj tak mohol byť vygenerovaný alebo exportovaný nástrojmi OpenAI, ak:
Bol vytvorený skôr, než boli signály pôvodu dostupné.
Pochádzal z nepodporovaného produktu, modelu, spôsobu exportu alebo typu súboru.
Metadáta boli odstránené počas nahrávania, sťahovania, úprav, konverzie alebo zdieľania.
Vodoznak bol narušený kompresiou, orezaním, šumom, úpravami, konverziou formátu alebo inými zmenami.
Zvukový klip je príliš krátky alebo bol výrazne upravený.
Ako získam čo najspoľahlivejší výsledok overovania?
Nahrávajte vždy len jeden podporovaný súbor a podľa možnosti použite pôvodný exportovaný súbor. Obrázky pred kontrolou neorezávajte ani nekonvertujte do iného formátu. Pri zvuku sa vo všeobecnosti najlepšie výsledky dosahujú s klipmi dlhými 10 až 60 sekúnd. Aj keď sa nezistí žiadny signál, pred vyvodením záveru zvážte zdroj a kontext súboru.
Zobrazujú výsledky môj príkaz alebo osobné údaje?
Signály pôvodu neobsahujú podrobnosti o používateľovi, organizácii ani príkaze.
Čo sa stane s obsahom, ktorý overím pomocou openai.com/verify alebo Content Provenance API?
Obsah nahratý na openai.com/verify alebo odoslaný na overenie do nášho Content Provenance API sa spracúva výlučne na vyhľadanie podporovaných signálov pôvodu. Obsah sa neukladá, pokiaľ to nevyžaduje zákon, a nepoužíva sa na trénovanie modelov OpenAI.
Dokáže OpenAI odhaliť obsah vygenerovaný pomocou iných nástrojov AI?
Naše nástroje na overovanie pôvodu obsahu sú navrhnuté na detekciu podporovaných signálov pôvodu spojených s obsahom vygenerovaným modelmi OpenAI alebo exportovaným nástrojmi OpenAI. Nie sú určené na odhaľovanie obsahu generovaného inými modelmi AI a nemusia odhaliť ani obsah generovaný OpenAI, ak príslušný signál chýba, nie je podporovaný alebo je poškodený.
Ako funguje označovanie vodoznakom
Určujú vodoznaky autorstvo, vlastníctvo alebo právnu zodpovednosť?
Nie. Vodoznak je dôkazom toho, že obsah pravdepodobne vygeneroval alebo spracoval model OpenAI. Sám osebe neurčuje, kto je autorom alebo vlastníkom obsahu, či bolo povinné uviesť použitie AI ani kto nesie právnu zodpovednosť. Neuvádza ani to, či model upravoval obsah nahratý používateľom.
Ukazujú vodoznaky, do akej miery sa na obsahu podieľal model OpenAI?
Nie. Detektor oznámi, či našiel vodoznak. Jeho nájdenie je dôkazom toho, že obsah pravdepodobne vygeneroval alebo spracoval model OpenAI, no neukazuje, či model vygeneroval iba časť alebo celý obsah, ani aký veľký bol príspevok človeka.
Ako funguje označovanie textu vodoznakom?
Označovanie textu vodoznakom vytvára tajný vzor v tom, ako model pri písaní vyberá slová a časti slov, nazývané „tokeny“.
V každom kroku model priradí pravdepodobnosť každému možnému nasledujúcemu tokenu. Systém označovania vodoznakom vytvorí niekoľko upravených súborov týchto pravdepodobností, pričom každý z nich podľa tajného kľúča uprednostňuje iné možnosti. Súbory sú vyvážené tak, aby ich priemer zodpovedal pôvodným pravdepodobnostiam modelu. Kľúč určí, ktorý súbor sa použije, a model z neho potom vykoná nový náhodný výber.
Detektor s rovnakým kľúčom a zodpovedajúcimi nastaveniami môže neskôr skontrolovať, či sa text riadi tajným vzorom častejšie, než by sa dalo očakávať pri náhodnom výbere.
Vzťahujú sa textové vodoznaky aj na faktografický text a text poskytnutý používateľom?
Označovanie textu vodoznakom závisí od toho, či má model k dispozícii rôzne spôsoby, ako niečo vyjadriť. Keď musí byť odpoveď prísne faktografická alebo presná, napríklad pri riešení matematickej úlohy, alebo keď má model reprodukovať dodaný text bez zmien, má menšiu voľnosť. V týchto prípadoch má model menej priestoru zmeniť formuláciu bez viditeľného rozdielu, takže vodoznak sa nemusí podariť detegovať.
Vzťahujú sa textové vodoznaky aj na krátke odpovede a kód?
Krátke pasáže zvyčajne neobsahujú dostatok textu na spoľahlivú detekciu vodoznaku. Aj označovanie kódu vodoznakom je náročnejšie, pretože v porovnaní s bežným textom existuje menej prijateľných možností, ako môže pokračovať.
Kódex postupov v oblasti transparentnosti obsahu generovaného AI podľa aktu EÚ o umelej inteligencii zohľadňuje tieto obmedzenia a nevyžaduje vodoznaky vo výstupoch kratších ako 200 tokenov – približne 150 slov v angličtine – ani v úryvkoch kódu.
Ako sa líši detekcia textových vodoznakov medzi jazykmi?
Úspešnosť detekcie sa líši podľa jazyka a v niektorých jazykoch je v súčasnosti jednoduchšie odhaliť vodoznak než v iných. Silu vodoznaku môžeme upraviť, aby sme zlepšili detekciu v jazykoch, v ktorých je signál slabší.
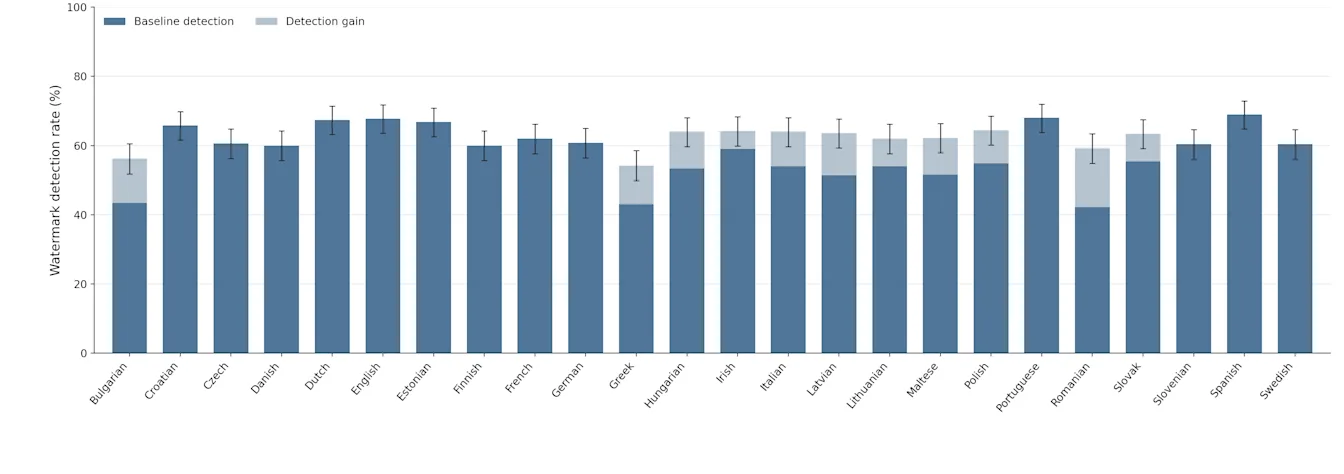
Tento graf hodnotí úspešnosť detekcie vo všetkých 24 úradných jazykoch EÚ. Najprv sme vygenerovali 500 syntetických príkazov v angličtine na rôzne témy a potom sme ich preložili do zvyšných 23 jazykov. Pri 1 % miere falošne pozitívnych výsledkov má najvyššiu úspešnosť detekcie španielčina (69,0 %) a najnižšiu rumunčina (42,2 %). Náš vodoznak má nastaviteľný parameter sily – akýsi „regulátor“, ktorý zosilňuje alebo zoslabuje signál vodoznaku pre rôzne oblasti použitia. Pomocou tohto regulátora sme dokázali zvýšiť silu signálu pri jazykoch s úspešnosťou detekcie pod 60 %; svetlomodré časti stĺpcov ukazujú dosiahnuté zlepšenie.
Znižujú textové vodoznaky kvalitu modelu?
Podľa našich testov nie. V benchmarkoch, ktorými hodnotíme Astru, náš najnovší prelomový model, sú rozdiely vo výkone s vodoznakom a bez neho v rámci bežného kolísania, ktoré pozorujeme medzi jednotlivými hodnoteniami. Ani skoršie testy v ChatGPT neukázali po zavedení vodoznakov žiadnu zmenu v podiele hodnotení palcom nadol ani v iných produktových ukazovateľoch.
Znižujú textové vodoznaky rýchlosť modelu?
Označovanie textu vodoznakom má zanedbateľný vplyv na rýchlosť našich modelov.
Čím sa textové vodoznaky OpenAI líšia od nástrojov tretích strán na detekciu obsahu vytvoreného AI?
Detekčné nástroje tretích strán, ako je Pangram, zvyčajne používajú klasifikátory na rozpoznávanie textu vygenerovaného AI na základe vzorcov, napríklad vo výbere slov. Tento prístup analyzuje text po jeho vygenerovaní namiesto toho, aby zisťoval vložený signál. Akt EÚ o umelej inteligencii výslovne vyžaduje, aby bol do vygenerovaného textu vložený signál.
Prečo používate vlastné textové vodoznaky namiesto technológií TextSeal alebo SynthID?
Vyvinuli sme vlastnú metódu označovania textu vodoznakom s názvom textGrain. Oproti technológiám SynthID či TextSeal nám dáva väčšiu kontrolu nad rovnováhou medzi detegovateľnosťou vodoznaku a rozmanitosťou odpovedí generovaných na základe rovnakého príkazu. V našich testoch náš prístup správne identifikoval podobný alebo vyšší podiel textových vzoriek s vodoznakom než SynthID pre text. Plánujeme sprístupniť textGrain ako technológiu s otvoreným zdrojovým kódom, aby na nej mohli stavať aj ostatní a pomáhať zlepšovať označovanie textu vodoznakom.
Pridáva označovanie textu vodoznakom skryté znaky, ďalšie tokeny alebo viditeľné zmeny?
Nie. Označovanie textu vodoznakom mení štatistický vzor výberu slov; nevkladá skryté znaky ani nepridáva tokeny slúžiace len na vytvorenie vodoznaku. Čitatelia vodoznak nevidia a kopírovaním a vkladaním textu sa nepridáva žiadny skrytý obsah.
Pokyny pre zákazníkov
Som zákazníkom API. Ako si zapnem textové vodoznaky?
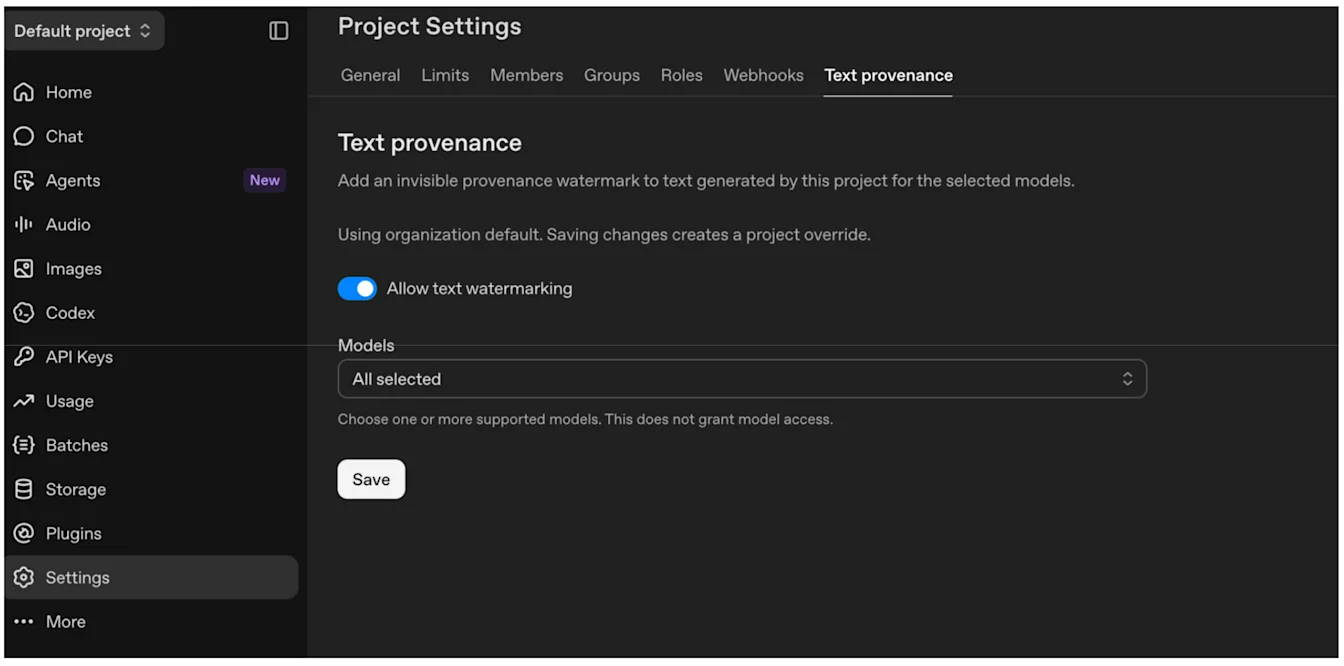
Zákazníci API OpenAI môžu zapnúť textové vodoznaky pre konkrétny projekt cez Nastavenia alebo pre celú organizáciu cez Nastavenia organizácie. V oboch prípadoch si zákazníci môžu vybrať, pri ktorých modeloch sa bude textový vodoznak používať. Po zapnutí tejto funkcie pre podporovaný model pridáva OpenAI vodoznak počas generovania textu. Zákazníci nemusia pridávať samostatné označenie do každej odpovede.
Zapnite možnosť Povoliť textové vodoznaky, vyberte modely a potom zvoľte Uložiť.
Predvolené nastavenie organizácie: Prejdite do časti Nastavenia organizácie > Ovládanie údajov.
Vyberte možnosť Pôvod textu.
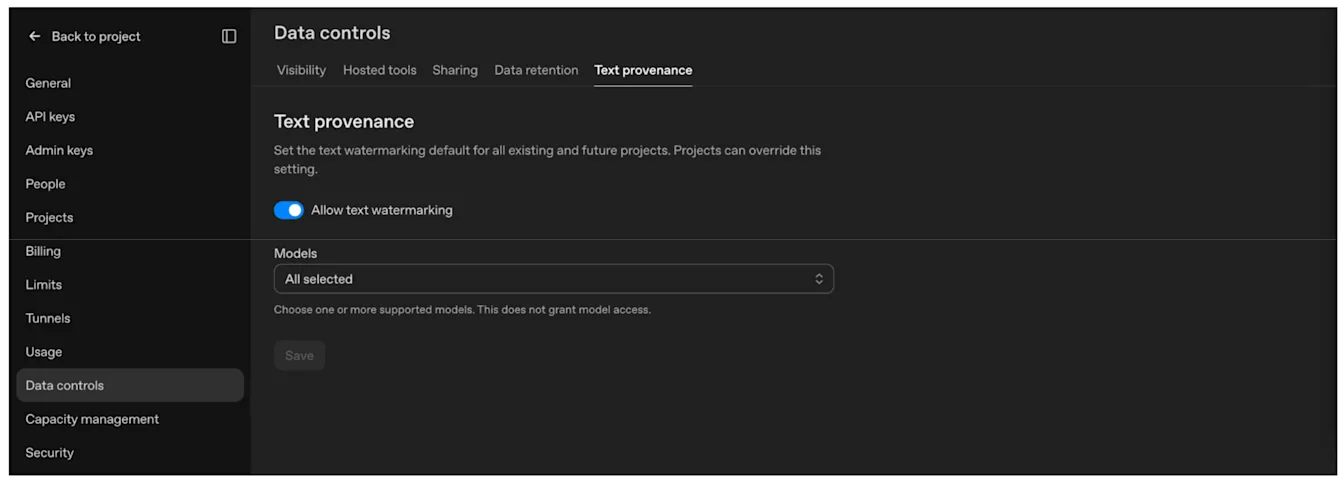
Prepísanie nastavenia pre projekt: Prejdite do časti Nastavenia projektu > Pôvod textu.
Pre ktoré modely môžem zapnúť vodoznaky?
V Nastaveniach a Nastaveniach organizácie si zákazníci môžu pozrieť zoznam modelov, pre ktoré sú vodoznaky aktuálne dostupné. V najbližších týždňoch rozšírime podporu na všetky staršie modely.
Získam zapnutím textových vodoznakov aj prístup k detektoru textu?
Nie. Prístup k detektoru textu je v súčasnosti obmedzený na schválené výskumné a akademické organizácie, ktoré pracujú na zvyšovaní spoľahlivosti označovania textu vodoznakom, zjednodušovaní jeho používania a zrozumiteľnejšom vysvetľovaní tejto technológie a jej výsledkov. Je to v súlade s našimi záväzkami vyplývajúcimi z Kódexu postupov v oblasti transparentnosti obsahu generovaného AI podľa aktu EÚ o umelej inteligencii.
Zostanú signály zachované aj po úprave obsahu?
Môžu zostať zachované, ale závisí to od signálu a vykonaných zmien.
Pri podporovaných obrázkoch a zvukových súboroch si ponechajte pôvodnú kópiu a pomocou Content Provenance API otestujte reprezentatívne súbory po úprave, konverzii a zverejnení. Pri obrázkoch môže orezanie, pridanie šumu, konverzia do formátu JPEG či vytvorenie snímky obrazovky sťažiť detekciu signálov. Text môžete týmto spôsobom testovať len vtedy, ak má vaša organizácia schválený prístup k detektoru textu.
Ak to formát súboru a pracovný postup podporujú, zachovajte existujúce metadáta C2PA a do vytváraných súborov zahrňte Content Credentials. Môžete tiež zvážiť pridanie vlastných označení, aby boli informácie o pôvode odolnejšie voči zmenám alebo užitočnejšie. Podrobnosti o implementácii nájdete v technickej dokumentácii C2PA.
Pri texte je vodoznak súčasťou spôsobu, akým model vyberá slová. Ak zachováte znenie, očakáva sa, že signál pri opätovnom použití textu zostane zachovaný bez potreby ďalšej integrácie. Výrazné prepracovanie, parafrázovanie alebo preklad môžu znížiť spoľahlivosť detekcie. Ani nezmenené znenie nezaručuje, že vodoznak bude možné zistiť, najmä pri krátkych pasážach alebo texte s malým priestorom na inú voľbu slov.
K modelom OpenAI pristupujem prostredníctvom cloudovej služby. Obsahujú aj tieto výstupy signály pôvodu?
Spolupracujeme so všetkými našimi poskytovateľmi cloudových a distribučných služieb, aby sa signály pôvodu vrátane vodoznakov vkladali do všetkých výstupov, ktoré spĺňajú podmienky, vrátane obrázkov, zvuku a textu. Dostupnosť sa môže líšiť podľa výstupu a partnera.
Nahrádzajú signály pôvodu viditeľné označenia AI alebo iné upozornenia?
Nie. Vodoznaky a metadáta C2PA poskytujú informácie, ktoré dokáže čítať softvér. Nenahrádzajú viditeľné označenia, bannery ani iné upozornenia, ktoré môžu byť povinné.
To, či potrebujete ďalšie upozornenie, závisí od toho, ako a kde obsah používate. OpenAI vám nemôže poskytovať poradenstvo o vašich konkrétnych právnych povinnostiach; požiadavky pre váš spôsob použitia by mal posúdiť váš právny tím.
Mám ďalšie otázky týkajúce sa aktu EÚ o umelej inteligencii
Pošlite nám otázku k aktu EÚ o umelej inteligencii a ozveme sa vám.