
V okviru zavezanosti varnejšemu in preglednejšemu ekosistemu umetne inteligence OpenAI uporablja signale o izvoru, ki ljudem pomagajo ugotoviti, ali je bila vsebina ustvarjena z modelom OpenAI.
Signali o izvoru lahko ponudijo koristne informacije o izvoru, vendar ne zagotavljajo, da je vsebina točna, nespremenjena, v zakoniti lasti ali predstavljena v ustreznem kontekstu.
Signali o izvoru OpenAI
Katere signale o izvoru uporablja OpenAI?
OpenAI za različne vrste vsebine uporablja različne signale o izvoru.
| Vrsta vsebine | Signali o izvoru | Opombe |
|---|---|---|
| Slike | Potrdila o vsebini in vodni žigi SynthID | Slike, ustvarjene z orodji ChatGPT, Codex ali API-jem OpenAI, vključujejo oba signala. |
| Zvok | Vodni žigi SynthID | Zvok, ustvarjen s ChatGPT ali API-jem OpenAI, vključuje neslišen vodni žig, vdelan v sam zvok. |
| Besedilo | Vodni žigi textGrain (samo v EU) | V EU besedilo, ustvarjeno s ChatGPT, zaradi skladnosti z Aktom EU o umetni inteligenci vključuje nevidno spremembo naključnosti pri modelovi izbiri besed. Stranke API-ja po vsem svetu lahko v nastavitvah projekta ali organizacije vklopijo besedilne vodne žige za izhodna besedila. |
| Video | Potrdila o vsebini | Sora je ukinjena. Več informacij. |
Podpora se lahko razlikuje glede na izdelek, model, način izvoza, vrsto datoteke in čas nastanka vsebine. Izhodne vsebine API-ja so zajete, razen pri modelih, za katere je načrtovana skorajšnja opustitev, vključno z gpt-image-1, gpt-image-1.5 in sora-2.
Zakaj se pri nekaterih vrstah vsebine uporablja več signalov?
Kadar je to tehnično izvedljivo, OpenAI združuje metapodatke in vodne žige, da lahko eni nadomestijo omejitve drugih. Metapodatki lahko vsebujejo podrobne informacije, vendar jih lahko platforme, orodja za urejanje in pretvorbe datotek odstranijo. Vodni žigi vsebujejo manj konteksta, a ker so vdelani v samo ustvarjeno vsebino, se lahko ohranijo tudi po nekaterih preoblikovanjih, ki odstranijo metapodatke.
Kako odporni so signali o izvoru proti spremembam vsebine?
Vodni žigi SynthID za slike in zvok ter vodni žigi textGrain za besedilo so zasnovani tako, da se ohranijo ob običajnih spremembah. Te lahko glede na vrsto vsebine vključujejo manjše popravke, kopiranje in lepljenje, obrezovanje ali posnetke zaslona. Zaradi obsežnejših sprememb, kot so močno obrezovanje slike, stiskanje datoteke, obsežno parafraziranje ali prevajanje, lahko vodni žig postane nezaznaven. Po obsežnih spremembah je lahko tudi manj smiselno rezultat opisati kot »ustvarjen z modeli OpenAI«.
Potrdila o vsebini, ki jih je razvila Koalicija za izvor in pristnost vsebin, se lahko izgubijo pri vsakdanjih opravilih, kot sta ustvarjanje posnetka zaslona ali pretvorba datoteke. Kadar se ohranijo, lahko ponudijo več podrobnosti o izvoru in zgodovini datoteke kot sam vodni žig.
Kjer je to tehnično mogoče, uporabljamo obe metodi, da povečamo verjetnost, da se informacije o izvoru ohranijo tudi po spremembah vsebine.
Kaj so potrdila o vsebini in kaj omogočajo?
Potrdila o vsebini datoteki priložijo informacije o njenem izvoru in zgodovini, na primer s katerim orodjem je bila ustvarjena in kdaj. Uporabljajo odprti standard, ki ga je razvila Koalicija za izvor in pristnost vsebin (C2PA), zato jih včasih imenujemo »metapodatki C2PA«.
Potrdila o vsebini ljudem pomagajo preveriti, od kod vsebina izvira. Njihova uporaba ni omejena na vsebine, ustvarjene z umetno inteligenco: proizvajalci fotoaparatov, novičarske organizacije in drugi standard uporabljajo tudi za potrjevanje izvora in zgodovine svojih medijskih vsebin. Več o C2PA.
Kaj je SynthID in kaj omogoča?
SynthID je tehnologija za označevanje z nevidnimi vodnimi žigi, ki jo je razvil Google DeepMind in signal vdela neposredno v ustvarjene medijske vsebine. V nasprotju z metapodatki je signal del same vsebine in se lahko ohrani tudi po nekaterih spremembah ali preoblikovanjih. SynthID poleg metapodatkov C2PA zagotavlja dodaten signal o izvoru. Če so na primer metapodatki odstranjeni iz datoteke, lahko vdelani vodni žig še vedno nakazuje, da je bila vsebina ustvarjena s podprtimi orodji OpenAI. Več o tehnologiji SynthID.
Zakaj izhodna besedila označujete z vodnimi žigi?
Za uporabnike ChatGPT v EU uvajamo označevanje besedila z vodnimi žigi, da bi izpolnili zahteve Akta EU o umetni inteligenci in svoje zaveze iz Kodeksa ravnanja EU glede preglednosti vsebin, ustvarjenih z umetno inteligenco, ki ga je OpenAI podpisal skupaj z več drugimi večjimi ponudniki umetne inteligence.
Kaj je textGrain in kaj omogoča?
textGrain je tehnologija družbe OpenAI za označevanje besedila z vodnimi žigi. Neopazno prilagodi način, kako model med pisanjem naključno izbira med možnimi besedami ali deli besed. Te izbire v odlomku ustvarijo vzorec, ki ga lahko detektor prepozna tudi po nekaterih spremembah.
Vodni žig je del samega ubesedenja in bralcem ni viden. Ne dodaja skritih znakov, nevidnih presledkov ali neobičajnih ločil. Označevanje besedila z vodnimi žigi pomaga izpolnjevati zahtevo Akta EU o umetni inteligenci glede označevanja ustvarjenega besedila.
Orodja OpenAI za preverjanje
Kako lahko preverim, ali je bila vsebina ustvarjena z orodji OpenAI?
Na strani openai.com/verify lahko preverite, ali podprta slikovna ali zvočna datoteka vsebuje signale o izvoru, povezane z vsebino, ustvarjeno ali izvoženo z orodji OpenAI. Ko naložite podprto datoteko, orodje v njej poišče podprte signale o izvoru OpenAI, na primer vodni žig SynthID ali zaupanja vreden manifest C2PA, povezan z družbo OpenAI. Če orodje najde podprt signal o izvoru OpenAI, to nakazuje, da je vsebino verjetno ustvaril model OpenAI.
Razvijalci in organizacije lahko uporabijo tudi API družbe OpenAI za izvor vsebine, da v slikah in zvoku preverijo prisotnost signalov o izvoru OpenAI ter preverjanje vključijo v svoje aplikacije ali delovne procese. Organizacije, katerih primer uporabe izpolnjuje pogoje, lahko zaprosijo za višje omejitve.
V skladu z našimi obveznostmi iz Akta EU o umetni inteligenci lahko organizacije, katerih primer uporabe izpolnjuje pogoje, zaprosijo za dostop do detektorja besedila. Sem spadajo na primer akademske in raziskovalne organizacije, ki preučujejo izvor besedil, zanesljivost zaznavanja ali to, kako ljudje razumejo rezultate preverjanja izvora. Vloge organizacij, ki izpolnjujejo pogoje, bomo obravnavali posamično in jim po potrebi poslali obvestila o novostih ali zahteve za dodatne informacije. Naš pristop k dostopu se lahko z novimi spoznanji in izboljšavami tehnologije spreminja.
Trenutno sodelujemo z omejeno skupino raziskovalcev, med katerimi so John Thickstun, docent za računalništvo na Univerzi Cornell, Martin Vechev, profesor računalništva na ETH Zürich in znanstveni direktor inštituta INSAIT, ter raziskovalci z Inštituta Kempelen za inteligentne tehnologije (KInIT). Tako želimo bolje razumeti zmožnosti in omejitve tehnologije ter pridobiti spoznanja za izboljšave označevanja besedila z vodnimi žigi.
Kdo izpolnjuje pogoje za višje omejitve preverjanja in ali se preverjanja zaračunavajo?
Preverjanja z API-jem za izvor vsebine so trenutno brezplačna, vendar zanje veljajo omejitve uporabe. Program z višjimi omejitvami je namenjen projektom preverjanja izvora v javnem interesu in delovnim procesom za zagotavljanje integritete informacij, ki izpolnjujejo pogoje. Primeri vključujejo preverjanje v uredništvih, preverjanje dejstev, raziskovanje izvora vsebin in regulativni nadzor.
Splošna poslovna uporaba trenutno ni vključena v program. Sem spadajo komercialno preprečevanje goljufij, preverjanje pristnosti in preverjanje vsebin ter preprodaja v okviru paketov storitev za preverjanje izvora in analizo podatkov.
Organizacije, katerih primer uporabe izpolnjuje pogoje, lahko zaprosijo za višje omejitve, vendar oddaja vloge ne zagotavlja odobritve. Javni API ostaja na voljo s privzetimi omejitvami, tudi za manjša ocenjevanja. Trenutne omejitve uporabe najdete v dokumentaciji API-ja za izvor vsebine.
Kdo izpolnjuje pogoje za dostop do detektorja besedila in ali se preverjanja zaračunavajo?
Preverjanja z detektorjem besedila so trenutno brezplačna. Pogoje izpolnjujejo primeri uporabe akademskih in raziskovalnih organizacij, ki preučujejo izvor besedil, zanesljivost zaznavanja ali to, kako ljudje razumejo rezultate preverjanja izvora.
Splošna poslovna uporaba trenutno ni vključena v program. Sem spadajo komercialno preprečevanje goljufij, preverjanje pristnosti in preverjanje vsebin ter preprodaja v okviru paketov storitev za preverjanje izvora in analizo podatkov.
Tudi uporaba za zagotavljanje akademske integritete, na primer preverjanje študentskih del glede uporabe umetne inteligence (npr. pri pisanju esejev ali zaključnih nalog), trenutno ni vključena v program.
Kaj pomenijo rezultati preverjanja?
Če je signal zaznan na strani openai.com/verify ali prek API-ja družbe OpenAI za izvor vsebine, to pomeni, da naložena vsebina vsebuje podprt signal o izvoru, povezan z družbo OpenAI. Orodje ne potrjuje, da je vsebina točna, nespremenjena, v zakoniti lasti ali predstavljena v ustreznem kontekstu. Prav tako ne ugotavlja, kdo je vsebino ustvaril ali zakaj je nastala.
Če ni zaznan noben signal, to pomeni, da orodje v naloženi datoteki ni našlo signalov o izvoru, ki jih je izdal OpenAI. Vsebina je bila kljub temu lahko ustvarjena ali izvožena z orodji OpenAI, če:
Je bila ustvarjena, preden so bili signali o izvoru na voljo.
Izvira iz nepodprtega izdelka, modela, načina izvoza ali vrste datoteke.
So bili metapodatki odstranjeni med nalaganjem, prenosom, urejanjem, pretvorbo ali deljenjem.
Je bil vodni žig oslabljen zaradi stiskanja, obrezovanja, šuma, urejanja, pretvorbe oblike zapisa ali drugih preoblikovanj.
Je zvočni posnetek prekratek ali je bil bistveno spremenjen.
Kako lahko dobim najzanesljivejši rezultat preverjanja?
Naenkrat naložite eno podprto datoteko in po možnosti uporabite izvirno izvoženo datoteko. Slik pred preverjanjem ne obrezujte ali pretvarjajte. Pri zvoku najboljše rezultate praviloma dajejo posnetki, dolgi od 10 do 60 sekund. Tudi če ni zaznan noben signal, pred sklepom upoštevajte izvor in kontekst datoteke.
Ali rezultati razkrijejo moj poziv ali osebne podatke?
Signali o izvoru ne vključujejo podrobnosti o uporabniku, organizaciji ali pozivu.
Kaj se zgodi z vsebino, ki jo preverim na strani openai.com/verify ali z API-jem za izvor vsebine?
Vsebina, naložena na openai.com/verify ali poslana našemu API-ju za izvor vsebine v preverjanje, se obdeluje izključno za preverjanje prisotnosti podprtih signalov o izvoru. Vsebina se ne shranjuje, razen če to zahteva zakon, in se ne uporablja za učenje modelov OpenAI.
Ali lahko OpenAI zazna vsebino, ustvarjeno z drugimi orodji umetne inteligence?
Naša orodja za preverjanje izvora vsebine so zasnovana za zaznavanje podprtih signalov o izvoru, povezanih z vsebino, ustvarjeno z modeli OpenAI ali izvoženo z orodji OpenAI. Niso namenjena zaznavanju vsebine, ustvarjene z drugimi modeli umetne inteligence, prav tako pa morda ne bodo zaznala vsebine, ustvarjene z modeli OpenAI, če ustrezni signal manjka, ni podprt ali je oslabljen.
Kako deluje označevanje z vodnimi žigi
Ali vodni žigi določajo avtorstvo, lastništvo ali pravno odgovornost?
Ne. Vodni žig je dokaz, da je vsebino verjetno ustvaril ali obdelal model OpenAI. Sam po sebi ne dokazuje, kdo je avtor ali lastnik vsebine, ali je bilo potrebno razkritje oziroma kdo je pravno odgovoren. Prav tako ne pove, ali je model urejal vsebino, ki jo je naložil uporabnik.
Ali vodni žigi kažejo, v kolikšni meri je pri vsebini sodeloval model OpenAI?
Ne. Detektor sporoči, ali je našel vodni žig. Najden vodni žig je dokaz, da je vsebino verjetno ustvaril ali obdelal model OpenAI, ne pokaže pa, ali je model ustvaril del vsebine ali celoto oziroma koliko je prispeval človek.
Kako deluje označevanje besedila z vodnimi žigi?
Označevanje besedila z vodnimi žigi med pisanjem ustvari skrivni vzorec v modelovi izbiri besed in delov besed, imenovanih »žetoni«.
Model pri vsakem koraku dodeli verjetnost vsakemu možnemu naslednjemu žetonu. Sistem za označevanje z vodnimi žigi ustvari več prilagojenih naborov teh verjetnosti, pri čemer vsak na podlagi skrivnega ključa daje prednost drugačnim izbiram. Nabori so uravnoteženi tako, da se njihovo povprečje ujema s prvotnimi verjetnostmi modela. Ključ določi, kateri nabor se uporabi, model pa nato iz tega nabora znova naključno izbere žeton.
Detektor z istim ključem in ustreznimi nastavitvami lahko pozneje preveri, ali besedilo sledi skrivnemu vzorcu pogosteje, kot bi pričakovali po naključju.
Ali se besedilni vodni žigi uporabljajo tudi pri stvarnem besedilu in besedilu, ki ga posreduje uporabnik?
Označevanje besedila z vodnimi žigi je odvisno od tega, ali lahko model isto stvar izrazi na različne načine. Možnosti je manj, kadar mora biti odgovor strogo vezan na dejstva ali zelo natančen, na primer pri rešitvi matematične naloge, ali kadar model prosimo, naj posredovano besedilo ponovi brez sprememb. V teh primerih ima model manj možnosti za neopazno spremembo ubesedenja, zato vodni žig morda ne bo zaznan.
Ali se besedilni vodni žigi uporabljajo tudi pri kratkih odgovorih in kodi?
Kratki odlomki običajno ne vsebujejo dovolj besedila za zanesljivo zaznavanje vodnih žigov. Tudi kodo je težje označiti z vodnim žigom, saj je v primerjavi z običajnim besedilom manj smiselnih možnosti za nadaljevanje.
Zaradi teh omejitev Kodeks ravnanja glede preglednosti vsebin, ustvarjenih z umetno inteligenco, v okviru Akta EU o umetni inteligenci ne zahteva vodnih žigov v izhodnih vsebinah, krajših od 200 žetonov – približno 150 besed v angleščini – ali v izsekih kode.
Kako se zaznavanje besedilnih vodnih žigov razlikuje med jeziki?
Stopnje zaznavanja se razlikujejo glede na jezik; v nekaterih jezikih je vodne žige trenutno lažje zaznati kot v drugih. Moč vodnega žiga lahko prilagodimo, da izboljšamo zaznavanje v jezikih, v katerih je signal šibkejši.
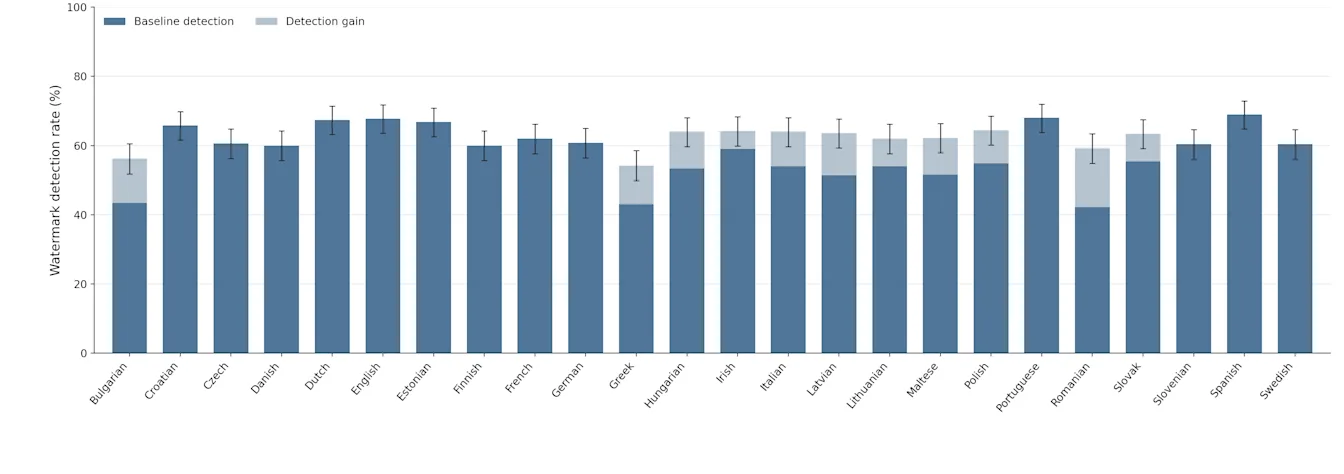
Ta graf prikazuje oceno stopnje zaznavanja v vseh 24 uradnih jezikih EU. Najprej smo ustvarili 500 sintetičnih pozivov v angleščini na različne teme in jih nato prevedli v preostalih 23 jezikov. Pri 1-odstotni stopnji lažno pozitivnih rezultatov ima španščina najvišjo stopnjo zaznavanja (69,0 %), romunščina pa najnižjo (42,2 %). Naš vodni žig ima nastavljiv parameter moči – »gumb«, s katerim lahko okrepimo ali oslabimo signal vodnega žiga za različna področja. S tem gumbom smo povečali moč za jezike s stopnjo zaznavanja pod 60 %; svetlomodri deli stolpcev prikazujejo dosežene izboljšave.
Ali besedilni vodni žigi zmanjšujejo kakovost modela?
Naši preizkusi kažejo, da ne. Pri primerjalnih preizkusih, s katerimi ocenjujemo Astro, naš najnovejši prelomni model, so razlike v uspešnosti z vodnimi žigi in brez njih znotraj običajnega šuma, ki ga opažamo med posameznimi ocenjevanji. Tudi prejšnji preizkusi v ChatGPT po uvedbi vodnih žigov niso pokazali sprememb v deležu ocen s palcem navzdol ali drugih kazalnikih izdelka.
Ali besedilni vodni žigi upočasnijo delovanje modela?
Označevanje besedila z vodnimi žigi ima zanemarljiv vpliv na hitrost naših modelov.
Kako se besedilni vodni žigi OpenAI razlikujejo od orodij drugih ponudnikov za zaznavanje vsebin, ustvarjenih z umetno inteligenco?
Orodja drugih ponudnikov za zaznavanje, kot je Pangram, običajno uporabljajo klasifikatorje za prepoznavanje besedila, ustvarjenega z umetno inteligenco, na podlagi vzorcev, kot je izbira besed. Ta pristop analizira besedilo po nastanku, namesto da bi zaznaval vdelani signal. Akt EU o umetni inteligenci izrecno zahteva, da je signal vdelan v ustvarjeno besedilo.
Zakaj uporabljate lastne besedilne vodne žige namesto tehnologij TextSeal ali SynthID?
Razvili smo lastno metodo označevanja besedila z vodnimi žigi, imenovano textGrain, ki nam v primerjavi s tehnologijama SynthID ali TextSeal omogoča več nadzora nad ravnovesjem med zaznavnostjo vodnega žiga in raznolikostjo odgovorov, ustvarjenih na podlagi istega poziva. V naših preizkusih je naš pristop pravilno prepoznal podoben ali večji delež besedilnih vzorcev z vodnim žigom kot SynthID za besedilo. Tehnologijo textGrain nameravamo objaviti kot odprtokodno, da jo bodo lahko drugi nadgrajevali in pomagali izboljšati označevanje besedila z vodnimi žigi.
Ali označevanje besedila z vodnimi žigi dodaja skrite znake, dodatne žetone ali vidne spremembe?
Ne. Označevanje besedila z vodnimi žigi spremeni statistični vzorec izbire besed; ne vstavlja skritih znakov in ne dodaja žetonov, namenjenih zgolj vodnemu žigu. Vodni žig bralcem ni viden, kopiranje in lepljenje besedila pa ne dodaja skrite vsebine.
Smernice za stranke
Uporabljam API. Kako vklopim besedilne vodne žige?
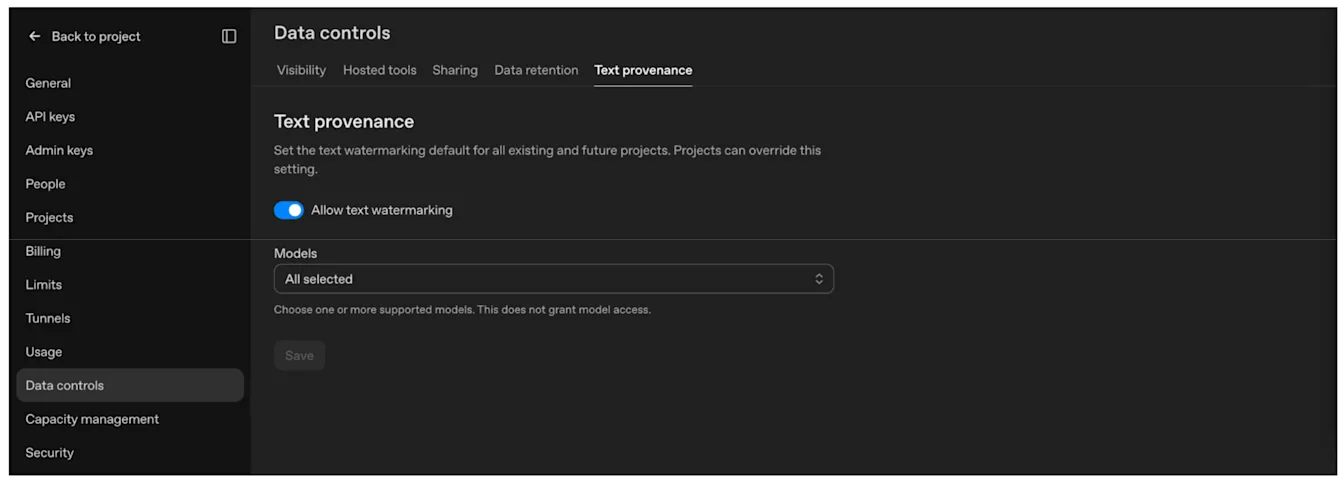
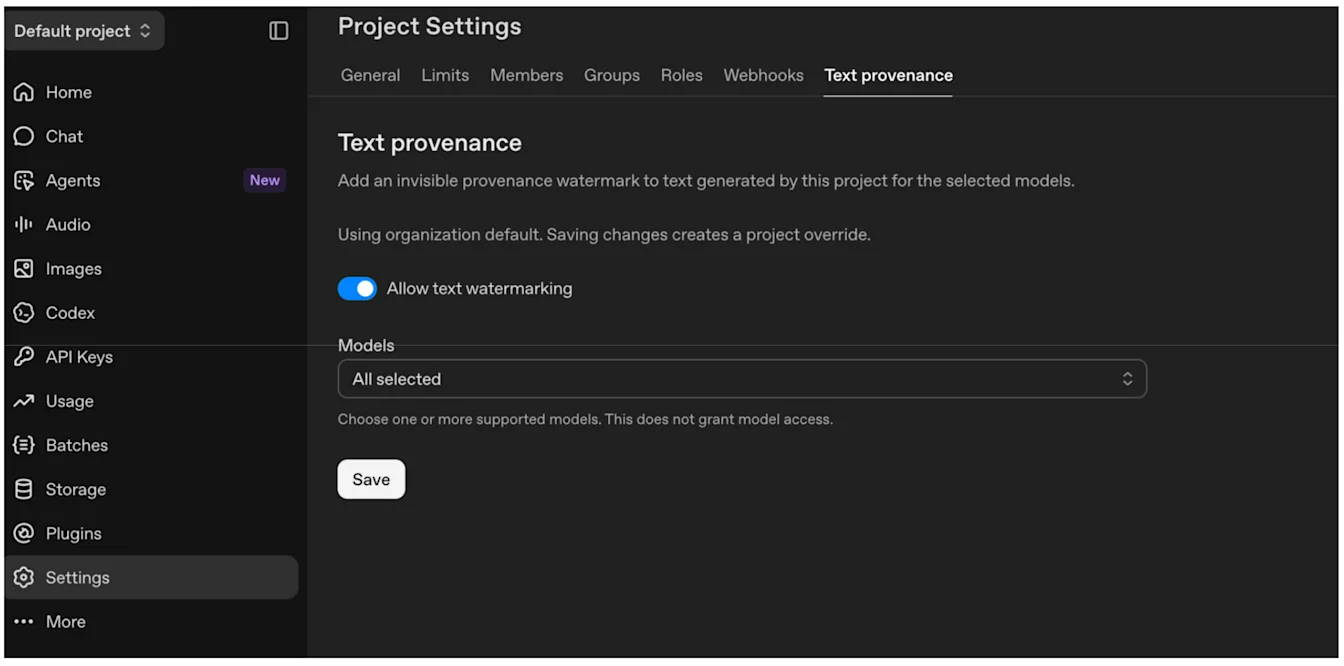
Stranke API-ja OpenAI lahko označevanje besedila z vodnimi žigi vklopijo za posamezen projekt v razdelku Nastavitve ali za celotno organizacijo v razdelku Nastavitve organizacije. V obeh primerih lahko izberejo, za katere modele se uporabi besedilni vodni žig. Ko je ta možnost vklopljena za podprt model, OpenAI vodni žig doda med ustvarjanjem besedila. Strankam ni treba dodajati ločene oznake vsakemu odgovoru.
Vklopite možnost Dovoli označevanje besedila z vodnimi žigi, izberite modele in nato izberite Shrani.
Privzeta nastavitev za organizacijo: Nastavitve organizacije → Nadzor podatkov → Izvor besedila.
Preglasitev za projekt: Nastavitve projekta → Izvor besedila.
Za katere modele lahko vklopim vodne žige?
Stranke si lahko v razdelkih Nastavitve in Nastavitve organizacije ogledajo seznam modelov, za katere je trenutno na voljo označevanje z vodnimi žigi. V prihodnjih tednih bomo podporo razširili na vse starejše modele.
Ali z vklopom besedilnih vodnih žigov dobim tudi dostop do detektorja besedila?
Ne. Dostop do detektorja besedila je trenutno omejen na odobrene raziskovalne in akademske organizacije, ki si prizadevajo izboljšati zanesljivost in preprostost uporabe označevanja besedila z vodnimi žigi ter jasnost razlage tehnologije in njenih rezultatov. To je v skladu z našimi zavezami iz Kodeksa ravnanja glede preglednosti vsebin, ustvarjenih z umetno inteligenco, v okviru Akta EU o umetni inteligenci.
Ali se signali ohranijo v vsebini, potem ko jo preoblikujem?
Lahko se, vendar je to odvisno od signala in sprememb, ki jih naredite.
Pri podprtih slikah in zvočnih posnetkih shranite izvirno kopijo in z API-jem za izvor vsebine preizkusite reprezentativne datoteke po urejanju, pretvorbi in objavi. Pri slikah lahko obrezovanje, dodajanje šuma, pretvorba v JPEG in ustvarjanje posnetkov zaslona otežijo zaznavanje signalov. Besedilo lahko na ta način preizkušate le, če ima vaša organizacija odobren dostop do detektorja besedila.
Kadar oblika datoteke in delovni proces to podpirata, ohranite obstoječe metapodatke C2PA in v ustvarjene datoteke vključite potrdila o vsebini. Razmislite lahko tudi o dodajanju lastnih oznak, da bodo informacije o izvoru trajnejše ali uporabnejše. Podrobnosti o implementaciji najdete v tehnični dokumentaciji C2PA.
Pri besedilu je vodni žig del modelove izbire besed. Če ohranite ubesedenje, naj bi se signal ob ponovni uporabi besedila ohranil brez dodatnega dela pri integraciji. Obsežno prepisovanje, parafraziranje ali prevajanje lahko zmanjša zanesljivost zaznavanja. Tudi nespremenjeno ubesedenje ne zagotavlja zaznavnega vodnega žiga, zlasti pri kratkih odlomkih ali besedilu, pri katerem je malo možnosti za drugačno izbiro besed.
Do modelov OpenAI dostopam prek storitve v oblaku. Ali tudi te izhodne vsebine vsebujejo signale o izvoru?
Z vsemi našimi ponudniki storitev v oblaku in distribucijskimi partnerji sodelujemo pri zagotavljanju, da so signali o izvoru, vključno z vodnimi žigi, vdelani v vse ustrezne izhodne vsebine, vključno s slikami, zvokom in besedilom. Razpoložljivost se lahko razlikuje glede na izhodno vsebino in partnerja.
Ali signali o izvoru nadomeščajo vidne oznake o uporabi umetne inteligence ali druga razkritja?
Ne. Vodni žigi in metapodatki C2PA zagotavljajo informacije, ki jih lahko prebere programska oprema. Ne nadomeščajo vidnih oznak, pasic ali drugih obvestil, ki so lahko obvezna.
Ali potrebujete dodatno razkritje, je odvisno od tega, kako in kje uporabljate vsebino. OpenAI vam ne more svetovati glede vaših konkretnih pravnih obveznosti; zahteve za vaš način uporabe naj presodi vaša pravna ekipa.
Imam dodatna vprašanja o Aktu EU o umetni inteligenci
Prosimo, pošljite vprašanje o Aktu EU o umetni inteligenci in odgovorili vam bomo.