OpenAI ใช้สัญญาณระบุแหล่งที่มาเพื่อช่วยให้ผู้คนทราบว่าเนื้อหาสร้างขึ้นด้วยโมเดลของ OpenAI หรือไม่ ซึ่งเป็นส่วนหนึ่งของความมุ่งมั่นในการสร้างระบบนิเวศ AI ที่ปลอดภัยและโปร่งใสยิ่งขึ้น
สัญญาณระบุแหล่งที่มาสามารถให้ข้อมูลที่เป็นประโยชน์เกี่ยวกับต้นทางของเนื้อหา แต่ไม่ได้รับประกันว่าเนื้อหานั้นถูกต้อง ไม่ผ่านการแก้ไข มีกรรมสิทธิ์โดยชอบด้วยกฎหมาย หรือนำเสนอในบริบทที่ถูกต้อง
สัญญาณระบุแหล่งที่มาของ OpenAI
OpenAI ใช้สัญญาณระบุที่มาอะไรบ้าง?
OpenAI ใช้สัญญาณระบุที่มาที่แตกต่างกันสำหรับเนื้อหาแต่ละประเภท
| ประเภทเนื้อหา | รูปแบบที่รองรับ | สัญญาณระบุที่มา | หมายเหตุ |
|---|---|---|---|
| รูปภาพ | PNG, JPEG/JPG, WebP, GIF | Content Credentials และลายน้ำ SynthID | รูปภาพที่สร้างด้วย ChatGPT หรือ OpenAI API มีสัญญาณทั้งสองประเภท |
| เสียง | MP3, WAV, AAC, FLAC, OGG, Opus, PCM | ลายน้ำ SynthID | เสียงที่สร้างโดย ChatGPT หรือ OpenAI API มีลายน้ำที่ไม่ได้ยินฝังอยู่ในตัวเสียง |
| ข้อความ | ข้อความอิสระ ไม่ผูกกับรูปแบบไฟล์ | ลายน้ำ textGrain (เฉพาะสหภาพยุโรป) | ในสหภาพยุโรป ข้อความที่สร้างโดย ChatGPT จะมีการปรับกระบวนการสุ่มที่โมเดลใช้เลือกคำในลักษณะที่มองไม่เห็น เพื่อปฏิบัติตามกฎหมาย AI ของสหภาพยุโรป ลูกค้า API ทั่วโลกสามารถเปิดใช้การฝังลายน้ำในผลลัพธ์ข้อความได้จากการตั้งค่าโปรเจกต์หรือองค์กร ดูข้อมูลเพิ่มเติม |
| วิดีโอ | ไม่เกี่ยวข้อง | ไม่เกี่ยวข้อง | Sora ยุติการให้บริการแล้วดูข้อมูลเพิ่มเติม |
| ไฟล์ PDF | PDF (.pdf) | Content Credentials (เมทาดาทา C2PA) | ไฟล์ PDF ที่ส่งออกจากเครื่องมือของ OpenAI ที่รองรับจะมีเมทาดาทา C2PA ฝังอยู่ในไฟล์ |
ขอบเขตการรองรับอาจแตกต่างกันไปตามผลิตภัณฑ์ โมเดล วิธีการส่งออก ประเภทไฟล์ และเวลาที่สร้างเนื้อหา ครอบคลุมผลลัพธ์จาก API ยกเว้นโมเดลที่มีแผนจะเลิกใช้งานในเร็วๆ นี้ ซึ่งรวมถึง gpt-image-1, gpt-image-1.5 และ sora-2
ทำไมเนื้อหาบางประเภทจึงใช้สัญญาณหลายชนิด?
เมื่อทำได้ในทางเทคนิค OpenAI จะใช้เมทาดาทาและลายน้ำร่วมกัน เพื่อให้แต่ละวิธีช่วยชดเชยข้อจำกัดของอีกวิธี เมทาดาทาเก็บข้อมูลได้ละเอียด แต่แพลตฟอร์ม เครื่องมือแก้ไข และการแปลงไฟล์อาจลบข้อมูลนี้ออก ลายน้ำให้ข้อมูลบริบทน้อยกว่า แต่เนื่องจากฝังอยู่ในตัวเนื้อหาที่สร้างขึ้น จึงอาจยังคงอยู่หลังการดัดแปลงบางอย่างที่ทำให้เมทาดาทาถูกลบออก
สัญญาณระบุที่มาทนต่อการดัดแปลงเนื้อหาได้มากเพียงใด?
ลายน้ำ SynthID สำหรับรูปภาพและเสียง และลายน้ำ textGrain สำหรับข้อความ ออกแบบมาให้ทนต่อการเปลี่ยนแปลงที่พบบ่อย การเปลี่ยนแปลงเหล่านี้อาจรวมถึงการแก้ไขเล็กน้อย การคัดลอกและวาง การครอบตัด หรือการจับภาพหน้าจอ ขึ้นอยู่กับประเภทเนื้อหา การเปลี่ยนแปลงที่มากกว่านั้น เช่น การครอบตัดภาพออกเป็นส่วนใหญ่ การบีบอัดไฟล์ การเรียบเรียงข้อความใหม่อย่างมาก หรือการแปล อาจทำให้ตรวจไม่พบลายน้ำ หลังจากมีการเปลี่ยนแปลงอย่างมาก การอธิบายว่าผลลัพธ์นั้น “สร้างโดย OpenAI” ก็อาจสื่อความหมายได้น้อยลงเช่นกัน
Content Credentials ซึ่งพัฒนาโดย แนวร่วมเพื่อที่มาและความแท้จริงของเนื้อหา อาจสูญหายไปจากการใช้งานทั่วไป เช่น การจับภาพหน้าจอหรือการแปลงไฟล์ หากข้อมูลเหล่านี้ยังคงอยู่ ก็จะให้รายละเอียดเกี่ยวกับแหล่งที่มาและประวัติของไฟล์ได้มากกว่าลายน้ำเพียงอย่างเดียว
หากทำได้ในทางเทคนิค เราจะใช้ทั้งสองวิธีเพื่อเพิ่มโอกาสที่ข้อมูลระบุที่มาจะยังคงอยู่หลังจากเนื้อหาถูกเปลี่ยนแปลง
Content Credentials คืออะไร และช่วยทำอะไรได้บ้าง?
Content Credentials แนบข้อมูลแหล่งที่มาและประวัติของไฟล์ เช่น สร้างด้วยเครื่องมือใดและเมื่อใด Content Credentials ใช้มาตรฐานเปิดที่พัฒนาโดยกลุ่มพันธมิตรเพื่อแหล่งที่มาและความแท้จริงของเนื้อหา (C2PA) จึงมีชื่อเรียกอีกอย่างว่า “เมทาดาทา C2PA”
Content Credentials ช่วยให้ผู้คนตรวจสอบได้ว่าเนื้อหามาจากที่ใด การใช้งานไม่ได้จำกัดอยู่แค่เนื้อหาที่สร้างโดย AI เท่านั้น ผู้ผลิตกล้อง องค์กรข่าว และหน่วยงานอื่นๆ ก็ใช้มาตรฐานนี้เพื่อรับรองแหล่งที่มาและประวัติของสื่อเช่นกัน ดูข้อมูลเพิ่มเติมเกี่ยวกับ C2PA
SynthID คืออะไร และช่วยทำอะไรได้บ้าง?
SynthID คือเทคโนโลยีใส่ลายน้ำที่มองไม่เห็น ซึ่งพัฒนาโดย Google DeepMind โดยฝังสัญญาณลงในสื่อที่สร้างขึ้นโดยตรง สัญญาณนี้ต่างจากเมทาดาทาตรงที่เป็นส่วนหนึ่งของตัวเนื้อหา และอาจคงอยู่หลังการแก้ไขหรือดัดแปลงบางอย่าง SynthID เพิ่มสัญญาณระบุแหล่งที่มาควบคู่ไปกับเมทาดาทา C2PA ตัวอย่างเช่น หากเมทาดาทาถูกลบออกจากไฟล์ ลายน้ำที่ฝังอยู่อาจยังเป็นสัญญาณบ่งชี้ว่าเนื้อหานั้นสร้างด้วยเครื่องมือของ OpenAI ที่รองรับ ดูข้อมูลเพิ่มเติมเกี่ยวกับ SynthID
ทำไมจึงฝังลายน้ำในผลลัพธ์ข้อความ?
เรากำลังนำการฝังลายน้ำในข้อความมาใช้กับผู้ใช้ ChatGPT ในสหภาพยุโรป เพื่อปฏิบัติตามกฎหมาย AI ของสหภาพยุโรป และให้สอดคล้องกับพันธสัญญาของเราภายใต้หลักปฏิบัติของสหภาพยุโรปว่าด้วยความโปร่งใสของเนื้อหาที่สร้างโดย AI ซึ่ง OpenAI และผู้ให้บริการ AI รายใหญ่รายอื่นๆ หลายรายได้ลงนามไว้
textGrain คืออะไรและทำอะไรได้บ้าง?
textGrain คือเทคโนโลยีฝังลายน้ำในข้อความของ OpenAI เทคโนโลยีนี้ปรับวิธีที่โมเดลสุ่มเลือกคำหรือส่วนของคำที่เป็นไปได้ขณะเขียนเพียงเล็กน้อย เมื่อพิจารณาข้อความทั้งช่วง การเลือกเหล่านี้จะเกิดเป็นรูปแบบที่เครื่องมือตรวจจับสามารถค้นหาได้ แม้ข้อความจะผ่านการแก้ไขมาบ้าง
ลายน้ำเป็นส่วนหนึ่งของถ้อยคำในข้อความ และผู้อ่านไม่สามารถมองเห็นได้ เทคโนโลยีนี้ไม่ได้เพิ่มอักขระที่ซ่อนอยู่ ช่องว่างที่มองไม่เห็น หรือเครื่องหมายวรรคตอนที่ผิดปกติ การฝังลายน้ำในข้อความช่วยให้ปฏิบัติตามข้อกำหนดของกฎหมาย AI ของสหภาพยุโรป (EU AI Act) ที่ให้ทำเครื่องหมายระบุข้อความที่สร้างขึ้น
ดูรายละเอียดเพิ่มเติมเกี่ยวกับการทำงานของ textGrain ได้ใน รายงานทางเทคนิคของเรา
เครื่องมือตรวจสอบของ OpenAI
ฉันจะตรวจสอบได้อย่างไรว่าเนื้อหาผ่านการประมวลผลด้วยเครื่องมือของ OpenAI หรือไม่?
คุณสามารถไปที่ openai.com/verify เพื่อตรวจสอบว่ารูปภาพ ไฟล์เสียง หรือ PDF ที่รองรับมีสัญญาณระบุที่มาที่เกี่ยวข้องกับเนื้อหาซึ่งผ่านการประมวลผลด้วยเครื่องมือของ OpenAI หรือไม่ หลังจากคุณอัปโหลดไฟล์ที่รองรับ เครื่องมือจะค้นหาสัญญาณระบุที่มาของ OpenAI ที่รองรับ เช่น ลายน้ำ SynthID หรือไฟล์ manifest ของ C2PA ที่เชื่อถือได้และเกี่ยวข้องกับ OpenAI หากเครื่องมือพบสัญญาณระบุที่มาของ OpenAI ที่รองรับ นั่นบ่งชี้ว่าเนื้อหาน่าจะผ่านการประมวลผลด้วยเครื่องมือของ OpenAI
นักพัฒนาและองค์กรยังสามารถใช้ API ตรวจสอบที่มาของเนื้อหาของ OpenAI เพื่อตรวจหาสัญญาณระบุที่มาของ OpenAI ในรูปภาพ เสียง และ PDF และผสานการตรวจสอบเข้ากับแอปพลิเคชันหรือเวิร์กโฟลว์ของตนเอง องค์กรที่มีกรณีการใช้งานตรงตามเกณฑ์สามารถ ยื่นคำขอเพิ่มขีดจำกัดการใช้งานได้
สำหรับข้อความ เพื่อให้สอดคล้องกับหน้าที่ของเราตามกฎหมาย AI ของสหภาพยุโรป องค์กรที่มีกรณีการใช้งานตรงตามเกณฑ์ เช่น สถาบันวิจัย สถาบันการศึกษา และสถาบันลักษณะเดียวกันที่ศึกษาที่มาของข้อความ ความน่าเชื่อถือของการตรวจจับ หรือวิธีที่ผู้คนทำความเข้าใจผลการตรวจสอบที่มา สามารถ ยื่นคำขอเข้าถึงเครื่องมือตรวจจับข้อความได้ เราจะพิจารณาคำขอจากองค์กรที่มีคุณสมบัติตรงตามเกณฑ์เป็นรายกรณี และติดต่อกลับเพื่อแจ้งความคืบหน้าหรือขอข้อมูลเพิ่มเติมตามความเหมาะสม แนวทางการให้สิทธิ์เข้าถึงของเราอาจเปลี่ยนแปลงไปเมื่อเราเรียนรู้เพิ่มเติมและปรับปรุงเทคโนโลยี
ขณะนี้เรากำลังร่วมมือกับนักวิจัยกลุ่มเล็กๆ ซึ่งรวมถึง John Thickstun ผู้ช่วยศาสตราจารย์ด้านวิทยาการคอมพิวเตอร์แห่งมหาวิทยาลัยคอร์เนลล์, Martin Vechev ศาสตราจารย์ด้านวิทยาการคอมพิวเตอร์แห่ง ETH Zurich และผู้อำนวยการฝ่ายวิทยาศาสตร์ของ INSAIT ตลอดจนนักวิจัยจากสถาบันเทคโนโลยีอัจฉริยะเคมเปเลน (KInIT) เพื่อทำความเข้าใจความสามารถและข้อจำกัดของเทคโนโลยีให้ดียิ่งขึ้น และนำข้อมูลไปใช้ปรับปรุงการฝังลายน้ำในข้อความ.
ใครมีสิทธิ์ได้รับขีดจำกัดการตรวจสอบที่สูงขึ้น และการตรวจสอบมีค่าใช้จ่ายหรือไม่?
ขณะนี้การตรวจสอบผ่าน Content Provenance API ไม่มีค่าใช้จ่ายและมีขีดจำกัดการใช้งาน โครงการเพิ่มขีดจำกัดมุ่งเน้นโครงการตรวจสอบแหล่งที่มาเพื่อประโยชน์สาธารณะและกระบวนการรักษาความน่าเชื่อถือของข้อมูลที่เข้าเกณฑ์ เช่น การตรวจสอบในกองบรรณาธิการข่าว การตรวจสอบข้อเท็จจริง การวิจัยแหล่งที่มาของเนื้อหา และการกำกับดูแลตามกฎหมาย
การใช้งานทางธุรกิจทั่วไปยังไม่อยู่ในขอบเขตของโครงการในขณะนี้ เช่น การป้องกันการฉ้อโกง การพิสูจน์ความแท้จริง และการตรวจสอบในเชิงพาณิชย์ หรือการนำไปขายต่อเป็นส่วนหนึ่งของแพ็กเกจบริการตรวจสอบแหล่งที่มาและวิเคราะห์ข้อมูล
องค์กรที่มีกรณีการใช้งานตรงตามเกณฑ์สามารถยื่นคำขอเพิ่มขีดจำกัดได้ แต่การยื่นคำขอไม่ได้รับประกันว่าจะได้รับอนุมัติ API สาธารณะยังคงเปิดให้ใช้งานภายใต้ขีดจำกัดเริ่มต้น รวมถึงการประเมินขนาดเล็ก ดูขีดจำกัดการใช้งานปัจจุบันได้ในเอกสารประกอบ Content Provenance API
ใครมีสิทธิ์เข้าถึงเครื่องมือตรวจจับข้อความ และการตรวจสอบมีค่าใช้จ่ายหรือไม่?
ปัจจุบันการตรวจสอบด้วยเครื่องมือตรวจจับข้อความไม่มีค่าใช้จ่าย ผู้ที่มีสิทธิ์ยื่นคำขอ ได้แก่ สถาบันวิจัย สถาบันการศึกษา และสถาบันลักษณะเดียวกันที่ศึกษาที่มาของข้อความ ความน่าเชื่อถือของการตรวจจับ หรือวิธีที่ผู้คนทำความเข้าใจผลการตรวจสอบที่มา ปัจจุบันคำขอประเภทอื่นยังอยู่นอกขอบเขตของโครงการ
ผลการตรวจสอบหมายความว่าอย่างไร?
หากตรวจพบสัญญาณผ่าน openai.com/verify หรือ API ตรวจสอบที่มาของเนื้อหาของ OpenAI แสดงว่าเนื้อหาที่อัปโหลดมีสัญญาณระบุที่มาที่รองรับซึ่งเกี่ยวข้องกับ OpenAI สิ่งนี้บ่งชี้ว่าเนื้อหาผ่านการประมวลผลด้วยเครื่องมือของ OpenAI แต่สัญญาณเพียงอย่างเดียวไม่ได้บอกว่าเนื้อหาถูกสร้างหรือแก้ไขด้วยเครื่องมือของ OpenAI หรือไม่ หรือมากน้อยเพียงใด เครื่องมือนี้ไม่ได้ยืนยันว่าเนื้อหาถูกต้อง ไม่เคยผ่านการแก้ไข มีการถือครองสิทธิ์อย่างถูกกฎหมาย หรือนำเสนอในบริบทที่ถูกต้อง นอกจากนี้ยังไม่ได้ระบุว่าใครเป็นผู้สร้างเนื้อหาหรือสร้างขึ้นด้วยเหตุใด
หากตรวจไม่พบสัญญาณ แสดงว่าเครื่องมือไม่พบสัญญาณระบุที่มาที่ออกโดย OpenAI ในไฟล์ที่อัปโหลด เนื้อหานั้นอาจยังเคยผ่านการประมวลผลโดย OpenAI หาก:
เนื้อหาถูกสร้างขึ้นก่อนที่จะมีการใช้สัญญาณระบุที่มา
เนื้อหามาจากผลิตภัณฑ์ โมเดล วิธีการส่งออก หรือประเภทไฟล์ที่ไม่รองรับ
เมทาดาทาถูกลบออกระหว่างการอัปโหลด ดาวน์โหลด แก้ไข แปลง หรือแชร์
สัญญาณลายน้ำเสื่อมลงจากการบีบอัด การครอบตัด สัญญาณรบกวน การแก้ไข การแปลงรูปแบบ หรือการดัดแปลงอื่นๆ
คลิปเสียงสั้นเกินไปหรือถูกดัดแปลงอย่างมาก
ฉันจะทำอย่างไรให้ได้ผลการตรวจสอบที่น่าเชื่อถือที่สุด?
อัปโหลดไฟล์ที่รองรับครั้งละหนึ่งไฟล์ และใช้ไฟล์ต้นฉบับที่ส่งออกมาเมื่อทำได้ สำหรับภาพ ให้หลีกเลี่ยงการครอบตัดหรือแปลงไฟล์ก่อนตรวจสอบ สำหรับเสียง โดยทั่วไปคลิปที่มีความยาว 10 ถึง 60 วินาทีจะให้ผลลัพธ์ดีที่สุด แม้จะตรวจไม่พบสัญญาณ ก็ควรพิจารณาแหล่งที่มาและบริบทของไฟล์ก่อนสรุปผล
ผลลัพธ์แสดงพรอมต์หรือข้อมูลส่วนบุคคลของฉันหรือไม่?
สัญญาณระบุแหล่งที่มาไม่มีรายละเอียดเกี่ยวกับผู้ใช้ องค์กร หรือพรอมต์
เนื้อหาที่ฉันตรวจสอบผ่าน openai.com/verify หรือ Content Provenance API จะถูกนำไปทำอะไรบ้าง?
เนื้อหาที่อัปโหลดไปยัง openai.com/verify หรือส่งไปตรวจสอบผ่าน Content Provenance API ของเรา จะถูกประมวลผลเพื่อตรวจหาสัญญาณระบุแหล่งที่มาที่รองรับเท่านั้น เราจะไม่จัดเก็บเนื้อหา เว้นแต่กฎหมายกำหนด และจะไม่นำเนื้อหาไปใช้ฝึกโมเดลของ OpenAI
OpenAI ตรวจจับเนื้อหาที่สร้างด้วยเครื่องมือ AI อื่นๆ ได้หรือไม่?
เครื่องมือตรวจสอบแหล่งที่มาของเนื้อหาของเราออกแบบมาเพื่อตรวจจับสัญญาณระบุแหล่งที่มาที่รองรับ ซึ่งเชื่อมโยงกับเนื้อหาที่สร้างโดยโมเดลของ OpenAI หรือส่งออกโดยเครื่องมือของ OpenAI เครื่องมือเหล่านี้ไม่ได้ออกแบบมาเพื่อตรวจจับเนื้อหาที่สร้างโดยโมเดล AI อื่นๆ และอาจตรวจไม่พบเนื้อหาที่สร้างโดย OpenAI เช่นกัน หากสัญญาณที่เกี่ยวข้องหายไป ไม่รองรับ หรือเสื่อมสภาพ
การใส่ลายน้ำทำงานอย่างไร
ลายน้ำใช้ตัดสินความเป็นผู้สร้าง ความเป็นเจ้าของ หรือความรับผิดชอบทางกฎหมายได้หรือไม่?
ไม่ได้ ลายน้ำเป็นหลักฐานว่าเนื้อหาน่าจะผ่านการสร้างหรือประมวลผลโดยโมเดลของ OpenAI ลายน้ำเพียงอย่างเดียวไม่สามารถยืนยันได้ว่าใครสร้างหรือเป็นเจ้าของเนื้อหา ต้องเปิดเผยข้อมูลหรือไม่ หรือใครเป็นผู้รับผิดชอบตามกฎหมาย และไม่ได้บอกว่าโมเดลกำลังแก้ไขเนื้อหาที่ผู้ใช้อัปโหลดมาหรือไม่
ลายน้ำบอกได้หรือไม่ว่าโมเดลของ OpenAI มีส่วนเกี่ยวข้องมากน้อยเพียงใด?
ไม่ได้ เครื่องมือตรวจจับจะรายงานว่าพบลายน้ำหรือไม่ การพบลายน้ำเป็นหลักฐานว่าเนื้อหาน่าจะผ่านการสร้างหรือประมวลผลโดยโมเดลของ OpenAI แต่ไม่ได้แสดงว่าโมเดลสร้างเนื้อหาบางส่วนหรือทั้งหมด หรือมนุษย์มีส่วนร่วมมากน้อยเพียงใด
การใส่ลายน้ำข้อความทำงานอย่างไร?
การใส่ลายน้ำข้อความสร้างรูปแบบลับในการเลือกคำและส่วนของคำที่เรียกว่า “Token” ของโมเดลขณะเขียน
ในแต่ละขั้นตอน โมเดลจะกำหนดค่าความน่าจะเป็นให้กับ Token แต่ละตัวที่อาจตามมา ระบบใส่ลายน้ำจะสร้างชุดค่าความน่าจะเป็นที่ปรับแล้วหลายชุด โดยแต่ละชุดจะให้น้ำหนักกับตัวเลือกที่ต่างกันตามคีย์ลับ ชุดค่าเหล่านี้จะถูกปรับให้สมดุลกัน เพื่อให้เมื่อนำมาเฉลี่ยรวมกันแล้วจะตรงกับค่าความน่าจะเป็นเดิมของโมเดล คีย์จะกำหนดว่าจะใช้ชุดใด จากนั้นโมเดลจะสุ่มเลือกใหม่จากชุดนั้น
เครื่องมือตรวจจับที่มีคีย์เดียวกันและการตั้งค่าที่ตรงกันจะตรวจสอบในภายหลังได้ว่า ข้อความเป็นไปตามรูปแบบลับบ่อยกว่าที่คาดว่าจะเกิดขึ้นโดยบังเอิญหรือไม่
ลายน้ำข้อความใช้กับข้อความข้อเท็จจริงและข้อความที่ผู้ใช้ให้มาด้วยหรือไม่?
การใส่ลายน้ำข้อความอาศัยการที่โมเดลมีวิธีสื่อความหมายเดียวกันได้หลายแบบ ความยืดหยุ่นนี้จะลดลงเมื่อคำตอบต้องตรงตามข้อเท็จจริงหรือแม่นยำมาก เช่น คำตอบของโจทย์คณิตศาสตร์ หรือเมื่อขอให้โมเดลแสดงข้อความที่ให้มาโดยไม่เปลี่ยนแปลง ในกรณีเหล่านี้ โมเดลมีทางเลือกน้อยลงในการปรับถ้อยคำโดยไม่ให้เกิดความแตกต่างที่สังเกตได้ จึงอาจตรวจไม่พบลายน้ำ
ลายน้ำข้อความใช้กับคำตอบสั้นๆ และโค้ดด้วยหรือไม่?
โดยทั่วไป ข้อความสั้นๆ มีความยาวไม่เพียงพอให้ตรวจจับลายน้ำได้อย่างน่าเชื่อถือ การใส่ลายน้ำในโค้ดก็ทำได้ยากกว่าเช่นกัน เพราะมีตัวเลือกที่เหมาะสมสำหรับส่วนที่จะเขียนต่อไปน้อยกว่าข้อความทั่วไป
เมื่อคำนึงถึงข้อจำกัดเหล่านี้ แนวปฏิบัติด้านความโปร่งใสของเนื้อหาที่สร้างโดย AI ภายใต้กฎหมาย AI ของสหภาพยุโรปจึงไม่กำหนดให้ใส่ลายน้ำในผลลัพธ์ที่สั้นกว่า 200 Token หรือประมาณ 150 คำในภาษาอังกฤษ รวมถึงในส่วนย่อยของโค้ด
การตรวจจับลายน้ำในข้อความแตกต่างกันอย่างไรในแต่ละภาษา?
อัตราการตรวจจับแตกต่างกันไปตามภาษา และปัจจุบันการตรวจจับในบางภาษาทำได้ง่ายกว่าภาษาอื่น เราสามารถปรับความเข้มของลายน้ำเพื่อเพิ่มประสิทธิภาพการตรวจจับในภาษาที่มีสัญญาณอ่อนกว่าได้
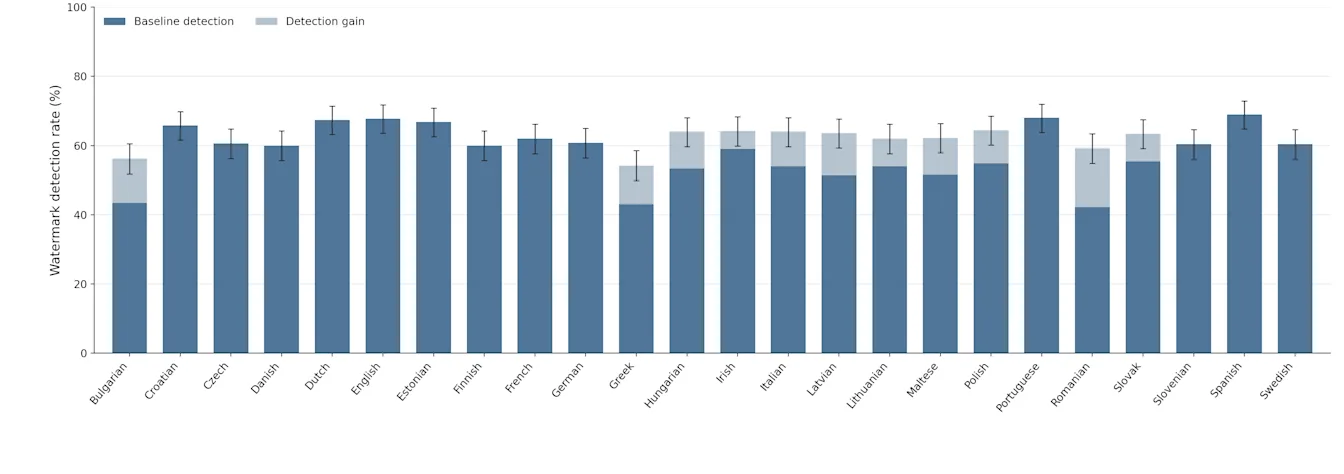
แผนภูมินี้แสดงการประเมินอัตราการตรวจจับในภาษาทางการทั้ง 24 ภาษาของสหภาพยุโรป เราเริ่มจากสร้างพรอมต์สังเคราะห์ภาษาอังกฤษ 500 รายการที่ครอบคลุมหัวข้อหลากหลาย แล้วแปลเป็นอีก 23 ภาษา ที่อัตราผลบวกลวง 1% ภาษาสเปนมีอัตราการตรวจจับสูงที่สุด (69.0%) ขณะที่ภาษาโรมาเนียมีอัตราต่ำที่สุด (42.2%) ลายน้ำของเรามีพารามิเตอร์ปรับความเข้ม ซึ่งเปรียบเสมือน “ปุ่มปรับ” ที่เพิ่มหรือลดความเข้มของสัญญาณลายน้ำให้เหมาะกับการใช้งานด้านต่างๆ การใช้ปุ่มปรับนี้ช่วยให้เราเพิ่มความเข้มสำหรับภาษาที่มีอัตราการตรวจจับต่ำกว่า 60% ได้ โดยส่วนสีฟ้าอ่อนของแท่งแผนภูมิแสดงอัตราการตรวจจับที่เพิ่มขึ้นจากการปรับดังกล่าว
ลายน้ำข้อความทำให้คุณภาพของโมเดลลดลงหรือไม่?
จากการทดสอบของเรา ไม่ได้ทำให้คุณภาพลดลง จากชุดทดสอบที่เราใช้ประเมิน Astra ซึ่งเป็นโมเดลระดับแนวหน้าล่าสุดของเรา ความแตกต่างด้านประสิทธิภาพระหว่างการใส่ลายน้ำกับไม่ใส่ลายน้ำอยู่ในช่วงความผันผวนที่เรามักพบระหว่างการประเมินแต่ละรอบ การทดสอบก่อนหน้านี้ใน ChatGPT ยังพบว่าการนำลายน้ำมาใช้ไม่ได้ทำให้อัตราการกดไม่ถูกใจหรือตัวชี้วัดผลิตภัณฑ์อื่นๆ เปลี่ยนแปลง
ลายน้ำข้อความทำให้โมเดลช้าลงหรือไม่?
การใส่ลายน้ำข้อความส่งผลต่อความเร็วของโมเดลของเราน้อยมากจนแทบไม่มีนัยสำคัญ
ลายน้ำในข้อความของ OpenAI ต่างจากเครื่องมือตรวจจับ AI ของบุคคลที่สามอย่างไร?
เครื่องมือตรวจจับของบุคคลที่สาม เช่น Pangram มักใช้ตัวจำแนกเพื่อระบุข้อความที่ AI สร้างจากรูปแบบต่างๆ เช่น การเลือกใช้คำ แนวทางดังกล่าววิเคราะห์ข้อความหลังจากสร้างเสร็จแล้ว แทนที่จะตรวจจับสัญญาณที่ฝังไว้ กฎหมาย AI ของสหภาพยุโรปกำหนดไว้อย่างชัดเจนว่าต้องฝังสัญญาณไว้ในข้อความที่สร้างขึ้น
ทำไมจึงใช้ลายน้ำข้อความของตนเองแทน TextSeal หรือ SynthID?
เราพัฒนาวิธีใส่ลายน้ำข้อความของเราเองที่ชื่อว่า textGrain เพื่อให้ควบคุมสมดุลระหว่างความสามารถในการตรวจจับลายน้ำกับความหลากหลายของคำตอบที่สร้างจากพรอมต์เดียวกันได้มากกว่า SynthID หรือ TextSeal ในการทดสอบของเรา วิธีนี้ระบุตัวอย่างข้อความที่มีลายน้ำได้ถูกต้องในสัดส่วนที่ใกล้เคียงหรือสูงกว่า SynthID สำหรับข้อความ เรามีแผนเผยแพร่ textGrain เป็นเทคโนโลยีโอเพนซอร์ส เพื่อให้ผู้อื่นนำไปต่อยอดและช่วยปรับปรุงการใส่ลายน้ำข้อความได้
การใส่ลายน้ำข้อความเพิ่มอักขระที่ซ่อนอยู่ Token พิเศษ หรือการเปลี่ยนแปลงที่มองเห็นได้หรือไม่?
ไม่ การใส่ลายน้ำข้อความเปลี่ยนรูปแบบทางสถิติของการเลือกคำ ไม่ได้แทรกอักขระที่ซ่อนอยู่หรือเพิ่ม Token ที่ใช้เพื่อลายน้ำโดยเฉพาะ ผู้อ่านมองไม่เห็นลายน้ำ และการคัดลอกแล้ววางข้อความก็ไม่ได้เพิ่มสิ่งที่ซ่อนอยู่ใดๆ
คำแนะนำสำหรับลูกค้า
ในฐานะลูกค้า API ฉันจะเปิดใช้ลายน้ำในข้อความได้อย่างไร?
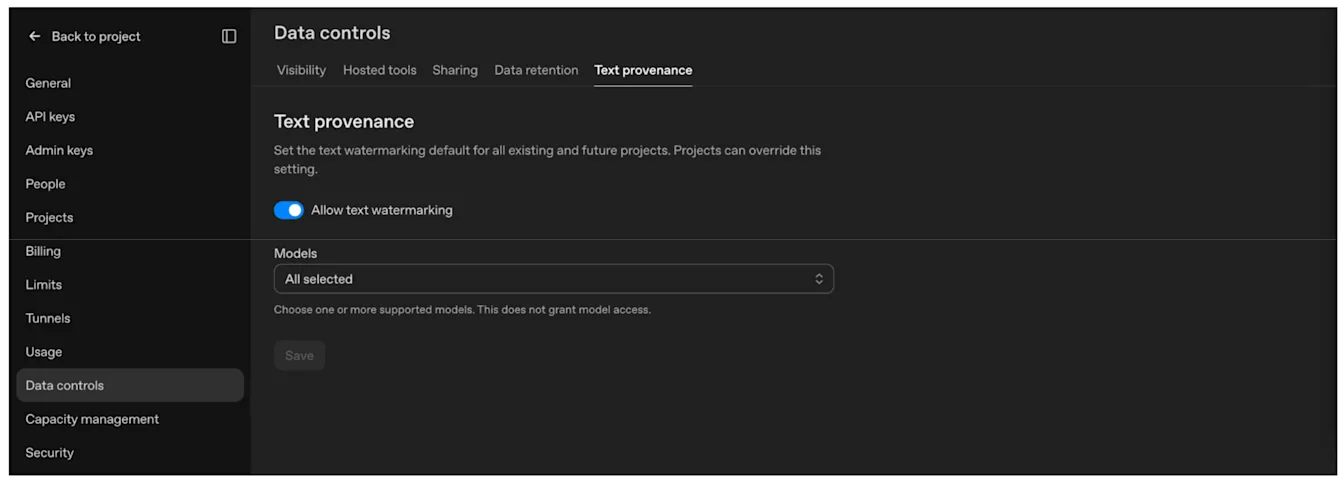
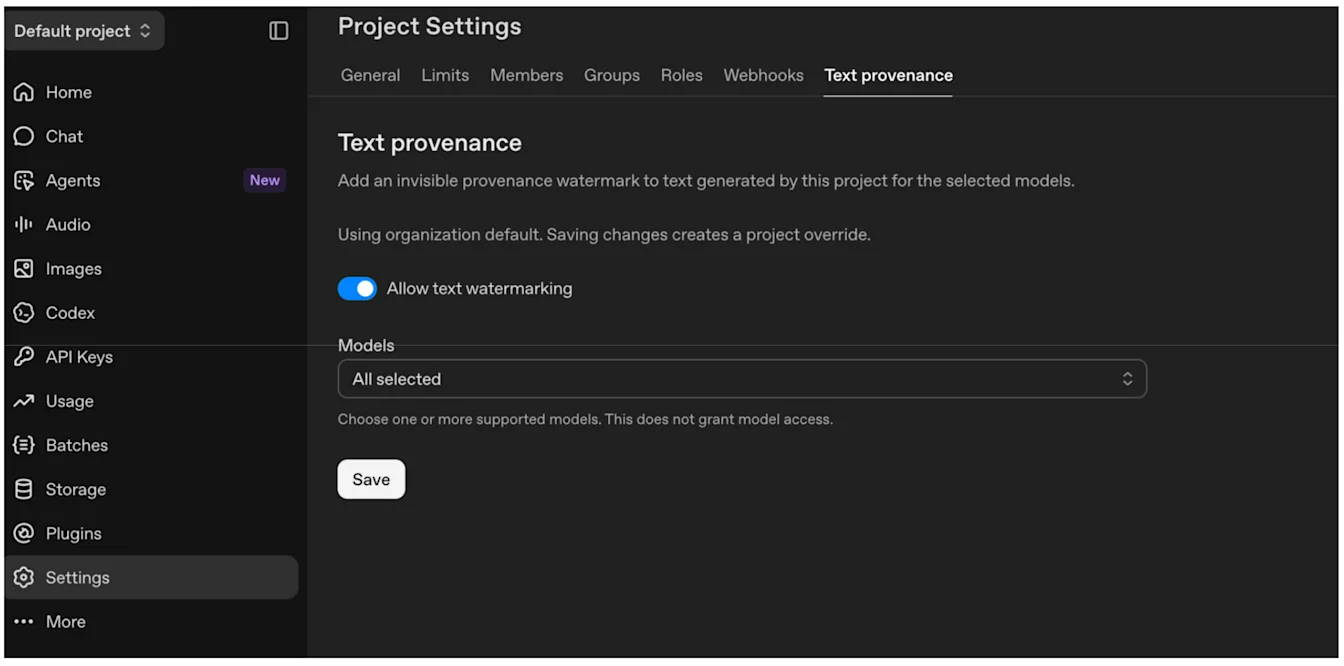
ลูกค้า OpenAI API สามารถเปิดใช้การฝังลายน้ำในข้อความสำหรับโปรเจกต์ที่ต้องการผ่าน การตั้งค่า หรือเปิดใช้กับทั้งองค์กรผ่าน การตั้งค่าองค์กร ในทั้งสองกรณี ลูกค้าสามารถเลือกได้ว่าจะให้ฝังลายน้ำในข้อความจากโมเดลใดบ้าง เมื่อคุณเปิดใช้การฝังลายน้ำในข้อความสำหรับโมเดลที่รองรับแล้ว OpenAI จะเพิ่มลายน้ำระหว่างการสร้างข้อความ ลูกค้าไม่จำเป็นต้องเพิ่มเครื่องหมายแยกต่างหากให้กับแต่ละคำตอบ
เปิดใช้ อนุญาตการฝังลายน้ำในข้อความ เลือกโมเดลของคุณ แล้วเลือก บันทึก
ค่าเริ่มต้นขององค์กร: ไปที่ การตั้งค่าองค์กร > การควบคุมข้อมูล
เลือก ที่มาของข้อความ
การตั้งค่าโปรเจกต์เพื่อแทนที่ค่าเริ่มต้น: ไปที่ การตั้งค่าโปรเจกต์ > ที่มาของข้อความ
ฉันเปิดใช้ลายน้ำกับโมเดลใดได้บ้าง?
ลูกค้าสามารถดูรายชื่อโมเดลที่รองรับการใส่ลายน้ำในปัจจุบันได้ที่การตั้งค่าและการตั้งค่าองค์กร ในช่วงไม่กี่สัปดาห์ข้างหน้า เราจะขยายการรองรับให้ครอบคลุมโมเดลรุ่นเก่าทั้งหมด
การเปิดใช้ลายน้ำข้อความทำให้ฉันได้สิทธิ์เข้าถึงเครื่องมือตรวจจับลายน้ำข้อความด้วยหรือไม่?
ไม่ ขณะนี้สิทธิ์เข้าถึงเครื่องมือตรวจจับลายน้ำข้อความจำกัดเฉพาะองค์กรวิจัยและวิชาการที่ได้รับอนุมัติ ซึ่งทำงานเพื่อปรับปรุงความน่าเชื่อถือและความสะดวกในการใช้ลายน้ำข้อความ รวมถึงความชัดเจนในการอธิบายเทคโนโลยีและผลลัพธ์ แนวทางนี้สอดคล้องกับพันธสัญญาของเราภายใต้แนวปฏิบัติด้านความโปร่งใสของเนื้อหาที่สร้างโดย AI ตามกฎหมาย AI ของสหภาพยุโรป
สัญญาณจะยังคงอยู่ในเนื้อหาหลังจากที่ฉันดัดแปลงเนื้อหาหรือไม่?
อาจยังคงอยู่ แต่ขึ้นอยู่กับสัญญาณและการเปลี่ยนแปลงที่คุณทำ
สำหรับภาพและเสียงที่รองรับ ให้เก็บสำเนาต้นฉบับไว้และใช้ Content Provenance API ทดสอบไฟล์ตัวอย่างที่เป็นตัวแทนของไฟล์ทั้งหมดหลังการแก้ไข แปลงไฟล์ และเผยแพร่ สำหรับภาพ การครอบตัด การเพิ่มสัญญาณรบกวน การแปลงเป็น JPEG และการจับภาพหน้าจออาจทำให้ตรวจจับสัญญาณได้ยากขึ้น คุณจะทดสอบข้อความด้วยวิธีนี้ได้ก็ต่อเมื่อองค์กรของคุณได้รับอนุมัติให้เข้าถึงเครื่องมือตรวจจับสำหรับข้อความแล้วเท่านั้น
หากรูปแบบไฟล์และเวิร์กโฟลว์ของคุณรองรับ ให้เก็บข้อมูลเมตา C2PA ที่มีอยู่ไว้ และใส่ Content Credentials ลงในไฟล์ที่คุณสร้าง คุณอาจพิจารณาเพิ่มเครื่องหมายของตนเอง เพื่อให้ข้อมูลแหล่งที่มาคงอยู่ได้นานขึ้นหรือมีประโยชน์มากขึ้น ดูรายละเอียดการนำไปใช้งานได้ในเอกสารทางเทคนิคของ C2PA
สำหรับข้อความ ลายน้ำเป็นส่วนหนึ่งของการเลือกใช้คำของโมเดล หากคุณคงถ้อยคำเดิมไว้ คาดว่าสัญญาณจะยังคงอยู่เมื่อนำข้อความไปใช้ซ้ำ โดยไม่ต้องผสานระบบเพิ่มเติม การเขียนใหม่อย่างมาก การถอดความ หรือการแปล อาจทำให้การตรวจจับน่าเชื่อถือน้อยลง แม้จะไม่เปลี่ยนถ้อยคำ ก็ไม่ได้รับประกันว่าจะตรวจจับลายน้ำได้ โดยเฉพาะในข้อความสั้นๆ หรือข้อความที่มีทางเลือกในการใช้คำไม่มากนัก
ฉันใช้งานโมเดลของ OpenAI ผ่านบริการคลาวด์ ผลลัพธ์เหล่านั้นมีสัญญาณระบุที่มาด้วยหรือไม่?
การฝังลายน้ำสำหรับโมเดลของ OpenAI ที่ให้บริการผ่าน Azure มีความครอบคลุมแตกต่างกันไปตามโมเดลและประเภทข้อมูล ติดต่อ Microsoft เพื่อสอบถามความพร้อมใช้งานและขอบเขตการรองรับในปัจจุบัน เรากำลังดำเนินการขยายการรองรับสัญญาณระบุที่มาให้ครอบคลุมผลลัพธ์ที่ส่งผ่านบริการคลาวด์อื่นๆ
สัญญาณระบุแหล่งที่มาใช้แทนป้ายกำกับ AI ที่มองเห็นได้หรือการเปิดเผยข้อมูลอื่นๆ ได้หรือไม่?
ไม่ได้ ลายน้ำและเมทาดาทา C2PA ให้ข้อมูลที่ซอฟต์แวร์อ่านได้ แต่ไม่ได้ใช้แทนป้ายกำกับ แบนเนอร์ หรือประกาศอื่นๆ ที่มองเห็นได้ ซึ่งอาจเป็นสิ่งที่ต้องมีตามข้อกำหนด
คุณจำเป็นต้องเปิดเผยข้อมูลเพิ่มเติมหรือไม่ ขึ้นอยู่กับวิธีและช่องทางที่คุณใช้เนื้อหานั้น OpenAI ไม่สามารถให้คำแนะนำเกี่ยวกับภาระหน้าที่ทางกฎหมายเฉพาะของคุณได้ ทีมกฎหมายของคุณควรประเมินข้อกำหนดที่เกี่ยวข้องกับการใช้งานของคุณ
ฉันมีคำถามเพิ่มเติมเกี่ยวกับกฎหมาย AI ของสหภาพยุโรป
โปรดส่ง คำถามเกี่ยวกับกฎหมาย AI ของสหภาพยุโรป แล้วเราจะติดต่อกลับ