
مصنوعی ذہانت کے زیادہ محفوظ اور شفاف ماحول کے عزم کے تحت، OpenAI ماخذ کی نشانیاں استعمال کرتا ہے تاکہ لوگوں کو یہ سمجھنے میں مدد ملے کہ آیا مواد OpenAI کے کسی ماڈل سے تیار کیا گیا تھا.
ماخذ کی نشانیاں مواد کی ابتدا کے بارے میں مفید معلومات دے سکتی ہیں، لیکن یہ ضمانت نہیں دیتیں کہ مواد درست ہے، اس میں ترمیم نہیں ہوئی، اس کی ملکیت قانونی ہے، یا اسے صحیح سیاق و سباق میں پیش کیا گیا ہے.
OpenAI کے ماخذ کی نشانیاں
OpenAI ماخذ کی کون سی نشانیاں استعمال کرتا ہے.
OpenAI مواد کی مختلف اقسام کے لیے ماخذ کی مختلف نشانیاں استعمال کرتا ہے.
| مواد کی قسم | ماخذ کی نشانیاں | نوٹس |
|---|---|---|
| تصاویر | مواد کی اسناد اور SynthID واٹرمارک | ChatGPT، Codex یا OpenAI کی اے پی آئی سے تیار کردہ تصاویر میں دونوں نشانیاں شامل ہوتی ہیں. |
| آڈیو | SynthID واٹرمارک | ChatGPT یا OpenAI کی اے پی آئی سے تیار کردہ آڈیو میں ایک ایسا واٹرمارک شامل ہوتا ہے جو سنائی نہیں دیتا اور خود آڈیو کا حصہ ہوتا ہے. |
| متن | textGrain واٹرمارک (صرف یورپی یونین میں) | یورپی یونین میں، مصنوعی ذہانت کے قانون کی تعمیل کے لیے، ChatGPT کے تیار کردہ متن میں ماڈل کے انتخابِ الفاظ کی بے ترتیبی میں ایک غیر مرئی تبدیلی شامل ہوتی ہے. دنیا بھر میں اے پی آئی کے صارفین اپنے منصوبے یا ادارے کی ترتیبات سے تیار کردہ متن کے لیے متنی واٹرمارک فعال کر سکتے ہیں. |
| ویڈیو | مواد کی اسناد | Sora بند کر دیا گیا ہے. مزید جانیں. |
اس سہولت کی دستیابی، پروڈکٹ، ماڈل، برآمد کے طریقے، فائل کی قسم اور مواد کی تیاری کے وقت کے لحاظ سے مختلف ہو سکتی ہے. اے پی آئی کے تیار کردہ مواد میں یہ سہولت شامل ہے، سوائے ان ماڈلز کے جنہیں جلد متروک کرنے کا منصوبہ ہے، جن میں gpt-image-1، gpt-image-1.5 اور sora-2 شامل ہیں.
مواد کی بعض اقسام میں متعدد نشانیاں کیوں استعمال ہوتی ہیں.
جہاں تکنیکی طور پر ممکن ہو، OpenAI میٹاڈیٹا اور واٹرمارک کو یکجا استعمال کرتا ہے تاکہ ہر ایک دوسرے کی حدود کی تلافی کر سکے. میٹاڈیٹا میں تفصیلی معلومات ہو سکتی ہیں، لیکن پلیٹ فارم، ترمیمی آلات اور فائل کی وضع میں تبدیلیاں اسے ہٹا سکتی ہیں. واٹرمارک میں سیاق و سباق کی معلومات کم ہوتی ہیں، لیکن چونکہ وہ خود تیار کردہ مواد میں شامل ہوتے ہیں، اس لیے میٹاڈیٹا کو ہٹا دینے والی بعض تبدیلیوں کے بعد بھی باقی رہ سکتے ہیں.
مواد میں تبدیلیوں کے مقابلے میں ماخذ کی نشانیاں کتنی پائیدار ہیں.
تصاویر اور آڈیو کے لیے SynthID واٹرمارک، اور متن کے لیے textGrain واٹرمارک، اس طرح بنائے گئے ہیں کہ عام تبدیلیوں کے باوجود برقرار رہیں. مواد کی قسم کے لحاظ سے ان تبدیلیوں میں معمولی ترامیم، نقل کر کے چسپاں کرنا، تراشنا یا اسکرین شاٹ لینا شامل ہو سکتا ہے. زیادہ بڑی تبدیلیاں—جیسے تصویر کو بہت زیادہ تراشنا، فائل کو سکیڑنا، بڑے پیمانے پر عبارت بدلنا یا ترجمہ کرنا—واٹرمارک کو ناقابلِ شناخت بنا سکتی ہیں. وسیع تبدیلیوں کے بعد حاصل ہونے والے مواد کو ”OpenAI کا تیار کردہ“ کہنا بھی کم بامعنی ہو سکتا ہے.
مواد کے ماخذ اور اصلیت کے اتحاد کی تیار کردہ مواد کی اسناد، اسکرین شاٹ لینے یا فائل کی وضع بدلنے جیسے روزمرہ کاموں میں ضائع ہو سکتی ہیں. اگر یہ برقرار رہیں تو اکیلے واٹرمارک کے مقابلے میں فائل کے ماخذ اور سابقہ مراحل کی زیادہ تفصیلات فراہم کر سکتی ہیں.
جہاں تکنیکی طور پر ممکن ہو، ہم دونوں طریقے استعمال کرتے ہیں تاکہ مواد میں تبدیلیوں کے بعد ماخذ کی معلومات کے محفوظ رہنے کا امکان زیادہ ہو.
مواد کی اسناد کیا ہیں اور ان سے کیا ممکن ہوتا ہے.
مواد کی اسناد کسی فائل کے ماخذ اور سابقہ مراحل کی معلومات اس کے ساتھ منسلک کرتی ہیں، مثلاً اسے کس آلے نے اور کب بنایا. یہ مواد کے ماخذ اور اصلیت کے اتحاد (C2PA) کے تیار کردہ کھلے معیار کو استعمال کرتی ہیں، اسی لیے انہیں کبھی کبھی ”C2PA میٹاڈیٹا“ کہا جاتا ہے.
مواد کی اسناد لوگوں کو یہ تصدیق کرنے میں مدد دیتی ہیں کہ مواد کہاں سے آیا ہے. ان کا استعمال صرف مصنوعی ذہانت سے تیار کردہ مواد تک محدود نہیں ہے: کیمرا بنانے والے، خبر رساں ادارے اور دیگر فریق بھی اپنے میڈیا کے ماخذ اور سابقہ مراحل کی تصدیق کے لیے یہ معیار استعمال کرتے ہیں. C2PA کے بارے میں مزید جانیں.
SynthID کیا ہے اور اس سے کیا ممکن ہوتا ہے.
SynthID، گوگل ڈیپ مائنڈ کی تیار کردہ پوشیدہ واٹرمارکنگ ٹیکنالوجی ہے، جو تیار کردہ میڈیا میں براہِ راست ایک نشانی شامل کرتی ہے. میٹاڈیٹا کے برعکس، یہ نشانی خود مواد کا حصہ ہوتی ہے اور کچھ ترامیم یا تبدیلیوں کے بعد بھی باقی رہ سکتی ہے. SynthID، C2PA میٹاڈیٹا کے ساتھ ماخذ کی ایک اضافی نشانی فراہم کرتا ہے. مثلاً، اگر کسی فائل سے میٹاڈیٹا ہٹا دیا جائے تو اس میں شامل واٹرمارک پھر بھی اس بات کی نشانی دے سکتا ہے کہ مواد OpenAI کے معاونت یافتہ آلات سے تیار کیا گیا تھا. SynthID کے بارے میں مزید جانیں.
آپ تیار کردہ متن میں واٹرمارک کیوں شامل کر رہے ہیں.
ہم یورپی یونین میں ChatGPT کے صارفین کے لیے متن میں واٹرمارک شامل کرنے کا طریقہ نافذ کر رہے ہیں، تاکہ یورپی یونین کے مصنوعی ذہانت کے قانون کی تعمیل ہو. یہ مصنوعی ذہانت سے تیار کردہ مواد کی شفافیت سے متعلق یورپی یونین کے ضابطۂ عمل کے تحت ہمارے وعدوں کے مطابق بھی ہے، جس پر OpenAI اور مصنوعی ذہانت کی سہولت فراہم کرنے والے کئی دیگر بڑے اداروں نے دستخط کیے ہیں.
textGrain کیا ہے اور اس سے کیا ممکن ہوتا ہے.
textGrain، OpenAI کی متن میں واٹرمارک شامل کرنے کی ٹیکنالوجی ہے. یہ لکھتے وقت ماڈل کے ممکنہ الفاظ یا لفظی اجزا میں سے بے ترتیب انتخاب کے طریقے میں معمولی تبدیلی کرتی ہے. پوری عبارت میں یہ انتخاب ایک ایسا نمونہ بناتے ہیں جسے شناختی آلہ کچھ ترمیم کے بعد بھی تلاش کر سکتا ہے.
واٹرمارک خود عبارت کا حصہ ہوتا ہے اور قارئین کو نظر نہیں آتا. یہ پوشیدہ حروف، نظر نہ آنے والی خالی جگہیں یا غیر معمولی رموزِ اوقاف شامل نہیں کرتی. متن میں واٹرمارک شامل کرنے سے یورپی یونین کے مصنوعی ذہانت کے قانون کی اس شرط کی تعمیل میں مدد ملتی ہے جس کے تحت تیار کردہ متن کو نشان زد کرنا ضروری ہے.
OpenAI کے تصدیقی آلات
میں کیسے جانچ سکتا ہوں کہ مواد OpenAI کے آلات سے تیار کیا گیا ہے.
آپ openai.com/verify پر جا کر جانچ سکتے ہیں کہ آیا معاونت یافتہ تصویر یا صوتی فائل میں ماخذ کی وہ نشانیاں موجود ہیں جو OpenAI کے آلات سے تیار یا برآمد کردہ مواد سے وابستہ ہیں. آپ کے معاونت یافتہ فائل اپ لوڈ کرنے کے بعد، یہ آلہ OpenAI کے ماخذ کی معاونت یافتہ نشانیاں تلاش کرے گا، مثلاً SynthID واٹرمارک یا OpenAI سے وابستہ معتبر C2PA مینفیسٹ. اگر آلے کو OpenAI کے ماخذ کی کوئی معاونت یافتہ نشانی ملتی ہے، تو اس سے ظاہر ہوتا ہے کہ مواد غالباً OpenAI کے کسی ماڈل نے تیار کیا تھا.
سافٹ ویئر بنانے والے اور ادارے تصاویر اور آڈیو میں OpenAI کے ماخذ کی نشانیاں جانچنے اور اپنی ایپلی کیشنز یا کام کے طریقوں میں تصدیق شامل کرنے کے لیے OpenAI کی مواد کے ماخذ کی اے پی آئی بھی استعمال کر سکتے ہیں. اہل مقصد کے لیے اسے استعمال کرنے والے ادارے زیادہ حدود کے لیے درخواست دے سکتے ہیں.
متن کے معاملے میں، یورپی یونین کے مصنوعی ذہانت کے قانون کے تحت اپنی ذمہ داریوں کے مطابق، ہم اہل مقاصد کے لیے کام کرنے والے اداروں کو متنی شناختی آلے تک رسائی کی درخواست دینے کی سہولت فراہم کرتے ہیں. ان میں متن کے ماخذ، شناخت کی قابلِ اعتماد کارکردگی، یا ماخذ سے متعلق نتائج کو لوگ کیسے سمجھتے ہیں، اس کا مطالعہ کرنے والے تعلیمی اور تحقیقی ادارے شامل ہیں. ہم اہل اداروں کی ہر درخواست کا الگ الگ جائزہ لیں گے اور حسبِ ضرورت تازہ معلومات دینے یا اضافی معلومات طلب کرنے کے لیے رابطہ کریں گے. مزید معلومات حاصل ہونے اور ٹیکنالوجی میں بہتری آنے کے ساتھ رسائی دینے کا ہمارا طریقہ بدل سکتا ہے.
ہم فی الحال محققین کے ایک محدود گروہ کے ساتھ مل کر کام کر رہے ہیں تاکہ اس ٹیکنالوجی کی صلاحیتوں اور حدود کو بہتر طور پر سمجھ سکیں اور متن میں واٹرمارک شامل کرنے کے طریقے کو بہتر بنا سکیں. ان میں کارنیل یونیورسٹی میں کمپیوٹر سائنس کے اسسٹنٹ پروفیسر جان تھکسٹن، ای ٹی ایچ زیورخ میں کمپیوٹر سائنس کے پروفیسر اور انسائٹ کے سائنسی ڈائریکٹر مارٹن ویچیف، اور کیمپلین انسٹی ٹیوٹ آف انٹیلیجنٹ ٹیکنالوجیز (کِنِٹ) کے محققین شامل ہیں.
تصدیق کی زیادہ حدود کا اہل کون ہے، اور کیا جانچ کے لیے فیس لی جاتی ہے.
مواد کے ماخذ کی اے پی آئی سے جانچ فی الحال مفت ہے اور استعمال کی حدود لاگو ہوتی ہیں. زیادہ حدود کا پروگرام مفادِ عامہ میں ماخذ سے متعلق اہل منصوبوں اور معلومات کی صحت برقرار رکھنے کے طریقۂ کار پر مرکوز ہے، جیسے خبرگاہوں میں تصدیق، حقائق کی جانچ، مواد کے ماخذ پر تحقیق اور ضابطہ جاتی نگرانی.
عام کاروباری استعمالات پروگرام کے دائرۂ کار سے فی الحال باہر ہیں، مثلاً تجارتی دھوکہ دہی کی روک تھام، توثیق اور تصدیق، یا ماخذ اور ڈیٹا کے تجزیے کی یکجا خدمات کے حصے کے طور پر دوبارہ فروخت.
اہل مقصد کے لیے اسے استعمال کرنے والے ادارے زیادہ حدود کے لیے درخواست دے سکتے ہیں، لیکن درخواست جمع کرانے سے منظوری کی ضمانت نہیں ملتی. عوامی اے پی آئی اپنی طے شدہ حدود کے تحت، چھوٹے پیمانے کے جائزوں سمیت، دستیاب رہتی ہے. استعمال کی موجودہ حدود کے لیے مواد کے ماخذ کی اے پی آئی کی دستاویزات دیکھیں.
متنی شناختی آلے تک رسائی کا اہل کون ہے، اور کیا جانچ کے لیے فیس لی جاتی ہے.
متنی شناختی آلے سے جانچ فی الحال مفت ہے. اہل استعمالات میں وہ تعلیمی اور تحقیقی ادارے شامل ہیں جو متن کے ماخذ، شناخت کی قابلِ اعتماد کارکردگی، یا ماخذ سے متعلق نتائج کو لوگ کیسے سمجھتے ہیں، اس کا مطالعہ کرتے ہیں.
عام کاروباری استعمالات پروگرام کے دائرۂ کار سے فی الحال باہر ہیں، مثلاً تجارتی دھوکہ دہی کی روک تھام، توثیق اور تصدیق، یا ماخذ اور ڈیٹا کے تجزیے کی یکجا خدمات کے حصے کے طور پر دوبارہ فروخت.
تعلیمی دیانت داری سے متعلق استعمالات، مثلاً طلبہ کے کام میں مصنوعی ذہانت کے استعمال کی جانچ (جیسے مضمون یا تحقیقی مقالہ لکھنے میں)، بھی پروگرام کے دائرۂ کار سے فی الحال باہر ہیں.
تصدیق کے نتائج کا کیا مطلب ہے.
اگر openai.com/verify یا OpenAI کی مواد کے ماخذ کی اے پی آئی کے ذریعے کوئی نشانی ملے، تو اس کا مطلب ہے کہ اپ لوڈ کردہ مواد میں OpenAI سے وابستہ ماخذ کی کوئی معاونت یافتہ نشانی موجود ہے. یہ آلہ اس بات کی تصدیق نہیں کرتا کہ مواد درست ہے، اس میں ترمیم نہیں ہوئی، اس کی ملکیت قانونی ہے، یا اسے صحیح سیاق و سباق میں پیش کیا گیا ہے. یہ بھی نہیں بتاتا کہ مواد کس نے یا کیوں تیار کیا تھا.
اگر کوئی نشانی نہ ملے، تو اس کا مطلب ہے کہ آلے کو اپ لوڈ کردہ فائل میں OpenAI کی جاری کردہ ماخذ کی نشانیاں نہیں ملیں. اس کے باوجود مواد OpenAI سے تیار یا برآمد کیا گیا ہو سکتا ہے، اگر:
مواد ماخذ کی نشانیاں دستیاب ہونے سے پہلے تیار کیا گیا تھا.
مواد کسی غیر معاونت یافتہ پروڈکٹ، ماڈل، برآمد کے طریقے یا فائل کی قسم سے حاصل ہوا تھا.
اپ لوڈ، ڈاؤن لوڈ، ترمیم، تبدیلیٔ وضع یا اشتراک کے دوران میٹاڈیٹا ہٹا دیا گیا تھا.
سکیڑنے، تراشنے، شور، ترامیم، وضع کی تبدیلی یا دیگر تبدیلیوں سے واٹرمارک کمزور ہو گیا تھا.
آڈیو کا حصہ بہت مختصر ہے یا اس میں نمایاں تبدیلی کی گئی ہے.
میں تصدیق کا سب سے قابلِ اعتماد نتیجہ کیسے حاصل کر سکتا ہوں.
ایک وقت میں ایک معاونت یافتہ فائل اپ لوڈ کریں اور جہاں ممکن ہو، اصل برآمد کردہ فائل استعمال کریں. تصاویر کی جانچ سے پہلے انہیں تراشنے یا ان کی فائل کی وضع تبدیل کرنے سے گریز کریں. آڈیو کے لیے، 10 سے 60 سیکنڈ کے دورانیے کے حصے عموماً بہترین نتائج دیتے ہیں. اگر کوئی نشانی نہ بھی ملے، تب بھی نتیجہ اخذ کرنے سے پہلے فائل کے ماخذ اور سیاق و سباق پر غور کریں.
کیا نتائج میں میرا پرومپٹ یا ذاتی معلومات دکھائی دیتی ہیں.
ماخذ کی نشانیوں میں صارف، ادارے یا پرومپٹ سے متعلق تفصیلات شامل نہیں ہوتیں.
میں جس مواد کی openai.com/verify یا مواد کے ماخذ کی اے پی آئی کے ذریعے تصدیق کرتا ہوں، اس کا کیا ہوتا ہے.
openai.com/verify پر اپ لوڈ کیے گئے یا تصدیق کے لیے ہماری مواد کے ماخذ کی اے پی آئی کو بھیجے گئے مواد پر صرف ماخذ کی معاونت یافتہ نشانیوں کی جانچ کے لیے کارروائی کی جاتی ہے. جب تک قانوناً ضروری نہ ہو، مواد محفوظ نہیں کیا جاتا اور اسے OpenAI کے ماڈلز کی تربیت کے لیے استعمال نہیں کیا جاتا.
کیا OpenAI مصنوعی ذہانت کے دیگر آلات سے تیار کردہ مواد کی شناخت کر سکتا ہے.
مواد کے ماخذ سے متعلق ہمارے آلات اس لیے بنائے گئے ہیں کہ OpenAI کے ماڈلز سے تیار کردہ یا OpenAI کے آلات سے برآمد کردہ مواد کے ماخذ کی معاونت یافتہ نشانیاں شناخت کر سکیں. یہ مصنوعی ذہانت کے دوسرے ماڈلز سے تیار کردہ مواد کی شناخت کے لیے نہیں بنائے گئے. متعلقہ نشانی غائب، غیر معاونت یافتہ یا کمزور ہو تو یہ OpenAI کے تیار کردہ مواد کی شناخت بھی نہیں کر پاتے.
واٹرمارک شامل کرنے کا طریقہ
کیا واٹرمارک تخلیق کار، ملکیت یا قانونی ذمہ داری کا تعین کرتے ہیں.
نہیں. واٹرمارک اس بات کا ثبوت ہے کہ غالباً OpenAI کے کسی ماڈل نے مواد تیار کیا یا اس پر کارروائی کی تھی. یہ اکیلا اس بات کا تعین نہیں کرتا کہ مواد کا تخلیق کار یا مالک کون ہے، آیا اس کے بارے میں انکشاف ضروری تھا، یا قانونی طور پر ذمہ دار کون ہے. یہ بھی نہیں بتاتا کہ آیا ماڈل صارف کے اپ لوڈ کردہ مواد میں ترمیم کر رہا تھا.
کیا واٹرمارک بتاتے ہیں کہ OpenAI کے ماڈل کا کتنا عمل دخل تھا.
نہیں. شناختی آلہ یہ بتاتا ہے کہ اسے واٹرمارک ملا یا نہیں. واٹرمارک ملنا اس بات کا ثبوت ہے کہ غالباً OpenAI کے کسی ماڈل نے مواد تیار کیا یا اس پر کارروائی کی تھی، لیکن یہ نہیں بتاتا کہ ماڈل نے کچھ مواد تیار کیا تھا یا پورا، یا کسی انسان کا کتنا حصہ تھا.
متن میں واٹرمارک شامل کرنے کا طریقہ کیسے کام کرتا ہے.
متن میں واٹرمارک شامل کرنے کا طریقہ، ماڈل کے لکھتے وقت الفاظ اور لفظی اجزا کے انتخاب میں ایک خفیہ نمونہ بناتا ہے. ان الفاظ اور اجزا کو ”ٹوکن“ کہا جاتا ہے.
ہر مرحلے پر، ماڈل ہر ممکنہ اگلے ٹوکن کے لیے ایک احتمال مقرر کرتا ہے. واٹرمارکنگ کا نظام ان احتمالات کے کئی تبدیل شدہ مجموعے بناتا ہے، جن میں سے ہر ایک خفیہ کلید کے مطابق مختلف انتخاب کو ترجیح دیتا ہے. ان مجموعوں میں ایسا توازن رکھا جاتا ہے کہ ان کا مجموعی اوسط ماڈل کے اصل احتمالات کے برابر ہو. کلید طے کرتی ہے کہ کون سا مجموعہ استعمال ہو گا، اور پھر ماڈل اس مجموعے سے ایک نیا بے ترتیب انتخاب کرتا ہے.
اسی کلید اور موافق ترتیبات والا شناختی آلہ بعد میں جانچ سکتا ہے کہ آیا متن اس خفیہ نمونے کی پیروی اتنی بار کرتا ہے جو محض اتفاق سے متوقع تعداد سے زیادہ ہو.
کیا متنی واٹرمارک حقائق پر مبنی متن اور صارف کے فراہم کردہ متن پر بھی لاگو ہوتے ہیں.
متن میں واٹرمارک شامل کرنے کا انحصار اس بات پر ہے کہ ماڈل کے پاس کسی بات کو کہنے کے مختلف طریقے ہوں. جب جواب کا مکمل طور پر حقائق پر مبنی یا بالکل درست ہونا ضروری ہو، جیسے ریاضی کے کسی مسئلے کا جواب، یا جب ماڈل سے فراہم کردہ متن کو بغیر تبدیلی کے دوبارہ پیش کرنے کو کہا جائے، تو گنجائش کم ہوتی ہے. ان صورتوں میں ماڈل کے پاس کسی نمایاں فرق کے بغیر اپنی عبارت بدلنے کی گنجائش کم ہوتی ہے، اس لیے ہو سکتا ہے کہ واٹرمارک کی شناخت نہ ہو سکے.
کیا متنی واٹرمارک مختصر جوابات اور کوڈ پر بھی لاگو ہوتے ہیں.
مختصر عبارتوں میں عموماً اتنا متن نہیں ہوتا کہ واٹرمارک کی قابلِ اعتماد شناخت ہو سکے. کوڈ میں بھی واٹرمارک شامل کرنا زیادہ مشکل ہوتا ہے، کیونکہ عام نثر کے مقابلے میں اس میں اگلے جزو کے لیے موزوں انتخاب کم ہوتے ہیں.
ان حدود کو مدنظر رکھتے ہوئے، یورپی یونین کے مصنوعی ذہانت کے قانون کے تحت مصنوعی ذہانت سے تیار کردہ مواد کی شفافیت سے متعلق ضابطۂ عمل میں 200 ٹوکن سے کم متن—یعنی انگریزی میں تقریباً 150 الفاظ—یا کوڈ کے ٹکڑوں میں واٹرمارک شامل کرنا لازمی نہیں ہے.
زبان کے لحاظ سے متنی واٹرمارک کی شناخت میں کیا فرق ہوتا ہے.
شناخت کی شرحیں زبان کے لحاظ سے مختلف ہوتی ہیں، اور فی الحال بعض زبانوں میں شناخت دوسری زبانوں کے مقابلے میں آسان ہے. جن زبانوں میں نشانی کمزور ہوتی ہے، ان میں شناخت بہتر بنانے کے لیے ہم واٹرمارک کی شدت بدل سکتے ہیں.
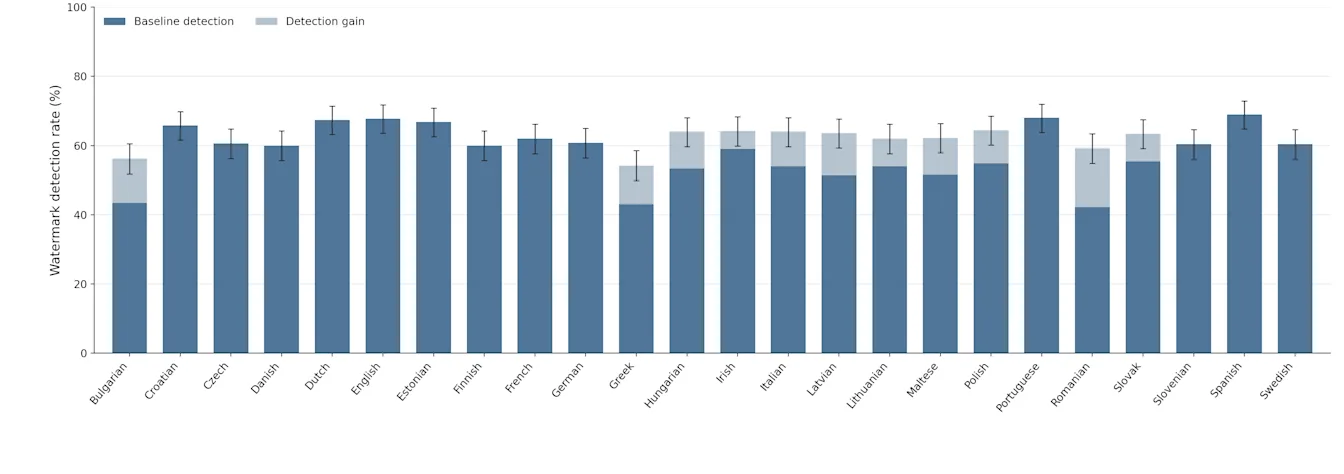
یہ چارٹ یورپی یونین کی تمام 24 سرکاری زبانوں میں شناخت کی شرح کا جائزہ پیش کرتا ہے. ہم نے پہلے مختلف موضوعات پر انگریزی میں 500 مصنوعی پرومپٹ تیار کیے، پھر ان کا دیگر 23 زبانوں میں ترجمہ کیا. غلط مثبت نتائج کی شرح 1% رکھنے پر، ہسپانوی میں شناخت کی شرح سب سے زیادہ (69.0%) اور رومانیائی میں سب سے کم (42.2%) ہے. ہمارے واٹرمارک میں شدت بدلنے کی ایک ترتیب ہے—ایک طرح کا ”کنٹرول“، جو مختلف شعبوں کے لیے واٹرمارک کی نشانی کو مضبوط یا کمزور کرتا ہے. اس کنٹرول کے ذریعے ہم ان زبانوں کے لیے شدت بڑھا سکے جن میں شناخت کی شرح 60% سے کم تھی؛ ستونوں کے ہلکے نیلے حصے اس سے حاصل ہونے والی بہتری دکھاتے ہیں.
کیا متنی واٹرمارک ماڈل کا معیار کم کرتے ہیں.
ہماری آزمائشوں کے مطابق، ایسا نہیں ہوتا. اپنے جدید ترین ماڈل Astra کا جائزہ لینے کے لیے ہم جو معیاری آزمائشیں استعمال کرتے ہیں، ان میں واٹرمارک کے ساتھ اور اس کے بغیر کارکردگی کا فرق اسی معمول کے اتار چڑھاؤ کی حد میں رہتا ہے جو مختلف جائزوں میں عموماً نظر آتا ہے. ChatGPT میں پہلے کی گئی آزمائشوں میں بھی واٹرمارک متعارف کرانے سے ناپسندیدگی کی شرح یا پروڈکٹ کے دیگر پیمانوں میں کوئی تبدیلی نہیں دیکھی گئی.
کیا متنی واٹرمارک ماڈل کی رفتار کم کرتے ہیں.
متن میں واٹرمارک شامل کرنے سے ہمارے ماڈلز کی رفتار پر نہ ہونے کے برابر اثر پڑتا ہے.
OpenAI کے متنی واٹرمارک، تیسرے فریق کے مصنوعی ذہانت کی شناخت کرنے والے آلات سے کیسے مختلف ہیں.
پینگرام جیسے تیسرے فریق کے شناختی آلات عموماً درجہ بندی کرنے والے نظام استعمال کرتے ہیں، جو انتخابِ الفاظ جیسے نمونوں کی بنیاد پر مصنوعی ذہانت سے تیار کردہ متن کی شناخت کرتے ہیں. اس طریقے میں کسی شامل شدہ نشانی کی شناخت کرنے کے بجائے متن تیار ہونے کے بعد اس کا تجزیہ کیا جاتا ہے. یورپی یونین کا مصنوعی ذہانت کا قانون خاص طور پر یہ لازم کرتا ہے کہ تیار کردہ متن میں ایک نشانی شامل ہو.
آپ TextSeal یا SynthID کے بجائے اپنے متنی واٹرمارک کیوں استعمال کر رہے ہیں.
ہم نے متن میں واٹرمارک شامل کرنے کا اپنا طریقہ textGrain تیار کیا ہے، تاکہ واٹرمارک کی شناخت پذیری اور ایک ہی پرومپٹ سے پیدا ہونے والے جوابات کے تنوع کے درمیان توازن پر ہمیں SynthID یا TextSeal کے مقابلے میں زیادہ اختیار حاصل ہو. ہماری آزمائشوں میں، ہمارے طریقے نے واٹرمارک والے متنی نمونوں کے اتنے ہی یا زیادہ تناسب کی درست شناخت کی، جتنے کی متن کے لیے SynthID نے کی. ہم textGrain کو کھلے ماخذ کی ٹیکنالوجی کے طور پر جاری کرنے کا ارادہ رکھتے ہیں تاکہ دوسرے اس کی بنیاد پر مزید کام کر سکیں اور متن میں واٹرمارک شامل کرنے کے طریقے کو بہتر بنانے میں مدد دے سکیں.
کیا متن میں واٹرمارک شامل کرنے سے پوشیدہ حروف، اضافی ٹوکن یا ظاہری تبدیلیاں شامل ہوتی ہیں.
نہیں. متنی واٹرمارک انتخابِ الفاظ کے شماریاتی نمونے کو بدلتا ہے؛ یہ پوشیدہ حروف یا صرف واٹرمارک کے لیے مخصوص ٹوکن شامل نہیں کرتا. واٹرمارک قارئین کو نظر نہیں آتا، اور متن کو نقل کر کے چسپاں کرنے سے کوئی پوشیدہ مواد شامل نہیں ہوتا.
صارفین کے لیے رہنمائی
میں اے پی آئی کا صارف ہوں، متنی واٹرمارک کیسے فعال کروں.
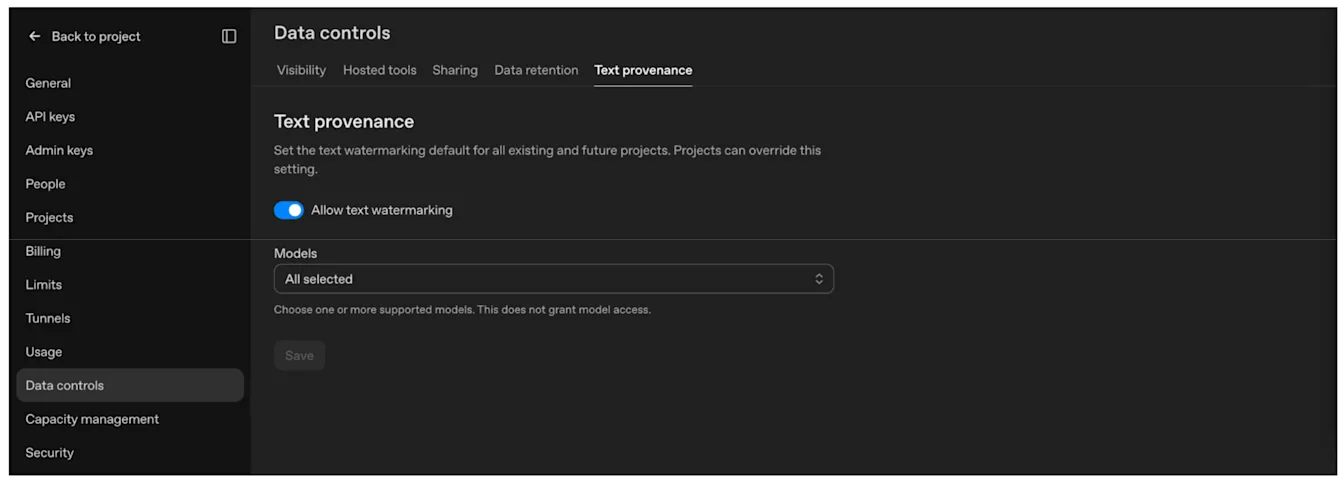
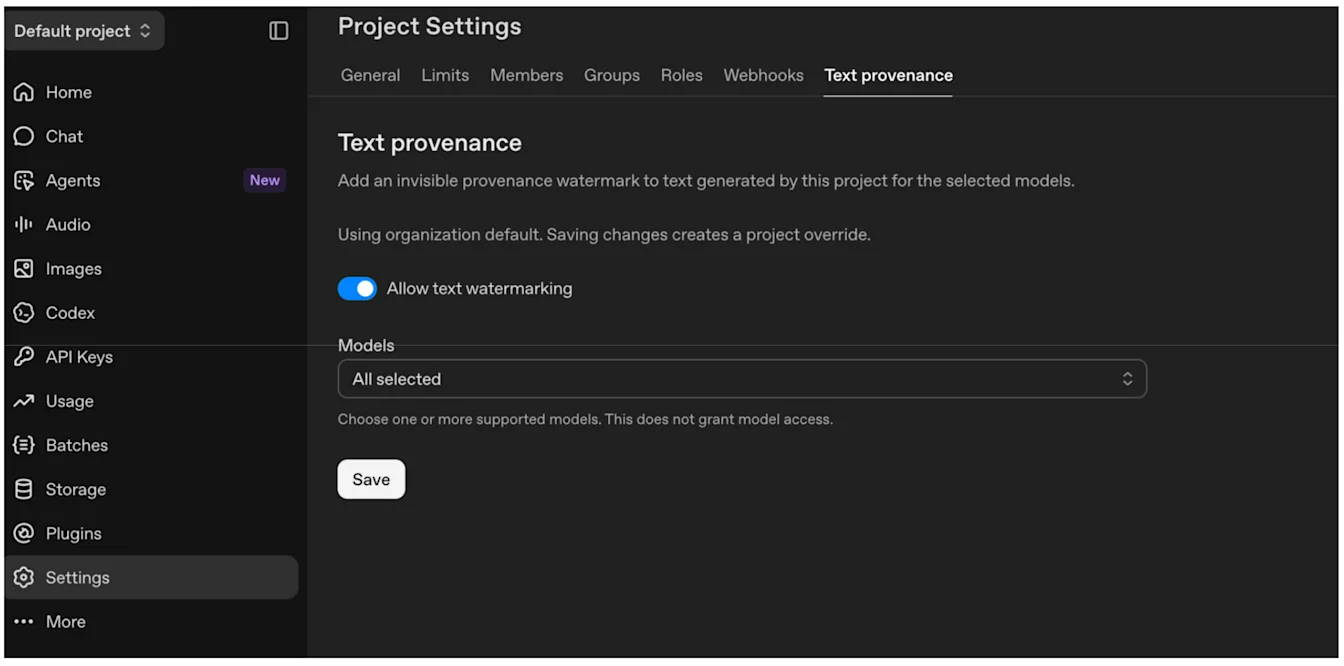
OpenAI کی اے پی آئی کے صارفین کسی مخصوص منصوبے کے لیے ترتیبات کے ذریعے، یا اپنے پورے ادارے کے لیے ادارے کی ترتیبات کے ذریعے متنی واٹرمارک فعال کر سکتے ہیں. دونوں صورتوں میں صارفین منتخب کر سکتے ہیں کہ کن ماڈلز کے متن میں واٹرمارک شامل ہو. کسی معاونت یافتہ ماڈل کے لیے یہ سہولت فعال ہونے پر، OpenAI متن تیار کرتے وقت واٹرمارک شامل کرتا ہے. صارفین کو ہر جواب پر الگ سے نشانی لگانے کی ضرورت نہیں ہوتی.
متنی واٹرمارک کی اجازت دیں کو فعال کریں، اپنے ماڈلز منتخب کریں، پھر محفوظ کریں منتخب کریں.
ادارے کی طے شدہ ترتیب: ادارے کی ترتیبات → ڈیٹا کے اختیارات → متن کا ماخذ.
منصوبے کی ترجیحی ترتیب: منصوبے کی ترتیبات → متن کا ماخذ.
میں کن ماڈلز کے لیے واٹرمارک فعال کر سکتا ہوں.
صارفین ترتیبات اور ادارے کی ترتیبات میں ان ماڈلز کی فہرست دیکھ سکتے ہیں جن کے لیے فی الحال واٹرمارک شامل کرنے کی سہولت دستیاب ہے. آنے والے ہفتوں میں ہم یہ سہولت تمام پرانے ماڈلز تک بڑھائیں گے.
کیا متنی واٹرمارک فعال کرنے سے مجھے متنی شناختی آلے تک بھی رسائی مل جاتی ہے.
نہیں. متنی شناختی آلے تک رسائی فی الحال منظور شدہ تحقیقی اور تعلیمی اداروں تک محدود ہے، جو متنی واٹرمارک کی قابلِ اعتماد کارکردگی، استعمال میں آسانی، اور اس ٹیکنالوجی اور اس کے نتائج کو واضح طور پر سمجھانے کے طریقوں کو بہتر بنانے پر کام کر رہے ہیں. یہ یورپی یونین کے مصنوعی ذہانت کے قانون کے تحت مصنوعی ذہانت سے تیار کردہ مواد کی شفافیت سے متعلق ضابطۂ عمل میں کیے گئے ہمارے وعدوں کے مطابق ہے.
کیا مواد میں تبدیلی کرنے کے بعد بھی نشانیاں اس کے ساتھ منسلک رہیں گی.
ممکن ہے، لیکن یہ نشانی اور آپ کی کی گئی تبدیلیوں پر منحصر ہے.
معاونت یافتہ تصاویر اور آڈیو کی اصل نقل محفوظ رکھیں اور ترمیم، تبدیلیٔ وضع اور اشاعت کے بعد نمائندہ فائلوں کو جانچنے کے لیے مواد کے ماخذ کی اے پی آئی استعمال کریں. تصاویر کو تراشنے، ان میں بصری شور شامل کرنے، JPEG میں تبدیل کرنے اور اسکرین شاٹ لینے سے نشانیوں کی شناخت زیادہ مشکل ہو سکتی ہے. آپ متن کو اس طرح صرف اسی صورت میں جانچ سکتے ہیں جب آپ کے ادارے کو متنی شناختی آلے تک رسائی کی منظوری حاصل ہو.
جہاں آپ کی فائل کی وضع اور کام کا طریقہ اجازت دے، وہاں موجودہ C2PA میٹاڈیٹا محفوظ رکھیں اور اپنی تیار کردہ فائلوں میں مواد کی اسناد شامل کریں. ماخذ کی معلومات کو زیادہ پائیدار یا مفید بنانے کے لیے آپ اپنی نشانیاں شامل کرنے پر بھی غور کر سکتے ہیں. عمل درآمد کی تفصیلات کے لیے C2PA کی تکنیکی دستاویزات دیکھیں.
متن میں واٹرمارک ماڈل کے انتخابِ الفاظ کا حصہ ہوتا ہے. اگر آپ عبارت برقرار رکھیں تو متن کو دوبارہ استعمال کرتے وقت، کسی اضافی تکنیکی انضمام کے بغیر، نشانی باقی رہنے کی توقع ہوتی ہے. بڑے پیمانے پر دوبارہ لکھنے، دوسرے الفاظ میں بیان کرنے یا ترجمہ کرنے سے شناخت کم قابلِ اعتماد ہو سکتی ہے. عبارت میں کوئی تبدیلی نہ ہونے پر بھی واٹرمارک کی شناخت کی ضمانت نہیں ہوتی، خاص طور پر مختصر عبارتوں یا ایسے متن میں جہاں مختلف الفاظ منتخب کرنے کی گنجائش کم ہو.
میں کلاؤڈ سروس کے ذریعے OpenAI کے ماڈلز تک رسائی حاصل کرتا ہوں. کیا اس طرح حاصل ہونے والے مواد میں بھی ماخذ کی نشانیاں ہوتی ہیں.
ہم اپنے تمام کلاؤڈ اور تقسیم کار فراہم کنندگان کے ساتھ کام کر رہے ہیں تاکہ تصاویر، آڈیو اور متن سمیت تمام اہل نتائج میں واٹرمارک کے ساتھ ماخذ کی نشانیاں شامل ہونا یقینی بنایا جا سکے. دستیابی، تیار کردہ مواد اور شراکت دار کے لحاظ سے مختلف ہو سکتی ہے.
کیا ماخذ کی نشانیاں مصنوعی ذہانت کے واضح لیبل یا دیگر انکشافات کی جگہ لے سکتی ہیں.
نہیں. واٹرمارک اور C2PA میٹاڈیٹا ایسی معلومات فراہم کرتے ہیں جنہیں سافٹ ویئر پڑھ سکتا ہے. یہ ان واضح لیبل، بینر یا دوسرے نوٹس کی جگہ نہیں لیتے جو ضروری ہو سکتے ہیں.
اضافی انکشاف کی ضرورت کا انحصار اس بات پر ہے کہ آپ مواد کو کیسے اور کہاں استعمال کرتے ہیں. OpenAI آپ کی مخصوص قانونی ذمہ داریوں کے بارے میں مشورہ نہیں دے سکتا؛ آپ کی قانونی ٹیم کو آپ کے استعمال سے متعلق تقاضوں کا جائزہ لینا چاہیے.
یورپی یونین کے مصنوعی ذہانت کے قانون سے متعلق میرے مزید سوالات ہیں
براہِ کرم یورپی یونین کے مصنوعی ذہانت کے قانون سے متعلق سوال جمع کرائیں اور ہم آپ سے رابطہ کریں گے.