
Como parte de su compromiso con un ecosistema de IA más seguro y transparente, OpenAI usa señales de procedencia para ayudar a las personas a saber si un contenido se generó con un modelo de OpenAI.
Las señales de procedencia pueden aportar información útil sobre el origen, pero no garantizan que el contenido sea exacto, no se haya editado, tenga un titular legítimo o se presente en el contexto correcto.
Señales de procedencia de OpenAI
¿Qué señales de procedencia usa OpenAI?
OpenAI usa distintas señales de procedencia para diferentes tipos de contenido.
| Tipo de contenido | Señales de procedencia | Notas |
|---|---|---|
| Imágenes | Credenciales de contenido y marcas de agua SynthID | Las imágenes generadas con ChatGPT, Codex o la API de OpenAI incluyen ambas señales. |
| Audio | Marcas de agua SynthID | El audio generado por ChatGPT o la API de OpenAI incluye una marca de agua inaudible integrada en el propio audio. |
| Texto | Marcas de agua textGrain (solo en la UE) | En la UE, el texto generado por ChatGPT incluye un cambio invisible en la aleatoriedad que el modelo usa al elegir palabras para cumplir con la Ley de IA de la UE. Los clientes de la API de todo el mundo pueden activar las marcas de agua para los resultados de texto desde la configuración de su proyecto u organización. |
| Video | Credenciales de contenido | Sora dejó de estar disponible. Obtén más información. |
La cobertura puede variar según el producto, el modelo, el método de exportación, el tipo de archivo y el momento en que se creó el contenido. Los resultados de la API están cubiertos, salvo los de los modelos que se retirarán próximamente, como gpt-image-1, gpt-image-1.5 y sora-2.
¿Por qué algunos tipos de contenido usan varias señales?
Cuando es técnicamente viable, OpenAI combina metadatos y marcas de agua para que cada método pueda compensar las limitaciones del otro. Los metadatos pueden contener información detallada, pero las plataformas, las herramientas de edición y las conversiones de archivos pueden eliminarlos. Las marcas de agua aportan menos contexto, pero, al estar integradas en el propio contenido generado, pueden persistir tras algunas transformaciones que eliminan los metadatos.
¿Qué tan resistentes son las señales de procedencia a las modificaciones del contenido?
Las marcas de agua SynthID para imágenes y audio, y las marcas de agua textGrain para texto, están diseñadas para resistir cambios habituales. Según el tipo de contenido, estos pueden incluir ediciones leves, copiar y pegar, recortes o capturas de pantalla. Los cambios más profundos —como recortes importantes de una imagen, compresión de archivos, paráfrasis sustanciales o traducciones— pueden hacer que una marca de agua sea indetectable. Después de cambios profundos, describir el resultado como “generado por OpenAI” también puede ser menos significativo.
Las credenciales de contenido, desarrolladas por la Coalición para la Procedencia y Autenticidad del Contenido, pueden perderse con acciones cotidianas, como tomar una captura de pantalla o convertir un archivo. Cuando se conservan, pueden aportar más detalles sobre el origen y el historial de un archivo que una marca de agua por sí sola.
Cuando es técnicamente posible, usamos ambos métodos para aumentar la probabilidad de que la información de procedencia se conserve tras los cambios en el contenido.
¿Qué son las credenciales de contenido y qué permiten hacer?
Las credenciales de contenido adjuntan información sobre el origen y el historial de un archivo, como qué herramienta lo creó y cuándo. Utilizan un estándar abierto desarrollado por la Coalición para la Procedencia y Autenticidad del Contenido (C2PA), por lo que a veces se denominan “metadatos C2PA”.
Las credenciales de contenido ayudan a las personas a verificar de dónde proviene un contenido. No solo se usan para contenido generado por IA: los fabricantes de cámaras, las organizaciones de noticias y otros también utilizan el estándar para certificar el origen y el historial de su contenido multimedia. Obtén más información sobre C2PA.
¿Qué es SynthID y qué permite hacer?
SynthID es una tecnología de marcas de agua invisibles desarrollada por Google DeepMind que incorpora una señal directamente en el contenido multimedia generado. A diferencia de los metadatos, la señal forma parte del propio contenido y puede persistir tras algunas ediciones o transformaciones. SynthID aporta una señal de procedencia adicional junto con los metadatos C2PA. Por ejemplo, si se eliminan los metadatos de un archivo, una marca de agua integrada aún puede indicar que el contenido se generó con herramientas de OpenAI compatibles. Obtén más información sobre SynthID.
¿Por qué incorporan marcas de agua a los resultados de texto?
Estamos implementando marcas de agua de texto para los usuarios de ChatGPT en la UE a fin de cumplir con la Ley de IA de la UE y con nuestros compromisos en virtud del Código de buenas prácticas de la UE sobre la transparencia del contenido generado por IA, que OpenAI firmó junto con varios otros proveedores importantes de IA.
¿Qué es textGrain y qué permite hacer?
textGrain es la tecnología de OpenAI para incorporar marcas de agua al texto. Ajusta sutilmente la forma en que el modelo elige al azar entre posibles palabras o fragmentos de palabras mientras escribe. A lo largo de un texto, estas elecciones crean un patrón que un detector puede buscar, incluso después de algunas ediciones.
La marca de agua forma parte de la propia redacción y no es visible para los lectores. No agrega caracteres ocultos, espacios invisibles ni signos de puntuación inusuales. Las marcas de agua de texto contribuyen a cumplir el requisito de la Ley de IA de la UE de marcar el texto generado.
Herramientas de verificación de OpenAI
¿Cómo puedo comprobar si un contenido se generó con herramientas de OpenAI?
Puedes visitar openai.com/verify para comprobar si un archivo de imagen o audio compatible contiene señales de procedencia asociadas con contenido generado o exportado por herramientas de OpenAI. Después de que subas un archivo compatible, la herramienta buscará señales de procedencia de OpenAI que admita, como una marca de agua SynthID o un archivo de manifiesto C2PA de confianza asociado con OpenAI. Si la herramienta encuentra una señal de procedencia de OpenAI que admita, esto indica que el contenido probablemente fue generado por un modelo de OpenAI.
Los desarrolladores y las organizaciones también pueden usar la API de procedencia de contenido de OpenAI para buscar señales de procedencia de OpenAI en imágenes y audio e integrar la verificación en sus propias aplicaciones o flujos de trabajo. Las organizaciones con un caso de uso que cumpla los requisitos pueden solicitar límites más altos.
En el caso del texto, de acuerdo con nuestras obligaciones en virtud de la Ley de IA de la UE, las organizaciones con un caso de uso que cumpla los requisitos pueden solicitar acceso al detector de texto. Entre ellas se incluyen las organizaciones académicas y de investigación que estudian la procedencia del texto, la confiabilidad de la detección o cómo las personas interpretan los resultados sobre procedencia. Revisaremos las solicitudes de las organizaciones que cumplan los requisitos caso por caso y, según corresponda, nos pondremos en contacto para comunicar novedades o solicitar información adicional. Nuestro enfoque de acceso puede evolucionar a medida que aprendamos más y mejoremos la tecnología.
Actualmente colaboramos con un grupo limitado de investigadores, entre ellos John Thickstun, profesor asistente de Ciencias de la Computación en la Universidad de Cornell; Martin Vechev, profesor de Ciencias de la Computación en la Escuela Politécnica Federal de Zúrich y director científico de INSAIT; e investigadores del Instituto Kempelen de Tecnologías Inteligentes (KInIT), para comprender mejor las capacidades y limitaciones de la tecnología y orientar las mejoras en las marcas de agua de texto.
¿Quiénes pueden acceder a límites de verificación más altos y se cobran las verificaciones?
Las verificaciones de la API de procedencia de contenido son gratuitas actualmente y están sujetas a límites de uso. El programa de límites más altos se centra en proyectos de procedencia de interés público y flujos de trabajo de integridad de la información que cumplan los requisitos, como la verificación en redacciones periodísticas, la verificación de hechos, la investigación sobre la procedencia del contenido y la supervisión regulatoria.
Las aplicaciones empresariales generales están actualmente fuera del alcance del programa, como la prevención del fraude, la autenticación y la verificación con fines comerciales, o la reventa como parte de paquetes de servicios de procedencia y análisis de datos.
Las organizaciones con un caso de uso que cumpla los requisitos pueden solicitar límites más altos, pero enviar una solicitud no garantiza su aprobación. La API pública sigue disponible con sus límites predeterminados, incluso para evaluaciones de menor escala. Consulta la documentación de la API de procedencia de contenido para conocer los límites de uso actuales.
¿Quiénes pueden acceder al detector de texto y se cobran las verificaciones?
Las verificaciones con el detector de texto son gratuitas actualmente. Entre los casos de uso que cumplen los requisitos se incluyen los de organizaciones académicas y de investigación que estudian la procedencia del texto, la confiabilidad de la detección o cómo las personas interpretan los resultados sobre procedencia.
Las aplicaciones empresariales generales están actualmente fuera del alcance del programa, como la prevención del fraude, la autenticación y la verificación con fines comerciales, o la reventa como parte de paquetes de servicios de procedencia y análisis de datos.
Las aplicaciones de integridad académica, como revisar trabajos de estudiantes para detectar el uso de IA (por ejemplo, en la redacción de ensayos o tesis), también están actualmente fuera del alcance del programa.
¿Qué significan los resultados de la verificación?
Si se detecta una señal mediante openai.com/verify o la API de procedencia de contenido de OpenAI, significa que el contenido subido contiene una señal de procedencia compatible asociada con OpenAI. La herramienta no confirma que el contenido sea exacto, no se haya editado, tenga un titular legítimo o se presente en el contexto correcto. Tampoco identifica quién creó el contenido ni por qué se creó.
Si no se detecta ninguna señal, significa que la herramienta no encontró señales de procedencia emitidas por OpenAI en el archivo subido. Aun así, el contenido podría haber sido generado o exportado por OpenAI si:
El contenido se creó antes de que las señales de procedencia estuvieran disponibles.
El contenido provino de un producto, modelo, método de exportación o tipo de archivo no compatible.
Los metadatos se eliminaron al subir, descargar, editar, convertir o compartir el archivo.
Una marca de agua se degradó por compresión, recortes, ruido, ediciones, conversión de formato u otras transformaciones.
Un clip de audio es demasiado corto o se modificó de forma considerable.
¿Cómo puedo obtener el resultado de verificación más confiable?
Sube un archivo compatible a la vez y, cuando sea posible, usa el archivo exportado original. En el caso de las imágenes, evita recortar o convertir el archivo antes de verificarlo. En el caso del audio, los clips de entre 10 y 60 segundos suelen dar los mejores resultados. Incluso cuando no se detecte ninguna señal, considera el origen y el contexto del archivo antes de sacar una conclusión.
¿Los resultados muestran mi prompt o información personal?
Las señales de procedencia no incluyen detalles sobre el usuario, la organización ni el prompt.
¿Qué sucede con el contenido que verifico mediante openai.com/verify o la API de procedencia de contenido?
El contenido que se sube a openai.com/verify o se envía a nuestra API de procedencia de contenido para su verificación solo se procesa para buscar señales de procedencia compatibles. El contenido no se almacena, salvo que lo exija la ley, ni se utiliza para entrenar modelos de OpenAI.
¿OpenAI puede detectar contenido generado con otras herramientas de IA?
Nuestras herramientas de procedencia de contenido están diseñadas para detectar señales de procedencia compatibles asociadas con contenido generado por modelos de OpenAI o exportado por herramientas de OpenAI. No están diseñadas para detectar contenido generado por otros modelos de IA, y también podrían no detectar contenido generado por OpenAI si la señal correspondiente falta, no es compatible o se ha degradado.
Cómo funcionan las marcas de agua
¿Las marcas de agua determinan la autoría, la titularidad o la responsabilidad legal?
No. Una marca de agua es un indicio de que un modelo de OpenAI probablemente generó o procesó el contenido. Por sí sola, no establece quién es el autor o titular del contenido, si era obligatorio informar sobre el uso de IA ni quién es legalmente responsable. Tampoco te indica si el modelo estaba editando contenido que subió un usuario.
¿Las marcas de agua indican en qué medida intervino un modelo de OpenAI?
No. El detector informa si encontró una marca de agua. Encontrar una es un indicio de que un modelo de OpenAI probablemente generó o procesó el contenido, pero no muestra si el modelo lo generó en parte o en su totalidad, ni cuánto aportó una persona.
¿Cómo funcionan las marcas de agua de texto?
Las marcas de agua de texto crean un patrón secreto en las palabras y fragmentos de palabras, llamados “tokens”, que el modelo elige mientras escribe.
En cada paso, el modelo asigna una probabilidad a cada posible token siguiente. El sistema de marcas de agua crea varios conjuntos ajustados de esas probabilidades; cada uno favorece distintas opciones según una clave secreta. Los conjuntos se equilibran de modo que, al promediarlos, coincidan con las probabilidades originales del modelo. La clave selecciona qué conjunto usar y luego el modelo hace una nueva elección aleatoria a partir de ese conjunto.
Un detector con la misma clave y una configuración coincidente puede comprobar después si el texto sigue el patrón secreto con más frecuencia de lo que cabría esperar por azar.
¿Las marcas de agua de texto se aplican al texto factual y al texto proporcionado por el usuario?
Las marcas de agua de texto dependen de que el modelo tenga distintas formas de decir algo. Hay menos flexibilidad cuando una respuesta debe ceñirse estrictamente a los hechos o ser muy precisa, como la respuesta a un problema matemático, o cuando se pide al modelo que reproduzca un texto proporcionado sin modificarlo. En estos casos, el modelo tiene menos margen para cambiar la redacción sin que se note una diferencia, por lo que es posible que no se detecte la marca de agua.
¿Las marcas de agua de texto se aplican a las respuestas breves y al código?
Los fragmentos breves no suelen contener suficiente texto para detectar una marca de agua de forma confiable. También es más difícil incorporar marcas de agua al código porque hay menos opciones plausibles para lo que viene a continuación que en la prosa común.
Para contemplar estas limitaciones, el Código de buenas prácticas sobre la transparencia del contenido generado por IA, en el marco de la Ley de IA de la UE, no exige marcas de agua en resultados de menos de 200 tokens —unas 150 palabras en inglés— ni en fragmentos de código.
¿Cómo varía la detección de marcas de agua de texto según el idioma?
Las tasas de detección varían según el idioma, y actualmente es más fácil detectar las marcas de agua en algunos idiomas que en otros. Podemos ajustar la intensidad de la marca de agua para mejorar la detección en los idiomas donde la señal es más débil.
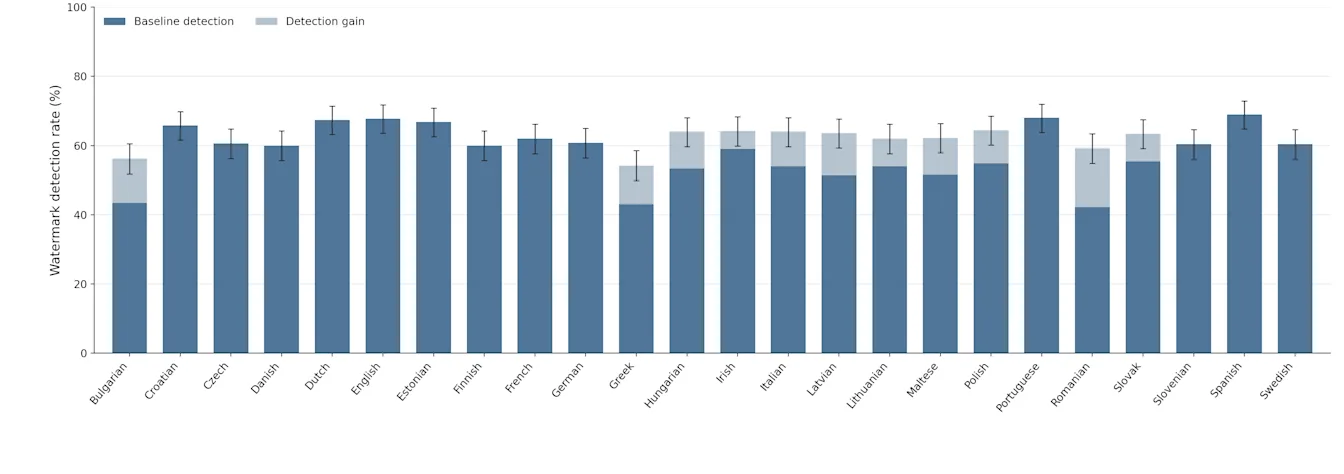
Esta gráfica evalúa la tasa de detección en los 24 idiomas oficiales de la UE. Primero generamos 500 prompts sintéticos en inglés sobre diversos temas y luego los tradujimos a los otros 23 idiomas. Con una tasa de falsos positivos del 1 %, el español tiene la tasa de detección más alta (69,0 %), mientras que el rumano tiene la más baja (42,2 %). Nuestra marca de agua tiene un parámetro de intensidad ajustable: una “perilla” que refuerza o debilita la señal de la marca de agua para distintos ámbitos. Con esta perilla pudimos aumentar la intensidad para los idiomas con tasas de detección inferiores al 60 %; las secciones celestes de las barras muestran las mejoras obtenidas.
¿Las marcas de agua de texto reducen la calidad del modelo?
Según nuestras pruebas, no. En las pruebas de referencia que usamos para evaluar Astra, nuestro modelo de vanguardia más reciente, las diferencias de rendimiento con y sin marcas de agua están dentro de la variación que solemos observar entre evaluaciones. Las pruebas anteriores en ChatGPT tampoco mostraron cambios en las tasas de valoraciones negativas ni en otras métricas del producto al introducir marcas de agua.
¿Las marcas de agua de texto reducen la velocidad del modelo?
Las marcas de agua de texto tienen un impacto insignificante en la velocidad de nuestros modelos.
¿En qué se diferencian las marcas de agua de texto de OpenAI de las herramientas de detección de IA de terceros?
Las herramientas de detección de terceros, como Pangram, suelen usar clasificadores para identificar texto generado por IA a partir de patrones como la elección de palabras. Ese enfoque analiza el texto después de su generación, en lugar de detectar una señal integrada. La Ley de IA de la UE exige específicamente que se incorpore una señal en el texto generado.
¿Por qué usan sus propias marcas de agua de texto en lugar de TextSeal o SynthID?
Desarrollamos nuestro propio método de marcas de agua de texto, llamado textGrain, para tener más control que con SynthID o TextSeal sobre el equilibrio entre la detectabilidad de la marca de agua y la variedad de respuestas generadas a partir de un mismo prompt. En nuestras pruebas, nuestro método identificó correctamente una proporción similar o mayor de muestras de texto con marcas de agua que SynthID para texto. Planeamos publicar textGrain como tecnología de código abierto para que otros puedan desarrollar soluciones a partir de ella y ayudar a mejorar las marcas de agua de texto.
¿Las marcas de agua de texto agregan caracteres ocultos, tokens adicionales o cambios visibles?
No. Las marcas de agua de texto cambian el patrón estadístico de la elección de palabras; no insertan caracteres ocultos ni agregan tokens exclusivos de la marca de agua. La marca de agua no es visible para los lectores, y copiar y pegar el texto no introduce material oculto.
Orientación para clientes
Soy cliente de la API, ¿cómo activo las marcas de agua de texto?
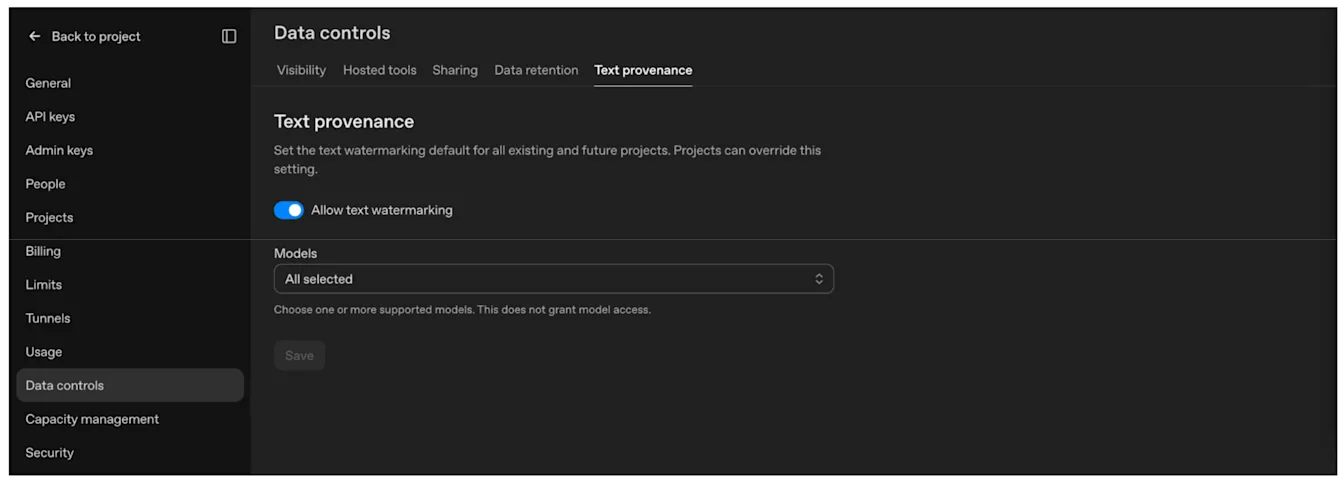
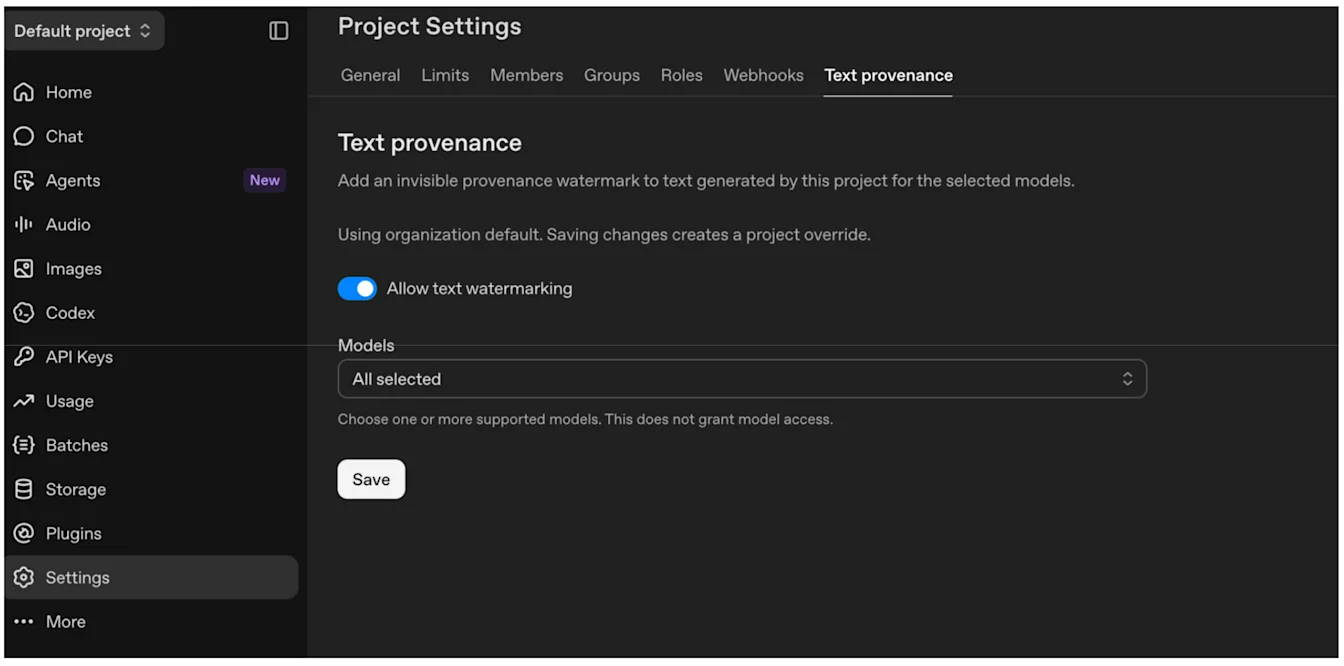
Los clientes de la API de OpenAI pueden activar las marcas de agua de texto para un proyecto específico desde Configuración, o para toda su organización desde Configuración de la organización. En cada caso, los clientes pueden seleccionar qué modelos usarán marcas de agua de texto. Una vez que se activa esta opción para un modelo compatible, OpenAI agrega la marca de agua durante la generación de texto. Los clientes no necesitan agregar una marca por separado a cada respuesta.
Activa Permitir marcas de agua de texto, selecciona tus modelos y luego selecciona Guardar.
Valor predeterminado de la organización: configuración de la organización → Controles de datos → Procedencia del texto.
Configuración específica del proyecto: configuración del proyecto → Procedencia del texto.
¿Para qué modelos puedo activar las marcas de agua?
En Configuración y Configuración de la organización, los clientes pueden ver la lista de modelos que actualmente admiten marcas de agua. En las próximas semanas, ampliaremos la cobertura a todos los modelos heredados.
¿Activar las marcas de agua de texto también me da acceso al detector de texto?
No. El acceso al detector de texto está limitado actualmente a organizaciones académicas y de investigación autorizadas que trabajan para mejorar la confiabilidad y la facilidad de uso de las marcas de agua de texto, así como la claridad con la que se pueden explicar la tecnología y sus resultados. Esto es coherente con nuestros compromisos en virtud del Código de buenas prácticas sobre la transparencia del contenido generado por IA, en el marco de la Ley de IA de la UE.
¿Las señales permanecerán en el contenido después de que lo transforme?
Es posible, pero depende de la señal y de los cambios que hagas.
En el caso de imágenes y audio compatibles, conserva una copia original y usa la API de procedencia de contenido para probar archivos representativos después de editarlos, convertirlos y publicarlos. En el caso de las imágenes, recortarlas, agregarles ruido, convertirlas a JPEG y tomar capturas de pantalla puede dificultar la detección de las señales. Solo puedes probar texto de esta manera si tu organización tiene acceso autorizado al detector de texto.
Cuando el formato de archivo y el flujo de trabajo lo permitan, conserva los metadatos C2PA existentes e incluye credenciales de contenido en los archivos que produzcas. También puedes considerar agregar tus propias marcas para que la información de procedencia sea más duradera o útil. Consulta la documentación técnica de C2PA para conocer los detalles de implementación.
En el caso del texto, la marca de agua forma parte de las palabras que elige el modelo. Si conservas la redacción, se espera que la señal permanezca cuando reutilices el texto, sin necesidad de trabajo adicional de integración. Una reescritura o paráfrasis sustancial, o una traducción, puede reducir la confiabilidad de la detección. Incluso si la redacción no cambia, no se garantiza que la marca de agua sea detectable, especialmente en fragmentos breves o en textos con poco margen para elegir palabras diferentes.
Accedo a los modelos de OpenAI a través de un servicio en la nube. ¿Esos resultados también contienen señales de procedencia?
Estamos trabajando con todos nuestros proveedores de servicios en la nube y de distribución para garantizar que se incorporen señales de procedencia, incluidas marcas de agua, en todos los resultados que las admitan, como imágenes, audio y texto. La disponibilidad puede variar según el resultado y el socio.
¿Las señales de procedencia reemplazan las etiquetas visibles de IA u otros avisos?
No. Las marcas de agua y los metadatos C2PA aportan información que el software puede leer. No reemplazan las etiquetas visibles, los banners ni otros avisos que puedan ser obligatorios.
La necesidad de un aviso adicional depende de cómo y dónde uses el contenido. OpenAI no puede asesorarte sobre tus obligaciones legales específicas; tu equipo legal debe evaluar los requisitos para tu uso.
Tengo más preguntas sobre la Ley de IA de la UE
Por favor, envía una consulta sobre la Ley de IA de la UE y te responderemos.