
Dans le cadre de son engagement en faveur d’un écosystème d’IA plus sûr et plus transparent, OpenAI utilise des signaux de provenance pour aider chacun à savoir si un contenu a été généré avec un modèle OpenAI.
Les signaux de provenance peuvent fournir des informations utiles sur l’origine d’un contenu, mais ils ne garantissent pas son exactitude, l’absence de modifications, la détention légale des droits ni sa présentation dans le bon contexte.
Les signaux de provenance d’OpenAI
Quels signaux de provenance OpenAI utilise-t-il ?
OpenAI utilise différents signaux de provenance selon les types de contenu.
| Type de contenu | Signaux de provenance | Remarques |
|---|---|---|
| Images | Content Credentials et filigranes SynthID | Les images générées avec ChatGPT, Codex ou l’API OpenAI incluent les deux signaux. |
| Audio | Filigranes SynthID | Les contenus audio générés par ChatGPT ou l’API OpenAI incluent un filigrane inaudible intégré au contenu audio lui-même. |
| Texte | Filigranes textGrain (UE uniquement) | Dans l’UE, le texte généré par ChatGPT inclut une modification invisible de l’aléa utilisé dans les choix de mots du modèle, afin de respecter le règlement européen sur l’IA. Les clients de l’API du monde entier peuvent activer les filigranes pour les textes générés dans les paramètres de leur projet ou de leur organisation. |
| Vidéo | Content Credentials | Sora n’est plus disponible. En savoir plus. |
La couverture peut varier selon le produit, le modèle, le mode d’exportation, le type de fichier et la date de création du contenu. Les sorties de l’API sont couvertes, à l’exception des modèles dont l’abandon est imminent, notamment gpt-image-1, gpt-image-1.5 et sora-2.
Pourquoi certains types de contenu utilisent-ils plusieurs signaux ?
Lorsque cela est techniquement possible, OpenAI combine métadonnées et filigranes afin que chacun puisse compenser les limites de l’autre. Les métadonnées peuvent contenir des informations détaillées, mais les plateformes, les outils d’édition et les conversions de fichiers peuvent les supprimer. Les filigranes fournissent moins de contexte, mais comme ils sont intégrés au contenu généré lui-même, ils peuvent résister à certaines transformations qui suppriment les métadonnées.
Dans quelle mesure les signaux de provenance résistent-ils aux modifications du contenu ?
Les filigranes SynthID pour les images et l’audio, ainsi que les filigranes textGrain pour le texte, sont conçus pour résister aux modifications courantes. Selon le type de contenu, il peut s’agir de modifications légères, de copier-coller, de recadrages ou de captures d’écran. Des modifications plus importantes — comme un recadrage marqué de l’image, la compression du fichier, une reformulation substantielle ou une traduction — peuvent rendre un filigrane indétectable. Après des modifications importantes, qualifier le résultat de « généré par OpenAI » peut aussi être moins pertinent.
Les Content Credentials, développés par la Coalition pour la provenance et l’authenticité des contenus, peuvent être perdus lors d’actions courantes, comme une capture d’écran ou la conversion d’un fichier. Lorsqu’ils restent disponibles, ils peuvent fournir davantage de détails sur l’origine et l’historique d’un fichier qu’un filigrane seul.
Lorsque cela est techniquement possible, nous utilisons les deux méthodes pour augmenter les chances que les informations de provenance résistent aux modifications du contenu.
Que sont les Content Credentials et à quoi servent-ils ?
Les Content Credentials associent à un fichier des informations sur son origine et son historique, comme l’outil qui l’a créé et la date de création. Ils utilisent une norme ouverte développée par la Coalition pour la provenance et l’authenticité des contenus (C2PA), d’où leur autre nom de « métadonnées C2PA ».
Les Content Credentials aident chacun à vérifier l’origine d’un contenu. Leur utilisation ne se limite pas aux contenus générés par l’IA : les fabricants d’appareils photo, les médias et d’autres acteurs utilisent également cette norme pour certifier la source et l’historique de leurs contenus multimédias. En savoir plus sur la C2PA.
Qu’est-ce que SynthID et à quoi sert-il ?
SynthID est une technologie de filigrane invisible développée par Google DeepMind, qui intègre un signal directement dans les contenus multimédias générés. Contrairement aux métadonnées, le signal fait partie du contenu lui-même et peut persister après certaines modifications ou transformations. SynthID fournit un signal de provenance supplémentaire, en complément des métadonnées C2PA. Par exemple, si les métadonnées d’un fichier sont supprimées, un filigrane intégré peut encore indiquer que le contenu a été généré avec des outils OpenAI pris en charge. En savoir plus sur SynthID.
Pourquoi ajoutez-vous des filigranes aux textes générés ?
Nous mettons en place des filigranes textuels pour les utilisateurs de ChatGPT dans l’UE afin de respecter le règlement européen sur l’IA, conformément à nos engagements au titre du code de bonnes pratiques de l’UE sur la transparence des contenus générés par l’IA, qu’OpenAI a signé avec plusieurs autres grands fournisseurs d’IA.
Qu’est-ce que textGrain et à quoi sert-il ?
textGrain est la technologie de filigrane textuel d’OpenAI. Elle ajuste subtilement la manière dont le modèle choisit aléatoirement parmi les mots ou fragments de mots possibles au fil de la rédaction. À l’échelle d’un passage, ces choix créent un motif qu’un détecteur peut rechercher, même après certaines modifications.
Le filigrane fait partie de la formulation elle-même et n’est pas visible pour les lecteurs. Il n’ajoute ni caractères cachés, ni espaces invisibles, ni ponctuation inhabituelle. Les filigranes textuels contribuent au respect de l’obligation de marquage des textes générés prévue par le règlement européen sur l’IA.
Les outils de vérification d’OpenAI
Comment vérifier si un contenu a été généré avec des outils OpenAI ?
Vous pouvez consulter openai.com/verify pour vérifier si une image ou un fichier audio pris en charge contient des signaux de provenance associés à du contenu généré ou exporté par des outils OpenAI. Une fois un fichier pris en charge importé, l’outil recherche les signaux de provenance OpenAI pris en charge, comme un filigrane SynthID ou un manifeste C2PA de confiance associé à OpenAI. Si l’outil trouve un signal de provenance OpenAI pris en charge, cela indique que le contenu a probablement été généré par un modèle OpenAI.
Les développeurs et les organisations peuvent également utiliser l’API Content Provenance d’OpenAI pour rechercher des signaux de provenance OpenAI dans les images et les fichiers audio, et intégrer la vérification à leurs propres applications ou workflows. Les organisations dont le cas d’utilisation est admissible peuvent demander une augmentation des limites.
Pour le texte, conformément à nos obligations au titre du règlement européen sur l’IA, les organisations dont le cas d’utilisation est admissible, notamment les établissements universitaires et organismes de recherche qui étudient la provenance des textes, la fiabilité de la détection ou la compréhension des résultats de provenance par le public, peuvent demander l’accès au détecteur de texte. Nous examinerons au cas par cas les demandes des organisations admissibles et leur communiquerons, selon les besoins, des informations sur leur avancement ou des demandes de renseignements complémentaires. Notre approche de l’accès pourra évoluer à mesure que nous en apprendrons davantage et améliorerons la technologie.
Nous collaborons actuellement avec un groupe restreint de chercheurs, dont John Thickstun, professeur adjoint d’informatique à l’université Cornell, Martin Vechev, professeur d’informatique à l’ETH Zurich et directeur scientifique de l’INSAIT, ainsi que des chercheurs de l’Institut Kempelen des technologies intelligentes (KInIT), pour mieux comprendre les capacités et les limites de cette technologie et orienter les améliorations des filigranes textuels.
Qui peut bénéficier de limites de vérification plus élevées, et les vérifications sont-elles facturées ?
Les vérifications via l’API Content Provenance sont actuellement gratuites et soumises à des limites d’utilisation. Le programme d’augmentation des limites vise les projets admissibles de provenance d’intérêt public ; les contrôles commerciaux courants de lutte contre la fraude n’entrent pas dans son périmètre actuel. Les organisations dont le cas d’utilisation est admissible peuvent demander une augmentation des limites, mais l’envoi d’une demande ne garantit pas son approbation. L’API publique reste disponible dans ses limites par défaut, y compris pour des évaluations à plus petite échelle. Consultez la documentation de l’API Content Provenance pour connaître les limites d’utilisation actuelles.
Que signifient les résultats de vérification ?
Si un signal est détecté via openai.com/verify ou l’API Content Provenance d’OpenAI, cela signifie que le contenu importé contient un signal de provenance pris en charge associé à OpenAI. L’outil ne confirme pas l’exactitude du contenu, l’absence de modifications, la détention légale des droits ni sa présentation dans le bon contexte. Il n’identifie pas non plus qui a créé le contenu ni pourquoi il a été créé.
Si aucun signal n’est détecté, cela signifie que l’outil n’a pas trouvé de signaux de provenance émis par OpenAI dans le fichier importé. Le contenu peut tout de même avoir été généré ou exporté par OpenAI si :
Le contenu a été créé avant que les signaux de provenance ne soient disponibles.
Le contenu provient d’un produit, d’un modèle, d’un mode d’exportation ou d’un type de fichier non pris en charge.
Les métadonnées ont été supprimées lors de l’importation, du téléchargement, de l’édition, de la conversion ou du partage.
Un filigrane a été dégradé par la compression, le recadrage, le bruit, des modifications, une conversion de format ou d’autres transformations.
Un extrait audio est trop court ou a été considérablement modifié.
Comment obtenir le résultat de vérification le plus fiable possible ?
Importez un seul fichier pris en charge à la fois et, si possible, utilisez le fichier exporté d’origine. Pour les images, évitez de recadrer ou de convertir le fichier avant de le vérifier. Pour l’audio, les extraits de 10 à 60 secondes donnent généralement les meilleurs résultats. Même si aucun signal n’est détecté, tenez compte de la source et du contexte du fichier avant de tirer une conclusion.
Les résultats affichent-ils mon prompt ou mes informations personnelles ?
Les signaux de provenance n’incluent pas de détails sur l’utilisateur, l’organisation ou le prompt.
Qu’advient-il du contenu que je vérifie avec openai.com/verify ou l’API Content Provenance ?
Le contenu importé sur openai.com/verify ou soumis à notre API Content Provenance pour vérification est uniquement traité pour rechercher des signaux de provenance pris en charge. Le contenu n’est pas conservé, sauf obligation légale, et n’est pas utilisé pour entraîner les modèles OpenAI.
OpenAI peut-il détecter du contenu généré avec d’autres outils d’IA ?
Nos outils de provenance des contenus sont conçus pour détecter les signaux de provenance pris en charge associés à du contenu généré par des modèles OpenAI ou exporté par des outils OpenAI. Ils ne sont pas conçus pour détecter du contenu généré par d’autres modèles d’IA et peuvent également ne pas détecter du contenu généré par OpenAI si le signal concerné est absent, non pris en charge ou dégradé.
Fonctionnement des filigranes
Les filigranes déterminent-ils la qualité d’auteur, la propriété ou la responsabilité juridique ?
Non. Un filigrane constitue un indice qu’un modèle OpenAI a probablement généré ou traité le contenu. À lui seul, il ne permet pas d’établir qui est l’auteur ou le propriétaire du contenu, si une mention d’information était requise, ni qui en est juridiquement responsable. Il n’indique pas non plus si le modèle modifiait un contenu importé par un utilisateur.
Les filigranes indiquent-ils dans quelle mesure un modèle OpenAI est intervenu ?
Non. Le détecteur indique s’il a trouvé un filigrane. La présence d’un filigrane constitue un indice qu’un modèle OpenAI a probablement généré ou traité le contenu, mais elle n’indique pas si le modèle en a généré une partie ou la totalité, ni l’ampleur de la contribution humaine.
Comment fonctionnent les filigranes textuels ?
L’insertion de filigranes textuels crée un motif secret dans les choix de mots et de fragments de mots du modèle, appelés « tokens », au fil de la rédaction.
À chaque étape, le modèle attribue une probabilité à chaque token susceptible de venir ensuite. Le système de filigrane crée plusieurs ensembles ajustés de ces probabilités, chacun favorisant des choix différents selon une clé secrète. Les ensembles sont équilibrés de sorte que leur moyenne corresponde aux probabilités d’origine du modèle. La clé sélectionne l’ensemble à utiliser, puis le modèle effectue un nouveau choix aléatoire dans cet ensemble.
Un détecteur disposant de la même clé et de paramètres correspondants peut ensuite vérifier si le texte suit le motif secret plus souvent que ne le laisserait prévoir le hasard.
Les filigranes textuels s’appliquent-ils aux textes factuels et aux textes fournis par l’utilisateur ?
L’insertion de filigranes textuels repose sur la possibilité pour le modèle de formuler une idée de différentes manières. Cette souplesse est moindre lorsqu’une réponse doit être très factuelle ou précise, comme la réponse à un problème de mathématiques, ou lorsque le modèle doit reproduire un texte fourni sans le modifier. Dans ces cas, le modèle a moins de latitude pour modifier sa formulation sans différence perceptible ; le filigrane peut donc ne pas être détecté.
Les filigranes textuels s’appliquent-ils aux réponses courtes et au code ?
Les passages courts ne contiennent généralement pas assez de texte pour permettre une détection fiable du filigrane. Le code est également plus difficile à marquer par un filigrane, car les choix plausibles pour la suite sont moins nombreux que dans un texte ordinaire.
Pour tenir compte de ces limites, le code de bonnes pratiques sur la transparence des contenus générés par l’IA, lié au règlement européen sur l’IA, n’exige pas de filigranes dans les sorties de moins de 200 tokens — soit environ 150 mots en anglais — ni dans les extraits de code.
Comment la détection des filigranes textuels varie-t-elle selon la langue ?
Les taux de détection varient selon la langue, et la détection est actuellement plus facile dans certaines langues que dans d’autres. Nous pouvons ajuster l’intensité du filigrane pour améliorer la détection dans les langues où le signal est plus faible.
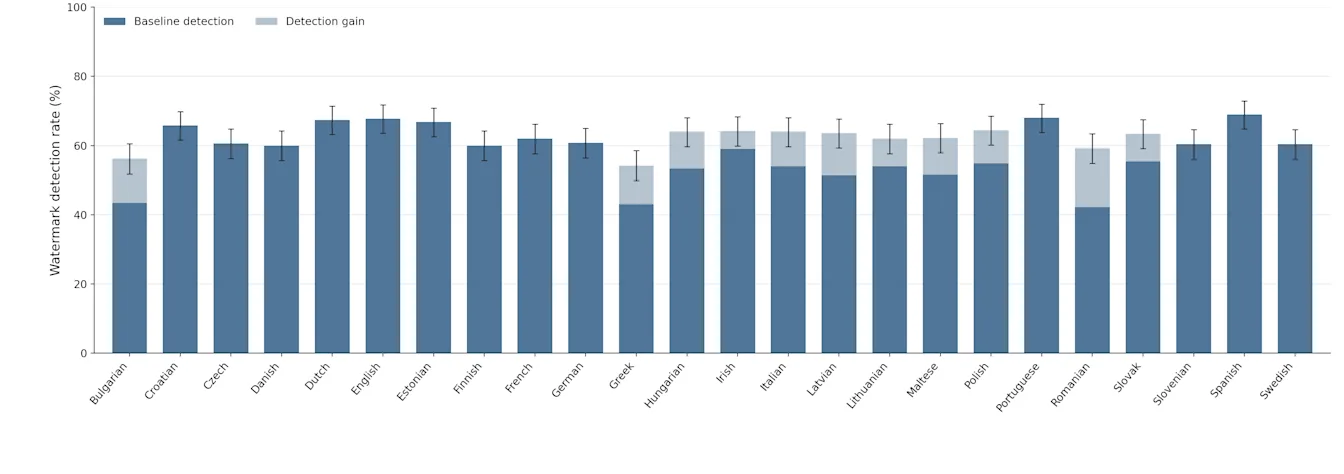
Ce graphique évalue le taux de détection dans les 24 langues officielles de l’UE. Nous avons d’abord généré 500 prompts synthétiques en anglais couvrant divers sujets, puis les avons traduits dans les 23 autres langues. Avec un taux de faux positifs de 1 %, l’espagnol présente le taux de détection le plus élevé (69,0 %), et le roumain le plus faible (42,2 %). Notre filigrane dispose d’un paramètre d’intensité réglable — un « curseur » qui renforce ou atténue le signal du filigrane selon les domaines. Grâce à ce curseur, nous avons pu augmenter l’intensité pour les langues dont le taux de détection était inférieur à 60 % ; les parties bleu clair des barres montrent les gains obtenus.
Les filigranes textuels réduisent-ils la qualité du modèle ?
D’après nos tests, non. Sur l’ensemble des benchmarks utilisés pour évaluer Astra, notre dernier modèle de pointe, les écarts de performance avec et sans filigrane se situent dans la marge de variation que nous observons habituellement d’une évaluation à l’autre. Des tests antérieurs dans ChatGPT n’ont pas non plus montré de changement du taux de pouces vers le bas ni d’autres indicateurs du produit après l’introduction des filigranes.
Les filigranes textuels réduisent-ils la vitesse du modèle ?
L’insertion de filigranes textuels a un effet négligeable sur la vitesse de nos modèles.
En quoi les filigranes textuels d’OpenAI diffèrent-ils des outils tiers de détection de l’IA ?
Les outils de détection tiers comme Pangram utilisent généralement des classificateurs pour identifier les textes générés par l’IA à partir de caractéristiques telles que le choix des mots. Cette approche analyse le texte après sa génération plutôt que de détecter un signal intégré. Le règlement européen sur l’IA exige expressément qu’un signal soit intégré au texte généré.
Pourquoi utilisez-vous vos propres filigranes textuels plutôt que TextSeal ou SynthID ?
Nous avons développé notre propre méthode de filigrane textuel, appelée textGrain, pour mieux maîtriser qu’avec SynthID ou TextSeal l’équilibre entre la détectabilité du filigrane et la variété des réponses générées à partir d’un même prompt. Lors de nos tests, notre approche a correctement identifié une proportion d’échantillons de texte marqués par un filigrane similaire ou supérieure à celle de SynthID pour le texte. Nous prévoyons de publier textGrain en open source afin que d’autres puissent s’appuyer sur cette technologie et contribuer à améliorer les filigranes textuels.
Les filigranes textuels ajoutent-ils des caractères cachés, des tokens supplémentaires ou des modifications visibles ?
Non. L’insertion de filigranes textuels modifie la structure statistique des choix de mots ; elle n’insère pas de caractères cachés et n’ajoute pas de tokens réservés au filigrane. Le filigrane n’est pas visible pour les lecteurs, et copier-coller le texte n’introduit aucun élément caché.
Conseils aux clients
Je suis client de l’API : comment activer les filigranes textuels ?
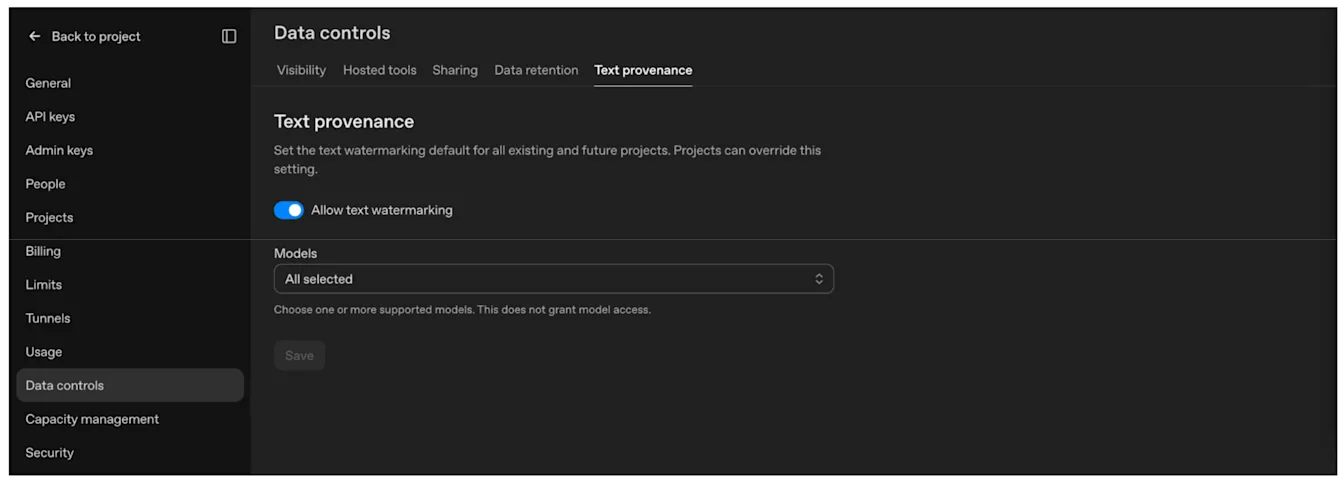
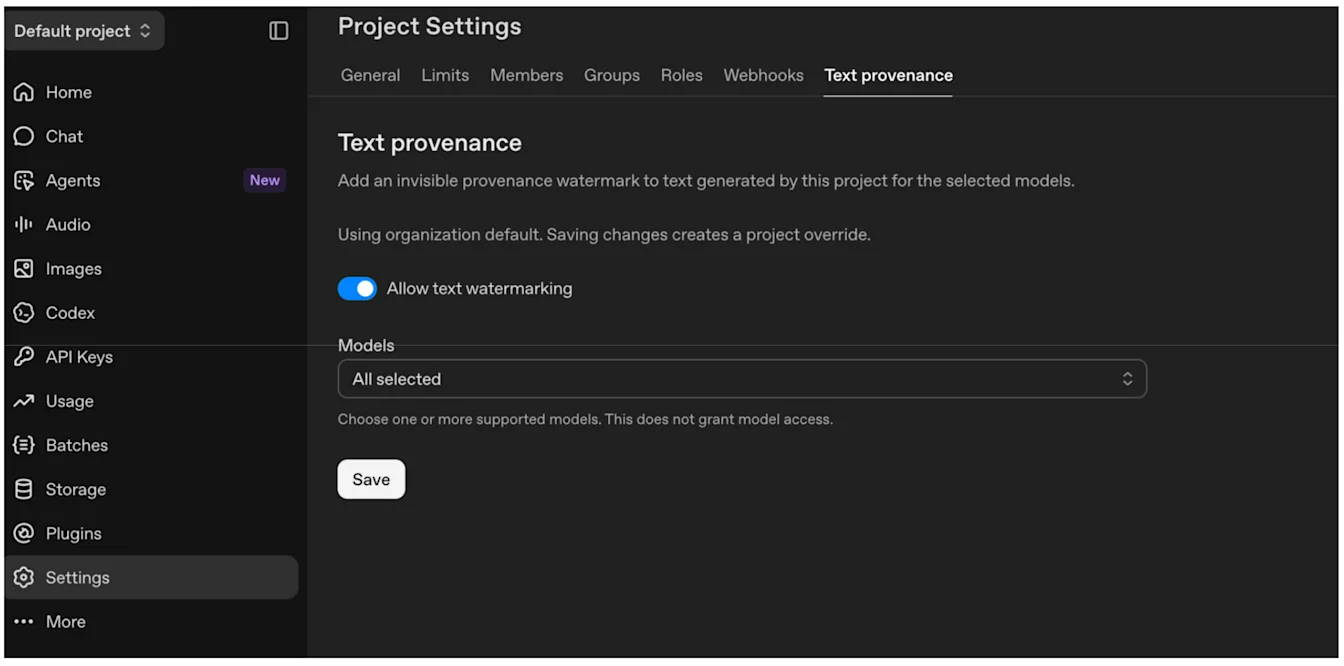
Les clients de l’API OpenAI peuvent activer les filigranes textuels pour un projet précis via les Paramètres, ou pour l’ensemble de leur organisation via les Paramètres de l’organisation. Dans chaque cas, les clients peuvent sélectionner les modèles auxquels appliquer un filigrane textuel. Une fois l’option activée pour un modèle pris en charge, OpenAI ajoute le filigrane lors de la génération du texte. Les clients n’ont pas besoin d’ajouter un marquage distinct à chaque réponse.
Activez Autoriser les filigranes textuels, sélectionnez vos modèles, puis sélectionnez Enregistrer.
Valeur par défaut de l’organisation : Paramètres de l’organisation → Contrôles des données → Provenance du texte.
Remplacement au niveau du projet : Paramètres du projet → Provenance du texte.
Pour quels modèles puis-je activer les filigranes ?
Dans les Paramètres et les Paramètres de l’organisation, les clients peuvent consulter la liste des modèles pour lesquels les filigranes sont actuellement disponibles. Au cours des prochaines semaines, nous étendrons la couverture à tous les anciens modèles.
L’activation des filigranes textuels me donne-t-elle aussi accès au détecteur de texte ?
Non. L’accès au détecteur de texte est actuellement limité aux organismes de recherche et établissements universitaires autorisés qui travaillent à améliorer la fiabilité et la facilité d’utilisation des filigranes textuels, ainsi que la clarté des explications de la technologie et de ses résultats. Cela est conforme à nos engagements au titre du code de bonnes pratiques sur la transparence des contenus générés par l’IA, lié au règlement européen sur l’IA.
Les signaux resteront-ils associés au contenu après sa transformation ?
C’est possible, mais cela dépend du signal et des modifications que vous apportez.
Pour les images et les fichiers audio pris en charge, conservez une copie d’origine et utilisez l’API Content Provenance pour tester des fichiers représentatifs après édition, conversion et publication. Pour les images, le recadrage, l’ajout de bruit, la conversion en JPEG et les captures d’écran peuvent rendre les signaux plus difficiles à détecter. Vous ne pouvez tester du texte de cette manière que si votre organisation dispose d’un accès autorisé au détecteur de texte.
Lorsque votre format de fichier et votre workflow le permettent, conservez les métadonnées C2PA existantes et incluez des Content Credentials dans les fichiers que vous produisez. Vous pouvez également envisager d’ajouter vos propres marquages pour rendre les informations de provenance plus durables ou plus utiles. Consultez la documentation technique C2PA pour en savoir plus sur l’implémentation.
Pour le texte, le filigrane fait partie des choix de mots du modèle. Si vous conservez la formulation, le signal devrait persister lors de la réutilisation du texte, sans travail d’intégration supplémentaire. Une réécriture importante, une reformulation ou une traduction peuvent rendre la détection moins fiable. Même une formulation inchangée ne garantit pas un filigrane détectable, notamment dans les passages courts ou les textes offrant peu de latitude dans le choix des mots.
J’accède aux modèles OpenAI via un service cloud. Ces sorties contiennent-elles aussi des signaux de provenance ?
Nous travaillons avec tous nos fournisseurs de services cloud et partenaires de distribution pour garantir l’intégration de signaux de provenance, y compris de filigranes, à toutes les sorties admissibles, notamment les images, l’audio et le texte. La disponibilité peut varier selon la sortie et le partenaire.
Les signaux de provenance remplacent-ils les mentions visibles d’IA ou d’autres informations à communiquer ?
Non. Les filigranes et les métadonnées C2PA fournissent des informations lisibles par les logiciels. Ils ne remplacent pas les mentions visibles, les bannières ou les autres avertissements qui peuvent être requis.
La nécessité d’ajouter une mention d’information dépend de la manière dont vous utilisez le contenu et de l’endroit où vous l’utilisez. OpenAI ne peut pas vous conseiller sur vos obligations juridiques particulières ; votre équipe juridique doit évaluer les exigences applicables à votre utilisation.
J’ai d’autres questions concernant le règlement européen sur l’IA
Veuillez envoyer une demande concernant le règlement européen sur l’IA et nous vous répondrons.