
OpenAI 致力建立更安全、更透明的 AI 生態系統,並為此使用來源訊號,協助人們了解內容是否由 OpenAI 模型生成。
來源訊號可提供有用的來源資料,但不能保證內容準確、未經編輯、擁有權合法,或在正確的語境下呈現。
OpenAI 的來源訊號
OpenAI 使用哪些來源訊號?
OpenAI 會針對不同內容類型使用不同的來源訊號。
| 內容類型 | 來源訊號 | 備註 |
|---|---|---|
| 圖片 | 內容憑證及 SynthID 浮水印 | 使用 ChatGPT、Codex 或 OpenAI API 生成的圖片均包含這兩種訊號。 |
| 音訊 | SynthID 浮水印 | ChatGPT 或 OpenAI API 生成的音訊,其本身嵌有無法聽見的浮水印。 |
| 文字 | textGrain 浮水印(僅限歐盟) | 在歐盟,為遵守歐盟《人工智能法案》,ChatGPT 生成文字時會對模型用詞選擇所採用的隨機機制作出不可見的調整。全球 API 客戶都可以在專案或組織設定中,為文字輸出啟用文字浮水印。 |
| 影片 | 內容憑證 | Sora 已停止服務。了解更多。 |
涵蓋範圍可能因產品、模型、匯出途徑、檔案類型及內容建立時間而異。API 輸出均在涵蓋範圍內,但計劃即將淘汰的模型除外,包括 gpt-image-1、gpt-image-1.5 及 sora-2。
為甚麼某些內容類型會使用多種訊號?
在技術可行的情況下,OpenAI 會結合元數據與浮水印,讓兩者互相彌補不足。元數據可以承載詳細資料,但平台、編輯工具及檔案轉換過程可能會將其移除。浮水印承載的背景資料較少,但由於它嵌入生成內容本身,即使某些轉換過程移除了元數據,浮水印仍可能保留下來。
內容修改後,來源訊號能保留到甚麼程度?
用於圖片和音訊的 SynthID 浮水印,以及用於文字的 textGrain 浮水印,在設計上都能抵禦常見的改動。視乎內容類型,這些改動可包括輕微編輯、複製與貼上、裁剪或擷取螢幕截圖。幅度較大的改動,例如大幅裁剪圖片、壓縮檔案、大量改寫或翻譯,可能令浮水印無法被偵測到。內容經過大幅修改後,將結果描述為「由 OpenAI 生成」也可能不再那麼有意義。
由內容來源與真實性聯盟開發的內容憑證,可能因擷取螢幕截圖或轉換檔案等日常操作而遺失。如果內容憑證仍然保留,相比單靠浮水印,它能提供更詳細的檔案來源及歷程資料。
在技術可行的情況下,我們會同時使用這兩種方法,提高來源資料在內容改動後仍能保留的機會。
甚麼是內容憑證?它有甚麼用途?
內容憑證會附上檔案的來源和歷程資料,例如建立檔案所用的工具及時間。內容憑證採用內容來源與真實性聯盟(C2PA)開發的開放標準,因此有時也稱為「C2PA 元數據」。
內容憑證有助人們驗證內容的來源。它不僅用於 AI 生成內容:相機製造商、新聞機構及其他組織也使用這項標準,證明其媒體內容的來源與歷程。進一步了解 C2PA。
甚麼是 SynthID?它有甚麼用途?
SynthID 是 Google DeepMind 開發的隱形浮水印技術,可將訊號直接嵌入生成的媒體內容中。與元數據不同,這種訊號是內容本身的一部分,可能在經過一些編輯或轉換後仍然保留。SynthID 可在 C2PA 元數據之外,提供額外的來源訊號。例如,即使檔案的元數據被移除,嵌入的浮水印仍可能提供訊號,表明內容由受支援的 OpenAI 工具生成。進一步了解 SynthID。
為甚麼要在文字輸出中加入浮水印?
我們正為歐盟的 ChatGPT 用戶實施文字浮水印,以遵守歐盟《人工智能法案》,並履行我們在歐盟《AI 生成內容透明度實務守則》下的承諾。OpenAI 已與其他數家主要 AI 供應商共同簽署該守則。
甚麼是 textGrain?它有甚麼用途?
textGrain 是 OpenAI 的文字浮水印技術。它會微調模型撰寫內容時,從可能的詞語或詞語片段中隨機作出選擇的方式。這些選擇會在整段文字中形成可供偵測工具識別的模式,即使文字經過一些編輯,仍可能被識別。
浮水印是措辭本身的一部分,讀者無法看見。它不會加入隱藏字元、不可見的空格或不尋常的標點符號。文字浮水印有助遵守歐盟《人工智能法案》對標記生成文字的要求。
OpenAI 的驗證工具
我如何檢查內容是否由 OpenAI 工具生成?
你可以前往 openai.com/verify,檢查受支援的圖片或音訊檔案是否包含與 OpenAI 工具生成或匯出的內容相關的來源訊號。上載受支援的檔案後,工具會尋找受支援的 OpenAI 來源訊號,例如 SynthID 浮水印,或與 OpenAI 相關的可信 C2PA 資訊清單。如果工具找到受支援的 OpenAI 來源訊號,就表示內容很可能由 OpenAI 模型生成。
開發者和機構也可以使用 OpenAI 的內容來源 API,檢查圖片和音訊中的 OpenAI 來源訊號,並將驗證功能整合到自己的應用程式或工作流程中。用途符合資格的機構可以申請提高用量上限。
就文字而言,按照我們在歐盟《人工智能法案》下的義務,用途符合資格的機構,例如研究文字來源、偵測可靠性或人們如何理解來源驗證結果的學術及研究機構,可以申請使用文字偵測工具。我們會逐一審核合資格機構的申請,並視乎情況跟進,提供最新消息或要求補充資料。隨着我們加深了解並改良技術,使用權限的安排也可能有所調整。
我們目前正與少數研究人員合作,包括康奈爾大學電腦科學助理教授 John Thickstun、蘇黎世聯邦理工學院電腦科學教授兼 INSAIT 科學總監 Martin Vechev,以及肯佩倫智能技術研究所(KInIT)的研究人員,以深入了解這項技術的能力與限制,為改良文字浮水印提供依據。
誰有資格獲得更高的驗證用量上限?檢查需要收費嗎?
內容來源 API 的檢查目前免費,但設有用量上限。提高用量上限的計劃主要面向符合資格、涉及公共利益的來源追溯專案及資訊完整性工作流程,例如新聞編輯室驗證、事實查核、內容來源研究及監管監督。
一般商業應用目前不在計劃範圍內,例如商業防詐騙、認證及驗證,或將其納入來源追溯及數據分析服務套裝中轉售。
用途符合資格的機構可以申請提高用量上限,但提交申請並不保證獲批。公開 API 仍可在預設用量上限內使用,包括用於小規模評估。目前的用量上限請參閱內容來源 API 文件。
誰有資格使用文字偵測工具?檢查需要收費嗎?
文字偵測工具的檢查目前免費。符合資格的用途包括學術及研究機構對文字來源、偵測可靠性,或人們如何理解來源驗證結果所進行的研究。
一般商業應用目前不在計劃範圍內,例如商業防詐騙、認證及驗證,或將其納入來源追溯及數據分析服務套裝中轉售。
學術誠信方面的應用,例如檢查學生作業是否使用 AI(如撰寫文章或學位論文),也目前不在計劃範圍內。
驗證結果代表甚麼?
如果透過 openai.com/verify 或 OpenAI 的內容來源 API 偵測到訊號,就表示上載的內容含有與 OpenAI 相關且受支援的來源訊號。工具不會確認內容是否準確、未經編輯、擁有權合法,或是否在正確的語境下呈現。它也無法識別內容由誰建立,或為何建立。
如果未偵測到訊號,就表示工具未在上載的檔案中找到 OpenAI 發出的來源訊號。在以下情況下,內容仍可能由 OpenAI 生成或匯出:
內容在來源訊號推出之前已經建立。
內容來自不受支援的產品、模型、匯出途徑或檔案類型。
元數據在上載、下載、編輯、轉換或分享過程中被移除。
浮水印因壓縮、裁剪、雜訊、編輯、格式轉換或其他轉換而受損。
音訊片段太短,或曾經大幅修改。
如何取得最可靠的驗證結果?
每次上載一個受支援的檔案,並盡可能使用原始匯出檔案。對於圖片,檢查前請避免裁剪或轉換檔案。對於音訊,長度介乎 10 至 60 秒的片段通常能得出最佳結果。即使未偵測到訊號,也應先考慮檔案的來源及背景,再作結論。
結果會顯示我的提示詞或個人資料嗎?
來源訊號不包含用戶、組織或提示詞的詳細資料。
我使用 openai.com/verify 或內容來源 API 驗證的內容會如何處理?
上載至 openai.com/verify 或提交至我們的內容來源 API 以供驗證的內容,只會用於檢查受支援的來源訊號。除非法律要求,否則我們不會儲存內容,也不會將內容用於訓練 OpenAI 模型。
OpenAI 能偵測其他 AI 工具生成的內容嗎?
我們的內容來源工具旨在偵測受支援的來源訊號,這些訊號與 OpenAI 模型生成或 OpenAI 工具匯出的內容相關。這些工具並非用來偵測其他 AI 模型生成的內容。如果相關訊號缺失、不受支援或已受損,它們也可能無法偵測 OpenAI 生成的內容。
浮水印的運作原理
浮水印能確定作者身分、擁有權或法律責任嗎?
不能。浮水印是內容很可能由 OpenAI 模型生成或處理的證據。單憑浮水印,無法確定內容由誰創作或擁有、是否需要作出披露,或由誰承擔法律責任。它也無法告訴你,模型是否在編輯用戶上載的內容。
浮水印能顯示 OpenAI 模型參與內容製作的程度嗎?
不能。偵測工具只會回報是否找到浮水印。找到浮水印,是內容很可能由 OpenAI 模型生成或處理的證據,但無法顯示模型生成了部分還是全部內容,也無法顯示人類貢獻了多少。
文字浮水印如何運作?
文字浮水印會在模型撰寫內容時,於其選擇的詞語和詞語片段(稱為「Token」)中建立秘密模式。
在每個步驟中,模型都會為每個可能接續的 Token 分配機率。浮水印系統會根據這些機率,建立數組經調整的機率分佈,每組都按照秘密金鑰偏向不同的選擇。這些分佈經過平衡調整,取平均值後會與模型原本的機率一致。金鑰會決定使用哪一組分佈,然後模型會按該組分佈重新作出隨機選擇。
之後,採用相同金鑰及相應設定的偵測工具,就能檢查文字符合該秘密模式的頻率,是否高於純粹隨機情況下的預期。
文字浮水印適用於事實性文字和用戶提供的文字嗎?
文字浮水印需要模型能以不同方式表達同一意思。如果回答必須嚴格依據事實或非常精確,例如數學題的答案,或模型被要求原封不動地重現所提供的文字,用詞的彈性就較小。在這些情況下,模型可在不造成明顯差異的前提下調整措辭的空間較小,因此浮水印可能無法被偵測到。
文字浮水印適用於簡短回答和程式碼嗎?
短篇文字通常沒有足夠內容供系統可靠地偵測浮水印。程式碼也較難加入浮水印,因為與一般文章相比,程式碼接下來可以合理採用的內容選擇較少。
考慮到這些限制,歐盟《人工智能法案》的《AI 生成內容透明度實務守則》並不要求在少於 200 個 Token(約 150 個英文單字)的輸出或程式碼片段中加入浮水印。
文字浮水印的偵測效果會如何因語言而異?
偵測率因語言而異,目前某些語言的浮水印較容易被偵測到。對於訊號較弱的語言,我們可以調整浮水印強度,改善偵測效果。
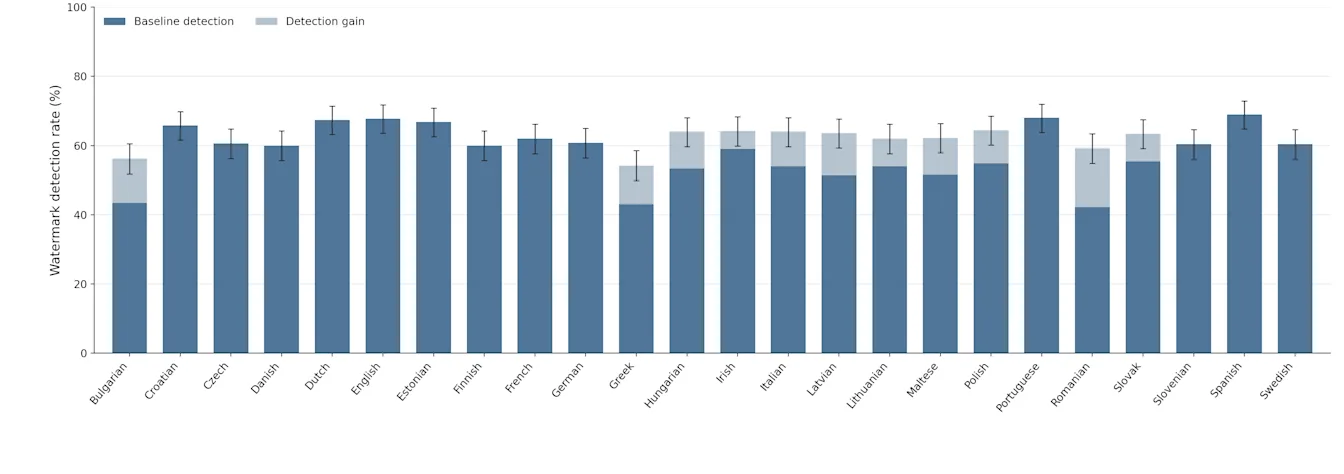
這張圖表評估了歐盟全部 24 種官方語言的偵測率。我們先生成了 500 個涵蓋多元主題的合成英文提示詞,再將它們翻譯成其餘 23 種語言。在誤報率為 1% 的情況下,西班牙文的偵測率最高(69.0%),羅馬尼亞文則最低(42.2%)。我們的浮水印設有可調整的強度參數,就像一個「旋鈕」,可針對不同領域增強或減弱浮水印訊號。透過這個旋鈕,我們能為偵測率低於 60% 的語言提高浮水印強度;長條中的淺藍色部分顯示了由此帶來的提升。
文字浮水印會降低模型的品質嗎?
根據我們的測試,不會。在用於評估最新前沿模型 Astra 的各項基準測試中,啟用與未啟用浮水印的表現差異,均落在我們通常於不同評估輪次之間觀察到的隨機波動範圍內。先前在 ChatGPT 進行的測試也顯示,加入浮水印並未改變負評率或其他產品指標。
文字浮水印會降低模型的速度嗎?
文字浮水印對我們模型速度的影響微乎其微。
OpenAI 的文字浮水印與第三方 AI 偵測工具有何不同?
Pangram 等第三方偵測工具通常使用分類器,根據用詞選擇等模式識別 AI 生成的文字。這種方法是在文字生成後加以分析,而非偵測嵌入的訊號。歐盟《人工智能法案》明確要求在生成文字中嵌入訊號。
為甚麼你們使用自行開發的文字浮水印,而不是 TextSeal 或 SynthID?
我們開發了名為 textGrain 的文字浮水印方法。與 SynthID 或 TextSeal 相比,這讓我們更能掌握浮水印的可偵測性與同一提示詞所生成回應的多樣性之間的平衡。在我們的測試中,與文字版 SynthID 相比,我們的方法正確識別出帶浮水印文字樣本的比例相若或更高。我們計劃以開源技術形式發佈 textGrain,讓其他人能在此基礎上開發,協助改良文字浮水印。
文字浮水印會加入隱藏字元、額外的 Token 或可見的改動嗎?
不會。文字浮水印會改變用詞選擇的統計模式,不會插入隱藏字元,也不會加入僅用於浮水印的 Token。讀者無法看見浮水印,複製及貼上文字也不會帶入隱藏內容。
客戶指引
我是 API 客戶,如何啟用文字浮水印?
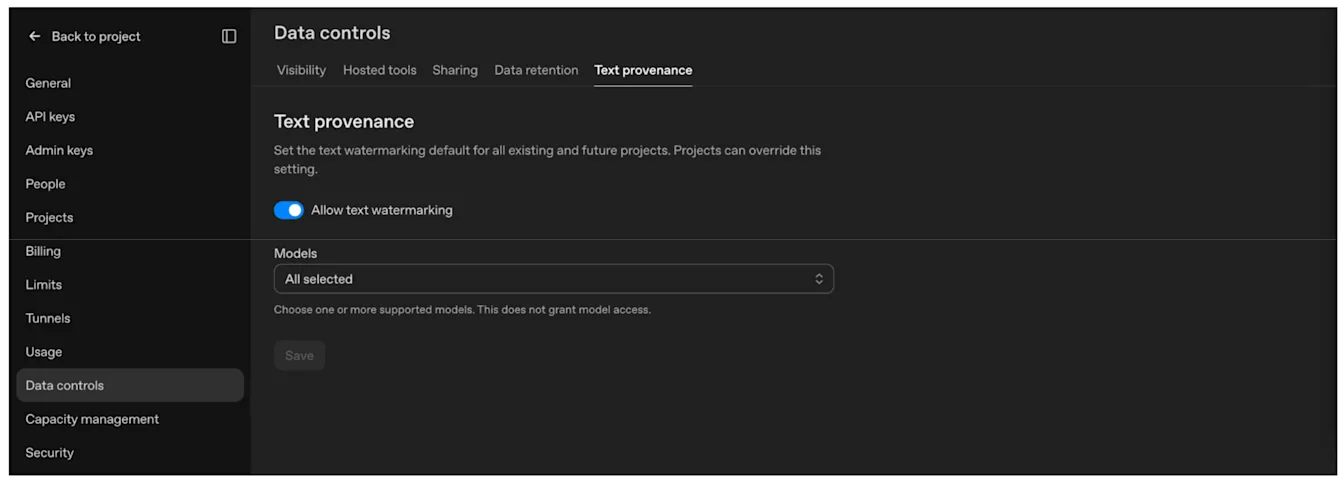
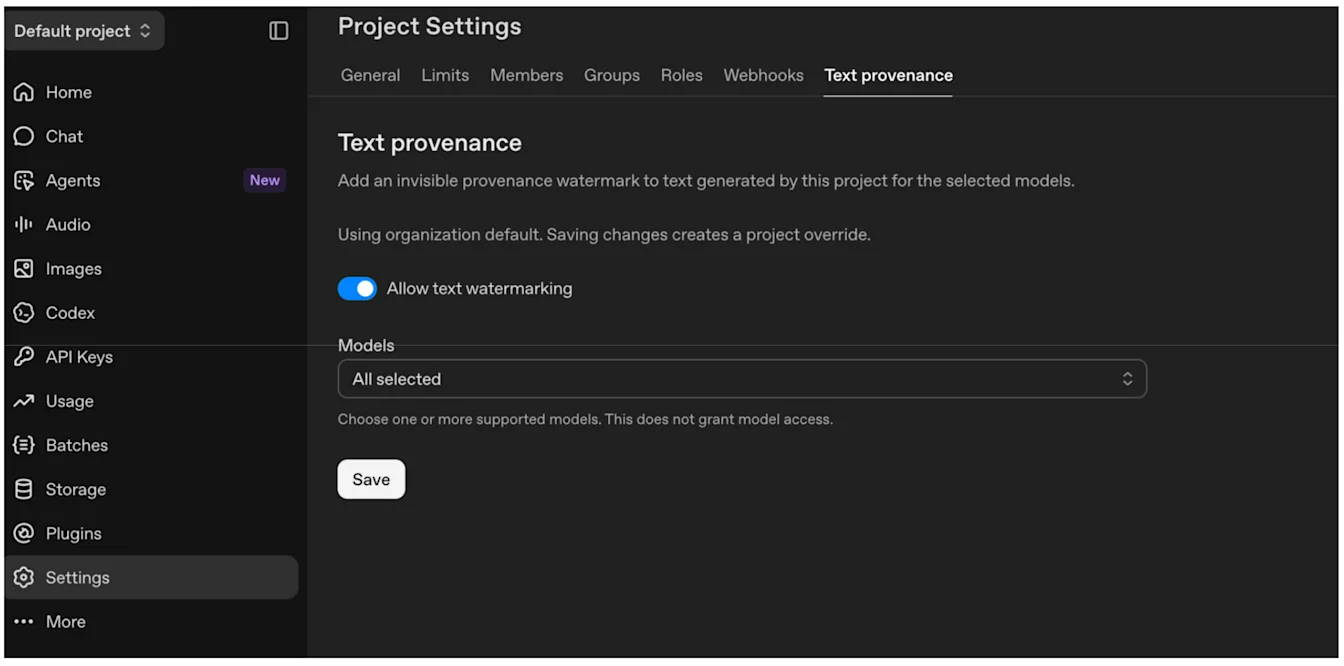
OpenAI API 客戶可以透過設定,為特定專案啟用文字浮水印,或透過組織設定,為整個組織啟用。無論採用哪種方式,客戶都可以選擇要為哪些模型加入文字浮水印。為受支援的模型啟用後,OpenAI 就會在生成文字時加入浮水印。客戶無須為每個回應另行加入標記。
開啟「允許文字浮水印」,選取模型,然後選擇「儲存」。
組織預設設定:組織設定 → 資料控制 → 文字來源。
專案覆寫設定:專案設定 → 文字來源。
啟用文字浮水印後,我也可以使用文字偵測工具嗎?
不可以。目前只有獲批准的研究及學術機構可以使用文字偵測工具。這些機構致力提升文字浮水印的可靠性和易用性,並讓這項技術及其結果更容易清楚解釋。這符合我們在歐盟《人工智能法案》的《AI 生成內容透明度實務守則》下所作的承諾。
內容經過轉換後,訊號仍會保留嗎?
有可能,但視乎訊號類型及你所作的改動。
對於受支援的圖片及音訊,請保留原始副本,並使用內容來源 API,測試經過編輯、轉換及發佈的代表性檔案。對於圖片,裁剪、加入雜訊、轉換為 JPEG 及擷取螢幕截圖,都可能令訊號更難偵測。只有在你的機構獲准使用文字偵測工具後,你才可以用這種方式測試文字。
如檔案格式及工作流程支援,請保留現有的 C2PA 元數據,並在製作的檔案中加入內容憑證。你也可以考慮加入自己的標記,讓來源資料更易保留或更具實用性。實作詳情請參閱 C2PA 技術文件。
對於文字,浮水印是模型用詞選擇的一部分。如果保留原有措辭,預期再次使用文字時訊號仍會保留,無須額外的整合工作。大幅改寫、換句話說或翻譯,都可能降低偵測的可靠性。即使用詞沒有改變,也不能保證偵測得到浮水印,尤其是短篇文字或用詞選擇空間很小的文字。
我透過雲端服務使用 OpenAI 模型。這些輸出也包含來源訊號嗎?
我們正與所有雲端及分銷服務供應商合作,確保在所有符合條件的輸出中嵌入浮水印等來源訊號,涵蓋圖片、音訊及文字。支援情況可能因輸出及合作夥伴而異。
來源訊號可以取代可見的 AI 標籤或其他披露嗎?
不可以。浮水印及 C2PA 元數據會提供軟件可讀取的資料。它們不能取代可能需要提供的可見標籤、橫幅或其他告示。
你是否需要作出額外披露,取決於你使用內容的方式及場合。OpenAI 無法就你的具體法律義務提供建議;你的法律團隊應評估相關用途須遵守的要求。
我對歐盟《人工智能法案》還有其他問題
請提交歐盟《人工智能法案》查詢,我們會回覆你。